Агенты кодирования постоянно отправляют контекст репозитория, инструкции, результаты работы инструментов и историю диалогов для генерации действий. Эта работа также является одной из самых конфиденциальных: ваш исходный код, внутренняя документация и архитектурные решения покидают ваш периметр при каждом нажатии клавиши. Владение средой выполнения — это способ сохранить контроль: код, трассировки и данные об использовании, которые в конечном итоге могут помочь вам в дообучении этих моделей, чтобы сделать их более адаптированными к потребностям вашей команды.
Помимо конфиденциальности данных, оплата за использование проприетарных LLM по токенам означает линейный рост расходов на каждого разработчика и каждый запрос, без возможности получения эффективности за счет масштаба по мере роста команды и количества агентов. Владение средой выполнения меняет ситуацию, позволяя команде совместно использовать базовые графические процессоры (GPU). BMW обнаружила экономическую выгоду от перехода с API на собственную инфраструктуру вывода уже при штате в 8 разработчиков. Однако создание и управление собственной платформой обслуживания LLM для кодирования сопряжено с операционными трудностями при работе с кластерами GPU.
Что касается затрат, ключевые выводы нашей модели показывают, что самостоятельное размещение обходится в долю от стоимости API с оплатой за токен на одного разработчика:
- Постоянно работающий сервис: около 2920 долларов в месяц, или около 58 долларов на одного зарегистрированного разработчика.
Постоянно работающий сервис: около 2920 долларов в месяц, или около 58 долларов на одного зарегистрированного разработчика.
- Сервис, работающий только в рабочие часы: около 840 долларов в месяц, или около 17 долларов на одного зарегистрированного разработчика.
Сервис, работающий только в рабочие часы: около 840 долларов в месяц, или около 17 долларов на одного зарегистрированного разработчика.
- Базовый уровень API: активный разработчик обычно тратит около 800 долларов в месяц в эквиваленте стоимости API Claude Code.
Базовый уровень API: активный разработчик обычно тратит около 800 долларов в месяц в эквиваленте стоимости API Claude Code.
Эти цифры предполагают стоимость около 4 долларов за час работы узла GPU для RTX PRO 6000 и 50 зарегистрированных разработчиков, использующих один GPU. Это плановые прогнозы, а не совокупная стоимость владения (TCO); полные допущения и оговорки приведены в разделе сравнения затрат ниже.
Помимо экономии средств, оптимизация инфраструктуры обслуживания дает измеримый прирост производительности.
Ключевые выводы наших эмпирических оценок демонстрируют значительное улучшение производительности:
- 8,0-кратное ускорение компиляции с восстановлением кэша компиляции. В конфигурации без MTP NVFP4 время компиляции сократилось с 48,5 до 6,0 секунд.
8,0-кратное ускорение компиляции с восстановлением кэша компиляции. В конфигурации без MTP NVFP4 время компиляции сократилось с 48,5 до 6,0 секунд.
- 3,79-кратное увеличение пропускной способности запросов с многоуровневым кэшированием KV на CPU. Добавление уровня CPU объемом 512 ГБ в оценке GLM-5.2 с одной репликой увеличило долю кэшированных токенов промпта с 6,1% до 74,9% для 58 общих промптов, сократив медианное время до первого токена (TTFT) с 48,4 до 9,2 секунд.
3,79-кратное увеличение пропускной способности запросов с многоуровневым кэшированием KV на CPU. Добавление уровня CPU объемом 512 ГБ в оценке GLM-5.2 с одной репликой увеличило долю кэшированных токенов промпта с 6,1% до 74,9% для 58 общих промптов, сократив медианное время до первого токена (TTFT) с 48,4 до 9,2 секунд.
- 1,86-кратное увеличение пропускной способности вывода с помощью спекулятивного декодирования. Многотокеновое прогнозирование (MTP) увеличило пропускную способность вывода с 65 до 121 токена/с.
1,86-кратное увеличение пропускной способности вывода с помощью спекулятивного декодирования. Многотокеновое прогнозирование (MTP) увеличило пропускную способность вывода с 65 до 121 токена/с.
- 2,87-кратное ускорение генерации вывода с включенными графами CUDA. Наблюдаемая клиентом пропускная способность токенов увеличилась с 15,9 до 45,6 токенов/с по сравнению с работой в режиме eager.
2,87-кратное ускорение генерации вывода с включенными графами CUDA. Наблюдаемая клиентом пропускная способность токенов увеличилась с 15,9 до 45,6 токенов/с по сравнению с работой в режиме eager.
Это руководство содержит пошаговую дорожную карту, охватывающую выбор модели и оборудования, развертывание сервиса, настройку одной реплики, автоматическое масштабирование с маршрутизацией на основе кэша и операции с несколькими моделями.
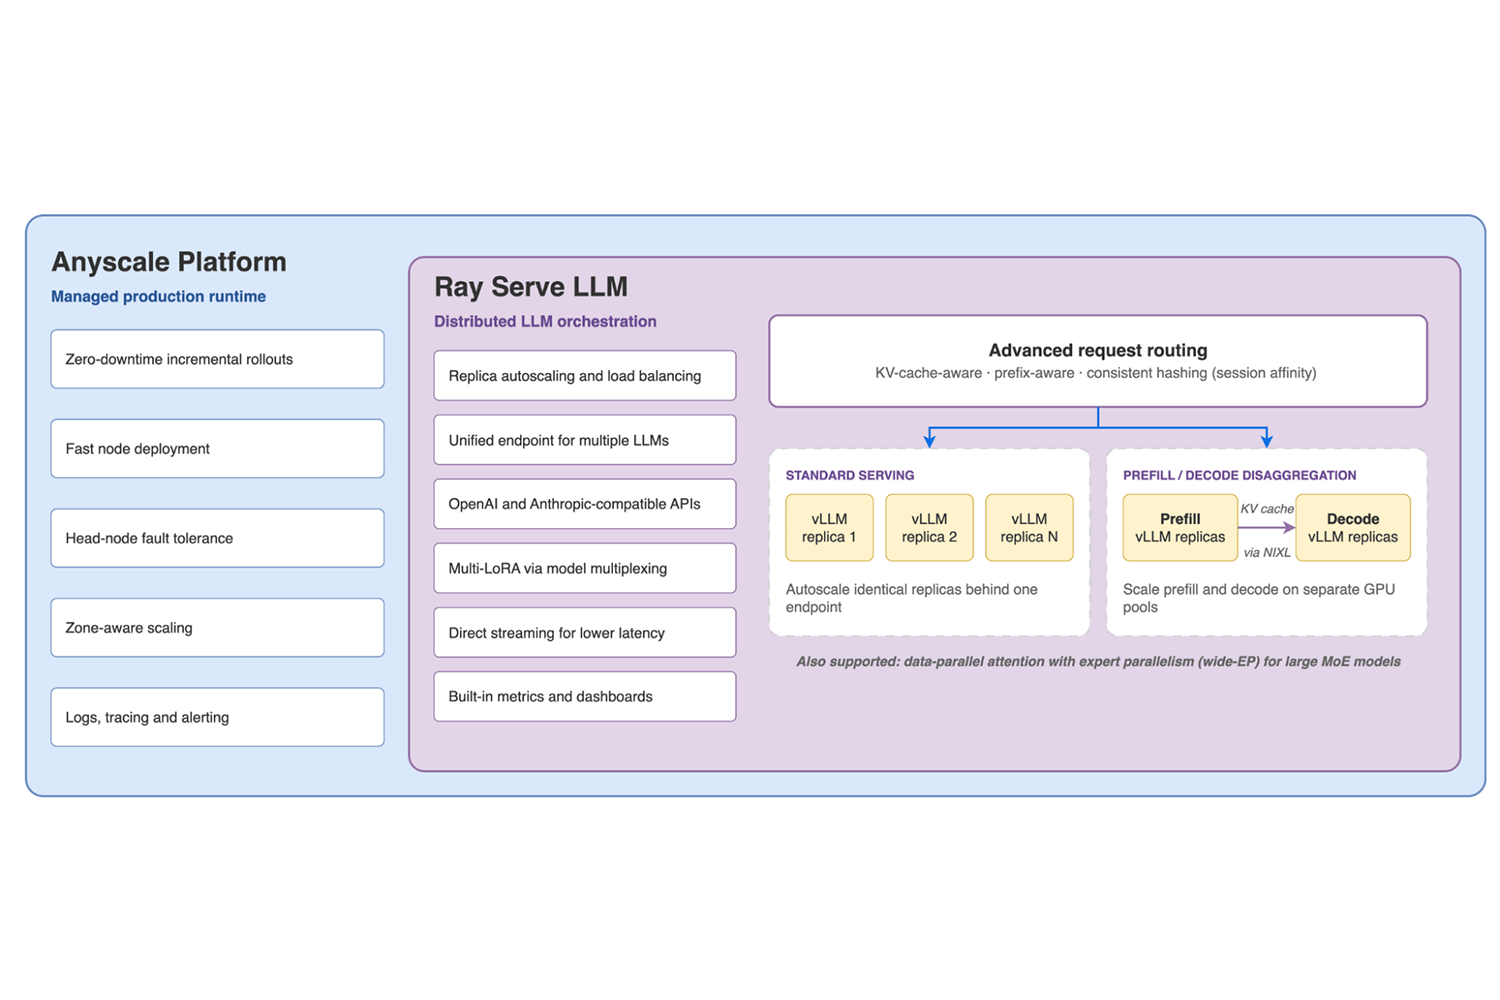
Рисунок 1. Стек обслуживания LLM на Anyscale: vLLM запускает модель, Ray Serve LLM организует и распределяет запросы между репликами, а Anyscale управляет производственной средой выполнения.
Как работает стек обслуживания LLM:
- vLLM: механизм вывода, который загружает модель на GPU и генерирует токены.
vLLM: механизм вывода, который загружает модель на GPU и генерирует токены.
- Ray Serve LLM: уровень оркестрации, который масштабирует, направляет и балансирует нагрузку запросов между множеством реплик vLLM за одной конечной точкой, совместимой с OpenAI и Anthropic, включая расширенные шаблоны, такие как дезагрегация префилла/декодирования.
Ray Serve LLM: уровень оркестрации, который масштабирует, направляет и балансирует нагрузку запросов между множеством реплик vLLM за одной конечной точкой, совместимой с OpenAI и Anthropic, включая расширенные шаблоны, такие как дезагрегация префилла/декодирования.
- Anyscale Platform: управляемая производственная среда выполнения, которая подготавливает GPU, автоматически масштабирует узлы (включая масштабирование до нуля) и обеспечивает надежность и наблюдаемость, такие как развертывание без простоя, отказоустойчивость, логи, трассировка и оповещения.
Anyscale Platform: управляемая производственная среда выполнения, которая подготавливает GPU, автоматически масштабирует узлы (включая масштабирование до нуля) и обеспечивает надежность и наблюдаемость, такие как развертывание без простоя, отказоустойчивость, логи, трассировка и оповещения.
Чтобы сделать этот путь воспроизводимым, мы создали репозиторий кода для обслуживания LLM для агентов кодирования.
Репозиторий организован в пять запускаемых частей:
- Part 1: Deploy: Запуск и проверка базового сервиса Anyscale.
: Запуск и проверка базового сервиса Anyscale.
- Part 2: Connect: Подключение Claude Code, Codex и Cursor через их собственные API.
: Подключение Claude Code, Codex и Cursor через их собственные API.
- Part 3: Optimize: Настройка использования GPU, кэширования, декодирования и автоматического масштабирования.
: Настройка использования GPU, кэширования, декодирования и автоматического масштабирования.
- Part 4: Route: Маршрутизация между открытой моделью и Claude с помощью LiteLLM.
: Маршрутизация между открытой моделью и Claude с помощью LiteLLM.
- Part 5: Roll out: Настройка развертывания без участия человека (zero-touch) для команды.
: Настройка развертывания без участия человека (zero-touch) для команды.
Как агенты кодирования меняют рабочую нагрузку обслуживания
Агенты кодирования производят гораздо больше, чем просто чат-трафик
Промпты агентов кодирования объединяют системные инструкции, контекст репозитория, определения инструментов, диагностику и историю диалогов — часто для того, чтобы создать лишь короткий вызов инструмента или правку. Это делает рабочую нагрузку тяжелой для префилла, где большие входные данные доминируют во времени до первого токена (TTFT).
Большая часть этого контекста повторяется между итерациями, создавая отличные возможности для автоматического повторного использования префиксного KV-кэша. При масштабировании команды коррелированные всплески нагрузки создают дополнительную проблему. Поэтому высокопроизводительная платформа должна балансировать между четырьмя целями: низкий TTFT, плавная потоковая передача токенов, высокое повторное использование кэша и эластичная емкость.
Рисунок 2. Иллюстративный сеанс агента кодирования: каждая итерация повторно отправляет большой, по большей части повторяющийся промпт для создания короткого вывода. Только новый контент каждой итерации (оранжевый) требует свежего префилла; остальное может быть обслужено из KV-кэша.
Агенты для написания кода работают как API-клиенты. При настройке с использованием пользовательских конечных точек локальный агент — или, в случае с облачными клиентами, такими как Cursor, его облачный бэкенд — отправляет запросы на совместимый сервер моделей вместо использования стандартной хостинговой модели. Поскольку эти клиенты используют разные схемы API и конечные точки, инфраструктура обслуживания должна предоставлять соответствующие маршруты. В руководстве по интеграции клиента для репозитория настраиваются следующие три пути:
Агент для написания кода
Путь API
Cursor
/v1/chat/completions
Claude Code
/v1/messages
Codex
/v1/responses
Размещение модели с открытыми весами на Anyscale может дать несколько преимуществ:
- Снижение затрат: более низкая предельная стоимость токена при достаточно высоком уровне использования, чтобы компенсировать фиксированные расходы на инфраструктуру.
Снижение затрат: более низкая предельная стоимость токена при достаточно высоком уровне использования, чтобы компенсировать фиксированные расходы на инфраструктуру.
- Контроль пропускной способности: снижение зависимости от ограничений скорости одного провайдера при самостоятельном управлении мощностями и очередями.
Контроль пропускной способности: снижение зависимости от ограничений скорости одного провайдера при самостоятельном управлении мощностями и очередями.
- Безопасность и контроль данных: сохранение большей части пути вывода внутри вашей сети.
Безопасность и контроль данных: сохранение большей части пути вывода внутри вашей сети.
- Снижение зависимости от провайдера моделей: получение контроля над обновлениями моделей и инфраструктуры обслуживания.
Снижение зависимости от провайдера моделей: получение контроля над обновлениями моделей и инфраструктуры обслуживания.
- Развитие LLM с использованием собственных данных: создание цикла обратной связи данных путем сбора одобренных трассировок агентов, их курирования и оценки с помощью Ray Data, а также последующего обучения с помощью Ray Train или фреймворка обучения с подкреплением (RL).
Развитие LLM с использованием собственных данных: создание цикла обратной связи данных путем сбора одобренных трассировок агентов, их курирования и оценки с помощью Ray Data, а также последующего обучения с помощью Ray Train или фреймворка обучения с подкреплением (RL).
Сообщество и прозрачность: использование открытой экосистемы для понимания и настройки поведения модели.
Рисунок 3. Прямая потоковая передача позволяет Ray Serve LLM подключаться к агентам для написания кода через различные конечные точки.
LinkRay Serve LLM масштабирует это для промышленного использования
В то время как vLLM берет на себя основные оптимизации вывода — такие как кэширование префиксов, фрагментированное предварительное заполнение (chunked prefill), quantization, спекулятивное декодирование и параллелизм моделей — для надежного развертывания требуется нечто большее. Ray Serve LLM добавляет производственный уровень для:
- Масштабирования реплик в средах с несколькими GPU.
Масштабирования реплик в средах с несколькими GPU.
- Интеллектуальной маршрутизации запросов на основе нагрузки и состояния кэша.
Интеллектуальной маршрутизации запросов на основе нагрузки и состояния кэша.
- Предоставления API, совместимых с OpenAI и Anthropic.
Предоставления API, совместимых с OpenAI и Anthropic.
- Потоковой передачи токенов от реплик через HAProxy в обход устаревшего узла входящего трафика Python.
Потоковой передачи токенов от реплик через HAProxy в обход устаревшего узла входящего трафика Python.
- Централизации метрик для сервисов, моделей и GPU.
Централизации метрик для сервисов, моделей и GPU.
- Эргономичные инструменты сборки для сложных многоузловых развертываний, таких как Wide-EP и дезагрегация предварительного заполнения.
Эргономичные инструменты сборки для сложных многоузловых развертываний, таких как Wide-EP и дезагрегация предварительного заполнения.
Опубликованный недавно бенчмарк Ray Serve LLM показал совокупный прирост пропускной способности до 4,4 раз на рабочих нагрузках с интенсивным предварительным заполнением и до 24,8 раз на задачах с интенсивным декодированием по сравнению со старой базовой версией Ray Serve LLM без пакетной обработки после внедрения HAProxy, прямой потоковой передачи и RayExecutorV2. На Anyscale Ray Serve LLM добавляет управляемое автоматическое масштабирование, наблюдаемость и отказоустойчивость вокруг движка вывода.
LinkРазвертывание LLM для агентов написания кода
Практическое развертывание состоит из четырех шагов:
- Выбор модели на основе качества выполнения задач и требований к ресурсам обслуживания.
Выбор модели на основе качества выполнения задач и требований к ресурсам обслуживания.
- Выбор оборудования и стратегии параллелизма.
Выбор оборудования и стратегии параллелизма.
- Настройка движка vLLM и развертывания Ray Serve.
Настройка движка vLLM и развертывания Ray Serve.
- Развертывание сервиса и проверка каждого клиента для написания кода.
Развертывание сервиса и проверка каждого клиента для написания кода.
LinkШаг 1: Выбор LLM для успеха задачи, а не только по рейтингу в таблице лидеров
Качество моделей с открытыми весами быстро растет. Таблицы лидеров агентов, такие как рейтинг Agent Arena для моделей с открытым исходным кодом, являются хорошей отправной точкой, а семейства моделей, включая Qwen, DeepSeek, Kimi и GLM, все чаще ориентируются на написание кода и использование инструментов. Однако публичные рейтинги — это лишь отправная точка, и эксперты Anyscale по LLM могут помочь вам выбрать лучшую модель для ваших конкретных рабочих нагрузок.
Общие бенчмарки включают SWE-bench для решения реальных проблем в репозиториях, Terminal-Bench для терминальных задач, Toolathlon для многоэтапных рабочих процессов с использованием нескольких инструментов, τ-bench для диалогового использования инструментов, CyberGym для анализа уязвимостей и GDPval-AA v2 для профессиональной интеллектуальной работы. Оценки часто отражают всю агентскую систему, а не только модель, поэтому сравнивайте результаты только тогда, когда версии бенчмарков и настройки оценки совпадают.
Оцените модели-кандидаты на своих собственных задачах:
- Редактирование нескольких файлов и навигация по репозиторию.
Редактирование нескольких файлов и навигация по репозиторию.
- Структурированные вызовы инструментов в течение нескольких итераций.
Структурированные вызовы инструментов в течение нескольких итераций.
- Следование инструкциям в длинном контексте.
Следование инструкциям в длинном контексте.
- Отладка и исправление тестов.
Отладка и исправление тестов.
- Задержка и количество итераций, необходимых для завершения задачи.
Задержка и количество итераций, необходимых для завершения задачи.
Модель меньшего размера, которая выполняет обычную работу за один надежный проход, может быть дешевле, чем более крупная модель, требующая больше GPU. Более мощная модель может оказаться дешевле для сложных задач, если она позволяет избежать повторных попыток. Измеряйте стоимость успешного выполнения задачи, а не только стоимость за миллион токенов.
LinkШаг 2: Подбор весов, оперативной памяти и KV-кэша под оборудование
Память GPU хранит веса модели, KV-кэш, временные активации, CUDA-графы и накладные расходы среды выполнения. Память для весов в основном фиксирована и масштабируется в зависимости от количества параметров и точности, поэтому квантование весов может быть критически важным, когда неквантованные веса ограничивают развертывание. KV-кэш хранит состояние внимания для активных запросов и растет вместе с длиной контекста и параллелизмом. Для рабочих нагрузок агентов написания кода с длинным контекстом квантование KV-кэша также может уменьшить объем памяти на токен. Квантование обоих компонентов, если оно поддерживается и проверено на качество, оставляет больше места для одновременных длинных запросов.
При выборе стратегии квантования рассмотрите следующие форматы:
- FP8: Отличный вариант как для весов, так и для KV-кэша, если это поддерживается оборудованием и средой выполнения. Это примерно вдвое сокращает объем необработанных данных по сравнению с BF16; качество остается зависимым от модели, задачи и калибровки.
FP8: Отличный вариант как для весов, так и для KV-кэша, если это поддерживается оборудованием и средой выполнения. Это примерно вдвое сокращает объем необработанных данных по сравнению с BF16; качество остается зависимым от модели, задачи и калибровки.
- NVFP4: На GPU NVIDIA Blackwell этот формат сокращает объем необработанных данных для квантованных тензоров вдвое по сравнению с FP8. Экономия на всей контрольной точке меньше, так как некоторые модули и метаданные остаются с более высокой точностью; протестированная контрольная точка Qwen занимала примерно 22 ГБ против 27 ГБ для FP8, что составляет сокращение примерно на 19%.
: На графических процессорах NVIDIA Blackwell этот формат сокращает вдвое объем необработанных данных для квантованных тензоров по сравнению с FP8. Экономия на всей контрольной точке меньше, так как некоторые модули и метаданные остаются в более высокой точности; протестированная контрольная точка Qwen использовала примерно 22 ГБ против 27 ГБ для FP8, что составляет сокращение примерно на 19%.
- MxFP4: Открытая альтернатива для 4-битной точности, используемая такими моделями, как gpt-oss.
: Открытая альтернатива для 4-битной точности, используемая такими моделями, как gpt-oss.
Примечание: Настройка среды выполнения и архитектура графического процессора определяют степень аппаратного ускорения. Хотя веса NVIDIA Qwen3.6-27B-NVFP4 развернуты здесь, закрепленный релиз vLLM полагается на резервный вариант Marlin вместо собственного ядра для плотного NVFP4 на оборудовании RTX PRO 6000. Кроме того, поскольку кэширование KV NVFP4 не поддерживается на этом устройстве, система по умолчанию использует кэш FP8 KV.
Рисунок 4. Иллюстративная компоновка памяти GPU: веса NVFP4 оставляют большую часть памяти для кэша KV, а FP8 KV вмещает примерно в два раза больше полных контекстов, чем BF16.
СсылкаШаг 3: Настройка движка для модели и рабочей нагрузки
Правильная конфигурация обслуживания зависит от модели. Помимо памяти и параллелизма, она должна использовать правильный шаблон чата, парсер рассуждений, парсер вызова инструментов, мультимодальные ограничения и длину контекста.
Реализация обслуживания Qwen в репозитории настраивает один GPU на реплику, ограничение контекста 256K, кэш FP8 KV, локальное кэширование префиксов, фрагментированное предварительное заполнение (chunked prefill), а также специфичные для Qwen парсеры рассуждений и инструментов. В следующем отрывке показаны соответствующие аргументы движка; реализация настраивает спекулятивное декодирование и поведение кэша компиляции отдельно:
max_model_len ограничивает контекст одного запроса. max_num_batched_tokens служит бюджетом планировщика для фрагментированного предварительного заполнения. В то же время max_num_seqs ограничивает параллелизм движка.
СсылкаШаг 4: Включение прямой потоковой передачи и подключение клиентов
Конфигурация постоянно активной службы в репозитории включает HAProxy и прямую потоковую передачу на уровне службы:
Следуйте руководству по подключению агента кодирования в репозитории. Сначала разверните оптимизированную постоянно активную службу:
Затем скопируйте ее общедоступный base_url и токен носителя (bearer token) из консоли Anyscale → Services → Query. Агент выполняет инструменты локально, но запросы к модели — включая инструкции, контекст репозитория, историю разговоров и результаты инструментов — и потоковые ответы модели проходят через службу.
Claude Code
Экспортируйте URL службы и токен, затем запустите из репозитория:
Средство запуска передает корень службы в Claude Code как ANTHROPIC_BASE_URL и предоставляет токен через ANTHROPIC_AUTH_TOKEN.
Codex
Из той же директории запустите codex-service.sh:
Он регистрирует URL /v1 как пользовательского провайдера, выбирает wire_api="responses" и отправляет токен носителя в /v1/responses.
Cursor
Следуйте настройке Cursor в руководстве и введите эти значения в Cursor Settings → Models → OpenAI API Key:
СсылкаОптимизация одной реплики для трафика агента кодирования
СсылкаБенчмаркинг задержки относительно определенных SLO
Для получения исчерпывающих определений TTFT, ITL, TPOT, предварительного заполнения, декодирования и пропускной способности (goodput) обратитесь к руководству по метрикам LLM от Anyscale.
Вместо того чтобы фокусироваться исключительно на необработанной пропускной способности токенов, отдавайте приоритет goodput — доле запросов, соответствующих целевым SLO по задержке. Хотя агрессивное пакетирование повышает общую пропускную способность, оно может негативно повлиять на производительность интерактивной потоковой передачи.
СсылкаВоспроизведение реальных сессий агента для бенчмарков
Однородные синтетические подсказки не позволяют зафиксировать истинный цикл работы агента. Реальный трафик сочетает в себе длинные и короткие обороты, повторяющиеся префиксы, ожидания выполнения инструментов и сессии с «тяжелым хвостом» длительности. Чтобы точно протестировать вашу настройку, преобразуйте свои сессии Claude Code JSONL в потоки запросов с временными метками, которые сохраняют рост подсказок и задержки между оборотами. Если вы еще не собираете свои собственные сессии, вы можете использовать общедоступный корпус сессий агента WekaTrace Claude Code.
Для каждой конфигурации-кандидата соберите:
- Распределения TTFT, TPOT, ITL и сквозной задержки.
Распределения TTFT, TPOT, ITL и сквозной задержки.
- Завершенные обороты агента и успешные задачи.
Завершенные обороты агента и успешные задачи.
- Входные/выходные токены и доля кэшированных токенов подсказок.
Входные/выходные токены и доля кэшированных токенов подсказок.
- Глубина очереди, вытеснение, удаление KV и использование GPU.
Глубина очереди, вытеснение, удаление KV и использование GPU.
- Ошибки вызова инструментов и некорректные ответы.
Ошибки вызова инструментов и некорректные ответы.
СсылкаПрименение оптимизаций в порядке зависимости
Измерения на одном GPU ниже используют один RTX PRO 6000. Большинство результатов декодирования были записаны с использованием реальных подсказок сессий Claude в среднем около 73 тыс. токенов. Каждая строка изолирует отдельный параметр; выигрыши не являются кумулятивными.
Оптимизация
До
После
Измеренное изменение
Графы CUDA против режима eager (веса FP8)
15.9 выходных токенов/с
45.6 выходных токенов/с
2.87x
Многотокеновое предсказание против базового (веса NVFP4)
65 выходных токенов/с
121 выходной токен/с
1.86x
RunAI Streamer
Около 85 с загрузки весов
Около 25 с загрузки весов
3.4x
Восстановленный кэш компиляции, vLLM 0.25.1
48.5 с стадия компиляции
6.0 с стадия компиляции
8.0x
1. Квантуйте веса для эффективного размещения модели. Квантование весов может превратить развертывание на нескольких GPU в развертывание на одном GPU, устраняя межпроцессорную связь и освобождая память для кэша KV. Преимущество зависит от собственных ядер GPU и калибровки контрольной точки. Относитесь к каждому изменению точности как к изменению как производительности, так и качества.
2. Квантуйте кэш KV, если это поддерживается. Оптимизированное развертывание использует кэш FP8 KV. Расчеты емкости оценили хранилище KV как эквивалентное примерно 3.27x контекстам 256K токенов с BF16 KV и 6.53x с FP8 KV на протестированном GPU 96 ГБ.
3. Держите графы CUDA включенными для продакшена. Режим eager запускает операции с большим участием CPU и полезен для отладки. Графы CUDA захватывают повторяемую работу GPU и снижают накладные расходы на запуск. Отключение режима eager (при сохранении включенных графов CUDA) увеличило скорость вывода с 15.9 до 45.6 токенов/с.
4. Тестируйте спекулятивное декодирование на целевых рабочих нагрузках. Многотокеновое предсказание предлагает и проверяет несколько будущих токенов одновременно, чтобы снизить TPOT; параметр num_speculative_tokens управляет количеством предсказанных черновых токенов (например, установив его на 3, чтобы предсказать три токена вперед). Однако чистое ускорение зависит от коэффициентов принятия и накладных расходов на проверку. При параллелизме 8 предсказание трех токенов дало 99 выходных токенов/с и 0.50 оборотов/с — превзойдя два токена (80 токенов/с, 0.50 оборотов/с) — тогда как предсказание четырех токенов снизило производительность до 74 токенов/с. Большая глубина спекуляции не обязательно лучше. Отдавайте приоритет точности вывода: вышестоящие проблемы отмечают поврежденные вызовы инструментов при объединении MTP с кэшированием префиксов. Проверьте совместимость клиента, модели, парсера и vLLM с помощью регрессионных тестов для нескольких оборотов перед включением MTP.
5. Оптимизируйте инициализацию, чтобы отделить холодные запуски от работы в установившемся режиме. Загрузка модели, загрузка весов, компиляция движка и готовность реплик — это отдельные этапы, влияющие на скорость развертывания. Кэши компиляции чувствительны к точной версии программного обеспечения, архитектуре GPU, модели, параллелизму и флагам, что означает, что устаревший кэш может привести к сбою или незаметному снижению производительности. Хотя RunAI Streamer сократил время загрузки весов, в матрице несовместимости репозитория зафиксирован известный конфликт между его путем загрузчика и MTP в протестированной версии vLLM.
На практике сначала убедитесь в правильности использования инструментов при отключенном спекулятивном декóдировании; используйте режим eager только по мере необходимости для отладки. Как только правильность будет подтверждена, включите требуемую квантизацию и длину контекста, а затем графики CUDA. После этого настройте пакетный префилл и протестируйте спекулятивное декóдирование. Наконец, оптимизируйте холодный запуск и повторно запустите полный набор тестов на правильность и нагрузку.
Сравнение затрат LinkModel
В модели затрат и допущениях репозитория предполагается стоимость примерно 4 доллара в час за узел GPU для конфигурации RTX PRO 6000, при этом 50 зарегистрированных разработчиков используют один GPU совместно. На основе этих допущений:
Режим планирования
Часы узла GPU в месяц
Стоимость узла GPU в месяц
Стоимость на одного зарегистрированного разработчика
Всегда включено
730
Около $2920
Около $58
Только рабочие часы
210
Около $840
Около $17
Цены на Claude через Azure Marketplace в Microsoft Foundry выглядят следующим образом Claude Opus 5 rates: $5,00 за миллион токенов (MTok) для стандартного ввода, $0,50/MTok для чтения из кэша и $25,00/MTok для вывода.
Активный разработчик регулярно тратит до $800 в месяц на эквивалентные затраты на API Claude Code. Это согласуется с отраслевыми бенчмарками, включая наблюдения компании Pylon о том, что активные пользователи достигают $800 в месяц, и другую аналогичную оценку в $1199,79 за 30 дней. Общедоступная телеметрия трасс подтверждает, что рабочие нагрузки агентов кодирования сильно смещены в сторону входных токенов:
- Набор данных WekaTrace указывает на соотношение входных токенов к выходным 117:1.
Набор данных WekaTrace указывает на соотношение входных токенов к выходным 117:1.
- В трассе Claude от SyFI TraceLab зафиксировано соотношение 269:1 при 95,2% попаданий в кэш промптов.
В трассе Claude от SyFI TraceLab зафиксировано соотношение 269:1 при 95,2% попаданий в кэш промптов.
Принимая во внимание показатель SyFI по кэшированному вводу в размере 95,2% (тарифицируемый как чтение из кэша) и рассматривая оставшиеся 4,8% как пятиминутную запись в кэш, ценообразование Opus 5 преобразует ежемесячные расходы в $800 приблизительно в 922 млн входных токенов и 3,43 млн выходных токенов на одного разработчика. Для команды инженеров из 50 разработчиков общее использование API составляет примерно 40 000 долларов и 171 млн выходных токенов в месяц.
Цифра в 40 000 долларов в месяц служит исключительно ориентиром для расходов на API, а не прямым показателем потенциальной экономии инфраструктуры. Поскольку краткие тесты декодирования для конкретных конфигураций не учитывают накладные расходы на префилл, постановку запросов в очередь, общее использование GPU, целевые показатели SLO задержки и вариации качества модели, они не могут надежно прогнозировать пропускную способность реальных воркеров.
Аналогичным образом, расчеты стоимости GPU на одного разработчика представляют собой предварительные проектные оценки, а не общую стоимость владения (TCO) или обязательства по уровню обслуживания. Чтобы точно определить необходимое количество реплик и чистую экономию, оцените полезную пропускную способность (goodput) при воспроизведении постоянных трасс по отношению к целевым SLO задержки и показателям успешности задач, а затем учтите дополнительные накладные расходы на эксплуатацию платформы.
LinkScale с автомасштабированием и балансировкой нагрузки с учетом кэша
LinkРаздельные лимиты движка, лимиты приема и цели автомасштабирования
- Параметр max_num_seqs в vLLM ограничивает количество последовательностей, принимаемых движком.
215