Если в вашем наборе тестов Cypress какие-то тесты начинают падать чаще или выполняются медленнее, вы знаете, как сложно выявить закономерность по одному единственному запуску. Это может быть один замедлившийся файл спеки (spec), один падающий тест или замедление всего набора тестов в целом. Первопричиной может быть баг в приложении, нестабильный (flaky) тест или что-то еще. Вывод в терминале и лог CI покажут, что произошло за один конкретный запуск, но это не поможет заметить более масштабные тенденции, тем более что эти данные теряются сразу же по завершении задачи.
К счастью, Cypress, фреймворк для автоматизированного тестирования фронтенда, созданный для веб-приложений, уже предоставляет всё необходимое через хуки плагинов. После завершения каждой спеки Cypress передает вам объект результатов с количеством успешных и неуспешных тестов, длительностью каждого теста и его состоянием. Вам нужно лишь превратить это в метрики и отправить в постоянное хранилище.
В этой статье вы узнаете, как мониторить тесты Cypress, преобразуя эти результаты в метрики Prometheus внутри хука Cypress, отправляя их в Prometheus Pushgateway и настраивая Alloy для сбора данных из шлюза и их пересылки в Grafana Cloud Metrics — и всё это с использованием исключительно бесплатных тарифов.
В итоге у вас будет работать конвейер со следующей архитектурой:
Что вам понадобится
Это руководство предполагает выполнение всех действий в рамках вашего существующего проекта Cypress. Перед началом убедитесь, что у вас есть:
- Проект Cypress (в этом примере используется Cypress 14.x) с файлом cypress.config.js, который можно редактировать
Проект Cypress (в этом примере используется Cypress 14.x) с файлом cypress.config.js, который можно редактировать
- Prometheus Pushgateway. Запуски Cypress — это кратковременные пакетные задания (batch jobs), поэтому их нельзя опросить напрямую: Pushgateway удерживает метрики между запусками, чтобы скрапер мог их забрать. Настройте Prometheus Pushgateway в своей инфраструктуре
Prometheus Pushgateway. Запуски Cypress — это кратковременные пакетные задания (batch jobs), поэтому их нельзя опросить напрямую: Pushgateway удерживает метрики между запусками, чтобы скрапер мог их забрать. Настройте Prometheus Pushgateway в своей инфраструктуре
- Alloy, наш коллектор с открытым исходным кодом, который мы используем для сбора данных из Pushgateway и удаленной записи (remote-write) в Grafana Cloud
Alloy, наш коллектор с открытым исходным кодом, который мы используем для сбора данных из Pushgateway и удаленной записи (remote-write) в Grafana Cloud
- Аккаунт Grafana Cloud. Бесплатный тариф включает Grafana Cloud Metrics и эндпоинт удаленной записи Prometheus. Если у вас нет аккаунта, вы можете зарегистрироваться здесь
Аккаунт Grafana Cloud. Бесплатный тариф включает Grafana Cloud Metrics и эндпоинт удаленной записи Prometheus. Если у вас нет аккаунта, вы можете зарегистрироваться
- URL удаленной записи Grafana Cloud, числовой ID пользователя и токен политики доступа с разрешением metrics:write
URL удаленной записи Grafana Cloud, числовой ID пользователя и токен политики доступа с разрешением metrics:write
Генерация метрик из хуков Cypress
1a. Хуки, которые заставляют это работать
Плагины Cypress выполняются в Node.js и могут подписываться на события жизненного цикла в setupNodeEvents. Два хука предоставляют нам всё необходимое:
- before:run срабатывает один раз перед запуском любой спеки. Мы используем его, чтобы присвоить единый run_id для всего набора тестов и очистить любое состояние от предыдущего запуска. В этом примере run_id представляет собой метку времени эпохи (epoch timestamp) для времени начала набора тестов.
before:run срабатывает один раз перед запуском любой спеки. Мы используем его, чтобы присвоить единый run_id для всего набора тестов и очистить любое состояние от предыдущего запуска. В этом примере run_id представляет собой метку времени эпохи (epoch timestamp) для времени начала набора тестов.
- after:spec срабатывает после завершения каждого файла спеки и получает объект результатов этой спеки. Именно здесь находятся счетчики тестов, их состояния и длительность, поэтому здесь мы формируем и отправляем метрики.
after:spec срабатывает после завершения каждого файла спеки и получает объект результатов этой спеки. Именно здесь находятся счетчики тестов, их состояния и длительность, поэтому здесь мы формируем и отправляем метрики.
Отправка обернута в блок try/catch, поэтому сбой мониторинга никогда не превратит успешный запуск тестов в неуспешный — телеметрия является побочным эффектом, а не блокирующим фактором. Во-вторых, run_id устанавливается один раз в before:run и используется повторно каждой спекой, поэтому все спеки из одного запуска набора тестов разделяют один идентификатор и могут быть сгруппированы вместе для каждого запуска.
1b. Превращение объекта результатов Cypress в метрики Prometheus
Объект результатов, который Cypress передает в after:spec, включает блок stats (passes, failures, pending, skipped, tests, а также длительность в миллисекундах) и массив тестов, каждый из которых имеет title, state и duration. Мы сопоставляем их с небольшим набором метрик, используя метки для детализации по спеке, запускy и отдельному тесту:
Каждый ряд содержит общий набор меток spec (какой файл), run_id (метка времени эпохи, заданная в before:run) и ci_run_id (запуск CI, если он присутствует), что позволяет отфильтровать дашборд до одной спеки или одного запуска CI. В результате получается компактный набор метрик:
- cypress_tests_total: количество тестов по результатам (пройдено, упало, в ожидании, пропущено) на спеку
cypress_tests_total: количество тестов по результатам (пройдено, упало, в ожидании, пропущено) на спеку
- cypress_tests_run_total: общее количество выполненных тестов на спеку
cypress_tests_run_total: общее количество выполненных тестов на спеку
- cypress_spec_duration_seconds: сколько времени заняла каждая спека
cypress_spec_duration_seconds: сколько времени заняла каждая спека
- cypress_spec_success: 1, если в спеке не было сбоев; 0, если в спеке был хотя бы один сбой
cypress_spec_success: 1, если в спеке не было сбоев; 0, если в спеке был хотя бы один сбой
- cypress_test_success и cypress_test_duration_seconds: та же идея на уровне отдельного теста, позволяющая отслеживать стабильность проблемного теста с течением времени
cypress_test_success и cypress_test_duration_seconds: та же идея на уровне отдельного теста, позволяющая отслеживать стабильность проблемного теста с течением времени
1c. Отправка в Pushgateway
Обычная настройка Prometheus производит опрос (скрейпинг) долго работающих сервисов с заданным интервалом. Запуск Cypress — это полная противоположность. Это кратковременное пакетное задание, которое завершается до того, как какой-либо скрапер успеет до него добраться. Prometheus Pushgateway существует ровно для этого случая: ваше задание отправляет свои метрики на шлюз, шлюз удерживает их, а Prometheus (или Alloy) опрашивает шлюз по собственному расписанию.
Сама отправка представляет собой обычный HTTP POST-запрос метрик в текстовом формате Prometheus:
Параметры job и instance в пути формируют ключ группировки Pushgateway (здесь job="cypress" и instance="local"; значения могут быть любыми в зависимости от проекта или модуля вашего выполняющегося набора тестов).
Поскольку мы аккумулируем метрики каждой спеки в карту specMetrics и заново отправляем (POST) полное тело после каждой спеки, шлюз всегда хранит полный и актуальный снимок набора тестов. А очистка этой карты в before:run означает, что новый запуск начинается с чистого листа, а не переносит устаревшие данные спек.
Вся интеграция находится в cypress.config.js и активируется только при установке PROMETHEUS_PUSHGATEWAY_URL, поэтому локальные запуски cypress остаются неизменными, если вы сами этого не захотите:
Отправка в Grafana Cloud с помощью Alloy
Теперь Pushgateway хранит ваши метрики, но это локальный буфер, а не долгосрочное хранилище. Alloy соединяет их воедино: он опрашивает шлюз и выполняет удаленную запись в Grafana Cloud Metrics.
Укажите учетные данные Grafana Cloud в качестве переменных окружения и запустите Alloy:
Запуск тестов и проверка
Запустите Pushgateway и Alloy, а затем выполните свой набор тестов, указав шлюз:
По завершении каждого спека Cypress выводит строку вроде Pushed metrics for spec "login.cy.js" (run_id="1753100000000") to Pushgateway. В течение интервала сбора данных эти временные ряды появляются в Grafana Cloud.
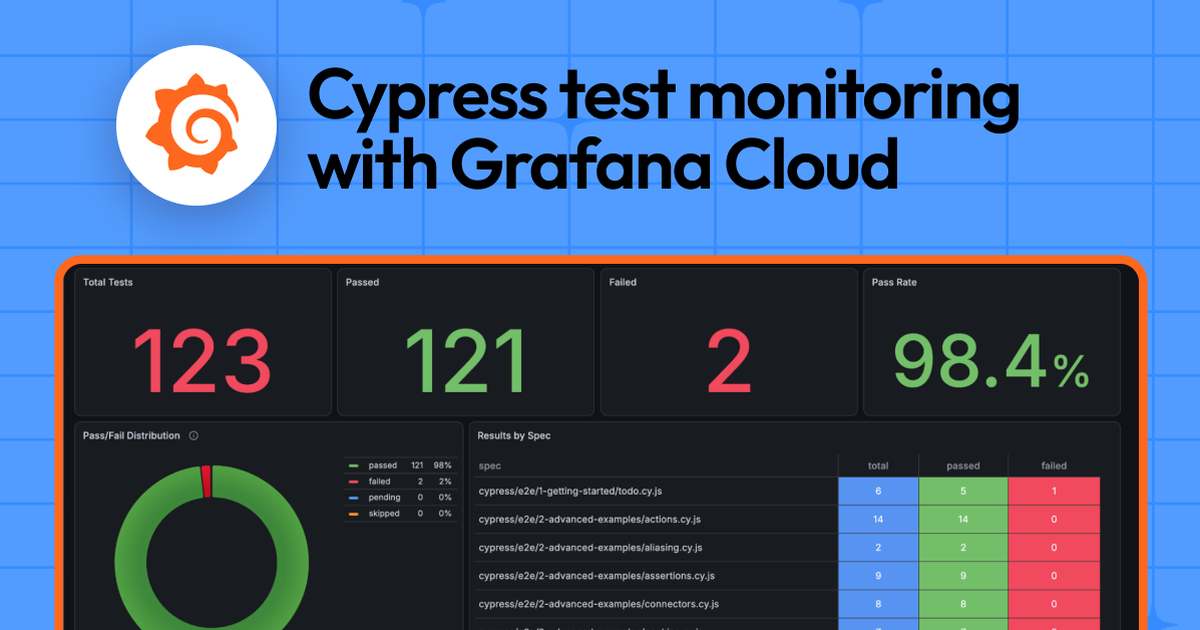
Отсюда вы можете создать дашборд, который определяет тенденции в количестве успешных и неудачных тестов, длительности спеков и успешности отдельных тестов. Вы также можете настроить Grafana Alerting для отправки уведомлений, когда коэффициент успешности набора тестов падает или критический спек начинает давать сбои.
На основе собранных метрик мы можем визуализировать время выполнения каждого спека, а также отдельных тестов.
Запуск в CI
Тот же механизм работает в CI без изменений — разница лишь в том, откуда берутся метрики.
Например, в workflow GitHub Actions задайте для PROMETHEUS_PUSHGATEWAY_URL адрес Pushgateway, доступный вашему раннеру, а остальное сделает Cypress:
Поскольку код считывает GITHUB_RUN_ID при его наличии, каждый запуск в CI помечается своим ci_run_id, поэтому вы можете перейти от всплеска метрик прямо к вызвавшему его запуск workflow.
Несколько советов, которые сэкономят вам время:
- Используйте Pushgateway, а не цель сбора (scrape target). Запуски Cypress завершаются за секунды; скрапер никогда бы их не поймал. Pushgateway — это буфер, который делает кратковременные задания наблюдаемыми.
Используйте Pushgateway, а не цель сбора (scrape target). Запуски Cypress завершаются за секунды; скрапер никогда бы их не поймал. Pushgateway — это буфер, который делает кратковременные задания наблюдаемыми.
- Никогда не позволяйте телеметрии приводить к сбою запуска. Оберните отправку в try/catch. Сбой мониторинга никогда не должен окрашивать успешно прошедший набор тестов в красный цвет.
Никогда не позволяйте телеметрии приводить к сбою запуска. Оберните отправку в try/catch. Сбой мониторинга никогда не должен окрашивать успешно прошедший набор тестов в красный цвет.
- Экранируйте значения ваших меток. Названия тестов представляют собой произвольный текст и могут содержать кавычки и символы новой строки, которые нарушают текстовый формат Prometheus. Экранируйте их перед записью метрик.
Экранируйте значения ваших меток. Названия тестов представляют собой произвольный текст и могут содержать кавычки и символы новой строки, которые нарушают текстовый формат Prometheus. Экранируйте их перед записью метрик.
- Присваивайте один run_id на весь набор тестов. Установка его в before:run и повторное использование для разных спеков позволяет вам группировать и сравнивать целые запуски позже.
Присваивайте один run_id на весь набор тестов. Установка его в before:run и повторное использование для разных спеков позволяет вам группировать и сравнивать целые запуски позже.
Grafana Assistant — это самый простой способ начать работу с метриками, логами, трейсами, дашбордами и многим другим в Grafana Cloud. У нас есть щедрый бесплатный тарифный план навсегда и планы для любых сценариев использования. Зарегистрируйтесь бесплатно прямо сейчас!
Теги