Команда run --all для крупного Terragrunt estate расходует время на две вещи. Первая — это реальная работа: планирование и применение изменений в OpenTofu/Terraform. Вторая — накладные расходы: планирование, из-за которого доступный уровень параллелизма остается неиспользуемым, и скачивание одних и тех же провайдеров каждым юнитом снова и снова. В версии Terragrunt 1.0 решены обе эти проблемы благодаря переработанному механизму планирования под названием «пул запускщиков» (runner pool) и автоматическому кэшированию провайдеров для OpenTofu 1.10 и более поздних версий.
Ни то, ни другое не новость, если вы следите за списком изменений, но их стоит понять отдельно, поскольку ускорение, которое они обеспечивают, не является фиксированным процентом. Оно растет вместе с размером и структурой вашей инфраструктуры. В этой статье объясняется, как работает каждый из этих механизмов и что нужно сделать, чтобы извлечь из них пользу (если вообще нужно).
Как Terragrunt планирует выполнение команды run --all
Когда вы запускаете команду для множества юнитов:
Terragrunt обнаруживает юниты в рабочей директории, считывает их блоки зависимости и зависимостей (dependency и dependencies) и строит на их основе направленный ациклический граф (DAG). Этот граф превращается в очередь выполнения: для команд plan и apply зависимости выполняются до того, как будут выполнены зависящие от них юниты; для destroy порядок меняется на обратный.
Юниты выполняются параллельно до лимита, которым вы управляете с помощью параметра --parallelism, но ограничение порядка всегда соблюдается. Юнит не начнется до тех пор, пока все его зависимости не завершатся успешно.
Это было справедливо для Terragrunt на протяжении многих лет. Что изменилось, так это то, насколько агрессивно Terragrunt заполняет доступный параллелизм, не нарушая граф.
Старая модель: группы зависимостей
До появления пула запускщиков Terragrunt группировал юниты по глубине зависимостей и выполнял группы последовательно. Юниты без зависимостей попадали в группу 1, юниты, зависящие только от группы 1, попадали в группу 2 и так далее:
Эту модель легко понять, и ее удобно выводить в логи, но у нее есть структурный изъян: группа начинается только тогда, когда завершилась вся предыдущая группа. Если юнит vpc выполняется восемь минут, а dns — тридцать секунд, юнит cache простаивает семь с половиной минут, хотя его единственная зависимость завершилась почти сразу. Каждая группа ждет самый медленный юнит внутри себя.
Сбои обладали такой же грубой грануляцией. Один сбоящий юнит мог нарушить границу всей группы, затронув юниты, у которых не было зависимостей с упавшим компонентом.
Модель пула
RFC пула запускщиков заменил группы очередью и пулом. Каждый обнаруженный юнит попадает в очередь с метаданными о том, что его блокирует. Юниты без незавершенных зависимостей готовы к работе; остальные заблокированы. Terragrunt поддерживает пул запускщиков размером с --parallelism, и как только запускщик освобождается, а юнит оказывается готов, этот юнит начинает выполняться.
Когда юнит успешно завершает работу, Terragrunt удаляет его из списков заблокированных (blocked-by) для зависящих от него элементов, и любой зависимый юнит, чей список только что опустел, сразу же получает право на запуск. Больше нет границ групп, которые нужно ждать. В примере выше юнит cache запускается в тот момент, когда завершается dns, в то время как vpc все еще работает.
Обработка ошибок в то же время стала более точной. Когда юнит завершается с ошибкой, только зависящие от него юниты (и их зависимости по цепочке) помечаются как имеющие неудачного предка и пропускаются. Несвязанные юниты продолжают выполняться. Если вы предпочитаете старое поведение с остановкой всего процесса, параметр --fail-fast вернет его:
Почему прирост масштабируется с размером инфраструктуры
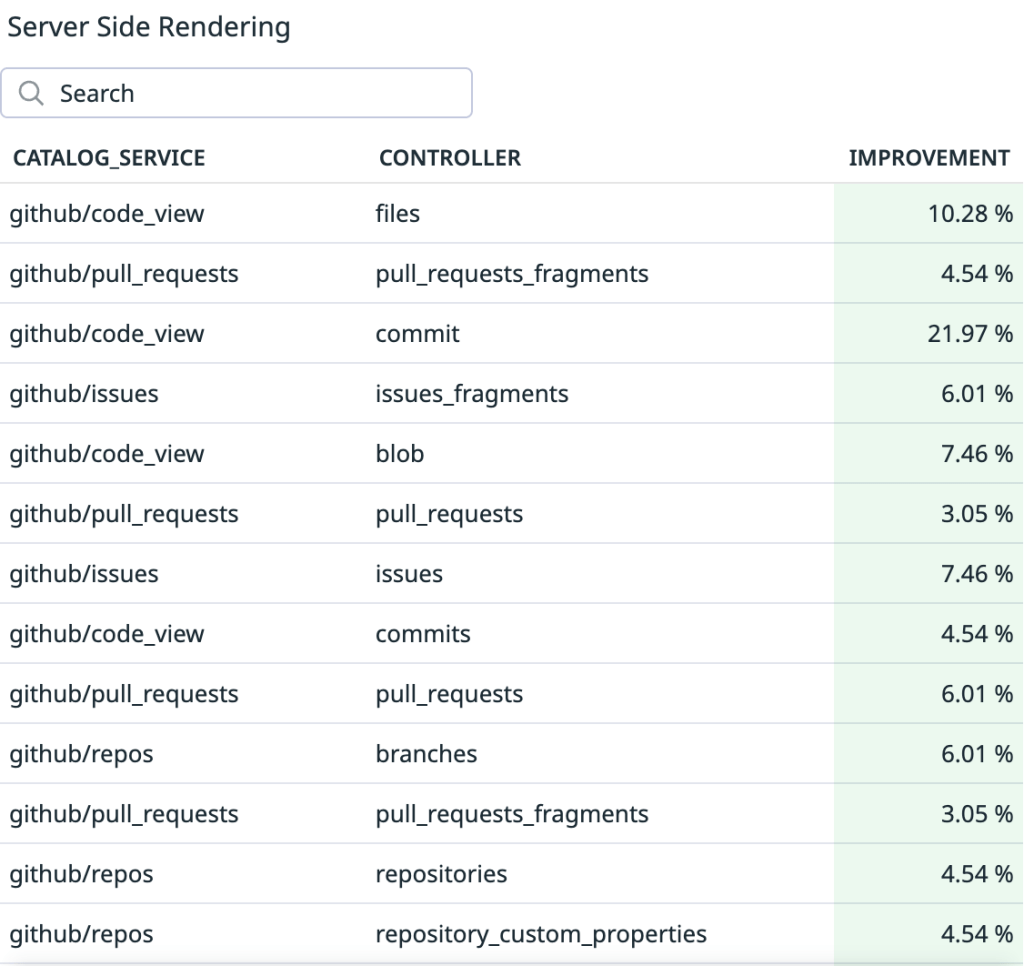
В худшем случае, когда каждый юнит в слое занимает одинаковое количество времени, пул и модель групп завершают работу одновременно. Реальная инфраструктура выглядит иначе. Время работы юнитов сильно различается (развертывание записи DNS и кластера баз данных требует разного объема работы), и чем больше юнитов и глубже ваш граф, тем больше времени простоя накапливает модель групп на границах групп. Пул устраняет именно это время простоя, поэтому улучшение пропорционально размеру инфраструктуры: небольшие видят скромный прирост, в то время как инфраструктуры с сотнями юнитов и неравномерным временем выполнения завершают работу гораздо быстрее.
Ничего не нужно включать. Пул запускщиков внедрялся экспериментально в серии версий 0.x и является основой для каждого запуска run --all и run --graph в версии 1.x. Документация очереди выполнения охватывает настройки для управления им, включая --parallelism, --queue-ignore-errors и фильтрацию юнитов.
Кэширование провайдеров
Планирование — это лишь половина дела. Вторые крупные расходы в масштабе — это скачивание провайдеров.
Проблема
Без кэширования каждый юнит скачивает собственную копию каждого используемого им провайдера и распаковывает ее в собственную директорию .terraform. Цифры быстро растут: архив провайдера AWS (v6.50.0) весит примерно 200 МБ, а в распакованном виде — около 900 МБ. Проект с 50 юнитами тратит около 10 ГБ трафика и 45 ГБ дискового пространства на то, что должно было стать единственной загрузкой размером 200 МБ.
В OpenTofu/Terraform есть встроенный кэш плагинов (TF_PLUGIN_CACHE_DIR), но исторически он был небезопасен при параллельном выполнении команды run --all: параллельные процессы повреждали записи друг друга в кэше. Это заставляло делать неприятный выбор между кэшированием и параллелизмом.
Автоматическое кэширование провайдеров с OpenTofu 1.10+
OpenTofu 1.10 сделал безопасным параллельный доступ к кэшу плагинов, и Terragrunt опирается на это напрямую. Когда Terragrunt обнаруживает OpenTofu 1.10 или более поздней версии, он автоматически устанавливает TF_PLUGIN_CACHE_DIR в общую директорию кэша для каждого запускаемого процесса OpenTofu. Каждый провайдер скачивается один раз и используется повторно каждым юнитом. Это функция директории автоматического кэша провайдеров, и она включена по умолчанию. Никаких флагов, никакой настройки:
Расположение кэша по умолчанию: $HOME/.cache/terragrunt/providers в Linux (с учетом $XDG_CACHE_HOME, если задано), $HOME/Library/Caches/terragrunt/providers в macOS и %LocalAppData%\terragrunt\providers в Windows. Вы можете указать другое расположение:
или отказаться от него для конкретного запуска:
Две детали, которые нужно уточнить. Этот путь требует OpenTofu 1.10 или более поздней версии и работает только с OpenTofu, а не с Terraform. Если требования не выполняются, функция молча ничего не делает, и вы переходите к поведению, описанному далее.
Сервер кэша провайдеров для Terraform и старых версий OpenTofu
Если вы используете Terraform или OpenTofu старше версии 1.10, сервер кэша провайдеров от Terragrunt решает ту же проблему другим способом. Terragrunt запускает локальный сервер реестра, направляет на него каждый процесс OpenTofu/Terraform через сгенерированную конфигурацию CLI, и сервер гарантирует, что каждый провайдер скачивается и сохраняется ровно один раз, а юниты получают символические ссылки на общий кэш. Поскольку сервером управляется кэш, он справляется с параллелизмом, с которым не справлялся старый встроенный кэш плагинов.
Он отключен по умолчанию. Включите его с помощью флага:
или переменной окружения, что удобно использовать в CI:
Об этом сервере также полезно знать даже при использовании актуального OpenTofu. В очень больших масштабах борьба за блокировки файловой системы между процессами OpenTofu, синхронизирующимися по общей директории кэша, может стать узким местом, и сервер кэша позволяет этого избежать. В документации по производительности описывается, когда какой подход побеждает.
Скачивание исходного кода
Юниты также многократно запрашивают исходный код модулей и юнитов. Хранилище с адресацией по содержимому (CAS) дедуплицирует эти запросы так же, как кэш провайдеров дедуплицирует загрузки провайдеров: оно сохраняет загруженный контент по хэшу и обслуживает повторные запросы локально. Оно стало стандартным в Terragrunt 1.1, и в посте о релизе Terragrunt 1.1 это подробно описано.
Что и когда включать
- OpenTofu >= 1.10, текущая версия Terragrunt: ничего. Пул воркеров и автоматическое кэширование провайдеров включены по умолчанию.
- Terraform или OpenTofu < 1.10: добавьте --provider-cache (или TG_PROVIDER_CACHE=1) к вызовам run --all. Пул воркеров по-прежнему применяется автоматически.
- В любом случае: не задавайте переменную TF_PLUGIN_CACHE_DIR самостоятельно при использовании run --all с Terraform или OpenTofu версии ниже 1.10. Это возвращает проблему параллельного повреждения данных, для предотвращения которой и существует кэш-сервер.
Несколько важных замечаний для CI. Оба кэша представляют собой директории в локальной файловой системе, поэтому на временных (ephemeral) раннерах они приносят пользу только в рамках одного задания, если вы не сохраняете директорию кэша между заданиями. Кроме того, кэш-сервер создает накладные расходы при запуске, поэтому для одного юнита terragrunt plan это может дать отрицательный эффект в общем итоге; он оправдывает себя при run --all, где множество юнитов делят общую экономию.
В CI эти преимущества суммируются. Каждый plan в каждом pull request обходит один и тот же граф и запрашивает одних и тех же провайдеров, поэтому сокращение времени выполнения run --all на минуты сокращает время каждого запуска пайплайна, которого ждет ваша команда. Если вы оркестрируете эти запуск с помощью Gruntwork Pipelines, улучшения планирования и кэширования применяются к каждому plan и apply автоматически, без каких-либо изменений в пайплайне.
Заключение
Производительность обеспечивают два механизма: пул воркеров запускает каждый юнит в тот момент, когда завершаются его зависимости, вместо ожидания границ групп, а кэширование провайдеров превращает N одинаковых загрузок в одну. В OpenTofu 1.10+ с текущей версией Terragrunt оба механизма уже работают на вас. В Terraform или старых версиях OpenTofu один флаг включает половину, отвечающую за кэширование. Подробную информацию можно найти в документации Run Queue, Automatic Provider Cache Dir и Provider Cache Server.
Такие улучшения, как пул воркеров и кэширование провайдеров, являются результатом нашей работы по поддержке крупных инфраструктур Terragrunt. Если вы решаете именно эту проблему, обратите внимание на Terragrunt Scale.
Существует даже бесплатный тариф, на который вы можете зарегистрироваться, чтобы протестировать его уже сегодня.