Год назад, когда EE Times посетила офис генерального директора Tenstorrent Джима Келлера, на доске рядом с его дверью было написано: «Мы победим!». Вернувшись год спустя, мы увидели: «Боже мой, это быстро!»
САНТА-КЛАРА, Калифорния — Год назад, когда EE Times посетила офис генерального директора Tenstorrent Джима Келлера, на доске рядом с его дверью было написано: «Мы победим!». Вернувшись год спустя, мы увидели: «Боже мой, это быстро!»
После мероприятия Tenstorrent TT-Deploy, на котором компания показала первые демонстрации того, что ее чипы могут сделать при масштабном развертывании, Келлер рассказал EE Times, что Tenstorrent может превзойти производительность как GPU, так и более специализированного AI-оборудования с помощью своего сервера BlackHole Galaxy.
Келлер считает, что AI-инференс в конечном итоге является проблемой сетевого взаимодействия и памяти, и что архитектура Tenstorrent теперь доказывает это в больших масштабах.
На мероприятии TT-Deploy компания продемонстрировала производительность в различных сценариях работы. Например, 16 серверов Tenstorrent Galaxy (512 чипов) могут выполнять инференс DeepSeek-671B со скоростью до 350 токенов в секунду на пользователя при пакете из 32 токенов.
По словам Келлера, быстрая обработка токенов в Tenstorrent — это прямой результат ее способности легко разделять большие тензоры на сотни чипов. В Galaxy-box'ах есть 56 портов Ethernet на коробку, в то время как у серверов GPU может быть восемь внешних портов на сервер.
Келлер ссылается на правило Рента, разработанное в IBM в 1960-х годах, которое гласит, что объем ввода-вывода, необходимый для блока логики, растет сублинейно по отношению к количеству логики; на практике это означает, что вычислительная область растет быстрее, чем доступная площадь для коммуникации. Это часто является фатальным недостатком для других архитектур, сказал он.
«Нет новых законов», — сказал он. — «Основы вычислений в области ИИ коренятся в HPC 1970-х годов, которые были хорошо изучены на протяжении десятилетий».
По его словам, успешная AI-инфраструктура по-прежнему сводится к балансу вычислений, памяти и ввода-вывода.
«ИИ — это в основном матричные вычисления и нелинейные векторные операции, и чтобы сделать его быстрым, вам нужно достаточное количество SRAM для хранения данных и результатов вычислений, а также буфер для перемещения данных между памятью, тензорными процессорами и чипами, который у нас есть», — сказал он. — «Если сделать память слишком большой, это не очень помогает, а если она слишком маленькая, это очень плохо».
Конкурент Tenstorrent, компания Cerebras, которая подвергается критике за производительность больших моделей после очень успешного IPO, опубликовала показатели производительности Kimi K2.6 (1T). Это самая большая модель, с которой она публично работала до сих пор; Cerebras заявила, что может достичь 981 токена в секунду на своем оборудовании CS3.
По словам Келлера, Tenstorrent может превзойти эту производительность при крупномасштабном развертывании своих серверов BlackHole Galaxy при значительно меньших затратах на оборудование.
«IPO Cerebras [и последующая оценка] были полезны, особенно потому, что мы собираемся победить их во всем», — сказал он. — «Вызов принят!»
Дезагрегированный инференс
Лидер рынка Nvidia лицензировал технологию у Groq для ускорения этапа декодирования инференса LLM с помощью метода, известного как дезагрегированный инференс. Требуются три стеллажа с процессорами и GPU Nvidia: примерно один стеллаж для префилла и два для хранения огромного кэша KV на один стеллаж с чипами Groq для декодирования.
По словам Келлера, Tenstorrent не нуждается в каких-либо дополнительных шагах для быстрого декодирования.
«Меня часто спрашивают, как мы справляемся с кэшем KV», — сказал он. — «Он находится в DRAM на тех же чипах, что и декодирование, мы даже не думаем об этом. Мы очень хороши в этом».
Ключ в том, что Tenstorrent может соединять вместе произвольное количество тензорных процессоров, сказал Келлер. При достаточном количестве чипов тензоры полностью поместятся в SRAM, но если количество чипов недостаточно, данные могут быть потоком получены из DRAM с некоторой потерей производительности. Архитектуры без DRAM, такие как Groq и Cerebras, не могут этого сделать, отметил он.
«Они могут масштабироваться до больших моделей, им просто нужно много оборудования», — сказал он. — «Наш ответ заключается в том, что даже относительно скромное оборудование может запускать большие модели, но если вы хотите сверхбыстрых скоростей токенов, мы можем переместить скорость токенов туда, куда захотим».
Можно ли использовать оборудование Tenstorrent вместе с GPU для ускорения декодирования, аналогично дезагрегированной архитектуре Nvidia?
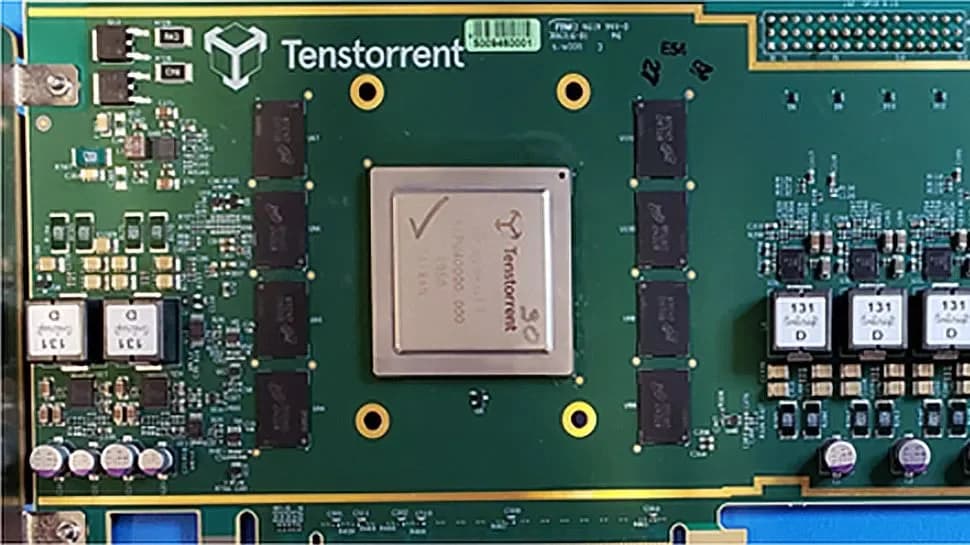
«У нас есть клиент, который использует Galaxy для ускорения GPU, которые он купил», — сказал Келлер. — «У нас есть PCIe-карта с нашим чипом BlackHole, и мы используем Layer 2 Ethernet для транспортировки, поэтому было довольно легко подключиться».
По словам Келлера, клиент удвоил или утроил скорость токенов с помощью этого метода.
«Если бы они купили только Tenstorrent вначале, это было бы дешевле, потому что мы можем делать префилл тоже, и это чище», — сказал он. — «Но [клиент] уже купил GPU и хотел использовать свои инвестиции».
Продуктовая реализация этой идеи в настоящее время является «возможно», добавил Келлер.
Совместная разработка рабочей нагрузки
Представление о том, что гипермасштабируемые системы и передовые лаборатории имеют преимущество в разработке оборудования, поскольку они вертикально интегрированы (то есть они хорошо знают свои рабочие нагрузки, поэтому могут совместно разрабатывать чипы и модели), возможно, было преувеличено, сказал Келлер. Tenstorrent, как и другие компании, имеет оптимизации для некоторых популярных нелинейных функций в своем оборудовании, но их можно корректировать в последовательных поколениях кремния при необходимости.
По словам Келлера, важные вещи на уровне чипа — это разработка для больших моделей, достижение правильной точности и правильное обращение как с огромными кэшами KV, так и с вычислительными нагрузками, такими как диффузия.
«Пока все работает хорошо, если у вас есть баланс DRAM, SRAM, вычислений, матрично-векторных операций и NoC — правило Рента, похоже, надежно», — сказал он.
Еще одно старое правило, которое становится применимым новыми способами, — это закон Амдала, который обычно применяется для иллюстрации того, что ускорение любой рабочей нагрузки ограничено частями, которые не могут быть ускорены.
«Агентные вычисления — это проблема закона Амдала», — сказал Келлер. — «ИИ потребовал огромного количества вычислений, поэтому CPU отправляли задачу ИИ и ждали, пока она завершится… агентные вычисления начали стимулировать спрос на CPU, потому что ИИ наконец стал достаточно быстрым, чтобы быть ограниченным скалярной частью проблемы».
Стремление к IPO
Келлер отказался комментировать сообщения о предложениях о поглощении от компаний, включая Intel и Qualcomm, подтвердив только, что он действительно встречался с генеральными директорами обеих компаний, а также со всеми крупными гипермасштабируемыми системами, чтобы представить им аппаратный IP Tenstorrent.
«Я надеюсь получить большую сделку от одного из этих парней, потому что наш RISC-V CPU IP отличный», — сказал он. — «Один из гипермасштабируемых систем также рассматривает наш AI IP для маленького чипа».
По словам Келлера, хотя гипермасштабируемые системы разработали свои собственные большие чипы для ИИ, более мелкие AI-чипы, такие как те, которые используются в устройствах на краю сети, не могут просто использовать урезанную версию того же IP. AI IP Tenstorrent разработан для масштабирования и полностью продуктовизирован (он поставляется со всем необходимым для масштабирования, скажем, от одного до 1000 ядер, сказал Келлер).
Два крупных исхода для конкурентов стартапа Tenstorrent за последние шесть месяцев — это эффективное (или фактическое) приобретение и IPO. Tenstorrent планирует провести IPO, подтвердил Келлер, и в связи с этим расширяет свою цепочку поставок и международное присутствие.
«В данный момент наши инвесторы очень заинтересованы в IPO», — сказал он.
Обладает ли Tenstorrent потенциалом в качестве ускорителя декодирования, что обязательно делает его привлекательной целью для приобретения компанией GPU? Келлер сказал, что более вероятным является какое-то стратегическое соглашение или совместный выход на рынок.
И суверенная инфраструктура, и крупные передовые лаборатории хотят контролировать свою собственную судьбу, когда речь идет о аппаратном и программном обеспечении, сказал он. «Многое может случиться», — добавил он.
После TT-Deploy Tenstorrent получила заказы на свое оборудование, сказал Келлер, причем крупнейший заказ был на кластер из 96 Galaxy, который будет отправлен за пределы США (96 Galaxy — это 3072 чипа Blackhole). Крупнейшим клиентом Tenstorrent на сегодняшний день остается AI& в Японии, генеральный директор которой — бывший сотрудник Tenstorrent Дэвид Беннетт.
«Некоторые из произошедших событий связаны с тем, что у кучки людей были заказы на 100 миллионов долларов у Nvidia, но Nvidia не будет поставлять в течение года, поэтому они взяли машину Tenstorrent на 20 миллионов долларов, потому что это гораздо дешевле», — сказал Келлер.
Tenstorrent находится в процессе строительства 1000 серверов Galaxy, по крайней мере половина из которых уже продана, сказал он.
«Наше оборудование работает довольно хорошо, у нас 10 клиентов с Galaxy на месте, мы прошли стадию доказательства концепции», — сказал Келлер. «Мы начинаем получать последующие заказы… Я хочу получить 10 довольных клиентов, а затем 20, а затем 30».
Эта статья впервые появилась в EE Times