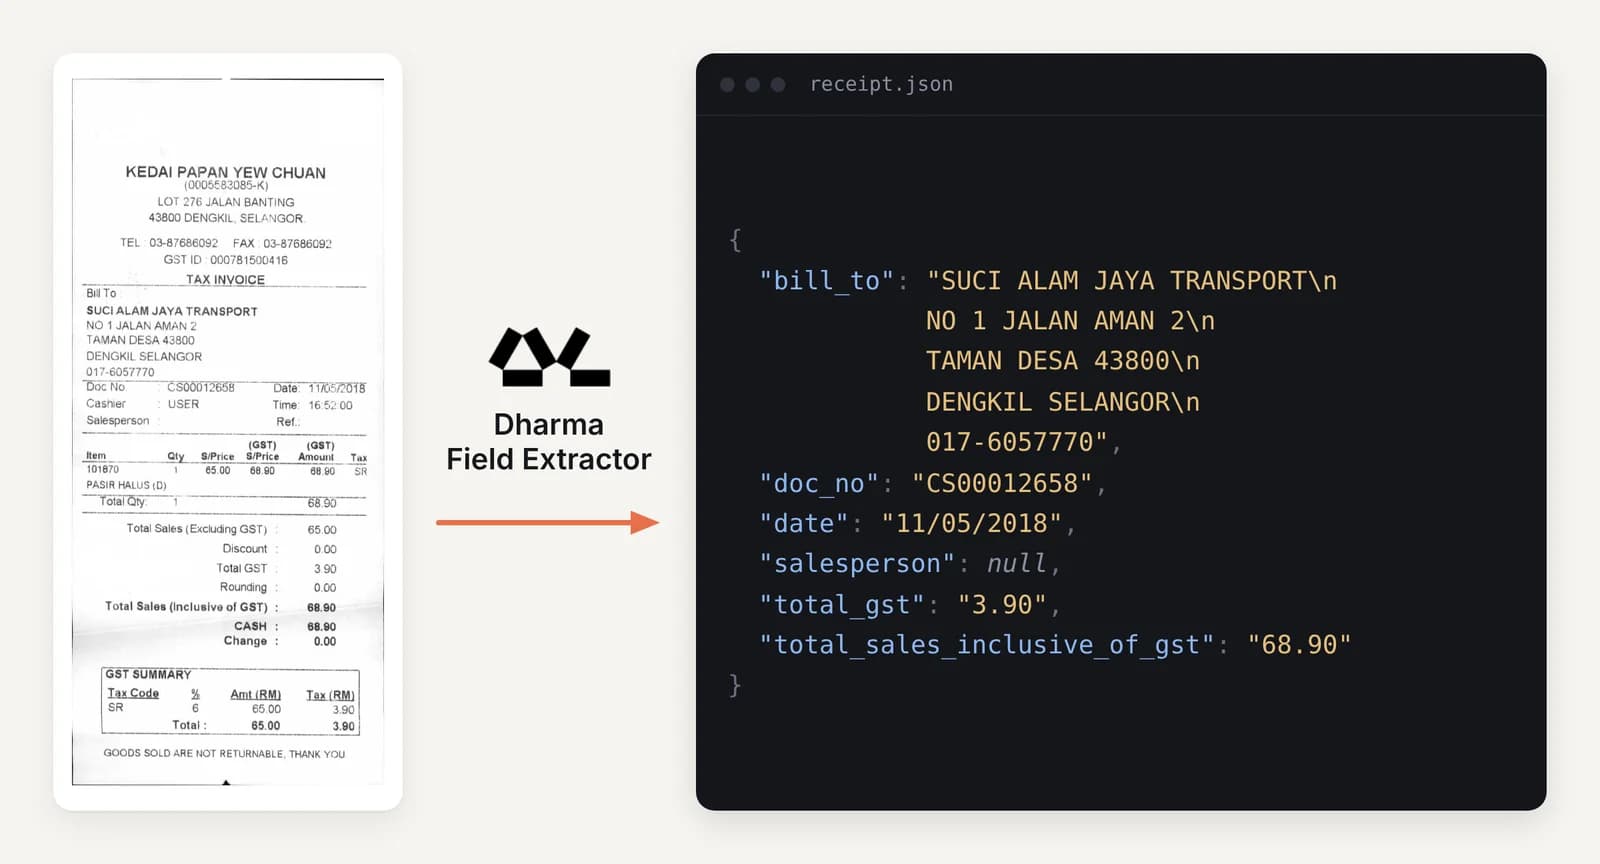
Модель с 2 миллиардами параметров, которая извлекает именно те поля, о которых вы просите, из документов любого типа, превосходя все протестированные нами передовые LLM при значительно меньшей стоимости.
В апреле мы выпустили DharmaOCR-LITE — модель, специализированную для распознавания текста (OCR) в самых разных документах: от контрактов и судебных исков до счетов, удостоверений личности и бланков. Статья paper, лежащая в ее основе, убедительно и точно обосновывает специализацию по доменам: меньшая модель, обученная ближе к своей задаче, превосходит универсальные передовые API в этой задаче.
OCR выдает текст на странице с сохранением исходного форматирования. Это именно то, что нужно, когда речь идет о документе целиком — например, о договоре, который вы читаете от корки до корки, или о рукописи, которую вы оцифровываете.
Однако существует другой сценарий использования: вам нужна не страница целиком, а конкретные поля из нее в формате, который может использовать последующая система. Каждая товарная позиция в счете-фактуре в виде списка. Имя пациента, тип обследования и дата из медицинского направления, готовые к записи на прием. Поля из удостоверения личности, сопоставленные со столбцами карточки сотрудника.
Если пропустить такой документ через OCR, вы получите все напечатанное на нем построчно, без каких-либо указаний на то, какая строка является типом обследования, какая — датой, а какое число — итоговой суммой. Кому-то все равно придется писать код, который сопоставляет каждое значение с правильным полем до того, как оно попадет в базу данных.
Универсальная LLM может справиться с этой задачей уже сегодня при условии тщательного подбора промптов. Учитывая стоимость и задержку передовых API при решении задачи, которую многим компаниям приходится выполнять в больших объемах, это быстро становится дорогим способом решения четко определенной проблемы.
Поэтому вместо этого мы создали специализированную модель. Field Extractor принимает изображение документа и либо запрос на все, что удается найти, либо точную схему для заполнения, а возвращает структурированный JSON: типизированный, поочередно для каждого поля, с вложенностью, соответствующей документу. Счет-фактура возвращается со всеми товарными позициями в виде упорядоченного списка (каждая со своим количеством и стоимостью) наряду с итоговыми суммами. Удостоверение личности возвращается в виде полей, которые вы будете хранить, под теми именами, которые ваша система уже использует для них. Один и тот же чекпойнт обрабатывает все это без необходимости дообучения под каждый тип.
Вы можете попробовать это самостоятельно here.
Что делает модель
Допустим, каждое утро поступает пакет счетов от поставщиков, и из каждого вам нужно извлечь четыре вещи для передачи в свою систему: поставщик, номер счета, срок оплаты, итоговая сумма. Та же история с медицинскими направлениями, поступающими в систему планирования, или договорами, попадающими в систему комплаенс, где значение имеют стороны, срок, штрафы и суммы взысканий. Вам не нужна страница целиком, вам нужны определенные поля. В Field Extractor запросить их можно двумя способами:
- Свободный режим (Open): схема не предоставляется. Модель читает страницу и на основе контекста и макета (а не фиксированного списка названий полей) определяет, какие ее части являются структурированными полями (метка, за которой следует значение, таблица с шапкой над столбцами), и возвращает все найденное в виде пар «ключ-значение».
- Направленный по схеме режим (Schema-directed): вы указываете точную требуемую структуру поле за полем, с типом для каждого из них (строка, число или булево значение), используя имена ключей, которые уже задействованы в вашей системе. Запросите "service_provider" и "client_company", и именно такие ключи вы получите на выходе. Запросите таблицу, и она заполнит ее строка за строкой, столбец за столбцом, сопоставляя каждую ячейку с ключом, к которому она принадлежит. Если запросить поле, которого нет в документе, модель вернет null вместо того, чтобы выдумывать значение.
Выбор сводится к тому, что вам уже известно. Отправляйте свободный запрос, когда не знаете, что содержит документ. Отправляйте схему, когда результат должен соответствовать структуре, которая уже где-то существует.
В любом случае на выходе формируется JSON: поля в качестве ключей, типизированные по запросу значения и null там, где в документе не оказалось того, что вы просили. При отправке схемы результат следует ей неукоснительно: с теми же ключами и без лишних полей, поэтому его можно сразу передавать в следующую систему.
Как модель обучалась
Базовой моделью является DharmaOCR-LITE v1.1 — новая версия с 2 миллиардами параметров, оптимизированная по сравнению с описанной в статье и уже специализированная для OCR посредством контролируемого дообучения (supervised fine-tuning) и метода DPO. Поверх этого чекпойнта мы обучили адаптер LoRA на 43 384 обучающих примерах, охватывающих оба режима запросов.
Данные организованы в три потока:
- Англоязычные многодоменные данные: разнообразные документы, собранные из открытых источников в интернете и охватывающие множество типов документов.
- Бразильские доменные данные: реальные бразильские документы, полученные из внутренних источников, на португальском языке.
- Многоязычные данные: меньшая доля, охватывающая другие европейские и азиатские языки для обеспечения более широкой генерализации за пределами английского и португальского.
Все три потока аннотированы на уровне полей. Набор данных намеренно является многодоменным: это чеки, коммерческие счета, бланки, банковские выписки, удостоверения личности и синтетические документы, а не документы какого-то одного типа.
Где бенчмарк проводит черту
Полный бенчмарк охватывает 546 документов в трех сценариях запросов, что в сумме составляет 1,638 случаев: извлечение каждого поля без схемы, частичная схема с указанием только реальных полей, а также схема, в которую намеренно включены несуществующие поля. Оценка представляет собой показатель F1 на уровне полей (сопоставление по пути, включая позицию внутри таблицы), умноженный на коэффициент сходства Левенштейна для совпавших значений и на долю результатов, возвращаемых в виде валидного JSON.
Мы провели тот же бенчмарк для четырех конфигураций универсальных передовых моделей.
По сравнению с универсальными LLM разрыв в качестве составляет от 1,8 балла (Claude Opus 5, самый близкий результат) до 9,3 балла (GPT-5.6 Luna, наибольший разрыв).
Стоимость различается примерно в 6 раз (для GPT-5.6 Luna) и примерно в 147 раз (для GPT-5.6 Sol). Ценообразование с обеих сторон устроено по-разному. Показатели для передовых моделей получены на основе измеренных средних входных и выходных токенов на страницу (включая токены рассуждения) по сравнению с опубликованными прейскурантами каждого провайдера. Каждая передовая модель работала с низким уровнем рассуждений (reasoning set to low); Claude Opus 5 использовала адаптивное усилие (adaptive effort), которое позволяет пропускать рассуждения на более простых страницах, оставаясь на низком уровне. Наша модель не тарифицируется за токены: она работает на собственной инфраструктуре, поэтому показатель рассчитывается как время работы GPU на одном ускорителе L40S из расчета $2,24 в час.
Это не отпускная цена. Стоимость самостоятельного развертывания зависит от оборудования, объема и задержки, необходимых для каждого внедрения. Это сравнение приведено здесь, чтобы показать, что суверенная малая языковая модель (SSLM), развернутая на собственной инфраструктуре, является реальной альтернативой передовым API.
Проверка генерализации
SROIE и FUNSD — это два публичных набора данных из нашего бенчмарка, которые не использовались при обучении. Ниже приведен по одному примеру из каждого.
В случае с чеком SROIE мы запросили все 18 напечатанных на нем полей, на этот раз без фиктивных полей, и каждое из них вернулось корректно: многострочный адрес выставления счета без метки распознан как единое поле, два пустых поля (продавец и номер ссылки) корректно возвращены как null, а каждое число на чеке совпало с точностью до цента.
На форме отклонений при ксерокопировании FUNSD, представляющей собой контрольный список из двенадцати булевых полей с одной вложенной группой из пяти вложенных опций, модель отмечает как истинное ровно то поле, которое отмечено галочкой (оригинал низкого качества, с рукописной пометкой «выцветший» рядом), а остальные одиннадцать — как ложные, в точности повторяя форму. Она также корректно считывает рукописный идентификатор Бейтса со страницы и возвращает null для двух оставшихся пустыми полей.
Качество и стоимость одновременно
Модель с 2 миллиардами параметров набрала 0,834 балла, опередив все протестированные нами передовые конфигурации: от Claude Opus 5 с 0,816 до GPT-5.6 Luna с 0,741, при этом работая на одном единственном L40S с более низкой стоимостью извлечения данных за запрос, чем у любого API в сравнении. Более высокое качество и более низкая стоимость, измеренные на одном и том же бенчмарке, в ходе одного запуска.
Мы измеряем это не впервые. Наша статья по OCR показала, что первая модель DharmaOCR-LITE с 3 миллиардами параметров превзошла все протестированные коммерческие передовые API на бразильском португальском языке; три месяца спустя появились более новые модели с большими ресурсами, но разрыв сохранился. Теперь модель с 2 миллиардами параметров делает это при извлечении полей. Каждый результат добавляет веса тезису, с которого мы начинали Dharma-AI: в рамках ограниченной задачи небольшая модель, обученная близко к этой задаче, превосходит передовую модель, от которой требуют выполнения того же самого в общем виде. В данном бенчмарке ее запуск также обошелся в 6–147 раз дешевле.
Количество параметров задает верхний предел; обучение определяет, какую его часть модель задействует для вашей задачи. Вашему бизнесу не нужна самая крупная из доступных моделей. Ему нужна модель, обученная под вашу проблему.
Попробуйте ее на ваших собственных документах . Чтобы узнать больше о Dharma-AI и специализированных моделях, которые мы создаем, посетите dharma-ai.com.
Источники
- BID. Бразильский набор данных документов, удостоверяющих личность. Soares, Neves Jr., Bezerra (2020), "BID Dataset: a challenge dataset for document processing tasks," Anais Estendidos XXXIII SIBGRAPI. github.com/ricardobnjunior/Brazilian-Identity-Document-Dataset
- CORD. Park et al., NAVER CLOVA (2019). huggingface.co/datasets/naver-clova-ix/cord-v2
- DocVQA. Mathew et al., WACV 2021 (ICDAR 2019). huggingface.co/datasets/lmms-lab/DocVQA
- WildReceipt. Sun et al., IJCAI 2021. huggingface.co/datasets/Theivaprakasham/wildreceipt
- SROIE (ICDAR 2019). Исключено из обучения, только оценка. huggingface.co/datasets/darentang/sroie (зеркало); первоисточник rrc.cvc.uab.es/?ch=13
- FUNSD. Jaume et al. Исключено из обучения, только оценка. huggingface.co/datasets/nielsr/funsd (зеркало); guillaumejaume.github.io/FUNSD
- Счета Zenodo (PT). Cruz & Castelli, NOVA IMS (2022). zenodo.org/records/6371710
- line_items. Sagarjha456, Hugging Face. huggingface.co/datasets/Sagarjha456/line_items
- Счета Katanaml (Donut). Kozłowski & Weichbroth (2021), Mendeley Data doi:10.17632/tnj49gpmtz.2. huggingface.co/datasets/katanaml-org/invoices-donut-data-v1
- Набор данных бразильских счетов и квитанций HumynLabs. huggingface.co/datasets/HumynLabs/Brazilian_Bills_and_Invoices_Dataset
- Извлечение документов Tech4Humans BR-Doc. huggingface.co/datasets/tech4humans/br-doc-extraction
- Cardoso, Gabriel Pimenta de Freitas, et al. "DharmaOCR: Specialized Small Language Models for Structured OCR that outperform Open-Source and Commercial Baselines." Препринт arXiv (2026).
Дополнительное чтение
- Как специализация словаря малых языковых моделей (SLM) может сократить затраты на вывод на 77% в реальных приложениях
- Тот же кластер, утилизация выше на 33 пункта: изменился порядок
- Управление графическими процессорами: почему простаивающие GPU — это новые самолеты на приколе
- Более новые модели, то же преимущество
- Почему специализация неизбежна
- Специализация превосходит масштаб: стратегическая переменная, которую большинство решений по закупке ИИ упускают из виду
- Вырождение текста: режим сбоя в продакшене, который большинство бенчмарков не отслеживают
- Оптимизация прямых предпочтений за пределами чат-ботов
Изучите Dharma AI на Hugging Face, чтобы опробовать наши интерактивные демо-версии, загрузить наши модели с открытым исходным кодом и узнать, как специализированные ИИ-системы превосходят модели общего назначения в реальных корпоративных приложениях.