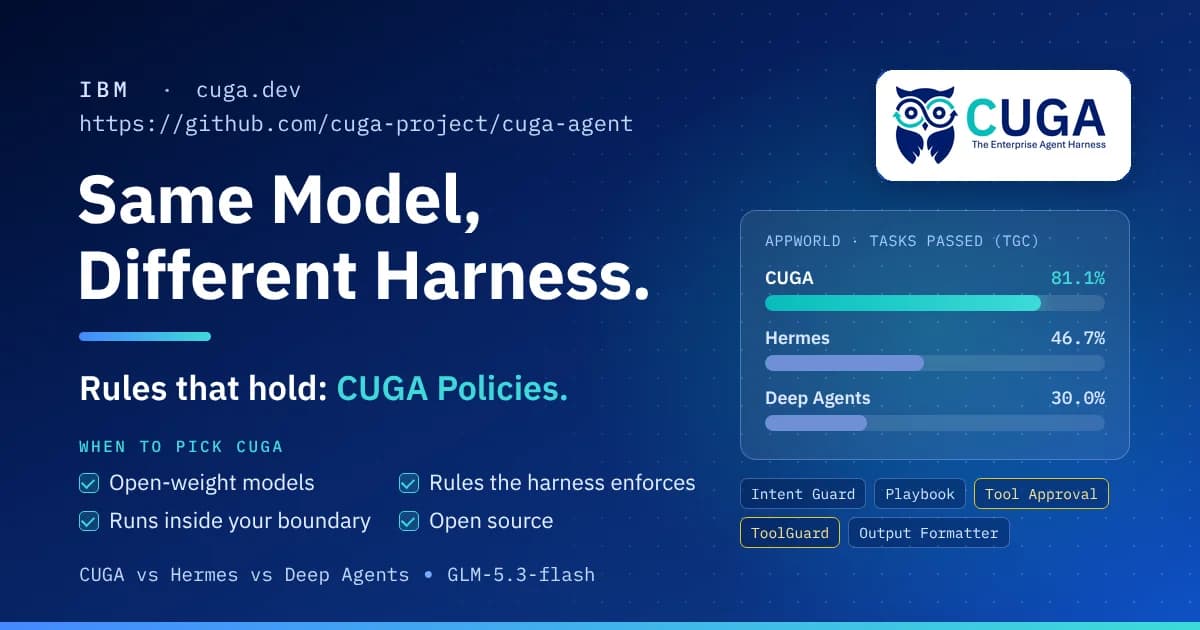
На выбор предлагается почти 200 агентских обвязок (harnesses). Мы дали трем из них одну и ту же модель с открытыми весами и 90 задач AppWorld, и смена обвязки изменила показатель успешности выполнения задач с 30% до 81%. Для корпоративного использования CUGA добавляет то, что этот бенчмарк не тестирует: правила, которые обвязка принудительно соблюдает, и развертывание внутри вашего собственного периметра.
Сообщества ведут списки, такие как awesome-agent-harness и best-of-Agent-Harnesses, в которых отслеживается почти 200 таких инструментов, и они четко доносят одну мысль: важна не только модель, но и обвязка. В одном из анализов, на который ссылается рейтинг лучших агентских обвязок, та же модель GLM-5.2 показала рост с 23% до 52% на SWE-bench Pro при изменении только обвязки.
Поэтому правильный вопрос звучит не «какая обвязка лучше?», а «какая обвязка подходит для моей рабочей нагрузки и моей модели?». Hermes от Nous Research создана для постоянных персональных ассистентов, а Deep Agents от LangChain — для долгих многоэтапных задач, таких как исследования. Обе они отлично справляются со своими задачами.
Корпоративная работа — это другая задача. Агенты действуют в бизнес-системах, таких как CRM и платежи, и они должны следовать правилам, которые действуют независимо от решений модели. CUGA (ConfigUrable Generalist Agent) — это обвязка с открытым исходным кодом от IBM, созданная для таких задач, работающая с моделями с открытыми весами или хостинговыми моделями внутри вашей собственной среды, включая суверенные облака и изолированные (air-gapped) среды. Чтобы измерить то, что добавляет обвязка, мы оставили модель прежней и изменили только обвязку.
Контролируемый эксперимент: та же модель, другая обвязка
Мы запустили CUGA, Hermes и Deep Agents на AppWorld, бенчмарке многоэтапных задач в 9 приложениях и 457 API, таких как электронная почта, платежи и файловое хранилище. Эти приложения являются потребительскими, поэтому AppWorld выступает в роли прокси: он тестирует подмножество возможностей, которые также необходимы корпоративной автоматизации, таких как вход в систему, чтение документации API, постраничный вывод результатов и изменение состояния в нескольких приложениях. Каждая обвязка использовала одну и ту же модель с открытыми весами, GLM-5.3-flash, на тех же 90 задачах в 30 сценариях, с одной попыткой на задачу. Все запуски использовали фреймворк оценки Harbor, а наша конфигурация опубликована в harbor-eval, нашем форке Harbor.
Результаты
AppWorld, 90 задач в 30 сценариях, GLM-5.3-flash
TGC: успешно пройденные задачи SGC: сценарии, в которых прошли все 3 варианта
CUGA
81.1 (73/90)
66.7 (20/30)
Hermes
46.7 (42/90)
26.7 (8/30)
Deep Agents
30.0 (27/90)
6.7 (2/30)
Рисунок 1. AppWorld, 90 задач в 30 сценариях, GLM-5.3-flash для каждой обвязки. TGC: успешно пройденные задачи. SGC: сценарии, в которых прошли все три варианта.
Как это читать. Это не приговор Hermes или Deep Agents. Ни та, ни другая не создавались для работы с многоаппликативными API, как в AppWorld, и в этом суть: обвязка должна соответствовать задаче.
Самое полезное число — SGC. Сценарий считается пройденным только тогда, когда проходят все три его варианта, поэтому SGC вознаграждает за стабильность, а не за удачный запуск. Здесь разрыв больше: 20 сценариев для CUGA, 8 для Hermes и 2 для Deep Agents.
Применимы три ограничения. Это выборка из 90 задач на одном бенчмарке, поэтому результаты могут не распространяться на другие задачи. Настройки не были идентичными (см. таблицу настроек выше). Кроме того, в заходах не использовались политики, поэтому они не измеряют соблюдение политик.
Откуда берутся баллы
В сравнении 90 задач модель была одинаковой в каждом запуске, поэтому различия обусловлены обвязкой. Каждый агент CUGA выполняет один и тот же компактный цикл: подготовка, вызов модели, выполнение и повторение. Этот цикл масштабируется от одного агента CugaAgent с его собственными инструментами до супервизора CugaSupervisor, координирующего несколько агентов локально или удаленно по протоколу A2A. Вот функции CUGA, которые работали в настройке AppWorld, сгруппированные по их назначению:
🧭 Планирование работы
Декомпозиция задач: разбивает задачу на шаги, по одному приложению за раз
Специализированные инструменты: каждый шаг видит инструменты своего приложения и несколько общих, а не все 469
Инструмент подбора инструментов (Tool shortlister): find_tools ищет любой другой инструмент, необходимый для шага
🐍 Действия в коде
CodeAct: модель пишет код на Python, который вызывает API приложений
Песочница: код выполняется в ограниченной среде с ограничением по времени
🔍 Проверка перед действием
Проверка перед выполнением: проверка оценивает каждый блок кода, который изменяет данные, перед его запуском
🔁 Проверка после действия
Автоматическая рефлексия: анализирует результаты и позволяет агенту скорректировать свой план
Аудит пагинации: отмечает вызов списка, который возвращает полную страницу, когда следующая страница никогда не запрашивалась
Благодаря этим функциям модель принимает меньше решений, а обвязка перехватывает больше ошибок до того, как они повлияют на результат.
Каждый шаг, которым владеет обвязка, является точкой принудительного контроля
Каждый шаг, контролируемый обвязкой, например те, что приведены в списке выше, также является местом, где она может проверить правило.
Большинство команд прописывают бизнес-правила, такие как одобрение платежей или сохранение конфиденциальных данных клиентов (PII) внутри организации, в системном промпте. Промпт — это инструкция, а не принудительное ограничение. Модель может прочитать его неправильно, пользователь может отговорить агента от его выполнения, а инъецированное сообщение может изменить его в середине выполнения задачи.
Политики CUGA переносят эти правила из промпта в обвязку. Мы описываем этот уровень политик в нашей статье для ACM CAIS 2026: «Управление на основе конструирования для агентов общего назначения» (arXiv). Политики действуют в четырех точках при каждом запуске:
Методические указания направляют модель, но одобрения и средства ToolGuards принудительно исполняются средой выполнения. Поместите такие правила, как одобрение платежей и обработку PII, во вторую группу, где они выполняются независимо от того, что решит модель.
Вы можете убедиться в разнице самостоятельно в Policy Playground, которая отправляет одно и то же сообщение двум работающим агентам: один без политик, а другой с ними:
Рисунок 2. На запрос «Оплатить все, что я должен» агент без политик выплатил 90 долларов, включая отклоненную претензию по сборам. Агент с политиками задержал платеж для утверждения, а затем выплатил только 10 долларов, которые действительно подлежали уплате.
Почему стоит выбрать CUGA
Выбирайте обвязку так же тщательно, как и модель. В нашем сравнении одна и та же модель выполнила от 30% до 81% задач AppWorld в зависимости от обвязки. Для корпоративной работы CUGA предоставляет:
- Высокие результаты, теперь и с моделями с открытыми весами. С хостинговыми моделями CUGA удерживала 1-е место на WebArena (с февраля по сентябрь 2025 г.) и на AppWorld (с июля 2025 г. по февраль 2026 г.).
- Правила, которые принудительно соблюдаются средой выполнения. Одобрения и средства защиты инструментов останавливают вызов на уровне обвязки, независимо от того, что решает модель.
- Развертывание внутри вашего суверенного периметра. CUGA имеет лицензию Apache 2.0, работает с любым эндпоинтом, совместимым с OpenAI, и запускается локально, в Kubernetes в вашем частном или суверенном облаке, или даже в изолированном суверенном кластере с входом через OIDC и раздельными ролями чата и управления. IBM Sovereign Core создана на базе CUGA для запуска агентов полностью внутри периметра клиента.
- Измеримые затраты. Бюджеты ограничивают расходы, а квитанции о запуске показывают токены, вызовы инструментов и время для каждого запуска.
- Конфигурация, а не код. Настраивайте инструменты, бюджетирование и политики в пользовательском интерфейсе или SDK, тестируйте черновик и публикуйте версию.
Когда выбрать что-то другое
CUGA — подходящая обвязка далеко не для каждой задачи:
- Для терминального агента-программиста используйте opencode, Codex или Claude Code.
- Для персонального постоянного помощника, живущего в ваших чат-приложениях, используйте OpenClaw или Hermes.
- Для фреймворка графов с чистого листа используйте LangGraph напрямую. CUGA построена на его основе.
CUGA предназначена для автоматизации бизнес-процессов через API, приложения и веб-интерфейсы в соответствии с правилами, которые вы можете задавать.
Попробуйте CUGA
- 🛡️ Полигон политик · руководство по политикам
- 🧪 Воспроизвести сравнение
- ⭐ Добавить CUGA в избранное на GitHub
Команда CUGA провела это сравнение, причем CUGA использовала конфигурацию AppWorld, которую другие инструменты не использовали. Если вы можете настроить Hermes или Deep Agents на лучший результат, отправьте конфигурацию на . Мы запустим ее повторно на тех же задачах и опубликуем результаты, независимо от того, какой инструмент победит.