Mistral Large 4 (он же Le Chonk) — это мультимодальная многоязычная модель типа «Смесь экспертов» (MoE) от Mistral. Она принимает на вход текст и изображения и генерирует текст. Модель имеет около 1 трлн общих параметров, 49 млрд активных параметров и контекстное окно в 1 млн токенов.
Модель выпускается в двух официальных вариантах:
- FP8
- NVFP4
Также существуют GGUF-версии, созданные командами Unsloth и llama.cpp. Она распространяется под лицензией Mistral Ecosystem Open-Weight License (производная от MIT, которая устанавливает ограничения для предложений модели как услуги).
Mistral Large 4 особенно сильна в кибербезопасности, агентах для написания кода и мультимодальности. В этой статье мы рассмотрим, как работает эта модель, ее возможности, архитектуру и многое другое!
Содержание
- Содержание статьи «Добро пожаловать, Le Chonk: Mistral Large 4 на Hugging Face» Что нового в Mistral Large 4 Возможности кибербезопасности Архитектура Визуальный энкодер Результаты бенчмарков Поддержка инференса Transformers vLLM Llama.cpp Дообучение с помощью TRL Эндпоинты инференса Dell Enterprise Hub Попробуйте в деле
- Содержание
- Что нового в Mistral Large 4 Возможности кибербезопасности
- Возможности кибербезопасности
- Архитектура Визуальный энкодер
- Визуальный энкодер
- Результаты бенчмарков
- Поддержка инференса Transformers vLLM Llama.cpp
- Transformers
- vLLM
- Llama.cpp
- Дообучение с помощью TRL
- Эндпоинты инференса
- Dell Enterprise Hub
- Попробуйте в деле
Что нового в Mistral Large 4
Mistral Large 4 объединяет большой пул экспертов с разреженным вниманием (sparse attention) и визуальным энкодером Pixtral. Языковая модель выбирает небольшую группу экспертов для каждого токена, в то время как ее индекс внимания определяет, к каким более ранним позициям токенов следует обратиться. Это две разные формы разреженности: одна выбирает сети прямой связи, а другая — позиции контекста.
Вы можете найти все контрольные точки (чекпоинты) в коллекции Mistral Large 4.
Возможности кибербезопасности
Mistral Large 4 набирает 82% в тесте Artificial Analysis Cyber Index, в котором модели предлагается воспроизвести реальную уязвимость в программном обеспечении с открытым исходным кодом, а затем исправить его. Mistral сообщает, что несколько закрытых передовых моделей набирают почти ноль в том же тесте, потому что отказываются выполнять эту работу. Это крайне важно для защитников, поскольку устранение уязвимости обычно требует ее воспроизведения. По данным внутренних тестов Mistral, модель Mistral Large 4 также оказалась полезна для анализа вредоносного ПО, расстановки приоритетов уязвимостей и написания правил обнаружения, для чего модель явно не обучалась.
Mistral позиционирует модель в основном для оборонительных задач в сфере безопасности. Исследования уязвимостей и реагирование на инциденты часто выглядят как атаки во входных данных модели, поэтому фильтры с закрытым исходным кодом могут их блокировать. Команда, зависящая от API, также может потерять доступ прямо посреди инцидента. Что особенно важно, модели с открытыми весами дают пользователю полный контроль как над политикой использования, тем не менее, модель по-прежнему отклоняет вредоносные запросы: по киберзапросам от JailbreakBench, StrongREJECT и AgentHarm ее средний показатель отказов выше, чем у любой другой модели с открытыми весами.
Для разработчиков сообщества модель с открытыми весами, такая как Mistral Large 4, открывает множество вариантов применения. Вы можете построить собственную систему кибербезопасности вокруг своей кодовой базы, журналов сбоев и образцов вредоносного ПО. Например, с помощью TRL вы можете дообучить меньшие модели на траекториях Mistral Large 4, исправляющих вашу кодовую базу. Фактически задачи по воспроизведению и последующему исправлению используют проверяемое вознаграждение, поэтому это хорошо вписывается в среды обучения с подкреплением (RL), которые можно использовать для дальнейшего обучения меньших моделей безопасности с помощью RL. Открытые веса также позволяют исследователям напрямую измерять поведение модели в отношении отказов, а не полагаться на описание провайдера.
Кратко говоря, появление таких кибервозможностей, как у ML4, в открытом доступе — это огромный импульс для сообщества.
Мы взяли интервью у Пьера Стокка (Pierre Stock) о кибервозможностях модели, вы можете посмотреть его здесь.
Мы взяли интервью у Пьера Стокка (Pierre Stock) о кибервозможностях модели, вы можете посмотреть его здесь.
Архитектура
Текстовый декодер Mistral Large 4 имеет 72 слоя, размерность скрытого пространства 6 144 и 64 головы внимания. Его блоки внимания сочетают многоголовое латентное внимание (MLA) с индексатором разреженного внимания DeepSeek (DSA) (направление, используемое и в других моделях, таких как GLM 5.3). MLA сохраняет сжатое представление KV, а DSA выбирает до 2 048 ключевых позиций для каждого запроса.
Для каждого блока декодера используется паттерн 3:1 RoPE и NoPE, то есть 3 слоя декодера используют RoPE, а каждый четвертый слой использует NoPE. Модель также разделяет состояние KV между слоями. Первый слой декодера использует плотную сеть прямой связи. Остальные 71 слой используют блоки MoE, в которых softmax-маршрутизатор выбирает четыре из 128 экспертов для каждого токена. Один общий эксперт всегда работает вместе с выбранными экспертами, в общей сложности получается 5 активных экспертов на токен.
Что касается RoPE, Mistral использует LeRope — масштабируемую с помощью YaRN разновидность RoPE с одним обучаемым мультипликатором на каждую частоту.
Визуальный энкодер
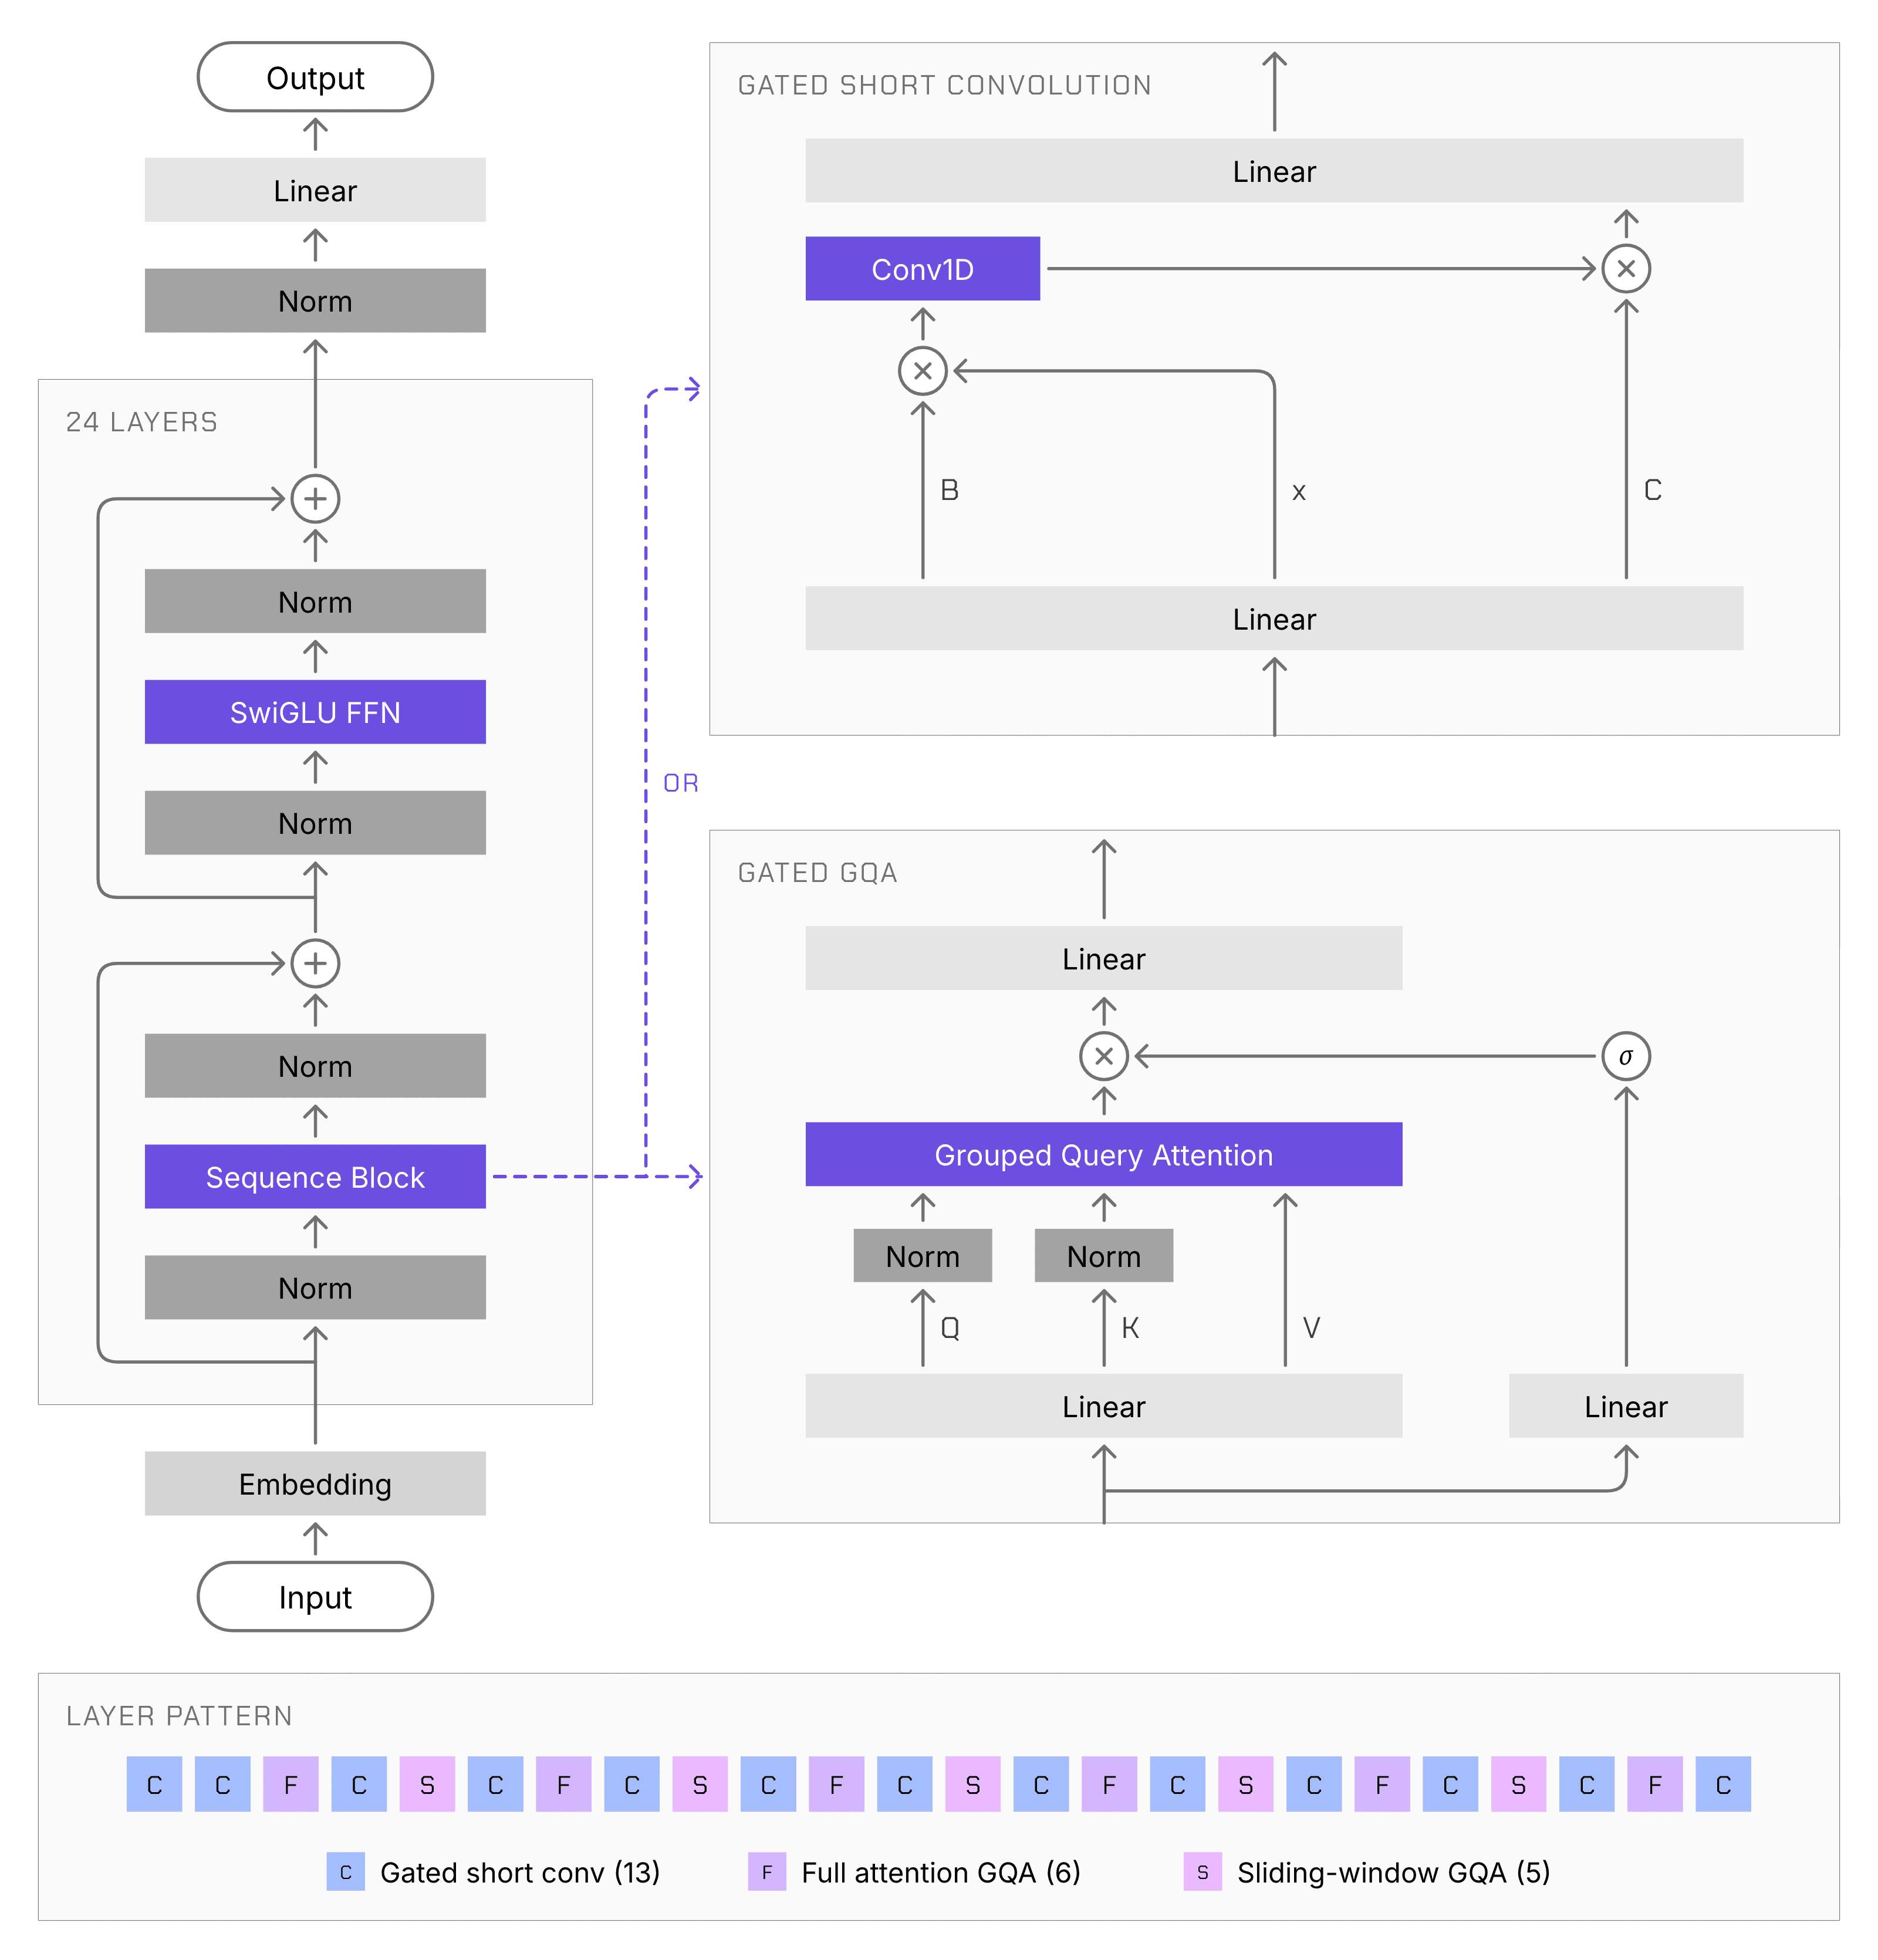
Mistral Large 4 использует энкодер Pixtral на 1,6 млрд параметров. Pixtral имеет 30 слоев, размерность скрытого пространства 2 048 и 16 голов внимания. В нем используются патчи 14 × 14 и проектор объединения патчей с размером пространственного объединения 2. Ниже вы можете увидеть конвейер энкодера.
Результаты бенчмарков
Mistral Large 4 демонстрирует высокие результаты в бенчмарках в области программирования, кибербезопасности, мультимодального понимания и агентных рабочих процессов, что делает ее конкурентоспособным дополнением к экосистеме моделей с открытыми весами. По состоянию на 29 октября 2026 года модель занимает пятое место среди моделей с открытыми весами в индексе интеллекта Artificial Analysis.
В программировании ML4 достигает 61,7% на DeepSWE v1.1, 59.4% на SWE-Atlas-QnA и 28.3% на Terminal-Bench 4. Ее общий балл в индексе кодинг-агентов (Coding Agent Index), составляющий 49.8%, ставит ее выше DeepSeek V4 Pro 0813 и Qwen3.8 Max.
Возможности ML4 в написании кода распространяются и на интеллектуальную работу: 59,9% в AutomationBench и 1393 Elo в AA-Briefcase, которые оценивают бизнес-процессы и долгосрочные профессиональные задачи.
Кибербезопасность — одна из наиболее ярких возможностей Mistral Large 4, демонстрирующая высокие результаты в оценке реальных уязвимостей и задачах соревнований по безопасности. Три бенчмарка подчеркивают показатели модели в области кибербезопасности:
- Artificial Analysis Cyber Index: ML4 входит в пятерку лучших моделей в мире по результатам этой независимой оценки способности моделей находить и исправлять уязвимости в программном обеспечении.
- Воспроизведение уязвимостей и их исправление: модель набирает 82%, что является самым высоким зарегистрированным баллом в этом тесте в рамках индекса. Задача требует воспроизведения реальной уязвимости в программном обеспечении с открытым исходным кодом и ее последующего исправления, что проверяет как навыки расследования, так и устранения последствий.
- Cybench: ML4 успешно справляется с 93% из набора из 40 задач, взятых из соревнований по безопасности, демонстрируя высокую эффективность в решении практических проблем безопасности.
Mistral Large 4 также демонстрирует 93,3% устойчивости к атакам в бенчмарке B3 от Lakera, что подтверждает ее надежность против атак с внедрением промптов (prompt-injection). Помимо бенчмарков, внутреннее тестирование показало многообещающие результаты в анализе вредоносного ПО, приоритизации уязвимостей и генерации правил обнаружения.
Поддержка инференса
Mistral Large 4 поставляется с поддержкой «первого дня» для transformers, vLLM и llama.cpp. Квантованные версии GGUF доступны от команды GGUF и llama.cpp. Мы предоставляем возможности для удаленного развертывания с помощью Inference Endpoints, а также использования бессерверного вывода через Inference Providers.
Transformers
Реализация в Transformers предоставляет AutoModelForMultimodalLM, а AutoProcessor подготавливает входные данные разговора и изображений. Mistral Large 4 может принимать параметры reasoning_effort: low, medium, high. По умолчанию установлено значение high, при этом учтите, что рассуждения нельзя отключить, поэтому использование reasoning_effort: none все равно приведет к применению high.
Чтобы запустить модель, обновите пакет transformers
Вы можете запустить приведенный выше скрипт, сохранив его в файле python script.py, а затем выполнив
vLLM
vLLM поддерживает высококачественный чекпоинт NVFP4 для Mistral Large 4, который имеет меньший объем памяти и требует графических процессоров NVIDIA Blackwell. Модель также поставляется с drafter DSpark для дополнительного ускорения с помощью vLLM. Запустите сервер следующим образом:
После того как сервер запустится и начнет работу, вы можете выполнить следующее.
Llama.cpp
Llama.cpp и Llama App уже поддерживают Mistral Large 4.
Вы можете установить Llama App с помощью следующей команды:
Затем вы можете запустить сервер следующим образом, указав суффикс квантования после идентификатора модели:
Вот репозиторий с квантованными версиями, созданными на основе чекпоинта FP8, а это версия NVFP4, конвертированная из официального репозитория NVFP4.
После запуска сервера вы можете перейти на localhost:9931, чтобы общаться с помощью встроенного WebUI. В веб-интерфейсе вы можете добавлять изображения для инференса и настраивать уровень рассуждений. Вы также можете отправлять запросы на сервер следующим образом. Обязательно ознакомьтесь с справочником по API для работы с мультимодальностью, вызовами инструментов и многим другим.
Вы можете запустить инференс «изображение-текст» следующим образом.
Команда llama.cpp поставляет следующие квантованные версии для дальнейшего преобразования: IQ2_XXS, Q2_K, Q4_K_M, NVFP4, Q8_0 и BF16. 2-битные квантованные версии работают на одном компьютере Apple Silicon Ultra с 512 ГБ объединенной оперативной памяти. Для остальных требуется распределенный вывод. Вы также можете запускать их на нескольких картах NVIDIA или AMD.
Запуская Q2_K на одном M3 Ultra, мы получили пропускную способность предварительного заполнения (prefill) около 90 токенов в секунду и скорость генерации 15 токенов в секунду. На 4 x RTX6000 Pro мы наблюдали следующие результаты:
- NVFP4: размер контекста 32K, предварительное заполнение 130–590 т/с, скорость генерации ~10 т/с
- IQ2_XXS: размер контекста 800K. При небольших размерах контекста предварительное заполнение составляет 500 токенов в секунду, а генерация работает со скоростью 30 токенов в секунду. Однако при использовании длинного контекста производительность падает до 129 токенов в секунду (предварительное заполнение) и 3 токенов в секунду (генерация).
Дообучение с помощью TRL
Мы также обеспечиваем поддержку «первого дня» для дообучения Mistral Large 4 с использованием TRL. Все, что вам нужно сделать, это обновиться до последних версий transformers, trl и peft.
В следующем примере мы обучаем модель выполнять многоязычное мышление. Дообученная модель сможет рассуждать на том языке, о котором просит системный промпт!
Скрипт работает с вариантом FP8 на узле из 8xB300.
Inference Endpoints
Mistral Large 4 также доступна на Inference Endpoints с готовым к развертыванию рецептом на 8 графических процессорах NVIDIA H200. Рецепт запускает vLLM с весами FP8, разделенными между всеми восемью графическими процессорами с использованием тензорного параллелизма и параллелизма экспертов, а также использует встроенную черновую голову (draft head) DSpark для более быстрой генерации за счет спекулятивного декодирования. Он обслуживает до 131K токенов контекста и обрабатывает до 16 запросов одновременно, и мы наблюдали следующие результаты:
- Один запрос: время до первого токена около 0,6 секунды для промпта размером 1K токенов и скорость генерации ~65 токенов в секунду, достигающая 120–138 токенов в секунду на чат-промптах, где принимаются черновики DSpark.
- Длинные промпты: промпты размером 16K токенов, по четыре одновременно, предварительно заполняются со скоростью около 4300 токенов в секунду в сумме, со временем до первого токена 8–9 секунд.
- Под нагрузкой: около 480 токенов в секунду общей генерации по 1000 диалогам ShareGPT.
Вы можете развернуть ее с помощью CLI hf следующим образом:
После запуска эндпоинта вы можете отправлять запросы к его API, совместимому с OpenAI, используя URL-адрес эндпоинта и ваш токен Hugging Face. Поле reasoning_effort управляет тем, насколько интенсивно модель рассуждает перед ответом, и может быть установлено в значение low, medium или high (по умолчанию).
Ответ возвращается в choices[0].message.content, а рассуждения — в choices[0].message.reasoning. Эндпоинт также поддерживает вызовы инструментов, структурированные выходы, ввод изображений и потоковую передачу через стандартные поля Chat Completions.
Dell Enterprise Hub
Самый простой способ начать работу с серверами Dell AI (NVIDIA H200, B200, GB200 или GB300) — установить CLI dell-ai:
И используйте его для запуска оптимизированного рецепта для Mistral Large 4, например, на узле NVIDIA B300.
Вы можете узнать больше об этом релизе в Dell Enterprise Hub (DEH).
Попробуйте
Получите веса из коллекции Mistral Large 4, запустите их локально с помощью GGUF или разверните с помощью Inference Endpoints. Нам не терпится увидеть, что вы создадите с помощью Le Chonk. Поделитесь своими результатами дообучения, квантования и другими артефактами в Hub!