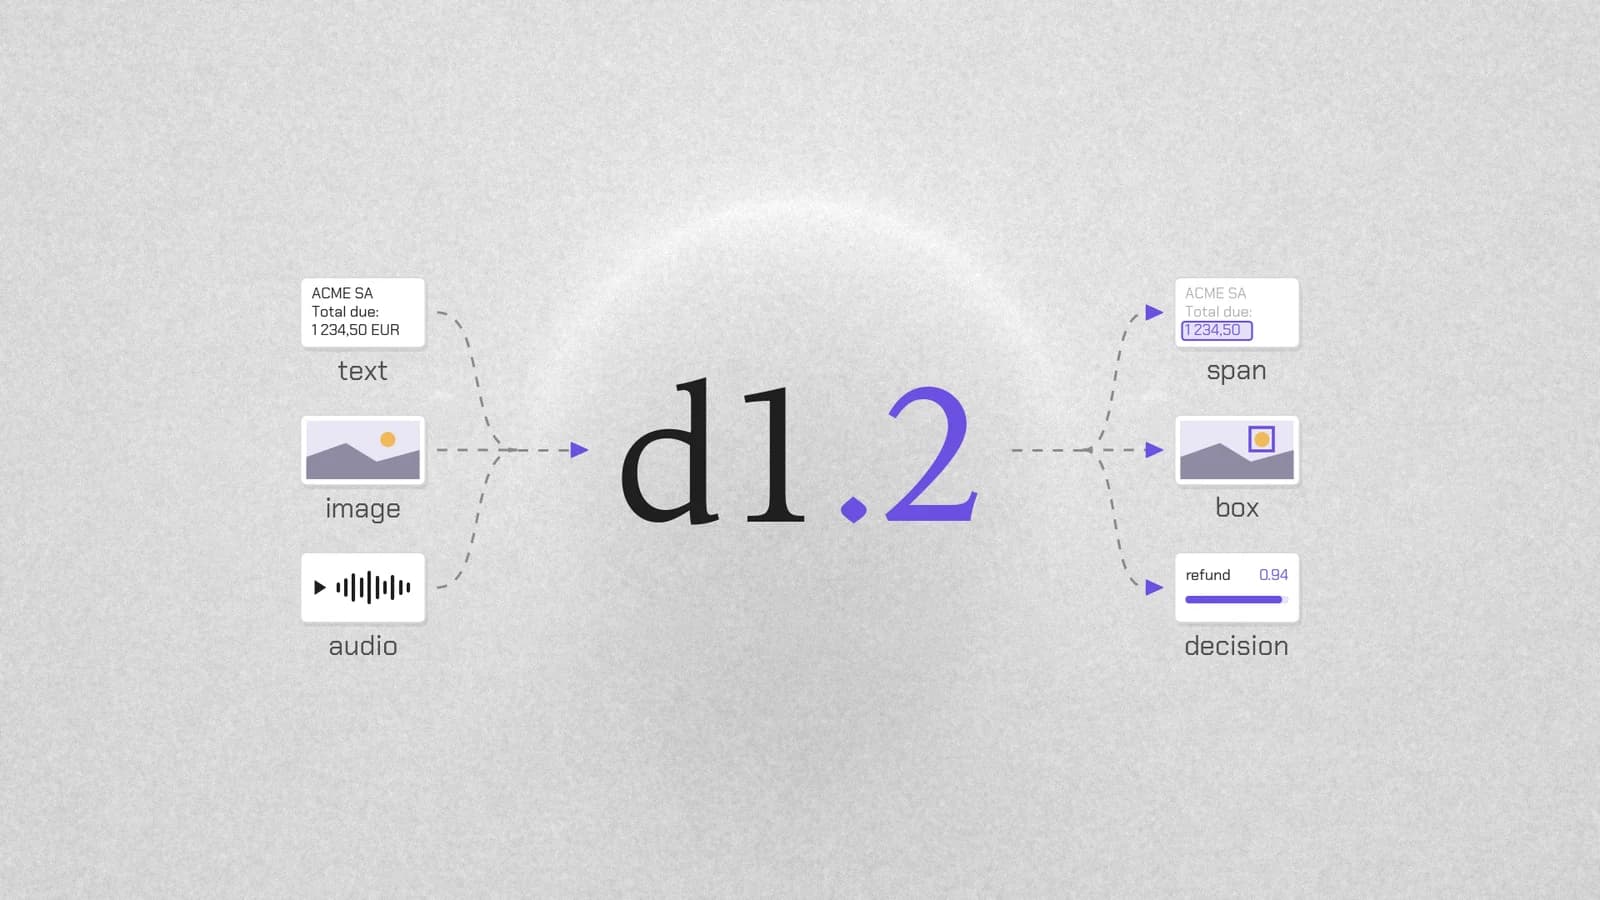
Сегодня мы выпускаем d1.2 и d1.2-ultra, новые версии наших моделей принятия решений, которые теперь поддерживают ввод аудио и пять новых задач. Кроме того, d1.2-ultra занимает первое место среди моделей принятия решений в индексе Artificial Analysis Decision Index v2.1.
Обе модели доступны уже сегодня через Liquid API по цене $0,02 за d1.2 и $0,042 за миллион входных токенов для d1.2-ultra.
d1.2 и d1.2-ultra добавляют пять новых задач в API:
- Чтение значения из входных данных (текст, число или дата). Задайте вопрос «Сколько нужно оплатить?» по счету, и модель вернет правильное значение вместе с символами, из которых она его считала. Если в счете нет этого значения, она ответит «не найдено» вместо того, чтобы угадывать.
- Поиск всех фрагментов определенного типа в тексте (диапазоны). Например, запросите все персональные данные в заметке, и модель вернет каждый фрагмент, такой как имя, номер телефона и адрес электронной почты, с указанием его позиции в тексте.
- Поиск объектов на изображении (рамка для одного объекта, рамки для всех экземпляров). Например, спросите, где находится подпись на отсканированном бланке, и модель вернет прямоугольник вокруг нее (или «не найдено»). Запросите все деревья на фотографии, и она вернет прямоугольник вокруг каждого дерева и их количество.
- Оценка числа (число с диапазоном). Спросите, сколько людей на фотографии, и модель вернет свое лучшее предположение (например, 12) и диапазон (например, от 10 до 14).
- Выбор всех применимых вариантов (выбор с параметром multiple, установленным в true). Спросите, какие темы затрагиваются в сообщении службы поддержки, и модель вернет каждую применимую тему, например «биллинг» и «доставка», каждую с указанием вероятности.
d1.2 и d1.2-ultra также принимают аудио в качестве входных данных. Это аудио может быть тем, о чем вы спрашиваете, например, на каком языке говорит человек или есть ли на фоне сирена. Сам вопрос также может быть записан в виде аудио, а не набран текстом.
Artificial Analysis Decision Index
Индекс Artificial Analysis Decision Index v2.1 оценивает модели принятия решений по шести критериям: от принятия решений и извлечения данных из резюме, квитанций и научных статей до вызова инструментов и сложных вопросов на проверку знаний. Он также оценивает вероятность, которую модель присваивает каждому ответу, поэтому уверенный неправильный ответ «стоит» дороже, чем неуверенный.
d1.2-ultra набирает 75 баллов — это самый высокий показатель в индексе, на два балла опережающий предыдущую лучшую модель принятия решений.
Обе модели также показывают лучший результат с точки зрения стоимости. В Decision Index v2.1 ни одна модель не набирает больше баллов, чем d1.2 за меньшие деньги, и ни одна модель не набирает больше баллов, чем d1.2-ultra при любой цене.
Калибровка
Вероятности, предоставляемые моделью принятия решений, полезны только в том случае, если они верны. Когда модель говорит «80%», она должна быть права примерно в 80% случаев, что позволяет вам установить пороговое значение. Например, вы можете автоматически отправлять задачи, в которых модель не уверена, на проверку человеку.
Ошибка калибровки измеряет разрыв между предсказанной моделью вероятностью и тем, как часто она оказывается права. По результатам 13 тестов и 22 505 вопросов, на которые ответили все пять моделей, ошибка калибровки d1.2-ultra составляет 0,8 пункта по сравнению с 1,2 для d1.2, 2,7 для Jev 1.14, 3,7 для Decider v1.3 от Perplexity и 7,2 для GPT-6 Luna в ее Decisions API.
Точность в новых задачах
Пока не существует публичного теста для измерения пяти новых задач, поэтому мы оценивали их на внутренних тестовых наборах, созданных из отложенных выборок публичных датасетов. В этих внутренних тестах чтение или рамка считаются правильными, если модель находит цель или сообщает «не найдено», когда цель отсутствует.
Задача
d1.2-ultra
d1.2
Чтение значения из квитанции (CORD, SROIE)
98%
96%
Поиск всех персональных данных в документе, точность / полнота (Nemotron PII)
94% / 93%
92% / 88%
Поиск объекта, описанного на фото (RefCOCO, RefCOCO+, RefCOCOg)
94%
94%
Оценка количества объектов на фото, с погрешностью в один (COCO)
93%
92%
Выбор всех объектов, присутствующих на фото ()
87%
90%
На отложенных записях обе модели отвечают правильно в 95–97% случаев на вопросы о том, какой звук они слышат (ESC-50) или на каком языке говорят (FLEURS, 43 языка). Каждый вопрос предлагает от трех до шести вариантов ответа, включая близкие по звучанию, такие как испанский и португальский, или требует ответа «да/нет».
Доступность и цены
Вызывайте модели как d1.2-ultra и d1.2 через Liquid API, используя ключ из console.liquid.ai (Dashboard > API Keys).
Новые типы ответов используют тот же эндпоинт и формат запроса. В этом примере считываются три значения из счета и запрашивается четвертое, которое в счете не указано.
Полная справочная информация по API находится в документации по моделям принятия решений.
Обе модели тарифицируют только входные токены. Изображение стоит 1,5 токена за патч 32x32 пикселя по текстовому тарифу, поэтому изображение 1024x1024 стоит 1536 токенов. Запрос тарифицирует текст и изображения один раз, а каждый дополнительный вопрос добавляет только свой собственный текст. Скоро появится на OpenRouter и Vercel.
Цитирование
Для цитирования используйте следующую ссылку или BibTeX:
Liquid AI, "d1.2: State-of-the-Art Omnimodal Decision Models", Liquid AI Blog, ноябрь 2026 г.