Почему MLPerf Inference 6.1 знаменует собой новый этап для AMD Instinct
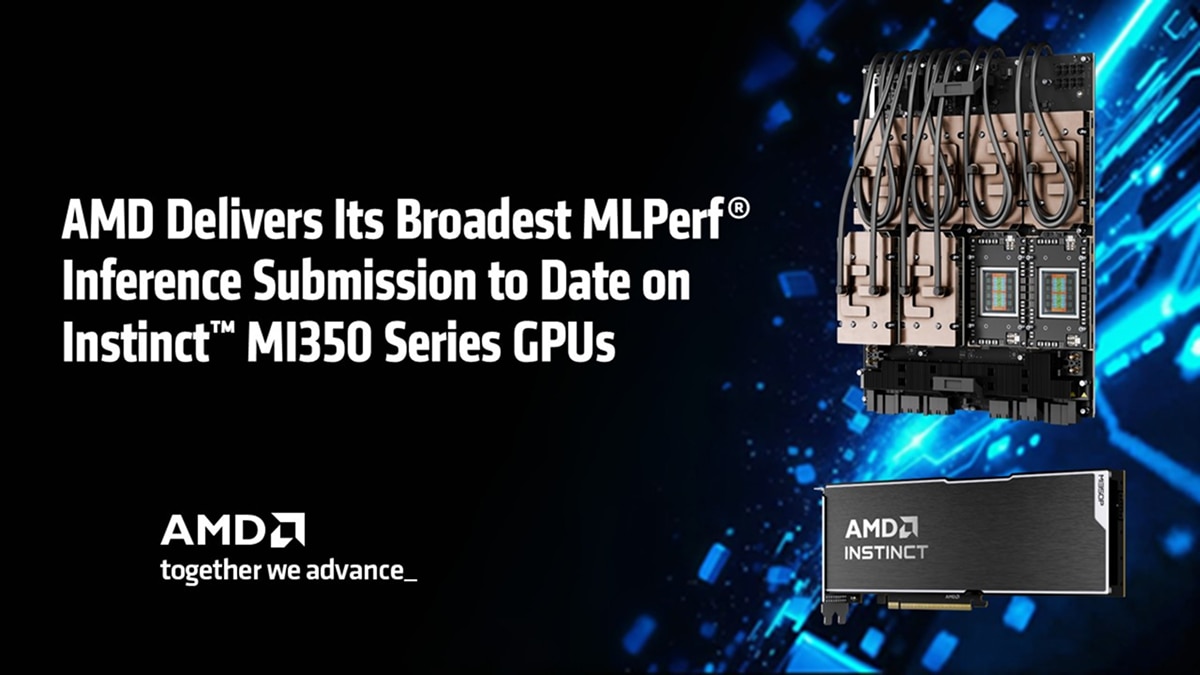
Релиз AMD в рамках MLPerf Inference 6.1 стал самым масштабным участием AMD на сегодняшний день: число семейств моделей увеличилось с трех в предыдущем раунде MLPerf 6.0 Inference до шести, охватив графические процессоры AMD Instinct™ MI355X и MI350X, а также нашу совершенно новую карту MI350P PCIe. Релиз охватывает задачи инференса для работы с языковыми моделями, рассуждениями, генерацией текста в видео и системами рекомендаций, предоставляя читателям более широкое представление о том, как платформа производит вычисления на различных моделях и в различных конфигурациях развертывания.
Масштаб — это лишь начало истории. Твердотельное железо на базе того же GPU AMD Instinct MI355X показало значительно более высокую производительность, чем цикл MLPerf назад. Кроме того, результат Crusoe для конфигурации из 512 GPU с моделью GPT-OSS-120B достиг рекордной совокупной пропускной способности токенов за всю историю MLPerf. Семь партнеров близко воспроизвели результаты AMD, что подтверждает масштабируемость производительности за пределы эталонной системы.
Три технических достижения помогают объяснить, что изменилось в этом раунде:
- Больше производительности от того же оборудования GPU AMD Instinct MI355X: всего за один цикл MLPerf непрерывная оптимизация программного обеспечения AMD ROCm™ увеличила пропускную способность для GPT-OSS-120B на 8 GPU, снизила задержку для Wan-2.2 и повысила пропускную способность кластера при меньшем количестве GPU.
- Лидирующая производительность на графических процессорах AMD Instinct MI355X и MI350P: графические процессоры AMD Instinct MI355X превзошли результаты NVIDIA B200 и B300 для модели GPT-OSS-120B в конфигурации с 8 GPU, а также результат NVIDIA GB200 в конфигурации с 72 GPU. В своем первом раунде MLPerf графические процессоры AMD Instinct MI350P опередили выбранные конфигурации NVIDIA RTX PRO 6000 Server Edition и H200 NVL.
- Рекордная пропускная способность токенов и промышленный масштаб инференса с эффективным масштабированием: в конфигурации из 72 GPU графический процессор AMD Instinct MI355X достиг эффективности масштабирования 95% на задаче GPT-OSS-120B. Кроме того, компания Crusoe продемонстрировала рекордную совокупную пропускную способность токенов на 512 GPU, достигнув 5,75 млн токенов в секунду в офлайн-режиме для GPT-OSS-120B и 2,90 млн для DeepSeek-R1.
В совокупности этот релиз демонстрирует переход платформы от первоначальной адаптации рабочих нагрузок к более широкому, повторяемому инференсу промышленного масштаба.
Единая архитектура AMD CDNA 4 для двух путей развертывания
Графические процессоры AMD Instinct™ MI355X и платы PCIe® MI350P созданы на базе архитектуры AMD CDNA™ 4, но они рассчитаны на разные требования к инфраструктуре. GPU AMD MI355X обеспечивает основу для масштабирования вверх (scale-up) для достижения максимальной пропускной способности и крупнейших кластеров в этом релизе. Карта AMD MI350P переносит то же архитектурное поколение в двухслотовый форм-фактор PCIe, предназначенный для развертывания в существующих средах центров обработки данных.
Увеличение изображения
Графический процессор AMD Instinct MI355X объединяет 256 вычислительных блоков, 288 ГБ памяти HBM3E и пропускную способность памяти 8 ТБ/с. Он обеспечивает до 10,1 Пфлопс пиковой теоретической производительности матриц MXFP4 и MXFP6 в форм-факторе OAM на платформе UBB 2.0. Эта конфигурация предназначена для плотных систем, где максимальная пропускная способность инференса и масштабируемость являются главными требованиями.
Плата AMD Instinct MI350P PCIe оснащена 128 вычислительными блоками, 144 ГБ памяти HBM3E и пропускной способностью памяти 4 ТБ/с. Она обеспечивает до 4,6 Пфлопс пиковой теоретической производительности матриц MXFP4 и MXFP6 в форм-факторе PCIe 5.0 с двумя слотами. Это важный выбор для портфолио, поскольку клиенты строят свои ИИ-системы по-разному. GPU AMD Instinct MI355X поддерживает среды, где приоритетом является максимальная производительность масштабирования, в то время как плата AMD Instinct MI350P PCIe обеспечивает более прямой путь к производительности инференса на базе AMD CDNA™ 4 в существующей инфраструктуре дата-центров. Вместе серия AMD Instinct MI350 поддерживает обе модели развертывания.
Этот выбор определяет дальнейшие результаты релиза. Оборудование задает доступные вычислительные мощности, объем памяти и формат развертывания. Последующие результаты показывают, как непрерывная работа над ПО AMD ROCm™ и экосистемой инференса с открытым исходным кодом позволила извлечь больше производительности из этой базы, включая измеримый прирост на тех же GPU AMD Instinct MI355X между раундами MLPerf.
Ключевые моменты релиза AMD MLPerf Inference 6.1
Результаты AMD в рамках MLPerf® Inference 6.1 опираются на три ключевых доказательства: рост производительности на том же железе, лидерство во всем спектре путей развертывания AMD Instinct™ MI355X и MI350P, а также инференс промышленного масштаба с рекордной совокупной пропускной способностью токенов.
1. Те же графические процессоры AMD Instinct™ MI355X обеспечивают более высокую производительность
Увеличение изображения
Менее чем за шесть месяцев непрерывная оптимизация программного обеспечения увеличила производительность графических процессоров AMD Instinct™ MI355X. На тех же 8 графических процессорах AMD Instinct™ MI355X совместная работа над ПО AMD ROCm™ и экосистемой инференса с открытым исходным кодом увеличила пропускную способность модели GPT-OSS-120B на 28% в офлайн-режиме и на 38% в серверном режиме, в то время как производительность Wan-2.2 SingleStream выросла на 70%.
Эффект становится еще более заметным на уровне кластера. 72 графических процессора AMD Instinct MI355X в раунде MLPerf Inference 6.1 обеспечили большую пропускную способность GPT-OSS-120B, чем 94 графических процессора в предыдущем раунде 6.0. Поколение GPU осталось прежним, но большая часть его потенциала превратилась в полезную работу по инференсу. Это дает инфраструктурным командам больший запас прочности развернутых систем до расширения кластера.
Увеличение изображения
Wan-data превращает эту историю платформы в историю зрелости рабочих нагрузок. Рабочая нагрузка прошла путь от первой заявки в категории Open в MLPerf Inference раунда 6.0 до лидирующей заявки в категории Closed в раунде 6.1. При этом графический процессор AMD Instinct MI355X показал на 18% более высокую производительность в офлайн-режиме и на 11% более высокую производительность в режиме SingleStream по сравнению с выбранным результатом NVIDIA B300.
Важность заключается в скорости этого прогресса. Новая рабочая нагрузка прошла путь от первоначальной адаптации до лидирующего стандарта результата всего за один цикл MLPerf. В этом ценность программной платформы, которая продолжает развиваться после поставки оборудования: новые рабочие нагрузки продвигаются вперед, пути обслуживания улучшаются, а развернутые системы продолжают выполнять все больше полезной работы.
2. Графические процессоры AMD Instinct™ MI355X и MI350P демонстрируют широкое лидерство в рабочих нагрузках ИИ-инференса
MLPerf Inference раунда 6.1 демонстрирует широту лидерства производительности AMD в языковых нагрузках, генерации текста в видео и системах рекомендаций, а также в различных сценариях обслуживания.
Увеличение изображения
GPT-OSS-120B предоставляет наиболее наглядную отправную точку. На стандартной 8-GPU системе AMD Instinct MI355X компания AMD опередила выбранные результаты NVIDIA B200 и B300 как в офлайн-, так и в серверном режиме. Это важно, поскольку узел с восемью графическими процессорами является практическим строительным блоком для инфраструктуры инференса.
Увеличение изображения
Увеличение изображения
Другие рабочие нагрузки расширяют доказательную базу. Wan-2.2 демонстрирует быструю программную зрелость, Llama 2 70B добавляет покрытие для пакетного, серверного и интерактивного инференса, а DLRM v3 расширяет возможности платформы до рекомендательных нагрузок, используемых для ранжирования и персонализации.
Лидерство в производительности также распространяется на другую инфраструктурную модель. В своем первом раунде MLPerf плата AMD Instinct MI350P PCIe® представила пять рабочих нагрузок в категории Closed и показала лидирующие результаты по сравнению с выбранными результатами NVIDIA RTX PRO 6000 Server Edition и H200 NVL.
Увеличение изображения
Увеличение изображения
Это меняет подход к развертыванию. GPU AMD Instinct MI355X предназначены для высокоплотных масштабируемых систем, в то время как GPU AMD Instinct MI350P предоставляют центрам обработки данных, построенным на базе двухслотовых серверов PCIe, еще один путь к производительности вывода AMD CDNA™ 4. Команды могут оценивать платформу, которая соответствует их текущим требованиям к питанию, охлаждению и серверной архитектуре, вместо того чтобы рассматривать один форм-фактор как универсальное решение для любой среды.
Что производительность может означать на практике
Масштабирование изображения
Исследование Signal65, проведенное по заказу AMD, помогает перевести результаты бенчмарков на язык операционных показателей. По всем протестированным рабочим нагрузкам исследование показало снижение стоимости обработки одного документа, увеличение количества токенов на доллар и рост числа пользователей, обслуживаемых в рамках заданного целевого показателя задержки.
Эти выводы объясняют, почему пропускная способность имеет значение. Бизнес-задача сводится к тому, какой объем полезной работы инфраструктура может выполнить в рамках бюджета и какой спрос она может удовлетворить, не выходя за рамки целевого времени отклика приложения.
3. Рекордная пропускная способность токенов и масштабируемый вывод в производственных условиях с эффективным масштабированием
Высокая производительность на одном узле важна только в том случае, если добавление дополнительных GPU обеспечивает полезную пропускную способность. AMD масштабировала GPT-OSS-120B с 8 до 72 GPU AMD Instinct MI355X — девятикратное увеличение количества GPU — сохранив при этом 95% эффективности масштабирования как в автономном режиме (Offline), так и в серверном (Server).
Масштабирование изображения
Этот результат показывает, что платформа может значительно увеличить емкость вывода, не теряя при этом значительную часть ожидаемой производительности из-за накладных расходов на обмен данными, планирование и распределение рабочих нагрузок. GPU AMD Instinct MI355X не только быстры на одном узле; они продолжают демонстрировать эффективность по мере того, как развертывания перерастают в реальные многоузловые кластеры вывода. При использовании 512 GPU фокус смещается со эффективности масштабирования на совокупную пропускную способность. Благодаря Crusoe модель GPT-OSS-120B достигла 5,75 миллиона токенов в секунду в автономном режиме и 5,39 миллиона токенов в секунду в серверном режиме, что является самым высоким показателем совокупной пропускной способности токенов, когда-либо представленным в истории MLPerf.
Результат DeepSeek-R1 достиг 2,90 миллиона токенов в секунду в автономном режиме и 2,41 миллиона в серверном, установив рекорд совокупной пропускной способности токенов для DeepSeek-R1 в истории MLPerf.
Масштабирование изображения
В совокупности эти три ключевых момента демонстрируют платформу, которая улучшает показатели на том же оборудовании, обеспечивает лидерство как в масштабируемых, так и в PCIe®-решениях, эффективно масштабируется от восьми до 72 GPU и достигает рекордной совокупной пропускной способности при 512 GPU.
Производительность AMD Instinct™, воспроизведенная в партнерских системах
Компании Dell Technologies и MangoBoost представили первый результат гетерогенного вывода на 32 GPU, объединив 16 GPU AMD Instinct™ MI300X в Корее с 16 GPU AMD Instinct MI355X в США в качестве единой конечной точки обслуживания GPT-OSS-120B. Система обеспечила 285 454 токена в секунду в автономном режиме и 253 501 токен в секунду в серверном режиме.
Значимость заключается в том, как была достигнута эта емкость. Существующие системы с GPU AMD Instinct MI300X и более новые системы с GPU AMD Instinct MI355X внесли вклад в одну и ту же службу вывода, демонстрируя путь к наращиванию мощности за счет объединения разных поколений GPU и географических локаций, вместо управления каждым парком оборудования как отдельной средой.
Масштабирование изображения
Эта гибкость является частью более широкой истории партнерства. Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe и MiTAC представили результаты для систем с GPU AMD Instinct MI350X, MI350P и MI355X. Средний показатель сопоставимых результатов партнеров с GPU AMD MI355X оказался в пределах 4% от результатов AMD, а некоторые из них сравнялись с эталонным результатом AMD или даже немного превзошли его.
Результат бенчмарка становится более полезным, когда его можно воспроизвести за пределами исходной лаборатории. Эти партнерские результаты показывают, что стабильная производительность AMD Instinct сохраняется в разных системах, что дает инфраструктурным командам больше уверенности при оценке развертываний у OEM-производителей, в облаках и у партнеров по программному обеспечению.
Выбор правильного профиля производительности для центра обработки данных
Не каждое развертывание вывода проектируется с расчетом на максимальную пропускную способность. Питание, охлаждение и существующая инфраструктура могут быть не менее важны, когда команды решают, какой уровень производительности GPU обеспечить в каждом сервере.
Для выбранных рабочих нагрузок GPT-OSS, Llama, Wan и DLRM платформа с восемью GPU AMD Instinct™ MI350X сохранила примерно 80% производительности платформы AMD Instinct MI355X. GPU AMD Instinct MI355X имеет на 40% более высокий номинальный TDP в этом сравнении, что отражает его позицию как варианта с максимальной производительностью в портфолио.
Масштабирование изображения
Это создает два профиля производительности:
- GPU AMD Instinct MI350X: Вариант с более низким TDP для развертываний, где питание, охлаждение и гибкость инфраструктуры определяют дизайн системы.
- GPU AMD Instinct MI355X: Вариант с максимальной производительностью для развертываний, где пропускная способность вывода является основным требованием.
Как программное обеспечение AMD ROCm™ связывает прогресс в бенчмарках с производственным ИИ
Программное обеспечение AMD ROCm™ объединяет всю историю MLPerf® Inference 6.1. Программное обеспечение AMD ROCm версии 7 обеспечило каждый результат в представленных данных, включая более высокую производительность на тех же GPU AMD Instinct™ MI355X, переход от начальной поддержки Wan-2.2 к закрытому (Closed) тестированию, 95% эффективности масштабирования на 72 GPU и партнерские результаты, которые были близки к показателям AMD.
Эти вехи представляют собой разные этапы одного и того же пути развития рабочей нагрузки. Модель должна сначала корректно работать, затем ее операции внимания, GEMM, использование KV-кэша, планирование и пути обмена данными должны быть настроены для целевой системы. Результат — это не просто более высокий балл в бенчмарке. Это рабочая нагрузка, которая может более эффективно использовать развернутое оборудование и давать сопоставимые результаты в системах AMD и партнеров.
Масштабирование изображения
ROCm 10.0 опирается на этот фундамент, предлагая более понятный путь к производственному использованию. Команды могут начать с привычного ПО vLLM и SGLang, использовать инструменты ROCm.AI для диагностики производительности и переносить одну и ту же программную базу с одной системы на многоузловую инфраструктуру. Локальное профилирование и настройка также дают разработчикам более прямое представление о том, на что тратится время в процессе обслуживания запросов.
Это история непрерывности: запуск рабочей нагрузки, улучшение пути обслуживания, расширение развертывания и воспроизведение результата. ROCm обеспечивает программный фундамент на каждом этапе.
Ежегодный цикл создает следующую главу вывода AMD Instinct™
Ценность дорожной карты AMD Instinct заключается не просто в последовательности названий продуктов. Это ритм, стоящий за прогрессом платформы, продемонстрированным в ходе MLPerf® Inference раунда 6.1.
Масштабирование изображения
GPU AMD Instinct MI300X заложили фундамент в 2023 году. GPU AMD Instinct MI325X расширили эту платформу памятью HBM3E и увеличенной вычислительной мощностью в 2024 году, за ними последовала серия AMD Instinct MI350 в 2025 году. Текущие результаты показывают, как этот фундамент продолжает приносить пользу благодаря оптимизации программного обеспечения, поддержке более широкого спектра рабочих нагрузок и увеличению вариантов развертывания.
Дорожная карта продолжается выпуском серии AMD Instinct MI400 в 2026 году, которая будет оснащена памятью HBM4 и увеличенной вычислительной мощностью, за которой последует серия MI500 и архитектура следующего поколения в 2027 году. Для команд инфраструктуры такой темп обеспечивает более четкий путь от систем, развертываемых сегодня, к требованиям к вычислительным мощностям и памяти для будущих рабочих нагрузок логического вывода.
Итоговые выводы
Результаты AMD в раунде 6.1 MLPerf® Inference знаменуют собой важный шаг вперед для логического вывода ИИ на базе AMD Instinct. AMD добилась более высокой производительности на том же аппаратном обеспечении графических процессоров AMD Instinct™ MI355X, лидерства в ряде сравнений графических процессоров AMD Instinct MI355X и MI350P, 95% эффективности масштабирования на 72 графических процессорах, рекордной совокупной пропускной способности токенов в рамках подачи Crusoe на 512 графических процессорах, а также результатов от семи партнеров по экосистеме.
Результаты также демонстрируют формирование более широкой платформы. Графические процессоры AMD Instinct обеспечивают аппаратную основу для путей развертывания с масштабированием (scale-up), с более низким TDP и через PCIe®. Программное обеспечение AMD ROCm™ связывает воедино поддержку рабочих нагрузок, постоянную оптимизацию, многоузловое выполнение и воспроизводимость в партнерских системах.
Для читателей, интересующихся более глубокими техническими подробностями, два новых блога AMD ROCm предоставляют дополнительную информацию о результатах MLPerf Inference 6.1. В статье «AMD Instinct™ GPUs MLPerf Inference v6.1 Submission» рассматриваются программные оптимизации и оптимизации рабочих нагрузок, лежащие в основе результатов, а в статье «Reproducing the AMD MLPerf Inference v6.1 submission result» объясняется, как воспроизвести тесты на оборудовании AMD Instinct. Вместе эти блоги позволяют более детально ознакомиться с программной основой AMD ROCm, лежащей в основе представленных результатов, и подтверждают приверженность AMD принципам открытости, прозрачности и воспроизводимости в области логического вывода ИИ.
Примечания END
Примечания END
- Предупреждение AMD - https://www.amd.com/en/legal/copyright.html
- Для получения дополнительной информации о результатах MLPerf Inference 6.1 по состоянию на 16 сентября 2026 года посетите: https://mlcommons.org/benchmarks/inference-datacenter/.
- Название и логотип MLPerf являются зарегистрированными и незарегистрированными товарными знаками MLCommons Association в Соединенных Штатах и других странах. Все права защищены. Несанкционированное использование строго запрещено. Дополнительную информацию см. на www.mlcommons.org.
ОБЩИЙ ОТКАЗ ОТ ОТВЕТСТВЕННОСТИ
Информация, содержащаяся в данном документе, предназначена только для информационных целей и может быть изменена без предварительного уведомления. Несмотря на то, что при подготовке этого документа были приняты все меры предосторожности, он может содержать технические неточности, упущения и опечатки, и AMD не обязана обновлять или иным образом исправлять эту информацию. Advanced Micro Devices, Inc. не делает никаких заявлений и не дает никаких гарантий в отношении точности или полноты содержания данного документа и не несет никакой ответственности, включая подразумеваемые гарантии отсутствия нарушения прав, товарной пригодности или пригодности для конкретных целей, в отношении работы или использования оборудования, программного обеспечения или других продуктов AMD, описанных в данном документе. Данный документ не предоставляет никакой лицензии, включая подразумеваемую или возникающую в силу правовой преграды, на какие-либо права интеллектуальной собственности. Условия и ограничения, применимые к покупке или использованию продуктов AMD, изложены в подписанном соглашении между сторонами или в Стандартных условиях продажи AMD. GD-18u.