Корпоративное кодирование с помощью ИИ на базе технологий AMD, Supermicro и Spectro Cloud, обеспечивающее снижение совокупной стоимости владения (TCO) до 75%
ИИ становится частью повседневной разработки программного обеспечения — от генерации кода и модернизации приложений до автоматизации тестов и проверки запросов на слияние (pull requests). По мере расширения использования перед предприятиями встает практический вопрос: как масштабировать этот прирост производительности для инженерных команд, одновременно контролируя расходы и защищая проприетарный код?
Передовые модели обладают мощными возможностями, но их использование для каждой задачи может сделать затраты труднопрогнозируемыми. Более длинные контекстные окна, повторяющиеся взаимодействия агентов и растущее внедрение увеличивают потребление токенов. Организациям также необходимы четкие политики, регулирующие, когда исходный код, промпты и другая конфиденциальная информация могут отправляться во внешние службы.
Перенос большего объема вычислений (инференса) на локальные мощности (on-premises) предлагает возможный путь решения. Тем не менее, сборка серверов, графических процессоров, программного обеспечения для инференса, моделей и средств операционного управления может оказаться сложной и трудоемкой задачей.
Успех AMD Instinct Coder 325 получил продолжение: AMD Instinct Coder 355 объединяет усилия AMD, Supermicro и Spectro Cloud для решения всех этих задач с помощью готовой корпоративной платформы для написания кода с поддержкой ИИ. Решение позволяет выполнять повседневные рабочие нагрузки по кодированию локально и разрешает обращение к передовым облачным сервисам только тогда, когда это оправданно и соответствует корпоративным политикам безопасности данных.
Полноценная платформа для локального кодирования с ИИ
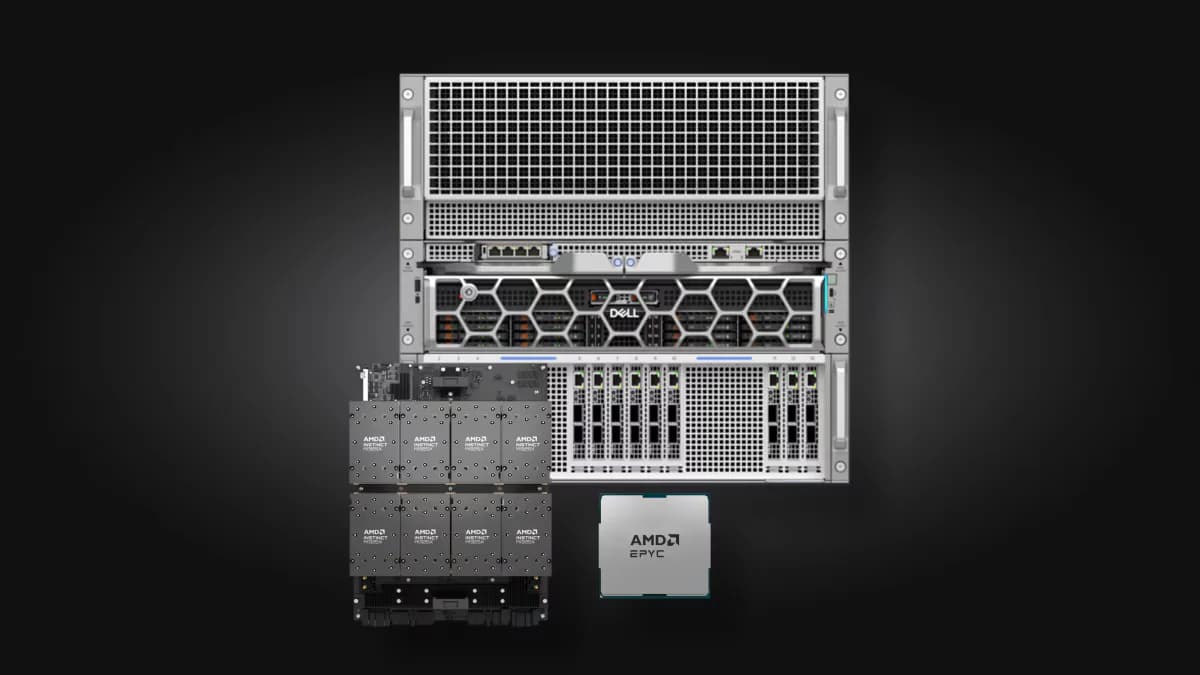
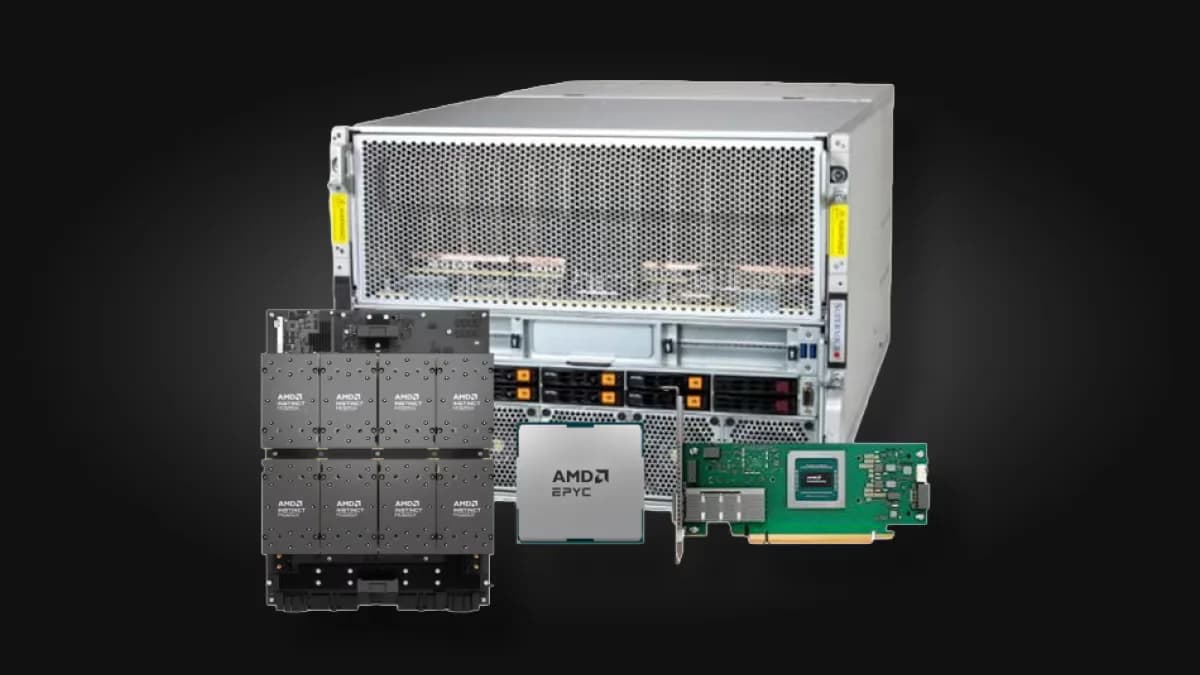
Решение объединяет серверы Supermicro на базе процессоров AMD EPYC™, графических процессоров AMD Instinct™ MI355X и сетевых адаптеров AMD Pensando™, а также модель GLM 5.3 и программное обеспечение Spectro Cloud PaletteAI Inference Launchpad.
AMD предоставляет вычислительную основу для локального инференса. Supermicro поставляет инфраструктуру корпоративных серверов и варианты аппаратной поддержки. Spectro Cloud объединяет развертывание, эксплуатацию и управление, помогая ИТ-отделам предоставлять услуги ИИ-кодирования в качестве внутреннего сервиса.
В совокупности эти возможности образуют готовый стек инференса, предоставляя инженерным командам доступ к помощи ИИ и помогая ИТ-отделу сохранять контроль над инфраструктурой, использованием, затратами и данными.
Локально по умолчанию, передовые модели — только при необходимости
Каждый запрос на написание кода не требует применения передовой модели. Генерация кода, создание тестов, документирование и рутинный анализ кода могут выполняться с помощью локального инференса, в зависимости от выбранной модели и требований организации к качеству.
PaletteAI Inference Launchpad обеспечивает интеллектуальную маршрутизацию, которая по умолчанию направляет запросы на локальные модели и разрешает использование утвержденных передовых сервисов, когда требования задачи оправдывают это, а ИТ-политика допускает такое решение. Команды платформы определяют политики маршрутизации, включая то, какие рабочие нагрузки могут выходить за пределы локальной среды.
Это дает предприятиям практичный способ сбалансировать возможности и затраты. Команды могут использовать локальные модели для подходящих рабочих нагрузок, сохраняя при этом доступ к передовым возможностям для более сложных задач в случае необходимости. Конфиденциальные рабочие нагрузки могут оставаться локальными в соответствии с корпоративной политикой; запросы, направляемые вовне, передают связанный контент выбранному сервису и должны соответствовать требованиям организации по обработке данных.
Упрощение контроля затрат на разработку кода с помощью ИИ
Перенос подходящих рабочих нагрузок на локальные мощности снижает зависимость от тарифицируемых API передовых моделей и перенаправляет расходы на инференс в сторону инфраструктуры, которую предприятия могут планировать и контролировать. Расходы на передовые модели можно зарезервировать для запросов, где ожидаемая выгода оправдывает их.
Учет использования, квоты и операционная видимость помогают администраторам понимать спрос и управлять потреблением. Вместо того чтобы рассматривать кодирование с помощью ИИ как статью расходов без фиксированного верхнего предела, предприятия могут управлять им как общим сервисом с определенной емкостью, политиками доступа и бюджетами.
Экономические показатели зависят от уровня использования, выбора модели, характеристик рабочей нагрузки, эксплуатационных расходов и доли запросов, направляемых во внешние сети. Оценка этих факторов в сопоставлении с реальным использованием разработчиками помогает организациям определить размер платформы и оценить потенциальную экономию.
Защита кода и сохранение свободы выбора
Для рабочих нагрузок, обрабатываемых локально, исходный код, промпты и контекст модели остаются внутри корпоративной среды. Контроль доступа и политики использования помогают командам управлять тем, кто может использовать сервис и как именно он потребляется.
Открытые модели и стандартная интеграция через API также обеспечивают организациям гибкость по мере эволюции их потребностей. Команды могут оценивать новые локальные модели, корректировать политики маршрутизации и подключать утвержденные внешние сервисы, не делая какого-то одного провайдера передовых моделей обязательным пунктом назначения для каждого запроса.
Разработчики могут подключать поддерживаемые инструменты кодирования к платформе, что позволяет организациям внедрять локальный инференс в привычные рабочие процессы. Совместимость инструментов и доступные функции зависят от проверенной модели, эндпоинта и конфигурации клиента.
Масштабирование производительности разработчиков с большим контролем
AMD Instinct Coder 355 предоставляет предприятиям практичную основу для расширения разработки с помощью ИИ с улучшенным контролем затрат, данных и операций. Вычислительные мощности AMD, инфраструктура Supermicro и средства управления Spectro Cloud объединяют ключевые компоненты в единую интегрированную платформу.
Запускайте подходящие рабочие нагрузки локально. Используйте передовые модели, когда того требуют задачи и позволяют правила. Предоставьте разработчикам необходимые им возможности ИИ, сохраняя при этом соответствие инфраструктуры и затрат корпоративным приоритетам.
Обратитесь к своему представителю AMD, Supermicro или Spectro Cloud, чтобы обсудить оптимальную конфигурацию для ваших команд разработки.
Детали решения
Сервер Supermicro AS-A126GS-TNMR
- 2 процессора AMD EPYC™ 9575F, 64 ядра, 3.3 ГГц
- 8 графических процессоров AMD Instinct™ MI355X AC 288GB HBM3e, UBB8
- 3 ТБ (24 x 128 ГБ) DDR5 RDIMM 6400 ECC
- 2 накопителя NVMe PCIe® Gen4 V6 M.2 емкостью 960 ГБ
- 8 SSD-накопителей PCIe Gen5 TLC U.2 емкостью 7.68 ТБ
- 2 сетевых адаптера AMD Pensando™ Pollara 400 HHHL PCIe NIC, 400GbE
- 6 резервных блоков питания титанового класса высокой эффективности (конфигурация 3+3) мощностью 5250 Вт
Spectro Cloud PaletteAI Inference Launchpad
- Управление жизненным циклом ИИ полного стека
- Корпоративное управление в масштабе предприятия
- Интеллектуальная маршрутизация моделей с приоритетом локального запуска, передовые модели при необходимости
- Полная видимость и контроль использования и стоимости ИИ
- Локально: GLM-5.3
- Передовые модели: Anthropic Claude, OpenAI GPT, Google Gemini
- Claude Code, Cursor, Visual Studio Code
- Комплексная полностековая программная поддержка от Spectro Cloud
- 3 года обслуживания на месте на следующий рабочий день (NBD) от Supermicro для оборудования
- Поддержка до 85 разработчиков на один узел (50 одновременно работающих)
- До 98% производительности передовых моделей по результатам бенчмарков