AMD обеспечивает работу большей части ведущих мировых систем научных вычислений: от суперкомпьютеров эксафлопсного класса, способствующих открытиям в США и Европе, до Lux — первой американской системы в рамках программы Genesis Mission для науки на базе ИИ. Благодаря передовым процессорам, графическим ускорителям, ПЛИС, сетевым решениям и открытому программному стеку AMD ROCm™, компания AMD предоставляет государствам, лабораториям и предприятиям единую открытую платформу для высокопроизводительных вычислений, научных исследований на базе ИИ, суверенного ИИ, агентного ИИ и перехода к квантовым вычислениям.
Такой широкий охват — не случайность. Это отражение убеждения, которое определяет каждую создаваемую нами систему: наука не работает на одном типе вычислений.
Важнейшие мировые задачи больше не вписываются в рамки одной вычислительной модели. Климатология, разработка лекарств, передовое производство, национальная безопасность, суверенный ИИ и квантовые исследования все чаще используют диверсифицированные вычислительные модели, работающие как единая система. Вопрос, стоящий перед нашей отраслью, больше не звучит как «какой процессор победит?». Он звучит так: «как нам обеспечить нужные вычисления для нужной рабочей нагрузки в нужное время?»
AMD отвечает на этот вопрос в производственных масштабах уже много лет. Frontier преодолел барьер эксафлопсных вычислений. El Capitan привнес моделирование с поддержкой ИИ в задачи национальной безопасности. LUMI предоставил открытую инфраструктуру для исследований климата и рака. А Lux, первый действующий суперкомпьютер DOE Genesis Mission для научных исследований на базе ИИ, сегодня работает в Ок-Риджской национальной лаборатории.
Эра эксафлопса была лишь началом. Графический процессор AMD Instinct™ MI430X — это следующий шаг.
Графический процессор AMD Instinct MI430X
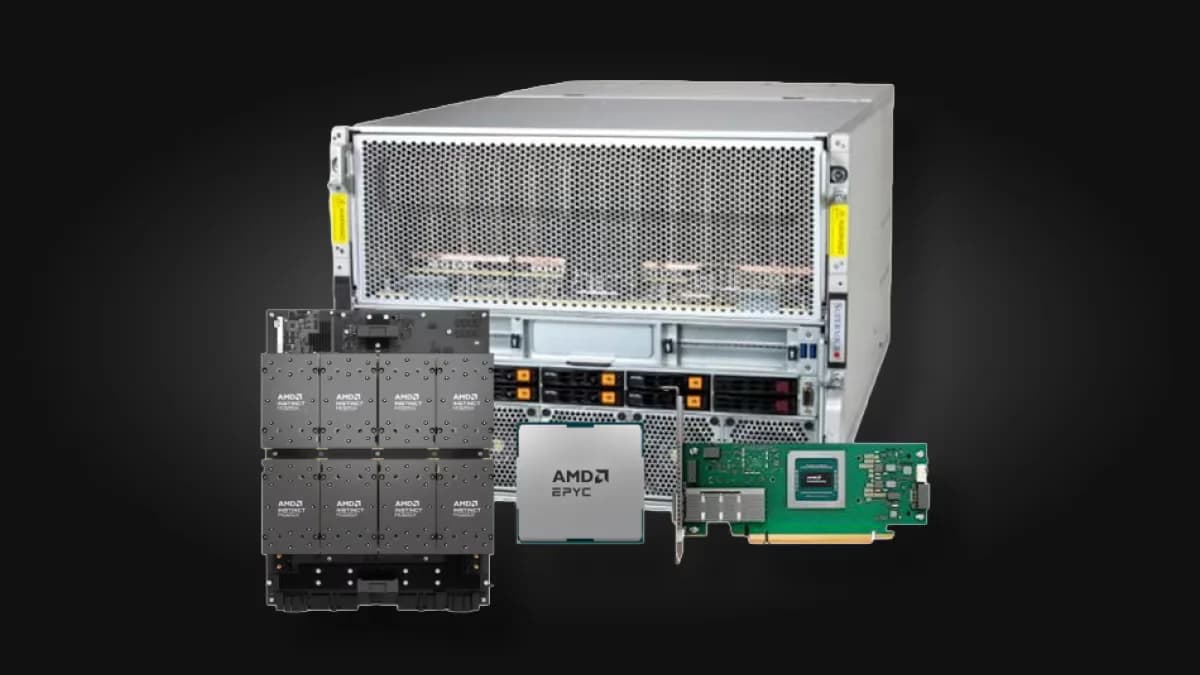
AMD Instinct MI430X — это первый графический процессор, изначально разработанный для конвергенции высокоточных вычислений и искусственного интеллекта в научных целях. Построенный на архитектуре AMD CDNA™ 5, он сочетает в себе до 288 Тфлопс пиковой нативной производительности FP64, 432 ГБ памяти HBM4 с пропускной способностью 23,3 ТБ/с и 9,2 Пфлопс пиковой производительности FP4, обеспечивая оптимальное сочетание высокой точности и вычислительной мощности для ИИ.
MI430X оснащен 432 ГБ памяти HBM4 с пропускной способностью до 23,3 ТБ/с, что на 50% больше объема памяти Nvidia Vera Rubin. Более крупные сетки, большее количество атомов и длинные последовательности остаются в памяти графического процессора, вместо того чтобы распределяться между узлами и сетью. Объем памяти также важен для точности: эмулированное умножение матриц FP64 требует примерно в три раза больше памяти, чем нативное, поэтому плотные нативные вычисления FP64 поддерживают эффективность использования памяти.
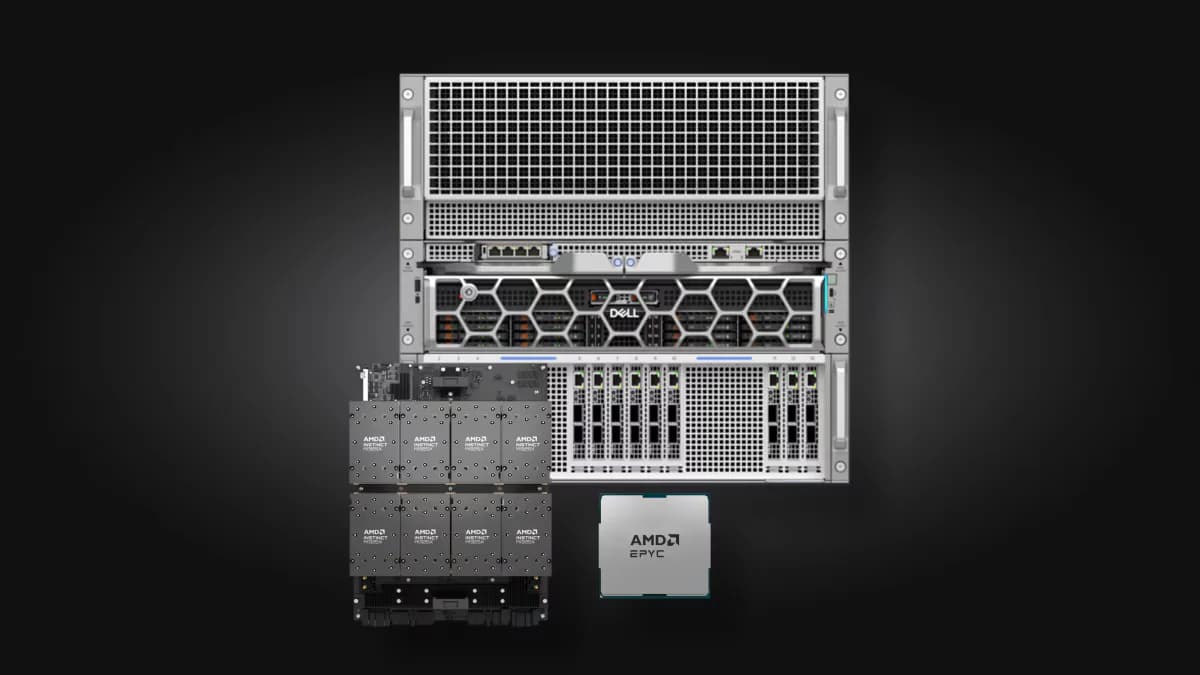
Когда для рабочих нагрузок HPC требуется больше, чем один графический процессор, AMD Instinct MI430X объединяет хост-процессор AMD EPYC™ Server CPU SP7 6-го поколения с четырьмя графическими процессорами в полностью связанную бесшовную ячеистую сеть с использованием технологии AMD Infinity Fabric™. Каждый графический процессор имеет прямое соединение с тремя другими, обеспечивая до 384 ГБ/с однонаправленной пропускной способности на GPU и до 12,3 Тбит/с совокупной пропускной способности масштабирования по узлу. Для научных кодов, где в моделировании с декомпозицией домена преобладают обмен данными между границами (halo exchange), операции редукции и коллективные операции с малыми сообщениями, этот трафик гораздо более чувствителен к задержке каждого перехода, чем к размеру домена масштабирования. Поэтому архитектура «все-ко-всем» без коммутаторов устраняет лишний переход, снижает энергопотребление и уменьшает домен отказа для каждого из этих обменов.
В совокупности эти проектные решения обеспечивают значительный прирост производительности поколений на графических процессорах AMD Instinct MI430X по сравнению с AMD Instinct MI300A:
Тест
MI430X (прогноз)
MI430X (прогноз результата)
HPL
3,96x
190 Тфлопс
HPL-MxP (FP16)
4,16x
1790 Тфлопс
BabelStream
5,27x
20 ТБ/с
HPCG
5,57x
3,08 Тфлопс
Узлы AMD Instinct MI430X сохраняют модель программирования с разделяемой памятью, вокруг которой выстроена работа клиентов MI300A, используя бесшовную технологию Infinity Fabric™ для когерентного подключения четырех графических процессоров к хосту EPYC™ «Venice» SP7. Код и накопленный опыт сохраняются.
Нативный FP64 против эмулированного FP64
Некоторые в отрасли считают, что нативной двойной точностью можно пренебречь в ускорителях HPC. Это основывается на двух утверждениях: рабочие нагрузки HPC ограничены пропускной способностью памяти, и тензорные ядра низкой точности могут при необходимости эмулировать FP64 с требуемой точностью.
В статье FP64 Performance and the Limits of Ozaki Emulation on HPC Systems, представленной на конференции SC26, исследователи AMD напрямую проверили оба утверждения, профилировав 47 конфигураций рабочих нагрузок в 11 приложениях и тестах на графических процессорах AMD Instinct MI350X и MI355X, а затем оценив эмуляцию Ozaki GEMM на трех современных архитектурах GPU. Выделяются три вывода.
- Эмуляция — это метод для плотных операций GEMM, а HPC в основном не является плотной операцией GEMM. Это векторные операции, редукции, трафареты (stencils), разреженная линейная алгебра и специфические для приложений ядра; ни одно из них не сводится к большому плотному умножению матриц. Основываясь на выборке HPC-приложений, упомянутых в вышеуказанной технической статье, менее 10% экосистемы HPC достаточно плотны и имеют структуру GEMM, чтобы эмулированный FP64 приносил пользу.
- Характеристика рабочих нагрузок HPC как «ограниченных пропускной способностью памяти» не отменяет важность нативного FP64. Это может сделать рабочие нагрузки HPC ограниченными вычислительной мощностью. На графическом процессоре AMD Instinct™ MI355X большинство профилированных нагрузок действительно находятся на стороне пропускной способности. Однако проекции «roofline» в исследовании показывают, что по мере снижения пропускной способности нативного FP64 при увеличении пропускной способности памяти, ядра, которые сегодня комфортно ограничены памятью, становятся ограничены вычислениями на архитектурах с урезанным FP64.
- Даже внутри упомянутых 10% благоприятных рабочих нагрузок HPC эмуляция дает преимущество только при больших размерах матриц и работает значительно медленнее при меньших. Она увеличивает общий объем занимаемой памяти примерно в три раза по сравнению с нативным GEMM FP64 и чувствительна к масштабированию операндов, в то время как нативный FP64 инвариантен. Неудобные формы матриц стоят значительно дороже, чем на нативном оборудовании. Эмуляция Ozaki — это хорошо спроектированный метод, который делает то, для чего был создан. Просто он подходит для очень узкого сегмента задач HPC.
Что это означает для вашей рабочей нагрузки и бюджета
Практический вопрос не в том, впечатляет ли эмуляция. А в том, подходит ли она для того, что на самом деле делает ваш код.
Класс рабочей нагрузки
Профилированный код
Помогает ли эмуляция?
Плотная линейная алгебра
rocHPL
Иногда — единственное приложение в наборе с доминирующим ядром DGEMM. Обратите внимание, что HPL в настоящее время запрещает эмуляцию.
Разреженная итерационная линейная алгебра
rocHPCG
Нет — не имеет структуры GEMM
Трафареты и гидродинамика
TeaLeaf, CloverLeaf, Laghos, PENNANT
Нет — ядра сеток и элементов
Конечные элементы высокого порядка
CEED Bake-Off
Нет — оценка операторов, а не плотный GEMM
Метод Монте-Карло и перенос частиц
XSBench, Kripke
Нет — нерегулярные вычисления и интенсивный сбор данных
Классическая молекулярная динамика
LAMMPS
Нет — списки соседей и короткодействующие силы
Пропускная способность памяти устройства
BabelStream
Нет — ограничено HBM
Одиннадцать профилированных приложений, один условный ответ «да». Для остальных вопрос FP64 решен еще до того, как эмуляция вступает в разговор: этим кодам необходима нативная векторная пропускная способность двойной точности и пропускная способность памяти.
Нативный FP64 меняет экономику так же, как и науку. Когда один ускоритель выполняет моделирование с полной двойной точностью, а ИИ — в формате FP4, вы используете одну систему, один программный стек и одну команду эксплуатации вместо отдельных кластеров HPC и ИИ. Больше памяти на графический процессор означает меньше графических процессоров для одной и той же задачи, а меньше узлов означает меньше сетевых затрат, энергопотребления и занимаемой площади.
Именно поэтому графический процессор AMD Instinct MI430X был выбран для флагманских научных систем на двух континентах: Discovery в Ок-Риджской национальной лаборатории, преемника Frontier; Alice Recoque, первой французской экзафлопсной системы, финансируемой EuroHPC; и Herder в HLRS в Германии. Национальные лаборатории и государственные программы планируют свою деятельность на годы вперед, и им требуется нативная поддержка FP64, а также поддержка вычислений с более низкой точностью для задач ИИ в науке.
Бескомпромиссные научные вычисления
Пропускная способность памяти, нативная производительность FP64 и эмуляция GEMM решают взаимодополняющие, а не взаимозаменяемые задачи портфеля HPC. Система, которая оптимизирует один параметр за счет других, не становится более эффективной — она становится более специализированной, и стоимость этой специализации ложится на плечи научных групп, вынужденных подстраиваться под эти ограничения.
Суперкомпьютер — это нечто большее, чем просто сумма его графических процессоров, и аппаратная архитектура — лишь часть ответа. Платформа ROCm™ предоставляет разработчикам открытое программное обеспечение для переноса, анализа и оптимизации как HPC, так и ИИ-приложений, с моделью долгосрочной поддержки, призванной обеспечить стабильность производственных развертываний в течение двух лет. AMD HPC Assistant предлагает ИИ-помощника для написания кода, созданного специально для высокопроизводительных вычислений. А наша сетевая стратегия строится на открытых отраслевых стандартах, поэтому ваша инфраструктура не окажется привязанной к одной проприетарной сетевой архитектуре.
Комплексное решение, предлагаемое AMD с адаптированным оборудованием, программным обеспечением, решениями и экосистемой, — это именно то, что нужно суперкомпьютерам. Frontier, El Capitan, LUMI и Lux уже работают сегодня. Alice Recoque станет основой европейской суверенной ИИ-инфраструктуры. LUMI-AI и LUMI-IQ в CSC Finland, а также Herder в HLRS будут использовать MI430X вместе с процессорами EPYC 6-го поколения.
Начало работы
Принесите нам два ваших самых важных кода. Команда AMD по HPC и ИИ проанализирует, как они соотносятся с моделью производительности (roofline) графического процессора AMD Instinct MI430X, и наметит ваш путь вперед, будь то перенос с помощью HIP, масштабирование на ROCm или планирование закупок с учетом нативной поддержки FP64.
Вам не придется выбирать между высокой производительностью ИИ и бескомпромиссными возможностями HPC.
С графическими процессорами AMD Instinct MI430X вам это и не потребуется.
Ваш следующий научный прорыв начинается здесь. Давайте построим его вместе.
Напишите на HPCAI@AMD.com, чтобы начать диалог, и посетите стенд AMD #3028 на конференции SC26 в Чикаго с 15 по 20 ноября — и присоединяйтесь к полной презентации для ознакомления с методологией, набором данных и результатами.
Примечания и раскрытие информации
Показатели производительности MI430X являются прогнозными, основанными на аналитических моделях и предварительных целевых характеристиках кремния; это не измеренные результаты, и они могут быть изменены. Данные сравнения с MI300A измерены; данные для MI430X спрогнозированы. Данные сравнения поколений и конкурентных решений обновлены по состоянию на ноябрь 2026 года. Показатели NVIDIA B200, Rubin и GB300 основаны на тестировании AMD. Результаты B200 и GB300 получены в ходе тестирования AMD (конфигурации приведены в документе). Показатели Vera Rubin основаны на опубликованных спецификациях NVIDIA (предварительных). Также добавьте: «Если не указано иное, AMD не тестировала и не проверяла сторонние заявления, содержащиеся в данном документе. GD-182a. Анализ эмуляции FP64, данные roofline и все выводы Ozaki, цитируемые в этой публикации, взяты из , исследования, проведенного и написанного AMD и представленного на SC26; см. документ для ознакомления с полной методологией, конфигурациями тестов, анализом точности и воспроизводимости, а также полными результатами. Набор данных roofline включает 47 конфигураций приложений и 131 построенный экземпляр ядра на AMD Instinct MI350X/MI355X. Сроки, дорожные карты и даты выпуска продуктов, указанные здесь, являются лишь планами и могут быть изменены.
Этот блог может содержать прогнозные заявления относительно Advanced Micro Devices, Inc. (AMD), которые сделаны в соответствии с положениями «безопасной гавани» Закона о реформе судопроизводства по частным ценным бумагам 1995 года. Прогнозные заявления обычно определяются такими словами, как «будет», «может», «ожидает», «полагает», «планирует», «намеревается», «прогнозирует» и другими терминами с аналогичным значением. Инвесторов предупреждают, что любые прогнозные заявления в этом блоге основаны на текущих убеждениях, предположениях и ожиданиях, актуальны только на дату публикации этого блога и связаны с рисками и неопределенностями, которые могут привести к тому, что фактические результаты будут существенно отличаться от текущих ожиданий. Инвесторам настоятельно рекомендуется подробно ознакомиться с рисками и неопределенностями в документах, поданных AMD в Комиссию по ценным бумагам и биржам, включая, помимо прочего, последние отчеты AMD по формам 10-K и 10-Q. AMD не берет на себя и настоящим отказывается от каких-либо обязательств по обновлению прогнозных заявлений, сделанных в этом блоге, за исключением случаев, предусмотренных законом.
AMD, логотип AMD Arrow, AMD CDNA, AMD Instinct, AMD Pensando, EPYC, Infinity Fabric, ROCm и их комбинации являются товарными знаками Advanced Micro Devices, Inc. Другие названия продуктов приведены только в информационных целях и могут являться товарными знаками соответствующих владельцев.