Вкратце
В последнее время возрос интерес к архитектурам «исполнитель-оркестратор» как способу экономии вычислительных ресурсов пограничных моделей. В такой схеме пограничная модель оценивает задачу, составляет план и управляет более мелкими и дешевыми моделями-исполнителями для достижения результата. Мы считаем, что экономию можно сделать еще более значительной, если пересмотреть подход к построению всего конвейера.
В нашей конфигурации сначала задействуются более дешевые модели для исследования контекста и его извлечения, что оптимизировано для получения наиболее качественных данных. К тому моменту, когда в конце вызывается пограничная модель, у нее уже есть весь необходимый контекст, чтобы написать правильный патч всего за один вызов.
Именно эта архитектура позволила нам достичь передового показателя успешного решения задач в 80,8% на SWE-Bench Pro при затратах всего $5,99 на задачу. Это выгодно отличается от других гибридных подходов, таких как недавний эксперимент Fireworks AI с использованием «рабочий + советник», где качество пострадало в погоне за экономией средств.
Экспериментальная установка и базовые показатели
Мы используем стандартную конфигурацию для тестирования агентов кодирования, подробно описанную в нашей предыдущей работе: агент получает задачу на естественном языке, работает внутри Docker-контейнера с целевым репозиторием, действует через команды терминала и выдает git-патч, который оценивается по скрытым тестам. Наш базовый уровень — это классический цикл ReAct (Reasoning + Acting), где единственным инструментом является терминал Docker. Одиночный проход с использованием модели с открытым исходным кодом MiniMax-M3 решает 57% полного публичного набора SWE-Bench Pro. Это надежный базовый уровень, но для его повышения требуется более сложная оркестрация.
Проектирование многомодельного конвейера для повышения производительности агента
Простым ответом на вопрос о повышении доли успешных решений могла бы стать замена MiniMax-M3 на пограничную модель. Но нашей целью было не просто повышение качества, а достижение этого при одновременном снижении вычислительных затрат по сравнению с текущими передовыми результатами. Пограничный агент потратил бы весь свой бюджет как на исследование, так и на генерацию, что значительно увеличило бы расходы.
Нашим решением было осознанно подойти к тому, как мы строим наш конвейер.
Ранее мы измеряли, как изменение порядка в обычном конвейере агента кодирования улучшает как точность, так и эффективность; вместо того чтобы сначала извлекать контекст, а затем генерировать решение, мы генерируем решения в большом масштабе, а затем используем эти кандидаты для более качественного извлечения контекста.
Теперь мы продолжаем изучать, как эффективное проектирование конвейера агента кодирования может радикально повысить качество при снижении общих затрат на задачу. Мы предлагаем два ключевых решения: во-первых, назначение каждого этапа той модели, которая наиболее эффективна для требуемой работы. Во-вторых, проектирование агентов таким образом, чтобы к моменту вызова пограничной модели для финальной записи у нее был лучший контекст для работы.
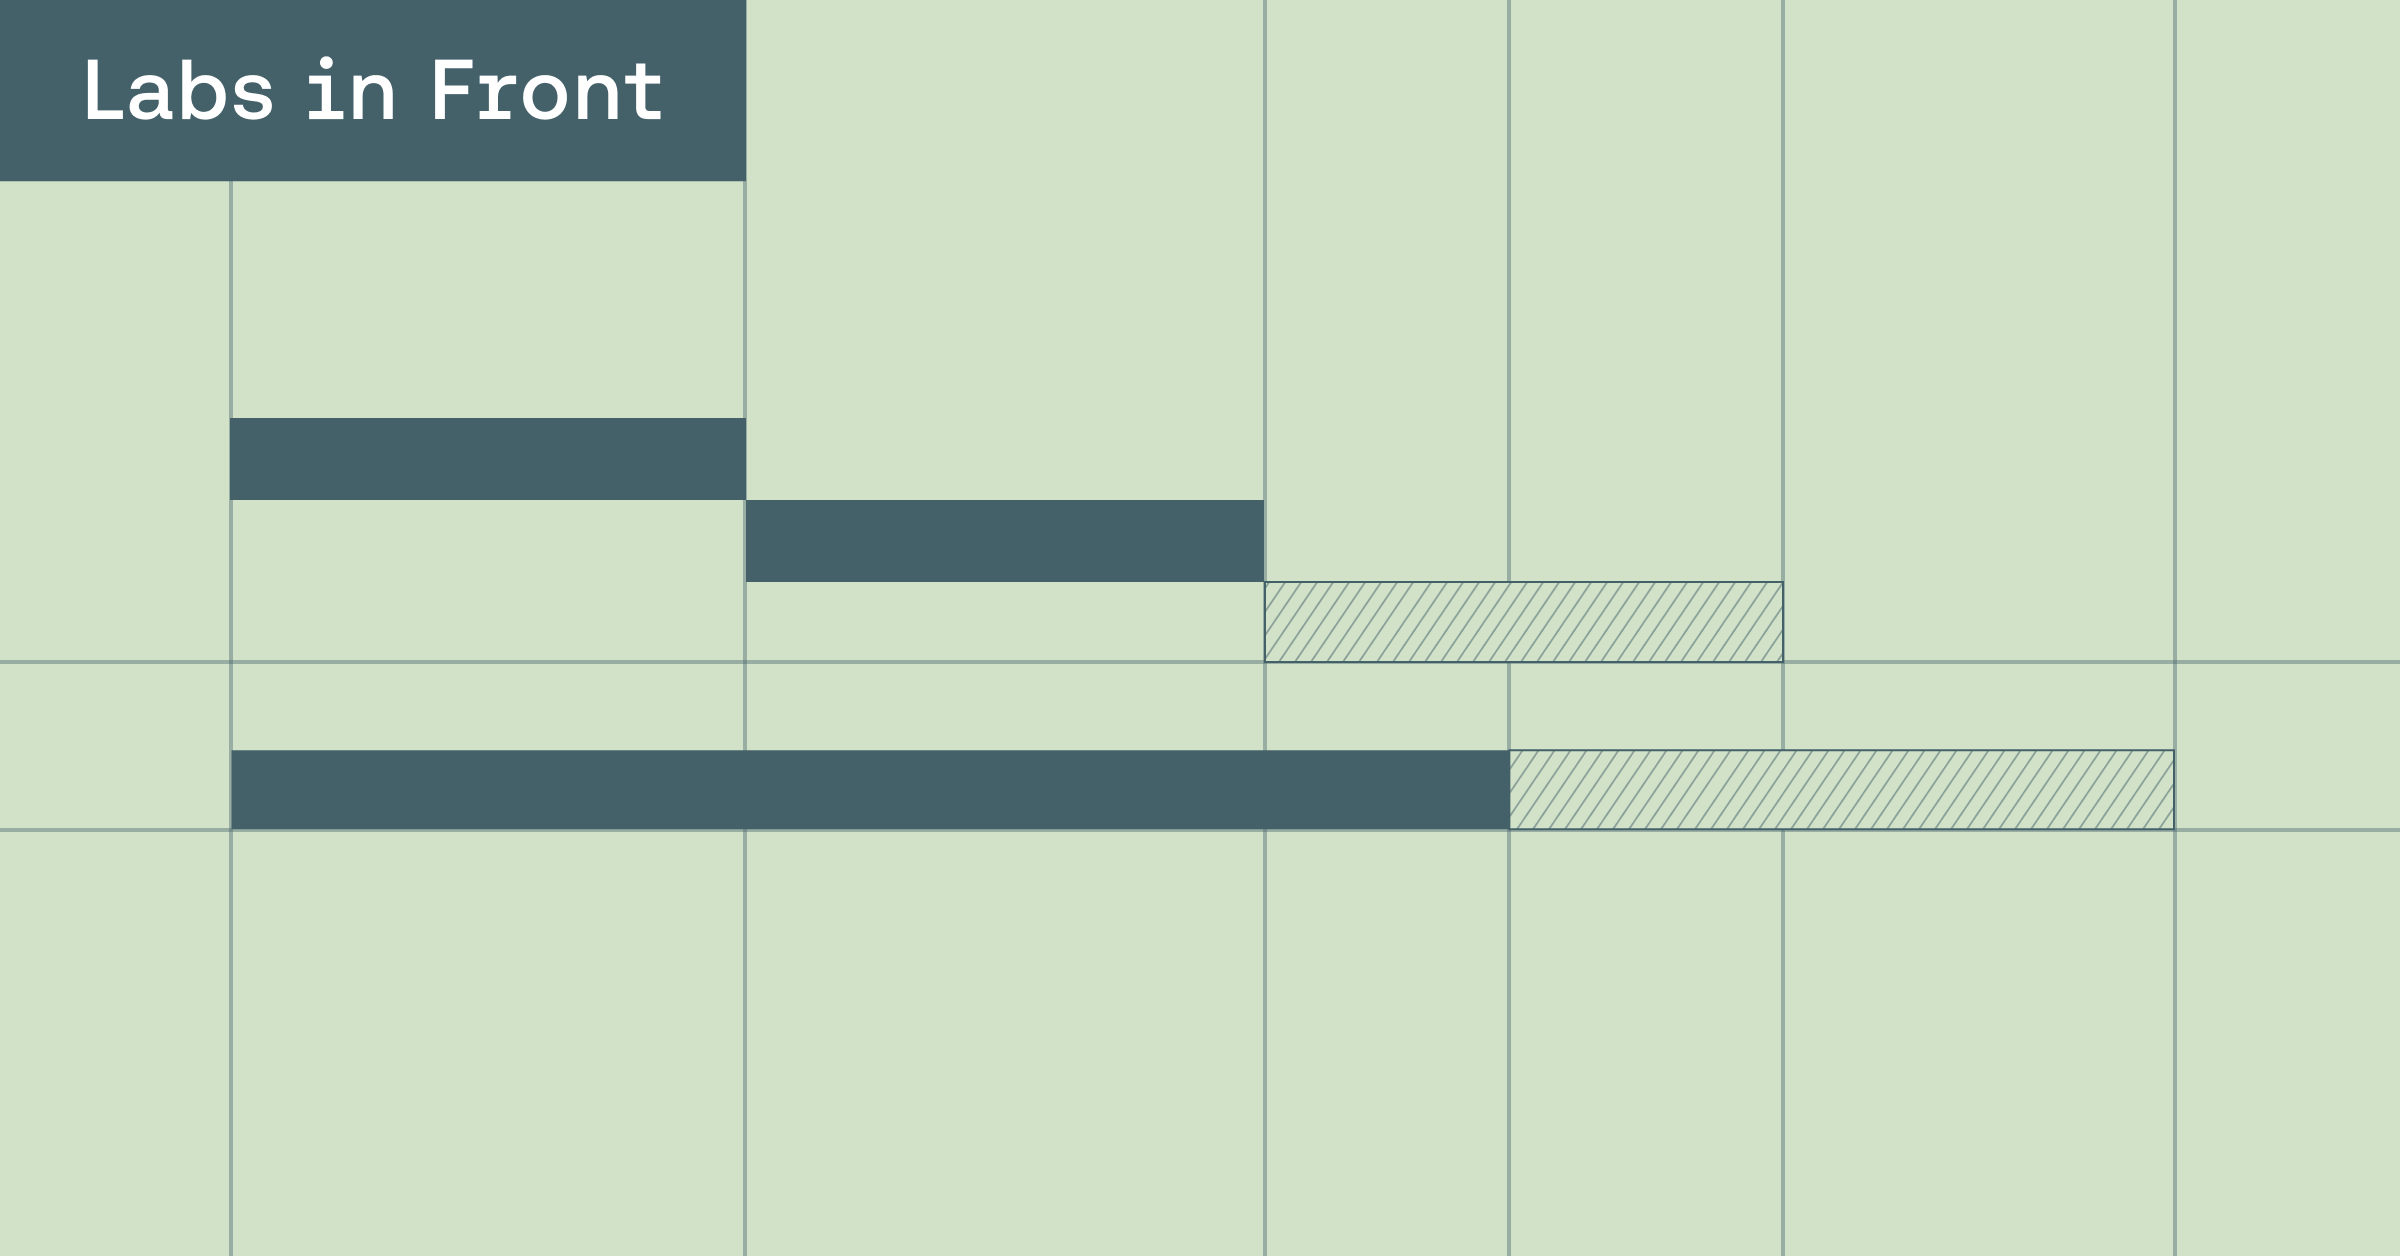
Это можно сравнить с командой, состоящей из младших, старших и ведущих специалистов. В нашем случае младшая модель параллельно «прочесывает» репозиторий, выполняя поиск, пробуя исправления и запуская тесты. Не каждая попытка оказывается удачной, но в совокупности они определяют, где находится исправление. Старшая модель подхватывает их наработки, углубляется в затронутый код и описывает, от чего именно зависит реальное исправление: задействованные функции, их вызовы, покрывающие их тесты. Только после этого ведущая модель приступает к написанию патча — один раз, на основе подготовленного брифа.
Таков наш конвейер: MiniMax-M3 в роли младших специалистов, GPT-5.2 в роли старшего, и пограничная модель (Opus 4.8 или Fable 5) в роли ведущего, которого мы привлекаем для единственного шага, где его мастерство меняет исход дела.
Оценка эффективности покрытия кода: получаем ли мы правильный контекст?
Одним из главных источников эффективности в этом конвейере является предоставление пограничной модели только наиболее релевантного и качественного контекста, чтобы она оставалась сфокусированной во время генерации патча. Поскольку патчи решений могут достигать десятков тысяч токенов, нерелевантный контекст создает шум, который может увести модель от правильного решения, заставляя ее «блуждать» и увеличивая затраты.
Поэтому перед финальной генерацией (шаг 3) мы проверили, содержит ли собранный нами контекст код, необходимый для исправления. Мы сделали это, сравнив его с эталонными патчами бенчмарка: для каждой задачи, какая часть строк, затрагиваемых эталонным патчем, также присутствует в нашем собранном контексте? Мы отслеживаем это двумя способами:
Параллельные запуски (младшая модель). Каждый запуск — это одна полная попытка открытого черновика (MiniMax-M3) решить задачу. По мере движения вдоль оси X на Рисунке 3 пул растет от 1 до 10, так как большее количество попыток в совокупности затрагивает больше релевантного кода.
Извлечение контекста (старшая модель). Помимо патчей-кандидатов, GPT-5.2 подтягивает окружающий код, от которого зависит исправление. Заштрихованная область на графике — это то, что добавляет этот этап извлечения сверх результатов запусков.
Рисунок 3. Покрытие строк эталонного патча в зависимости от размера пула запусков, с извлечением контекста GPT-5.2 и без него (заштриховано = прирост). Среднее значение на экземпляр по 731 публичной задаче SWE-Bench Pro.
Мы измеряем два типа строк кода отдельно:
- Удаленные строки — это строки, которые эталонный патч удаляет или изменяет, и они находятся в исходном коде. Покрытие здесь помогает ответить на вопрос: насколько хорошо мы нашли правильное «место» в репозитории для исправления? С помощью параллельных запусков и извлечения контекста мы достигаем ~90% покрытия строк этого типа.
- Добавленные строки — это новый код, который вносит исправление. Покрытие здесь помогает ответить на вопрос: насколько хорошо мы предложили правильное исправление? Для строк этого типа мы достигаем ~71% покрытия.
Отслеживание того, куда на самом деле уходят деньги
Наш конвейер, работающий с Fable 5, стоит $5,99 за задачу. Вот как эта цена распределяется по конвейеру:
Основное преимущество здесь заключается в снятии нагрузки с пограничной модели.
Когда агент на базе Opus 4.8 в одиночку берется за всю задачу от начала до конца, это стоит $18,28 (как сообщает Fireworks AI). В нашем конвейере пограничные модели потребляют лишь 25% бюджета, а остальную работу выполняют более дешевые модели. В результате весь наш конвейер обходится примерно в ⅓ стоимости работы одиночного агента Opus 4.8, превосходя его по качеству.
Основные выводы
- Подбирайте модель под этап. Открытые, более слабые модели не только дешевле, но теперь они достаточно хороши, чтобы эффективно генерировать варианты решений и искать в репозиториях. Оставьте ресурсы пограничных моделей для сложных задач, с которыми открытые модели все еще справляются с трудом.
- Повторно используйте то, за что вы уже заплатили. Рассматривайте параллельные запуски «младших» моделей как «карту исправлений». Используйте этот сигнал для извлечения контекста, а не отбрасывайте его после голосования.
- Собирайте исходный контекст после попыток решения задач. Поиск различительного контекста между известными патчами приводит к гораздо более сфокусированному и эффективному исходному контексту, который можно передать на следующий этап.
- Тратьте вычислительные ресурсы пограничных моделей экономно. Одиночная генерация пограничной модели на хорошо подготовленном контексте лучше, чем использование пограничной модели агентом от начала до конца. Используйте дорогую модель на этапе, где качество важнее всего.
Это лишь часть более масштабных усилий по оптимизации производительности агентов путем формирования правильной стратегии выполнения с использованием подходящих моделей. Следующим шагом станет обучение этапа извлечения исходного контекста для достижения более высокого уровня охвата.