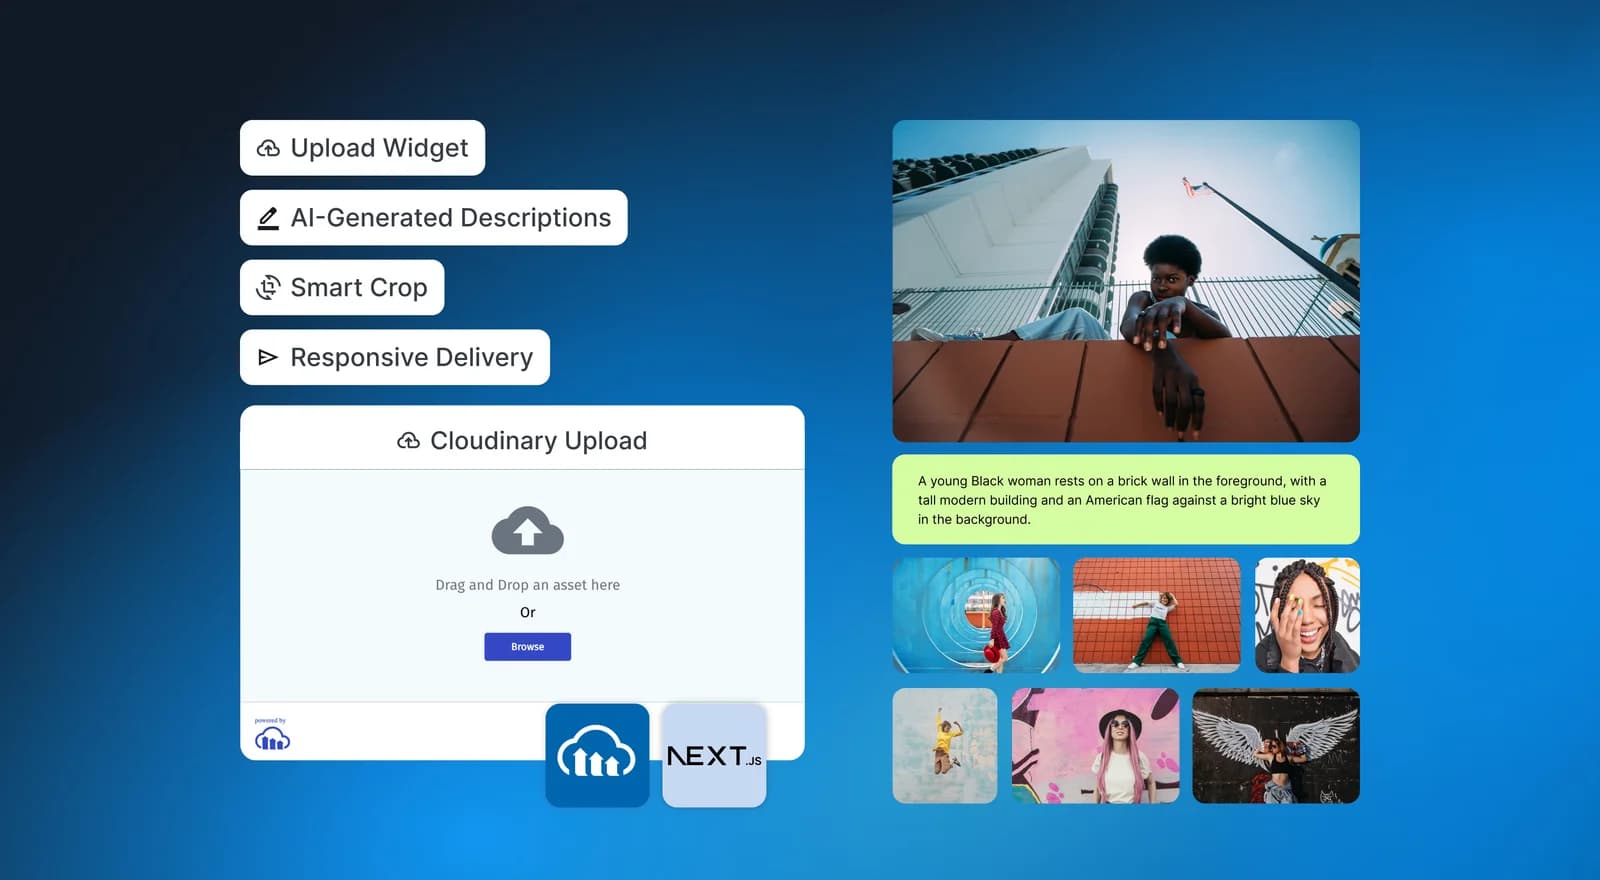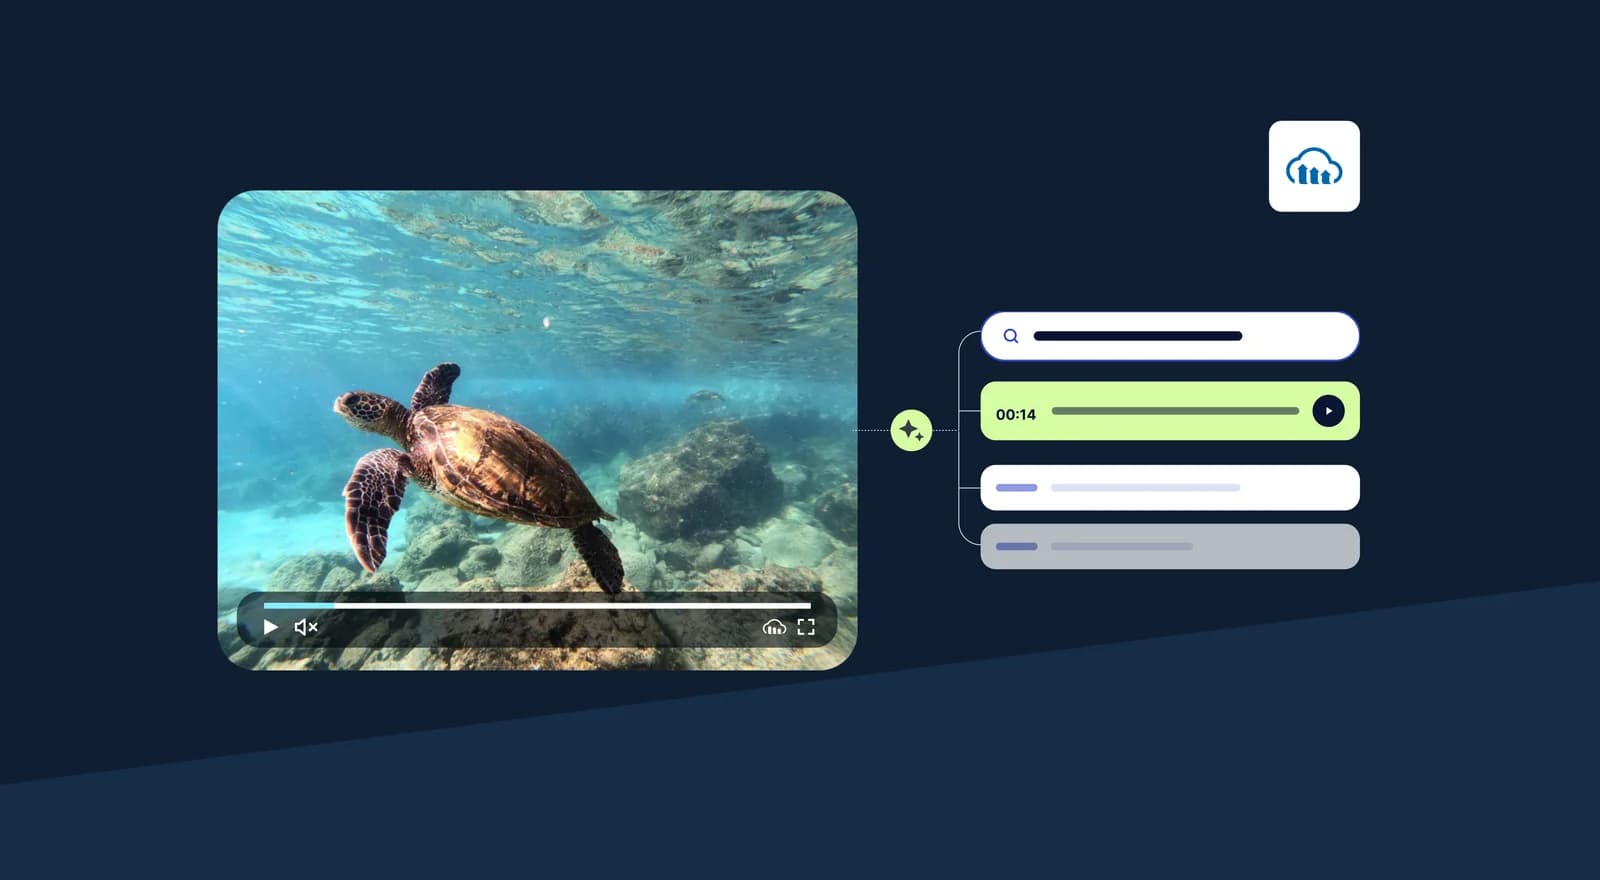
ИИ может выполнять поиск по видео без речи, преобразуя каждую визуальную сцену в текст с таймкодами, создавая эмбеддинги этих описаний сцен и находя ближайшую сцену для запроса на естественном языке. В ответ система может указать точное время начала и окончания сцены и сразу переключить видеоплеер на это доказательство.
В этом туториале вы создадите такой конвейер поиска с использованием Next.js, Cloudinary AI Video Analysis, эмбеддингов Gemini, Supabase pgvector и проигрывателя Cloudinary Video Player.
- Живая демонстрация: https://build-visual-rag-for-video.vercel.app/
- Репозиторий на Github: https://github.com/musebe/Build-Visual-RAG-for-Video
Готовое приложение представляет собой поисковый слой визуальной генерации с дополненной выборкой (Visual Retrieval-Augmented Generation, RAG). Оно возвращает ранжированные доказательства с таймкодами вместо того, чтобы заставлять языковую модель придумывать ответ. Позже вы сможете добавить генерацию, используя в качестве обоснованного контекста только найденные сцены.
Приложение работает по следующему конвейеру:
Посетитель может загрузить демонстрационное видео с морской черепахой или загрузить собственный файл в формате MP4, MOV или WebM. Cloudinary описывает визуально различимые сцены и присваивает им таймкоды. Приложение создает эмбеддинги для этих описаний, сохраняет их в Postgres и возвращает результаты, например 0:04.5–0:08.5. Выбор результата перематывает плеер к этому моменту.
Демо также включает воспроизводимый бенчмарк из 30 вопросов. Это доказательство имеет значение, поскольку привлекательный интерфейс поиска не гарантирует, что была найдена именно та сцена, которую вы ожидали.
Транскрипция речи отвечает на вопросы о том, что было сказано. Она не может надежно ответить на такие вопросы, как:
- Когда черепаха плывет к камере?
- В какой момент объект показан снизу?
- Когда объект покидает кадр?
- Где появляется видимый текст или происходит изменение цвета?
Эти ответы заложены в пикселях, а не в аудио.
Cloudinary AI Video Analysis генерирует визуальную стенограмму для видео, уже сохраненного в вашей программной среде Cloudinary. Каждый сегмент содержит описание, а также параметры start_time и end_time. Эта функция в настоящее время находится в стадии бета-тестирования, поэтому перед развертыванием в продакшене проверьте доступ в используемой среде продукта и перепроверьте текущий контракт API.
Это дает поисковой системе две вещи, которые обычная стенограмма речи предоставить не может: семантические описания видимых событий и привязанные к источнику временные диапазоны.
Оригинальная статья о RAG объединяет поиск с генерацией, чтобы модель могла отвечать на основе внешних данных. В визуальном видео-воркфлоу данные сначала необходимо сделать доступными для поиска.
В этом проекте этот процесс разделен на четыре этапа:
Архитектура сознательно сохраняет привязку таймкодов к описаниям на протяжении всего конвейера. Если текст внедряется без диапазона исходного файла, поиск может найти релевантное описание, но не сможет выдать проверяемую ссылку на видео.
Вам понадобятся:
- Node.js 20 или более поздней версии.
- Аккаунт Cloudinary и среда продукта с доступом к бета-версии AI Video Analysis.
- Проект Supabase.
- Ключ API Gemini из Google AI Studio.
- Аккаунт Vercel — только если вы хотите развернуть приложение.
В проекте используются Next.js 16, React 19, TypeScript, next-cloudinary, SDK Cloudinary для Node.js, компоненты shadcn и Vitest. Он был создан на основе create-cloudinary-next.
Клонируйте готовый проект и установите его зависимости:
Cloudinary отвечает за исходное видео, задачу визуального анализа, сгенерированный актив транскрипта и воспроизведение.
В консоли Cloudinary:
- Создайте или выберите программную среду.
- Откройте Settings (Настройки), затем API Keys (Ключи API).
- Скопируйте имя облака (cloud name), ключ API и секрет API.
- Убедитесь, что эта среда продукта имеет доступ к API AI Video Analysis (бета-версия).
- Загрузите демонстрационное видео в медиабиблиотеку (Media Library), если вам нужен многоразовый пример в один клик.
- Откройте этот актив и скопируйте его неизменяемый идентификатор (asset ID) для переменной DEMO_VIDEO_ASSET_ID.
AI Video Analysis — это возможность API, а не одно из аналогично названных дополнений для тегирования или транскрипции из Маркетплейса. Доступ и коммерческие условия могут измениться во время нахождения API в бета-версии.
Создайте файл .env.local из шаблона:
Добавьте плейсхолдеры для собственных учетных данных:
Публичным является только имя облака Cloudinary. Храните секрет API Cloudinary, секретный ключ Supabase и ключ API Gemini в переменных, доступных только на сервере. Немедленно замените секрет, если он появится в скриншоте, чате, логе или коммите Git.
Значение 100 МБ — это лимит приложения для этой демонстрации, а не ограничение платформы Cloudinary. Настройте его в соответствии с вашей моделью угроз и средой развертывания.
Примените все файлы из supabase/migrations в порядке их имен файлов с помощью Supabase CLI или SQL Editor.
Первая миграция включает pgvector, создает таблицы рабочего процесса и сохраняет каждую сцену с ее исходным временным диапазоном:
Полная схема визуального RAG также записывает идентификаторы активов Cloudinary, задачи анализа, транскрипты, состояния обработки и таймкоды. Полемические миграции добавляют поиск, хранилище бенчмарков, индексы и разрешения только для сервера.
Безопасность на уровне строк (RLS) включена без политик браузера, поскольку приложение обращается к этим таблицам только через доверенные маршруты Next.js. Секретный ключ Supabase никогда не попадает к клиенту.
Большие двоичные данные видео не должны проходить через сервер Next.js только для того, чтобы добраться до Cloudinary. Вместо этого браузер запрашивает у сервера ограниченные подписанные параметры и выполняет загрузку напрямую в Cloudinary.
Механизм подписи фиксирует общедоступный идентификатор (public ID), принятые форматы, теги, контекст, поведение при перезаписи и метку времени перед созданием подписи:
См. полную реализацию подписанной загрузки и маршрут подписи. Руководство Cloudinary по подписям загрузки объясняет, почему подпись должна создаваться в доверенной среде.
Браузер проверяет заявленный тип MIME, размер в байтах и заголовок файла перед запросом подписи. Затем он использует XMLHttpRequest, чтобы пользовательский интерфейс мог сообщать о прогрессе загрузки. Прочитайте полный документ о клиенте загрузки из браузера.
Проверки на стороне клиента улучшают обратную связь, но не являются границей безопасности. После загрузки сервер считывает актив через Cloudinary Admin API и проверяет его неизменяемый asset_id, пространство имен сгенерированного public-ID, контекст приема, декодированный формат и фактический размер в байтах.
Работающее приложение предлагает кнопку Load demo video, чтобы читатель мог протестировать поиск без загрузки дублирующегося контента. POST /api/videos/demo считывает DEMO_VIDEO_ASSET_ID, проверяет, был ли он уже проиндексирован, и повторно использует существующую запись в базе данных.
Если он новый, маршрут считывает актив Cloudinary по ID и запускает тот же конвейер анализа, который используется для загрузок:
См. полный маршрут демонстрационного видео. Использование неизменяемого идентификатора актива позволяет избежать зависимости от изменяемого имени файла или общедоступного ID как ключа идентификации приложения.
Эндпоинт анализа принимает идентификатор видеоактива Cloudinary и необязательный промпт визуальной транскрипции. Проект запрашивает конкретные видимые доказательства и указывает сервису не делать выводов на основе речи:
Полный клиент AI Video Analysis отправляет учетные данные в заголовке авторизации на стороне сервера, применяет тайм-аут, проверяет ответ и избегает логирования учетных данных.
Анализ выполняется асинхронно. Первоначальный запрос возвращает job_id, который приложение сохраняет перед началом опроса. Запрос состояния может вернуть pending (в ожидании), completed (завершено) или failed (ошибка). Сохранение ID задания означает, что процесс может продолжаться между запросами, а не удерживать одно открытое HTTP-соединение.
Когда задание завершается, Cloudinary возвращает исходный ресурс визуальной транскрипции. Приложение принимает только HTTPS-URL на res.cloudinary.com, ограничивает размер загрузки и проверяет каждый сегмент с помощью Zod:
См. visual-transcript.ts для анализаторов ответа-конверта и транскрипции.
См. для анализаторов ответа-конверта и транскрипции.
Для демо с морской черепахой продолжительностью 15,215 секунды Cloudinary сгенерировал три сцены:
Один сегмент Cloudinary превращается в одну извлекаемую сцену. Это позволяет сохранить сгенерированное описание, индекс сцены и исходные временные метки вместе. Более сложная разбивка на фрагменты может объединять или разделять сцены, но она должна сохранять привязку к исходным временным интервалам.
В проекте используется gemini-embedding-2 и явно запрашивается 1536 выходных размерностей в соответствии с векторным столбцом Postgres.
В текущей документации Google по эмбеддингам Gemini рекомендуется разделять поисковые документы и поисковые запросы во входных данных. Проект подготавливает их следующим образом:
Клиент эмбеддингов ограничивает каждый ввод, запрашивает ожидаемые размерности, проверяет каждое возвращенное число и обрабатывает сцены с ограниченным параллелизмом. См. gemini.ts и retrieval-input.ts.
Документы и запросы должны использовать одну и ту же модель эмбеддингов и размерность. Изменение моделей требует повторного создания эмбеддингов для корпуса сцен. Приложение сохраняет имя модели рядом с каждым вектором и отклоняет поиск, если проиндексированная модель отличается от настроенной.
Как только транскрипция готова, POST /api/videos/:videoId/index закрепляет видео за индексацией, создает эмбеддинги для каждого описания сцены, выполняет операции upsert для векторов и переводит рабочий процесс в состояние ready (готово).
Прочтите полный код маршрута индексации и repository.
Прочтите полный код маршрута индексации и .
Состояния рабочего процесса uploaded, analyzing, transcript_ready, embedding, ready и failed делают промежуточную обработку видимой. Условные обновления также мешают двум запросам претендовать на выполнение одного и того же шага индексации.
Для производственных нагрузок перенесите длительные этапы анализа и создания эмбеддингов в надежный фоновый рабочий процесс с повторными попытками, идемпотентностью и наблюдаемостью. Цикл опроса в браузере подходит для этого демонстрационного примера, но не для приема данных в больших объемах.
Supabase ранжирует векторы по косинусному расстоянию. Функция SQL сначала ограничивает поиск запрошенным готовым видео и подходящей моделью эмбеддингов, а затем упорядочивает эти сцены по степени схожести:
Прочтите полную миграцию поиска по сцене. Перенос фильтра видео в функцию базы данных соответствует рекомендациям Supabase по семантическому поиску и позволяет избежать получения несвязанных строк перед их фильтрацией в коде приложения.
В демоверсии используется точный косинусный поиск, так как каждое проиндексированное видео содержит небольшое количество сцен. По мере роста корпуса оцените векторный индекс, такой как HNSW, и измерьте полноту (recall) с помощью ваших реальных фильтров. Документация Supabase описывает доступные компромиссы в своем руководстве по векторным индексам.
POST /api/videos/:videoId/search проверяет вопрос, преобразует его в поисковый запрос с помощью эмбеддингов, вызывает функцию Supabase и преобразует каждое совпадение из базы данных в общедоступную цитату:
Ответ включает описание сцены, степень схожести, время начала, время окончания и отображаемую цитату. См. полный search routeмаршрут поиска и форматтер цитат.
Языковая модель не обязана выдавать этот результат. Если вы добавляете ее, передавайте ей только полученные описания и временные метки, требуйте цитирования и сохраняйте видимость результатов исходной сцены. Качество поиска и качество ответа следует оценивать раздельно.
Интерфейс отрисовывает CldVideoPlayer из next-cloudinary. Поскольку плеер зависит от API браузера, он импортируется динамически с отключенным рендерингом на стороне сервера. Когда посетитель выбирает результат, компонент переходит к указанному времени начала и начинает воспроизведение:
API видеоплеера Cloudinary предоставляет методы currentTime() и play() для этого взаимодействия. Полный компонент поиска по видео также включает прогресс загрузки, состояния обработки, доступные кнопки результатов и три примера поиска, которые читатели могут вставить в один клик.
Попробуйте эти вопросы в живой демоверсии:
- Когда черепаха видна снизу?
- Когда черепаха подплывает близко к камере?
- Когда черепаха уплывает?
Бенчмарк проверяет два независимых утверждения:
- Расположил ли поиск сцену с разметкой человека на первом месте?
- Пересекалась ли верхняя цитата с диапазоном времени, размеченным человеком?
sea-turtle-v1 dataset содержит ровно 30 вопросов с десятью метками для каждой из трех сцен. Метки были созданы путем просмотра исходного видео до поиска, а не путем копирования формулировок из сгенерированных Cloudinary описаний.
Каждый запуск сохраняет версию набора данных, промпт анализа Cloudinary, модель эмбеддингов, пороговое значение, количество результатов, отранжированные результаты и агрегированные метрики. Это делает результат воспроизводимым и предотвращает ситуацию, когда настроенный порог незаметно скрывает сложные совпадения.
В отчете бенчмарка указано:
Вы можете изучить рабочий стол браузера по адресу /benchmark?video=<video-id> и полный протокол бенчмарка.
Проверенный запуск был завершен 23 августа 2026 года для образца видео с морской черепахой samples/sea-turtle от Cloudinary длительностью 15,215 секунды. Использовались три сцены Cloudinary, gemini-embedding-2 с 1536 размерностями, косинусное сходство, отсутствие настроенного порога поиска и три возвращенных результата.
Четыре вопроса, помеченные для вводной сцены, поставили на первое место другую сцену. В пропущенных случаях использовались такие фразы, как «поворот» (turn), «перед тем как он приблизится» (before it approaches) и «под углом к кадру» (angled across the frame), которые также описывают движение в последующих сценах. Во всех четырех случаях ожидаемая сцена заняла третье место.
Это результат контролируемой демонстрации, а не заявление об общей точности. Поскольку корпус содержит одно короткое видео и ровно три проиндексированные сцены, возвращение трех результатов делает показатель попадания в топ-3 (top-3 recall) слабым критерием. Более надежная оценка требует более длинных видео без звука, большего количества сцен, независимо проверенных меток, разнообразных визуальных доменов и результатов по каждому видео.
Добавьте те же переменные окружения в проект Vercel, сохранив все секретные данные исключительно на сервере, а затем разверните приложение. Выполните эту проверку работоспособности после развертывания:
Эндпоинт сообщает, настроены ли Cloudinary, Supabase и эмбеддинги, не возвращая при этом учетные данные. Проверенное публичное развертывание возвращает HTTP 200 со всеми тремя включенными службами.
Проверьте всю систему после локальной настройки или развертывания:
- Откройте живую демоверсию SceneSeeker.
- Выберите Load demo video (Загрузить демовидео).
- Дождитесь сообщения Ready to search (Готово к поиску).
- Выберите один из примеров поиска.
- Отправьте вопрос и откройте результат.
- Убедитесь, что видеоплеер Cloudinary переходит к процитированной сцене.
Для производственного трафика добавьте аутентификацию, квоты запросов, лимиты скорости, правила хранения ресурсов, надежные фоновые задания, средства управления повторными попытками и мониторинг злоупотреблений.
Визуальная транскрипция также не заменяет транскрипцию речи. Промышленная поисковая видеосистема может индексировать визуальные сцены, произнесенные слова, текст на экране и структурированные метаданные ресурсов как отдельные каналы данных, а затем сравнивать их вклад при оценке.
Немое видео становится доступным для поиска, когда визуальные данные преобразуются в описания с временными метками, которые остаются связанными с исходными сценами. Cloudinary хранит видео, создает визуальную стенограмму и воспроизводит цитируемые моменты. Gemini создает эмбеддинги для поиска, в то время как Supabase pgvector ранжирует совпадающие сцены.
Самый важный выбор при проектировании — это не поисковая строка. Это сохранение происхождения от стенограммы Cloudinary через векторное хранилище до финального действия плеера. Именно это превращает правдоподобное семантическое совпадение в цитату с временной меткой, которую можно проверить.
Готовы начать разработку с Cloudinary? Зарегистрируйте бесплатную учетную запись сегодня.