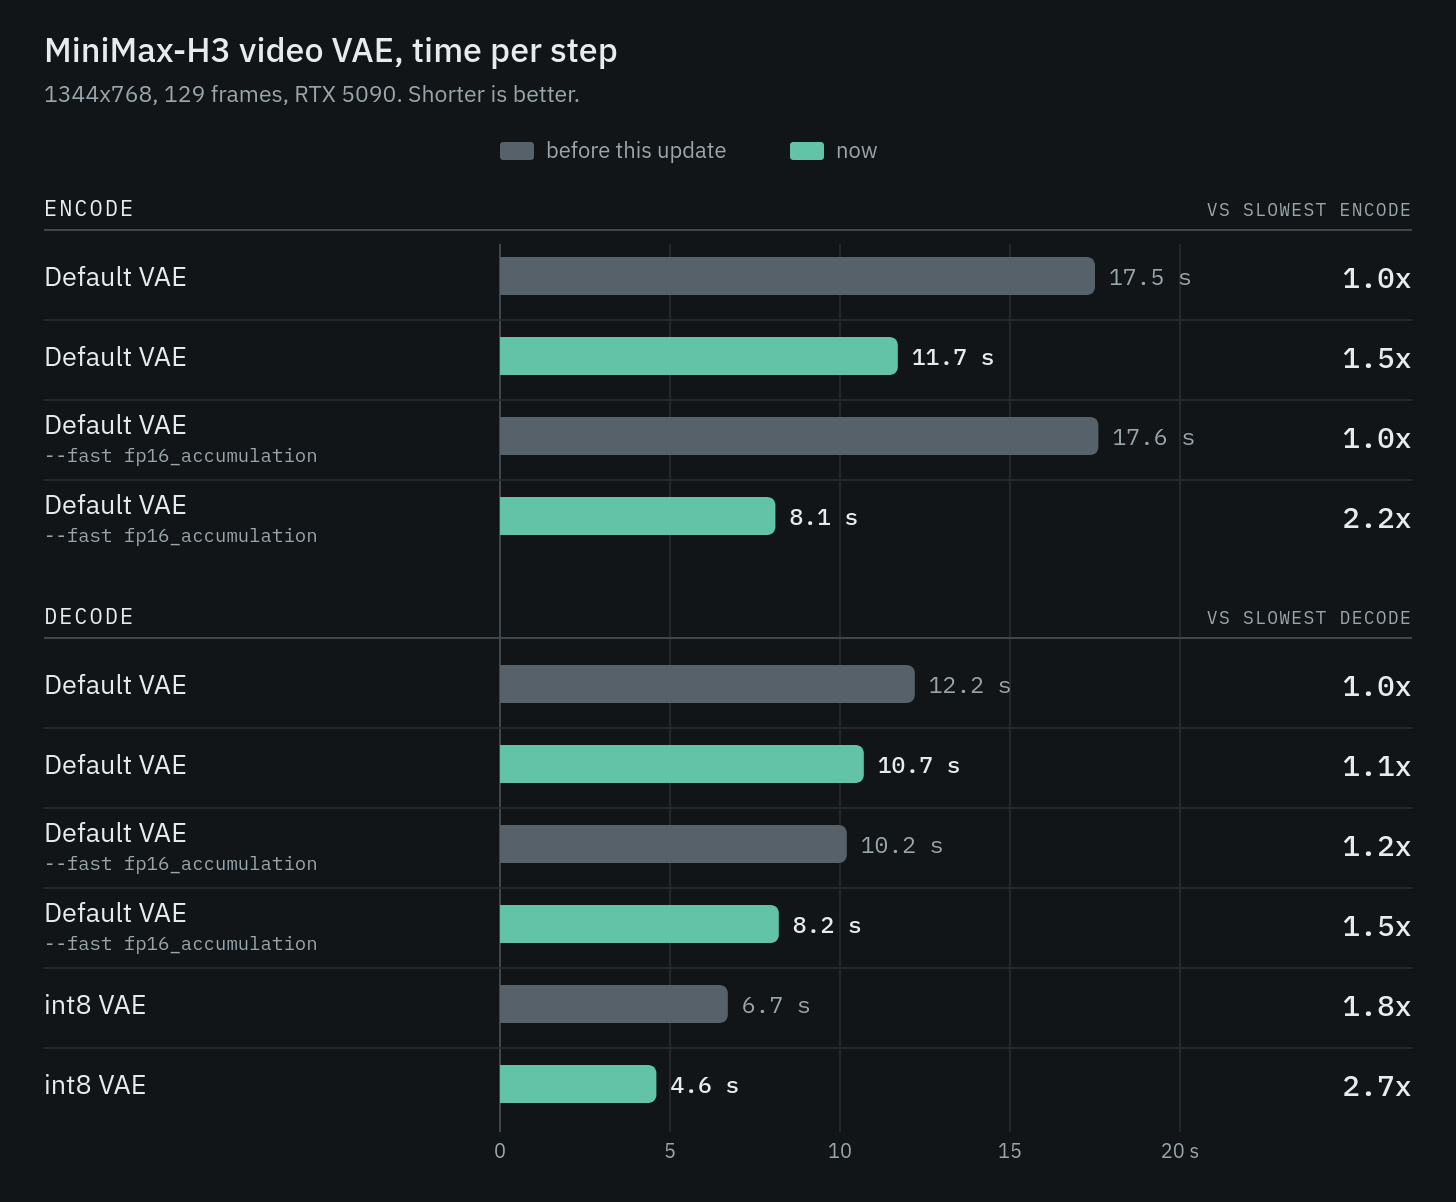
Видео VAE MiniMax H3 теперь кодирует примерно в ~2.2 раза быстрее и декодирует в ~1.4–2.7 раза быстрее. В сумме это позволяет примерно вдвое сократить время, затрачиваемое видеопроцессом на VAE: полный цикл кодирования и декодирования для разрешения 1344x768 и 129 кадров сокращается с 24.3 до 12.7 секунд.
- Объединенный ядро энкодера, включенное по умолчанию. Между свёртками энкодер нормализовывал каждый кадр, применял активацию и дополнял границы нулями (падинг), причем каждое действие выполнялось за отдельный проход по сотням мегабайт. Теперь это один проход, записывающий данные прямо в структуру памяти, необходимую для следующей свёртки. Ускорение составляет ~1.5 раза при идентичном качестве вывода.
Объединенный ядро энкодера, включенное по умолчанию. Между свёртками энкодер нормализовывал каждый кадр, применял активацию и дополнял границы нулями (падинг), причем каждое действие выполнялось за отдельный проход по сотням мегабайт. Теперь это один проход, записывающий данные прямо в структуру памяти, необходимую для следующей свёртки. Ускорение составляет ~1.5 раза при идентичном качестве вывода.
- Свёртки, поддерживающие --fast fp16_accumulation. PyTorch отправляет свёртки в cuDNN, библиотеку NVIDIA, и в ней нет возможности запросить накопление в fp16, поэтому данный флаг раньше применялся только к матричным умножениям, а энкодер от него ничего не получал. Новая пользовательская свёртка поддерживает его, причем смещение и пропускное соединение (skip connection) встроены в нее. Это ускоряет энкодер примерно до ~2.2 раза.
Свёртки, поддерживающие --fast fp16_accumulation. PyTorch отправляет свёртки в cuDNN, библиотеку NVIDIA, и в ней нет возможности запросить накопление в fp16, поэтому данный флаг раньше применялся только к матричным умножениям, а энкодер от него ничего не получал. Новая пользовательская свёртка поддерживает его, причем смещение и пропускное соединение (skip connection) встроены в нее. Это ускоряет энкодер примерно до ~2.2 раза.
- Декодер int8. В файле int8 VAE веса декодера имеют 8-битную разрядность, а нормализация, активация и пропускное соединение встроены в матричные умножения, поэтому промежуточные результаты никогда не попадают в память. Механизм внимания (attention) также работает в 8-битном режиме. Это на 1.4 раза быстрее по сравнению с предыдущей реализацией int8 VAE.
Декодер int8. В файле int8 VAE веса декодера имеют 8-битную разрядность, а нормализация, активация и пропускное соединение встроены в матричные умножения, поэтому промежуточные результаты никогда не попадают в память. Механизм внимания (attention) также работает в 8-битном режиме. Это на 1.4 раза быстрее по сравнению с предыдущей реализацией int8 VAE.
Измерения проводились на RTX 5090 при разрешении 1344x768 и 129 кадрах путем сравнения каждой конфигурации с ее состоянием до этого обновления. Ничто здесь не привязано конкретно к этой видеокарте: объединенное ядро энкодера снижает нагрузку на трафик памяти, что идет на пользу любому GPU от NVIDIA.
Режим --fast fp16_accumulation помогает на потребительских видеокартах, где накопление в fp16 выполняется с удвоенной скоростью.
Скорее всего, вы не заметите разницы визуально.
Любой VAE теряет немного деталей при сжатии видео и его восстановлении, и эта потеря присутствует всегда. Дополнительные потери от ускоренных путей int8 примерно в 30 раз меньше, что намного ниже порога видимости на кадре.
Кодирование по-прежнему выполняется в fp16 даже при использовании int8 VAE, а объединенное ядро работает без потерь — оно просто вычисляет те же значения в другом порядке.
В технических терминах: декодер int8 соответствует стандартному декодеру на уровне 67.7 дБ PSNR, а ускоренный энкодер — примерно на 68 дБ, по сравнению с примерно 38 дБ для собственной реконструкции реальных кадров с помощью VAE.
- Обновите ComfyUI до версии v0.36.0 или выше. Объединенному ядру энкодера больше ничего не требуется.
Обновите ComfyUI до версии v0.36.0 или выше. Объединенному ядру энкодера больше ничего не требуется.
- Запустите ComfyUI с параметром --fast fp16_accumulation для ускорения работы энкодера и декодера.
Запустите ComfyUI с параметром --fast fp16_accumulation для ускорения работы энкодера и декодера.
- Скачайте рабочие процессы ниже или найдите их в библиотеке шаблонов.
Скачайте рабочие процессы ниже или найдите их в библиотеке шаблонов.
- Загрузите файл int8 MiniMax-H3 VAE для максимально быстрого декодирования. Это прямая замена стандартного файла.
Загрузите файл для максимально быстрого декодирования. Это прямая замена стандартного файла.
Все показатели получены в результате тех же измерений методом A/B по сравнению со сборкой до внесения изменений, выполненных через узлы VAE Encode и VAE Decode.
Нет записей