Кто-то спросил меня, сколько серверов мы используем, и я не смог ответить. По крайней мере, за 30 секунд. У меня были открыты вкладка vCenter, вкладка Prism, два CSV-экспорта в разных форматах и таблица, которую я пересоздавал чаще, чем мне хотелось бы признавать. Чего у меня не было, так это единой инвентаризации VMware и Nutanix, которую можно было бы выгрузить, кому-то отдать и сверить с реальностью.
Я поддерживаю тестовый дата-центр на обеих платформах: VMware vCenter в семи кластерах, Nutanix Prism Central в трех, а снизу установлены Cisco UCS и HyperFlex. У обеих платформ отличные интерфейсы. Ни одна из них понятия не имеет о существовании другой.
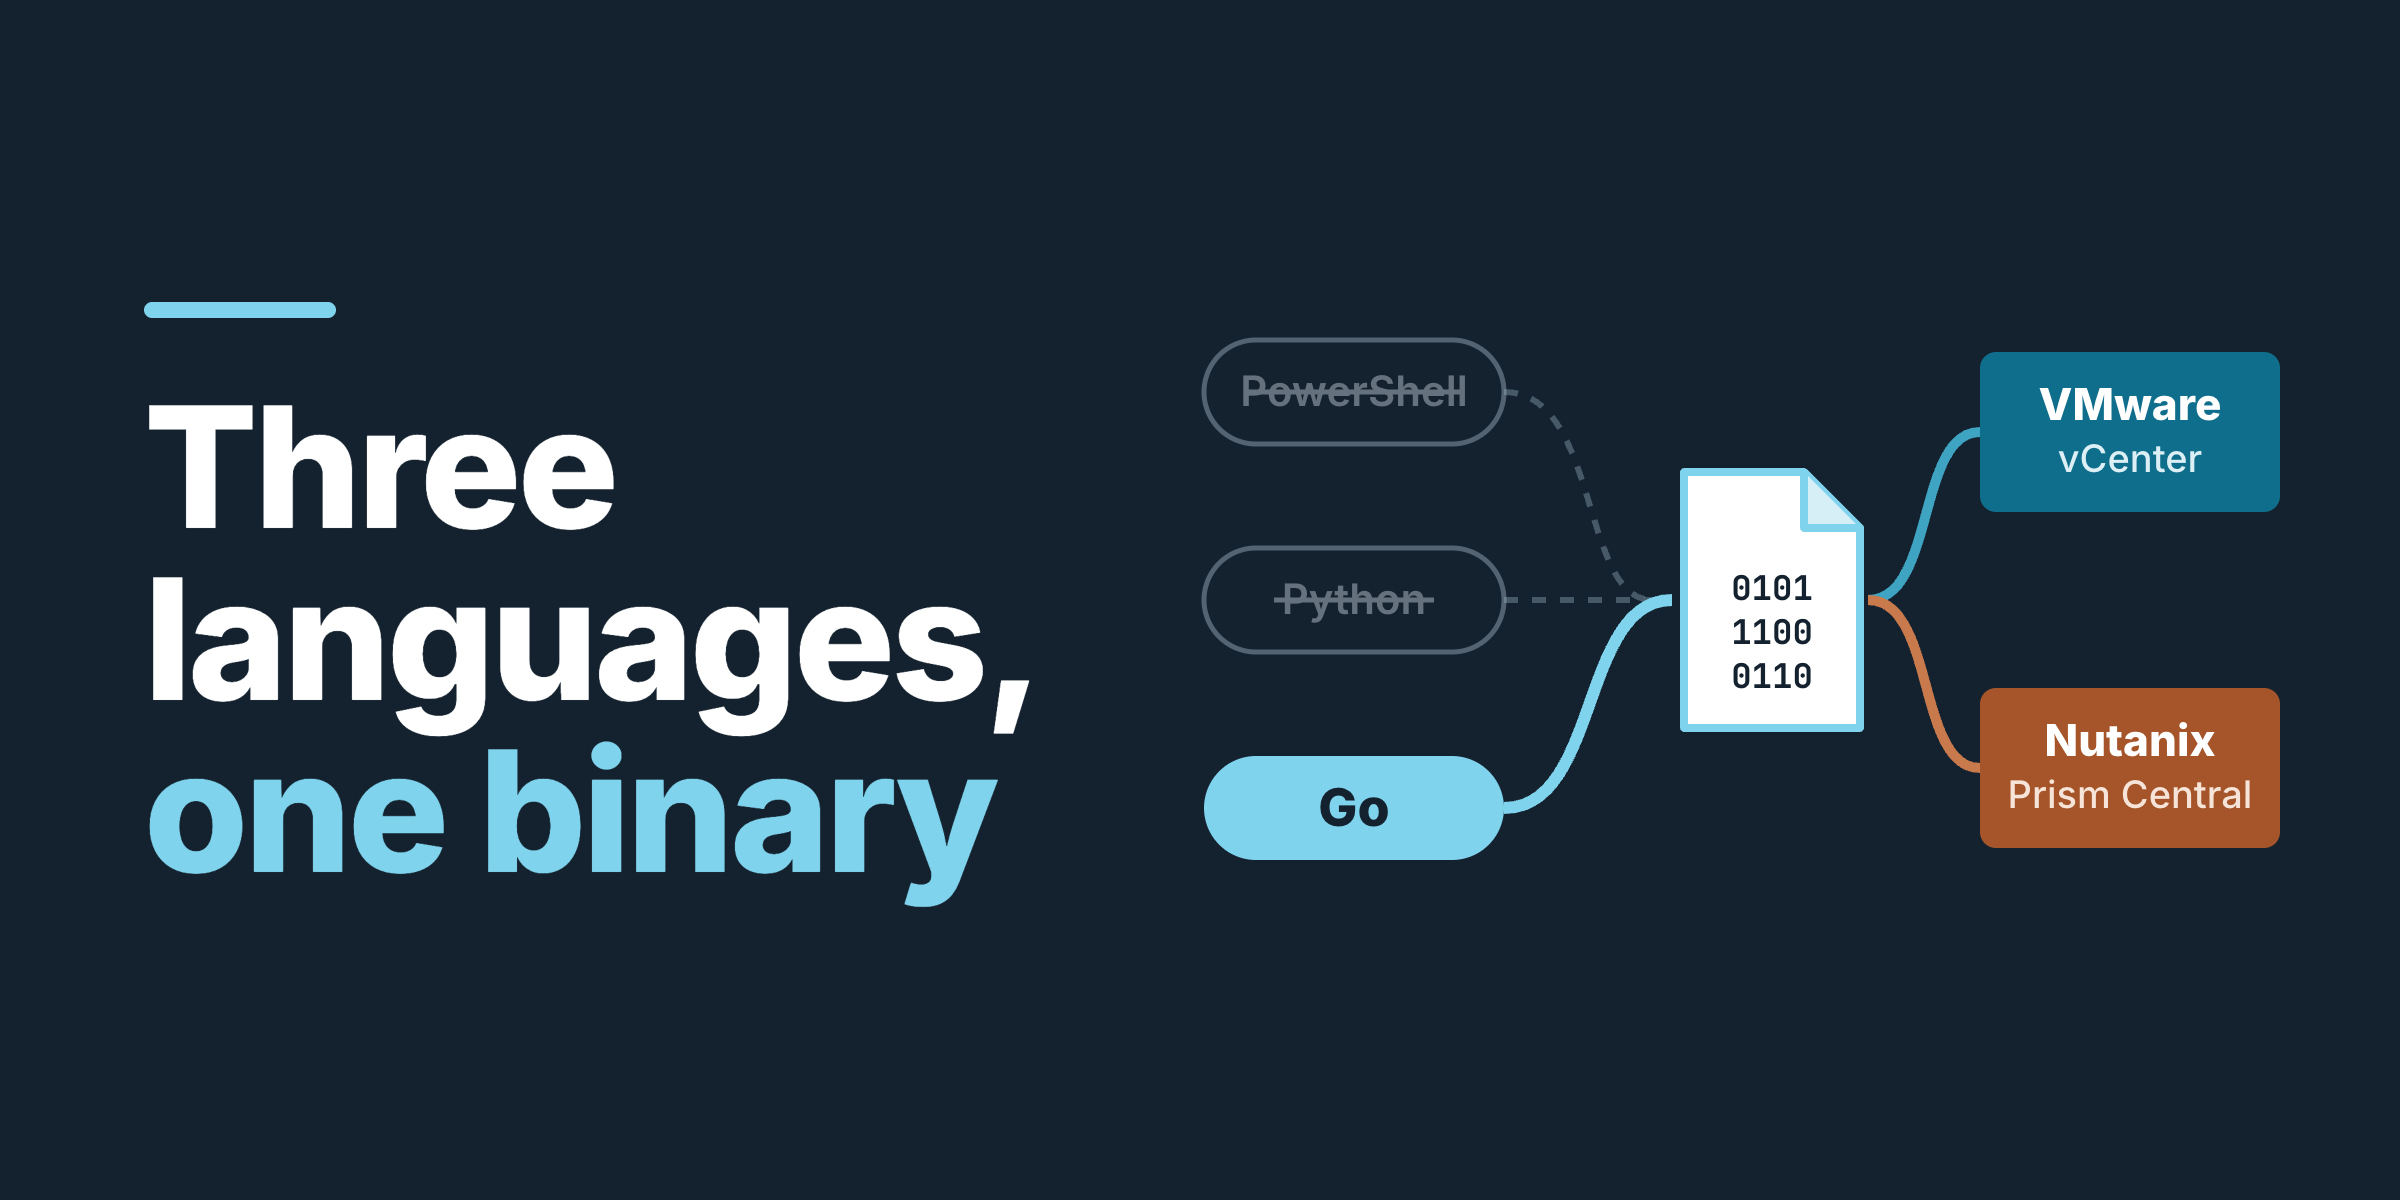
Четыре месяца спустя один бинарник на Go за один проход инвентаризирует 104 сервера и 2139 виртуальных машин на обеих платформах. Большую часть кода написал Claude. Чтобы прийти к этому, понадобилось три языка программирования, две черновые версии и три бага, которые месяцами прятались у всех на виду.
Инвентаризация VMware и Nutanix, которую никто не мог мне предоставить
Даже данные по одной платформе были скудными. Экспорт хостов из vCenter не включал модель сервера в удобном виде, поэтому ответ на вопрос «на каком «железе» мы работаем?» требовал ручной сверки с UCS Manager. Когда инструмент выдал результат, оказалось, что моделей 11: 24 блейд-сервера UCS X210C-M7, 18 стоечных C225-M6S, 19 узлов HyperFlex в четырех вариантах и длинный хвост из одиночных машин.
Это было неприятно. Срочность же придала миграция: перенос нашей библиотеки готовых шаблонов виртуальных машин с vCenter на Nutanix. Их насчитывается 371 штука, они неравномерно распределены по трем тестовым кластерам, и ни у кого не было актуального списка. Попробуйте спланировать такое, глядя на две вкладки браузера.
Мое интернет-соединение повлияло на архитектурное решение
Я работаю удаленно, через фиксированное беспроводное WiMAX-соединение. Каждый вызов API проходит по каналу с реальной задержкой и склонностью обрываться без предупреждения. Я потерял не один сеанс инвентаризации из-за чертового таймаута где-то на двух третях работы, причем на диск ничего не записывалось. Поэтому эффективность перестает быть приятным бонусом и становится вопросом выживания: завершится отчет или нет.
Поэтому соединение диктовало правила:
- Запрашивайте только те данные, которые действительно читаете.
- Записывайте результат по ходу дела.
- Выпускайте программу, которая запускается из одного файла и не требует установки.
Я уже автоматизировал это. Claude сдвинул границы
У меня уже был рабочий PowerShell-скрипт, который я запускал удаленно против vCenter по одному запросу за раз, когда кто-то просил. Настоящий вопрос заключался в том, как далеко стоит зайти, прежде чем усилия перестанут окупаться. Claude отодвинул эту грань очень далеко.
Он быстро выдавал правдоподобный результат, а я был единственным, кто мог определить, правильный ли он. Вот как распределилась работа:
- Мои задачи: что именно программа должна выдавать, выбор языка (трижды), архитектура, модель безопасности и каждая проверка на реальном «железе».
- Работа Claude: шаблонный код, перевод с одного языка на другой, когда я менял свое мнение, механика API, которую не хотелось запоминать (пагинация, структура свойств SOAP-запроса), а также первые черновики, с которыми я спорил или отправлял на доработку.
PowerShell работал, а затем начал плодиться
Я хотел, чтобы все дерево объектов обходилось за один проход, с получением структурированного CSV для каждого слоя: дата-центры, кластеры, хосты, виртуальные машины, датасторы. Я точно знал, как это должно выглядеть. Я просто не хотел тратить два недели вечеров на набор кода.
Поэтому я описал нужную мне структуру, и Claude справился с масштабом за один день. Проблема была в том, что я все еще относился к этому как к одолжению самому себе, а не как к проекту. Вот эта папка, без изменений спустя четыре месяца:
Четыре версии менее чем за 24 часа. Обратите внимание на порядок. Финальная версия появилась в 19:00. Затем версия 3 появилась на следующее утро. Каждый инженер, читающий это, лично знаком с такими именами файлов. Черт, я бы смеялся, если бы они не были моими.
Так выглядит отсутствие контроля версий на диске, и это полностью моя вина. Когда новая версия стоила мне всего пару минут, бардак не раздражал настолько, чтобы заставить меня остановиться и все исправить.
Я забросил этот подход по двум причинам, которые недооценил. PowerCLI на моем Mac с процессором Apple Silicon был настоящей занозой в теле: он работает под PowerShell 7, но я постоянно сталкивался с проблемами модулей и зависимостей при любых обновлениях. К тому же, долгие последовательные запуски — это как раз то, что мое соединение любило обрывать на 70% без какого-либо сохранения данных.
Python дал мне верную копию, со старой структурой и всем остальным
Тот же день, вторая попытка. pyVmomi от VMware, Python SDK для vSphere API, дает мне тот же API на Python, а Python работает на моем Mac нативно. Я попросил сделать полный перенос, и получил именно его. В комментарии в шапке до сих пор написано:
Именно это я и получил, включая те части, от которых хотел избавиться. Получилось 845 строк, а 16 минут спустя — уже 922 строки. Если бы я хотел переосмыслить подход, нужно было об этом попросить.
Python принес одну полезную вещь: сначала загрузить весь граф объектов в память, чтобы инвентаризация не «плыла», если какая-то виртуальная машина мигрирует прямо во время работы скрипта.
Затем возникла стена. Каждой машине для запуска нужен Python, виртуальное окружение (venv) и установка через pip. Когда коллега попросил скрипт, моим честным ответом было: «Конечно, сначала настрой venv», — на этом этапе большинство людей прекращают попытки. К тому же это был единый файл размером почти в тысячу строк, а Nutanix еще даже не был добавлен.
Go: один файл, который коллега действительно может запустить
Go решил то, что волновало меня больше всего: возможность передать инструмент кому-то другому. Он компилируется в единый автономный бинарник: без интерпретатора, без среды выполнения, ничего не нужно устанавливать.
Для VMware используется govmomi, открытая библиотека Go от VMware для vSphere API, так что мне не приходилось бороться с платформой. Для Nutanix я использовал собственный компактный REST-клиент для Prism Central, который обрабатывает пагинацию и сглаживает различия между версиями API. Это больше кода для поддержки, но зато появилась полноценная поддержка второй платформы.
Здесь 7437 строк — примерно в восемь раз больше, чем в версии на Python, потому что программа делает гораздо больше: поддерживает две платформы, меню, запросы VLAN и подсетей, поиск MAC-адресов на обеих платформах, поиск «сирот» (заброшенные папки ВМ, непривязанные диски, неиспользуемые образы), а также логи сеансов и аудита.
Результат: инвентаризация VMware и Nutanix, охватывающая 104 сервера и 2139 виртуальных машин в vCenter и Prism Central за один проход, из файла, который я могу передать кому угодно.
Программа читает данные и формирует отчеты. Она пока не занимается мониторингом, не работает в фоновом режиме без участия человека и не пишет в Excel. Единственное действие на запись — удаление «сирот». Прежде чем появилась хоть одна строка этого кода, я решил, что программа будет сначала спрашивать, дважды подтверждать действие и логировать каждое удаление.
SOAP с одной стороны, REST с другой. Все, что находится ниже адаптеров, является общим, поэтому новый отчет пишется один раз.
Три бага, которые месяцами выглядели безобидно
Все три содержались в коде, который успешно компилировался и выглядел нормально. Выявить их удалось только путем запуска и тщательного изучения вывода.
Одно имя свойства стоило девяти минут на каждый запуск
Сбор данных по 68 хостам занимал 9 минут и 6 секунд. При моем канале связи это девять минут надежды. Ничто в коде не выглядело подозрительно, поэтому я проверил, что именно запрашивается у vCenter. Программа вытягивала полную конфигурацию каждого хоста, включая сети, хранилища и правила брандмауэра, и при этом ни разу их не читала.
Отчет считывает версию ESXi из summary.config, и кажется, что для этого требуется блок config верхнего уровня. Это не так. Это два разных объекта, в названии которых просто совпадает слово. Я удалил одну строку из списка свойств, и время формирования отчета сократилось до 40 секунд, что в 13,7 раза быстрее. Замер времени выполнения позволил это обнаружить.
Первый же написанный мной тест обнаружил сбой
В течение нескольких месяцев в репозитории не было тестов. Новые функции появлялись так быстро, что я никогда не останавливался, чтобы написать хотя бы один. Добавляя столбец модели оборудования, я наконец написал тест: я передал в CSV-экспорт нормальный хост и хост с пустой сводкой, чтобы посмотреть, что произойдет в граничных случаях. Второй вариант привел к сбою всего отчета.
vCenter может оставлять некоторые поля сводки пустыми для отключенных или не отвечающих хостов, и код считывал их без проверки в трех местах. Все хосты в моей инфраструктуре были исправны, поэтому ошибка никогда не возникала. Первый же отключенный хост обрушил бы весь отчет.
Мой файл .gitignore поглотил целый пакет
Эта ошибка полностью на моей совести. В моем файле игнорирования была строка reports/, которая исключала сгенерированные файлы CSV из репозитория. Без ведущего слэша шаблон gitignore вроде этого совпадает на любой глубине, поэтому он также исключал internal/prism/reports/ — весь пакет отчетности Nutanix.
Четыре файла, 1 311 строк, которые так и не были закоммичены. В моем собственном файле README они были описаны, именно поэтому никто ничего не заметил. Свежий клон моего собственного репозитория даже не скомпилировался бы. Ну просто отлично. Исправление свелось к одному символу: /reports/.
Какому количеству узлов верить?
Две конечные точки Nutanix расходятся во мнениях о том, сколько узлов в кластере. Одна сообщает о 13 и 25. Другая перечисляет 12 и 24, причем для каждого узла указаны модель и серийный номер, на которые я могу указать. Измерения проведены с разницей в две секунды. Ни одна из них не выдает ошибку, и обе выглядят так, будто точно знают, о чем говорят.
Чтение кода не подскажет, кому верить. Ответ кроется в самой инфраструктуре. Ситуацию прояснило то, что знаю я и чего не знает инструмент: каждый используемый нами узел является гиперконвергентным. Здесь нет свидетелей, узлов только для вычислений или только для хранения, поэтому пересчитанное количество является истинным.
Теперь инструмент отдает предпочтение подсчитанному количеству и записывает предупреждение в лог, когда показатели расходятся. Что именно подсчитывает другая конечная точка, до сих пор остается загадкой.
Более тихая версия той же ловушки: три поля Nutanix возвращались пустыми или нулевыми вместо того, чтобы вызывать ошибку (модель сервера, кластер, к которому принадлежит хост, а также количество узлов и виртуальных машин). В инвентаризации VMware Nutanix, на основе которой кто-то будет планировать миграцию, это пугающий тип ошибки. Она выглядит как данные.
Теперь, если какое-то значение может не прийти, инструмент открыто заявляет об этом вместо того, чтобы выводить пустой столбец.
Что я хотел бы сказать вам перед началом
Черновые версии и были требованиями. PowerShell подсказал мне, что именно нужно для отчета. Python дал концепцию «загрузить все сначала». Я не мог указать версию на Go в первый день, потому что еще не знал, что именно я строю.
Просите о переосмыслении. Попросите о простом переносе, и вы получите хороший перенос. Если вам нужен другой дизайн, говорите об этом до того, как будет написана хоть одна строка.
Сразу просите о скучных вещах. Структурированное логирование, журнал аудита для удалений, двойное подтверждение перед удалением чего-либо. Пиши я это вручную в 23:00, я бы пропустил каждую из них. Именно благодаря им я готов направить процедуру удаления на реальное хранилище данных.
Попробуйте применить это к отчету, который вы переделываете вручную
Благодаря Claude пробовать три языка и выбрасывать два из них стало дешево. Генерация кода никогда не была узким местом. Узким местом была его оценка.
Моим проектом была инвентаризация VMware Nutanix. Вашим является то, что вы каждый месяц переделываете вручную. Пусть Claude напишет первую версию, затем запустите ее на живой инфраструктуре и проверьте хотя бы одно число, которое вы уже знаете, прежде чем доверять остальному.
Далее: доработка стороны Nutanix, урегулирование вопроса с количеством узлов и автономный режим, чтобы снимки состояния ушли в прошлое. Я также создал вспомогательный инструмент, который переносит золотые шаблоны из vCenter в Nutanix без передачи образов через мое соединение WiMAX. Но это уже история для другого поста.