Компании OpenAI и Anthropic недавно опубликовали руководство по миграции для своих новейших моделей, и оба документа содержат необычно откровенное послание для разработчиков: промпты и навыки, которые давали хорошие результаты на предыдущей модели, могут сдерживать новую.
В Anthropic’s guide for Claude Fable 5 отмечается, что навыки, написанные для предыдущих моделей, «часто слишком предписывающие для Claude Fable 5 и могут снизить качество вывода». В guide for GPT-6 Astra от OpenAI настоятельно рекомендуется проводить аудит навыков и таких файлов, как AGENTS.md, поскольку новая модель более чутко реагирует на содержащиеся в них инструкции. Для обоих семейств моделей вывод один: инструкции, настроенные для одной модели, могут стать «бутылочным горлышком» для следующей.
Каждая строка, которую вы даете агенту, существует по одной из двух причин: либо из-за вашей предметной области, либо из-за самой модели. Контент предметной области охватывает факты о ваших системах, границы, установленные бизнесом, и намерения, стоящие за задачей; он остается верным, даже когда модель меняется.
Контент модели — это обходной путь для устранения слабости, поэтому он устаревает, как только исчезает сама слабость. Иногда он даже работает против вас: GPT-6 Astra задает больше уточняющих вопросов, чем предыдущие модели OpenAI, поэтому инструкция, которая когда-то побуждала модель уточнять детали, теперь может затормозить ту, которая и так это делает.
Разница между ними стоит того, чтобы учитывать ее при проектировании. Инструкции обесцениваются, а контекст — растет в цене. Обходной путь теряет ценность, как только исправленная им слабость исчезает, в то время как факт приобретает ценность с каждым новым релизом, потому что более мощная модель извлекает из него больше пользы.
Большинство текущих советов сосредоточено на «гигиене промптов», что означает аудит файлов и удаление обходных путей. Более важная возможность заключается в том, чтобы решить, где должны храниться знания о вашей предметной области, чтобы агенты совершенствовались с каждым релизом модели без необходимости переписывать инструкции. Для медиаконтента ответ конкретен, и это тем более важно, что промпт никогда не был подходящим местом для хранения знаний о медиа.
Агент может открывать ваш код, конфигурации и документацию и рассуждать о них напрямую, потому что в текстовом виде артефакт и знание — это одно и то же.
С медиаконтентом все иначе. Модель компьютерного зрения может посмотреть на изображение и описать, что на нем изображено, но вопросы, которые важны в продакшене, находятся за пределами пикселей. Кто обладает правами? К какой кампании оно относится? Это утвержденный мастер-файл или устаревший дубликат? Где он уже используется?
Эти знания часто хранятся в DAM-системе, к которой агенты не обращаются, в электронной таблице в общей папке или в памяти дизайнера, который уже уволился. Где бы они ни находились, агент не может до них добраться.
Команды компенсируют это единственным доступным им способом: через промпт. «Геройские изображения должны быть шириной 1200 пикселей». «Конвертировать в WebP». «Проверить права на использование перед публикацией». Но если вы примените тест «предметная область или модель» к этим строкам, вы убедитесь, что здесь что-то не так.
Факты — это контент предметной области, но они подаются как контент модели: поддерживаются вручную, заперты в одном промпте, невидимы для любого другого агента и устаревают в тот момент, когда что-то меняется. Долговечное решение — это медиаконтент, который несет в себе собственный контекст.
Чтобы агент мог рассуждать о медиаконтенте перед тем, как совершить действие, актив должен самостоятельно отвечать на четыре типа вопросов.
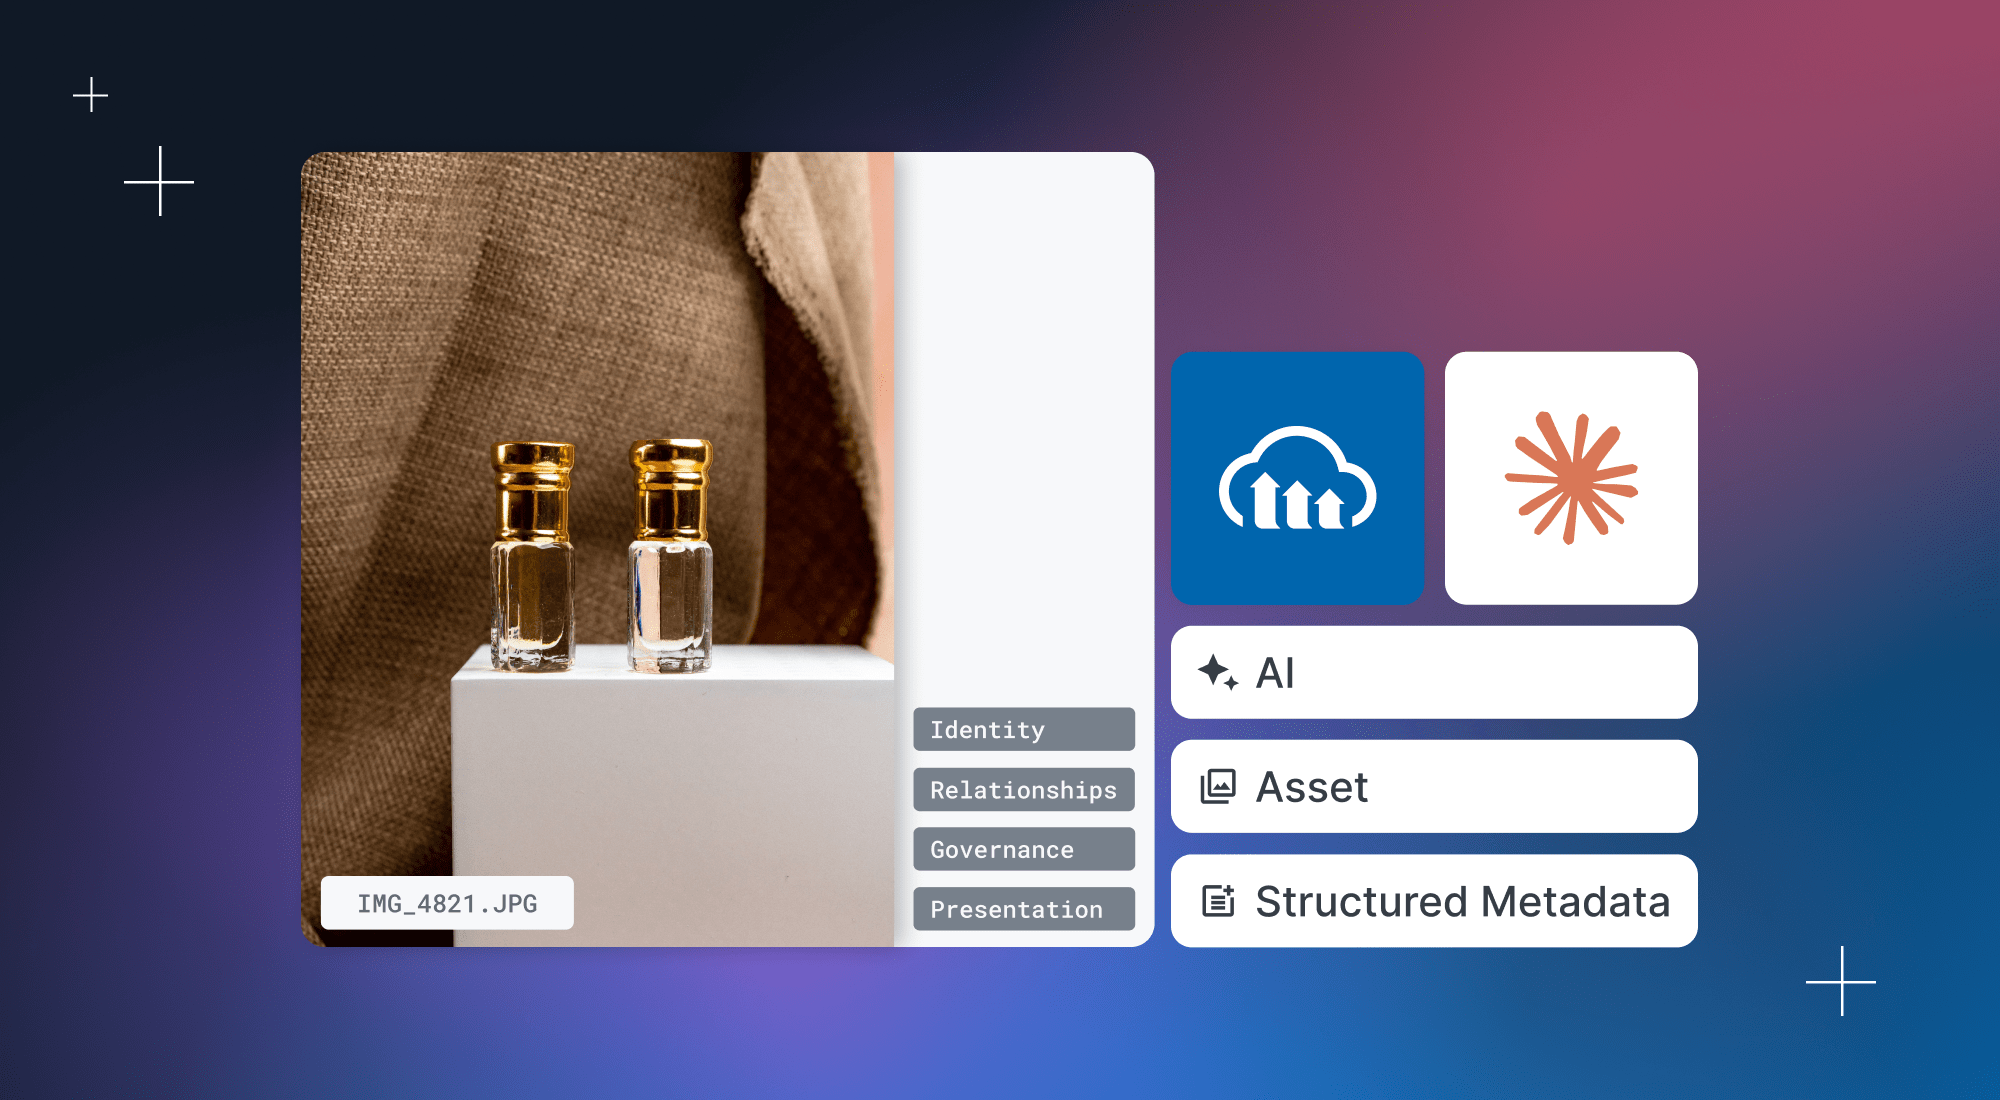
- Идентификация. Что это за актив? Технические факты, такие как формат и размеры, соседствуют с семантическими, включая сгенерированные ИИ теги, подписи и замещающий текст (alt text). Структурированные поля метаданных связывают актив с вашим бизнесом, например, артикул продукта (SKU), кампания и рынок. Происхождение, записанное при загрузке, показывает, откуда взялся актив, включая то, какая модель его создала. С этой информацией агент выбирает правильное изображение, основываясь на том, что актив говорит о самом себе.
Происхождение, записанное при загрузке, показывает, откуда взялся актив, включая то, какая модель его создала. С этой информацией агент выбирает правильное изображение, основываясь на том, что актив говорит о самом себе.
- Связи. С чем связан этот актив? Исходный мастер-файл, производные от него варианты, а также страницы и каналы, которые каждый из них обслуживает, — все это зафиксировано. Когда агент обновляет исходник, он уже знает о зависимых элементах, поэтому изменения корректно применяются ко всем шаблонам.
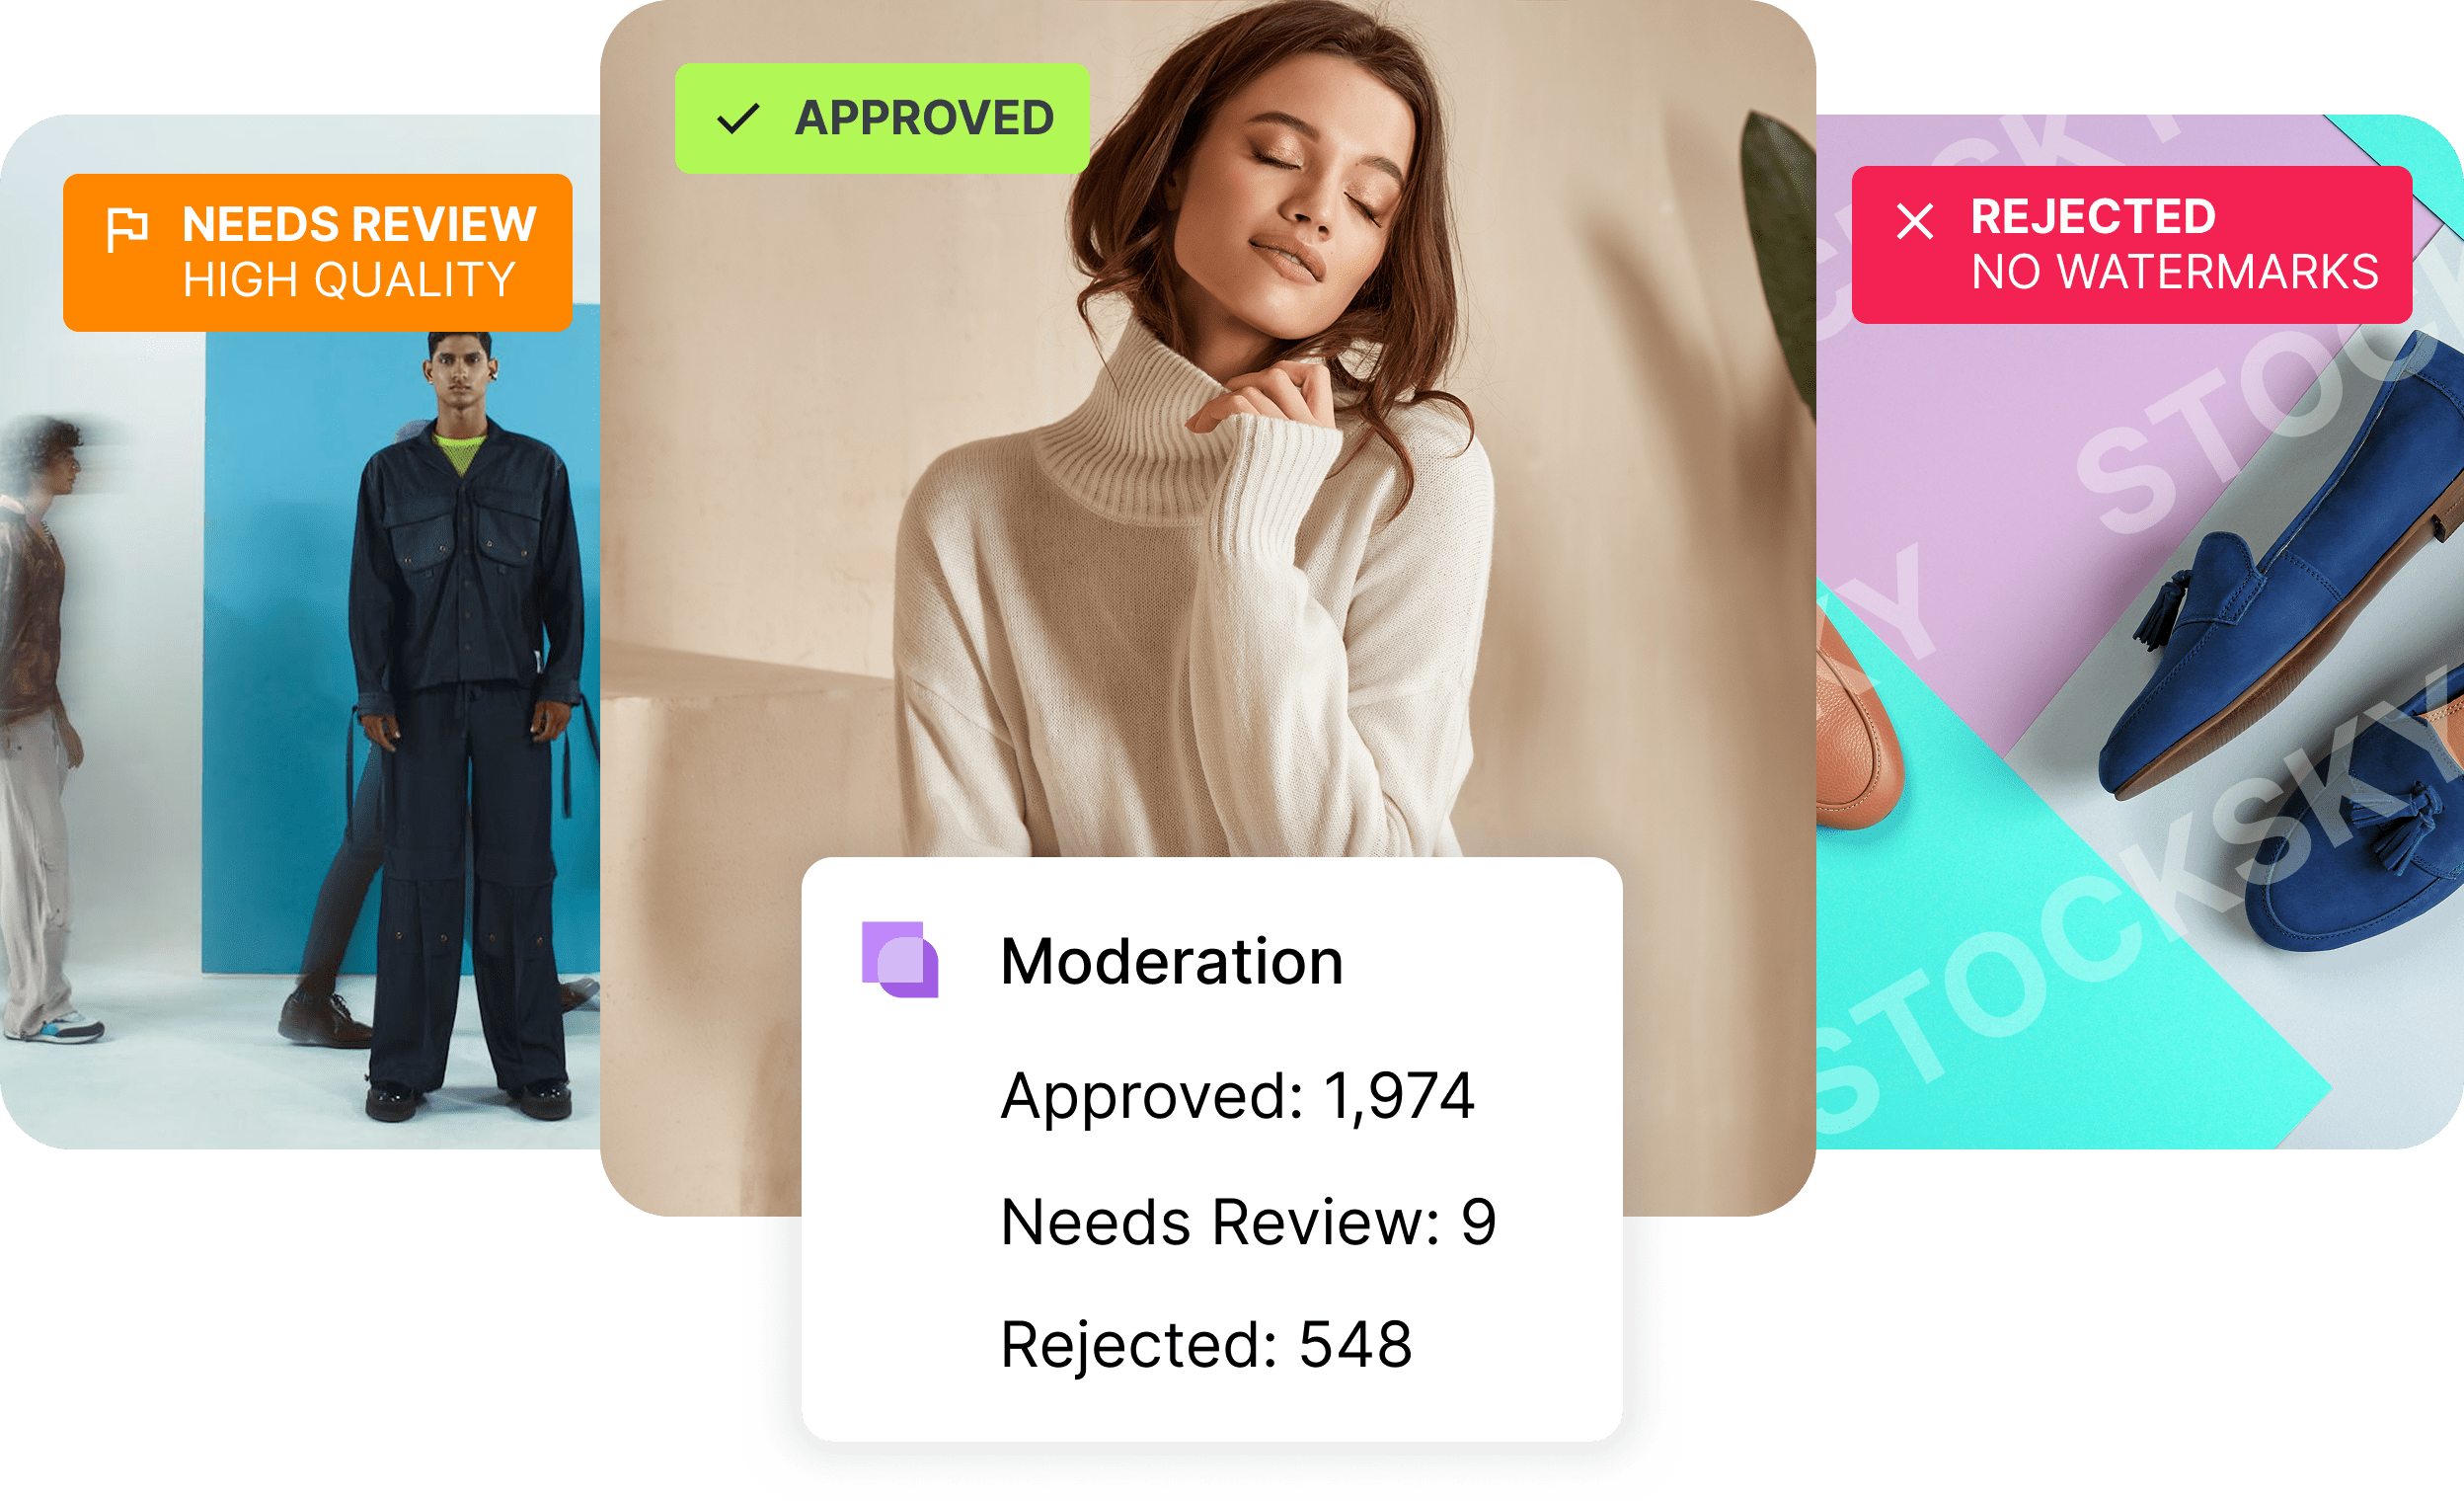
- Управление. Что разрешено? Права на использование, сроки действия лицензий, статус модерации, правила бренда и утвержденные контексты перемещаются вместе с активом в качестве защитных барьеров. Каждый агент наследует их автоматически, поэтому ни один промпт не должен их «помнить».
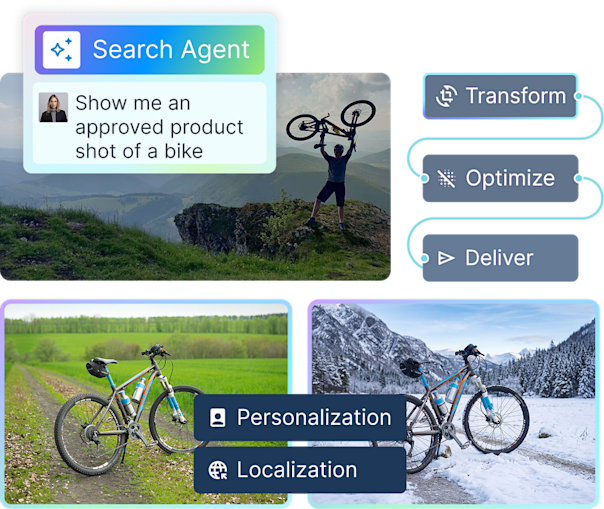
- Представление. Как должен отображаться этот актив? Агент заявляет о своем намерении, например, «геройское изображение для лендинга», «заголовок письма» или «миниатюра продукта», а трансформации определяют правильную обрезку, формат и качество для этого места назначения. Это заменяет промпты типа «изменить размер до 1200 пикселей, конвертировать в WebP», что является именно тем типом инструкций, которые устаревают с каждым поколением моделей. Намерение сохраняет свою ценность от одной модели к другой.
Как только активы несут в себе собственный контекст, возможности агента исходят из медиа-слоя, а не из того, что удалось включить в промпт.
- Поиск медиа по смыслу и правам доступа. Агент ищет утвержденные имиджевые снимки с очищенными правами для конкретного рынка. Когда в качестве брифа выступает эталонное изображение, визуальный поиск находит активы, похожие на него.
- Отправка нужной версии куда угодно. Агент указывает место назначения, и автоматически подбираются правильный размер, формат и качество, включая те направления, которые промпт даже не предусматривал.
- Проверка перед публикацией. Агент считывает срок действия прав, статус модерации и правила бренда, а затем помечает конфликт для проверки человеком.
- Обновление один раз — распространение везде. Замените исходный актив, и связи определят каждый вариант и каждое место, где он используется.
- Превращение сгенерированных файлов в производственные активы. Модель возвращает файл без контекста и с ограниченным сроком жизни. Загруженный как актив, он начинает формировать идентификацию, связи и правила управления с первого дня.
Каждая из этих задач — обычная производственная задача. В среде, богатой контекстом, каждая из них продолжает работать при смене моделей, и никому не нужно поддерживать промпт для ее обеспечения.
Cloudinary рассматривает каждый актив как структурированный медиаобъект. Автоматическое тегирование и создание подписей с помощью ИИ заполняют идентификацию, структурированные метаданные связывают активы с вашим бизнесом, правила модерации и доступа обеспечивают управление, а трансформации управляют представлением на основе заявленного намерения.
Большая часть этого контекста требует минимальных ручных усилий. Обогащение происходит при загрузке: вы загружаете актив, а автотегирование и ИИ-описания самостоятельно описывают его. Модерация запускается автоматически при загрузке с помощью одного параметра. Правила доступа перемещаются вместе с активом, а не живут в коде приложения, а структурированные метаданные превращают бизнес-контекст в поля, которые может запрашивать агент. Стоимость добавления контекста сводится к стоимости загрузки.
Агенты подключаются через официальные серверы Cloudinary MCP и получают контекст, доступный для запросов. Мы применяем тот же тест «предметная область или модель» к нашим собственным инструментам для агентов, сохраняя факты, границы и намерения в файлах, которые читают наши агенты, и отсекая обходные пути модели с каждым новым релизом.
Медиаконтент, созданный таким образом, продолжает совершенствоваться благодаря развитию моделей. С каждым новым релизом более интеллектуальная модель извлекает больше информации из одного и того же объекта. Она обнаруживает конфликт прав, который пропустила предыдущая модель, выбирает более подходящую версию для контекста, который вы даже не указывали, и связывает метаданные кампании с задачей, которую вы не могли предвидеть. Контекстно-ориентированная медиасистема получает каждое обновление автоматически, в то время как система, основанная на промптах, требует переписывания при каждом новом поколении моделей.
В течение многих лет мастерство заключалось в написании лучших инструкций для имеющейся у вас модели. В случае с медиаконтентом мастерство заключается в создании активов, которые объясняют себя сами — для любой модели, которая появится в будущем.