Основные выводы:
- На конференции IBM Quantum Developer Conference 2026 (QDC 2026) была представлена волна новых инструментов Qiskit для разработчиков, охватывающих аппаратное обеспечение, исправление ошибок, рабочие нагрузки, приложения и доступ.
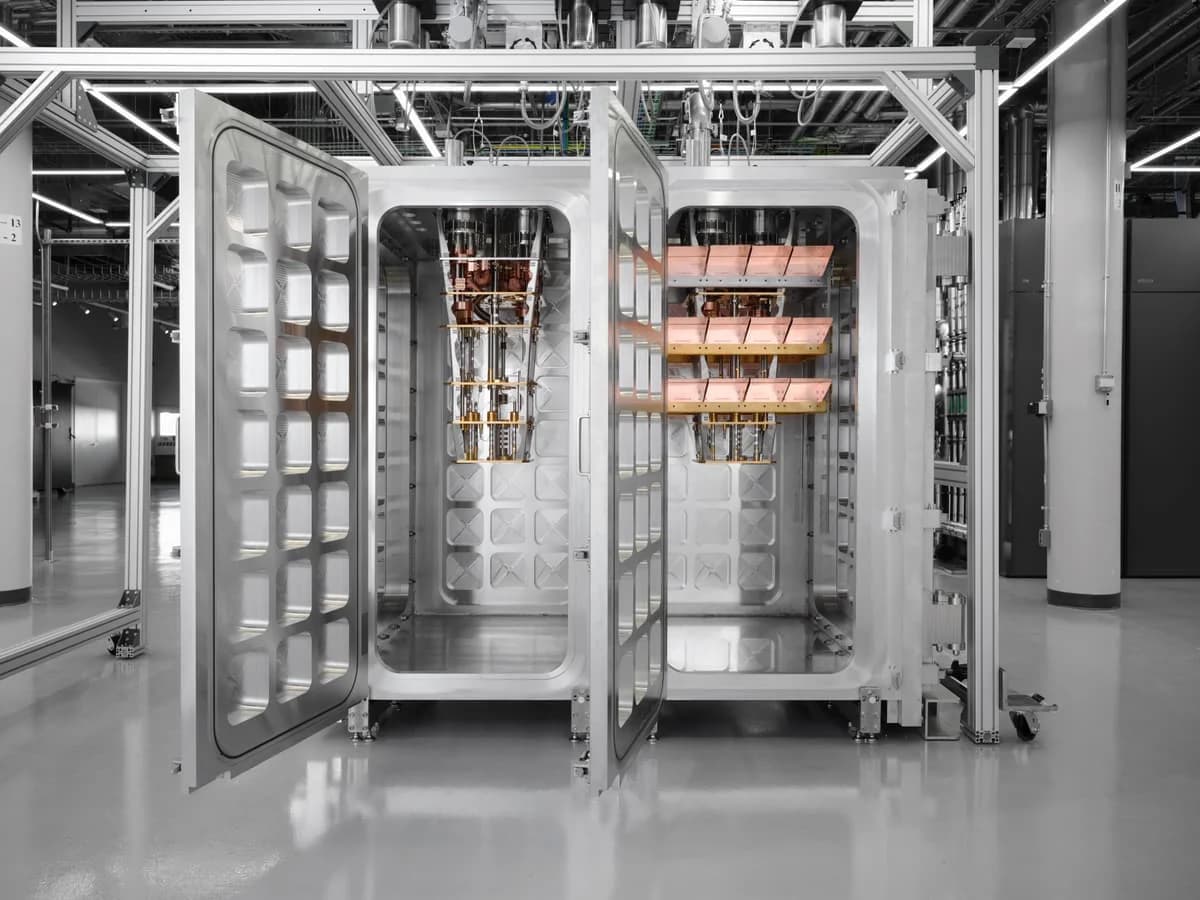
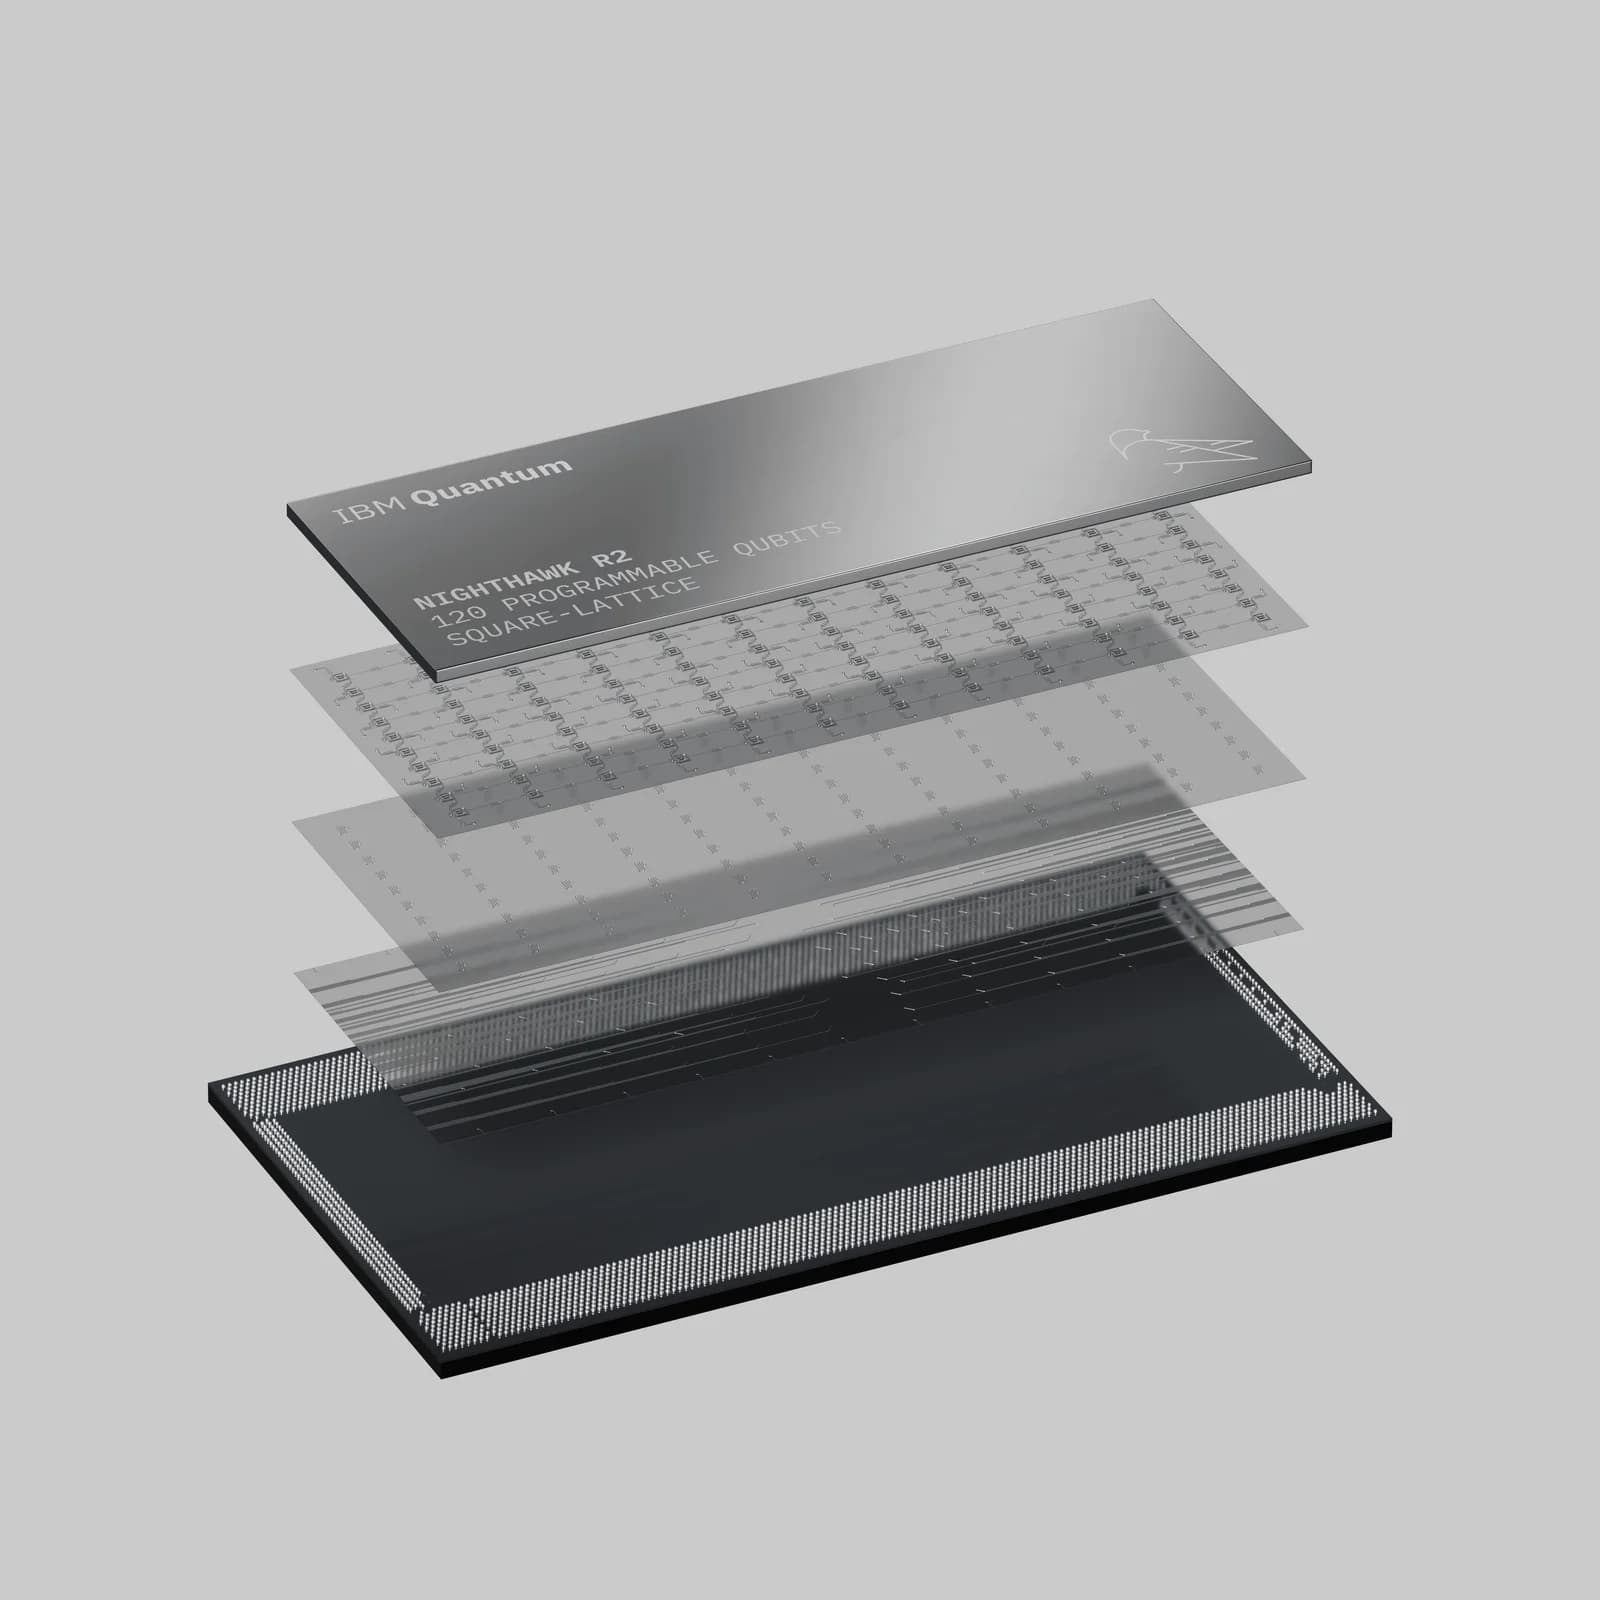
- IBM Quantum Nighthawk r2, самый быстрый процессор на сегодняшний день, предоставляет разработчикам прямое управление на уровне импульсов для создания, запуска и итеративной разработки передовых квантовых цепей.
- Новые инструменты исправления ошибок позволяют разработчикам уже сегодня создавать приложения на основе отказоустойчивых примитивов — от фреймворков стабилизирующих кодов до долго выполняющихся экспериментов с кодами повторения на реальном оборудовании IBM Quantum.
- Модель направленного выполнения и новые управляемые рабочие процессы на платформе IBM Quantum Platform дают разработчикам больше контроля при масштабировании квантовых и высокопроизводительных классических вычислений.
- Расширенный набор прикладных инструментов связывает реальные задачи в области химии, материаловедения и оптимизации с квантовыми цепями, превращая подтвержденное квантовое превосходство в практические рабочие процессы.
- Каждый релиз сопровождается документацией IBM Quantum, руководствами и готовым к запуску кодом Qiskit, а также новыми навыками для ИИ-агентов и расширенным бесплатным доступом для начала разработки.
Квантовое превосходство все больше становится вопросом удобства разработки, а не только исследовательским вехом. Этот переход был наглядно продемонстрирован на конференции IBM Quantum Developer Conference 2026 (QDC 2026), где были представлены практические инструменты, помогающие разработчикам создавать, тестировать, оптимизировать и масштабировать квантовые рабочие нагрузки уже сегодня.
В ходе мероприятия компания IBM выделила растущее портфолио инструментов на базе Qiskit и созданных силами сообщества, предназначенных для изучения отраслевых приложений, внесения вклада в открытый исходный код, создания готовых к производству рабочих процессов и академических исследований. В этой статье мы познакомим вас с релизами, которые наиболее важны для разработчиков в области аппаратного обеспечения, программного обеспечения, исправления ошибок и доступа, а также покажем, как начать работу с каждым из них.
Высокопроизводительное аппаратное обеспечение для передовых квантовых цепей
Для разработчиков все начинается с аппаратного обеспечения. В этом году значительный скачок в скорости сделал как никогда простым создание, запуск и итеративную разработку передовых квантовых цепей, проверяющих пределы наших возможностей.
IBM Quantum Nighthawk r2 — возможности для разработчиков
Наш самый быстрый процессор (120 программируемых кубитов, до 100 000 выборок в секунду) с прямым доступом на уровне импульсов, который разработчики могут использовать напрямую: измерения в середине цепи, быстрый сброс кубитов, динамические цепи и считывание мягких данных (IQ).
Почему это важно: скорость и контроль в реальном времени делают передовые цепи практически применимыми, а также предоставляют средства для тестирования методов исправления ошибок на реальном оборудовании уже сегодня.
Начало работы: прочитайте блог, посвященный Nighthawk r2, и запустите цепи на платформе IBM Quantum Platform уже сегодня. Посмотрите, на что способен Nighthawk, с помощью нашего руководства по началу эргодичности, которое запускает и анализирует эксперимент с 64 кубитами на процессоре Nighthawk.
Код: скорость — это то, что позволяет исследовать передовые квантовые цепи в масштабе, и вам не нужно верить нам на слово. Все тесты производительности устройств от IBM находятся в открытом доступе, поэтому вы можете самостоятельно измерить максимальное количество цепей в секунду (MCPS) для процессора.
from qiskit_ibm_runtime import QiskitRuntimeService from qiskit_device_benchmarking.mcps.mcps_benchmark import MCPSBenchmark service = QiskitRuntimeService() bench = MCPSBenchmark(service, "ibm_nighthawk") # ваше имя бэкенда print(bench.mcps()) # например: {'mcps': ..., 'num_circuits': 1000, 'shots': 1000, 'total_time_seconds': ...}
Для более практического тестирования зеркальный бенчмарк запускает цепь масштаба полезности и проверяет ее точность — это часть полностью открытого пакета бенчмаркинга от IBM (MCPS, CLOPS, EPLG и другие).
Внедрение исследований по исправлению ошибок
Исправление ошибок было одной из важнейших тем на конференции QDC 2026: квантовая команда продемонстрировала расширенный стек исправления ошибок. Сюда вошли новые инструменты, позволяющие разработчикам начать работу с концепциями, рабочими процессами и абстракциями, которые лягут в основу будущих систем с исправлением ошибок.
Эти инструменты являются частью интегрированного пакета, охватывающего весь стек. Наряду с фреймворками исправления ошибок, такими как Qiskit Paulice, вы найдете модульные инструменты снижения погрешностей — qiskit-mitigation и qiskit-noise-learning, о которых рассказано далее в этом посте в разделе «Запуск и масштабирование рабочих нагрузок».
Qiskit Paulice
Фреймворк, поддерживающий вычисления на основе стабилизаторов и рабочие процессы квантового исправления ошибок (коды пространства-времени для цепей Клиффорда).
Почему это важно: позволяет разработчикам и исследователям уже сегодня начать создание решений с использованием примитивов отказоустойчивых квантовых вычислений.
Начало работы: прочтите блог Paulice, изучите документацию или пройдите руководство по кодам пространства-времени на платформе IBM Quantum Platform.
Код: вот основной рабочий процесс — добавление проверок пространства-времени в цепь Клиффорда для повышения точности ее измеренного распределения:
pip install qiskit-paulice from qiskit import QuantumCircuit from qiskit_ibm_runtime import QiskitRuntimeService from qiskit_paulice.layout import get_check_qubits from qiskit_paulice.noise_models import NoiseModel from qiskit_paulice import add_pauli_checks # Ваша цепь Клиффорда (здесь — 12-кубитная кирпичная кладка из запутывающих и однокубитных слоев Клиффорда) # Выберите топологию устройства, затем найдите целевые пары кубитов и кубитов-анцилл из связности устройства backend = QiskitRuntimeService().backend("ibm_boston") layout = [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133] target_qubits, ancilla_qubits = get_check_qubits(backend.coupling_map, layout) # Создайте модель шума деполяризации на основе данных бэкенда для оценки кандидатных проверок noise_model = NoiseModel.from_backend(backend, layout) # Найдите эффективные проверки с малым весом и добавьте их в цепь checked_circuit = add_pauli_checks( circuit, [layout.index(q) for q in target_qubits], noise_model )[-1] # → цепь с 7 проверками, готовая к запуску
Далее в документации Paulice рассказывается о заполнении проверенной цепи, постобработке выборок без ошибок и сравнении точности до и после.
Возможности на уровне импульсов
Исследования в области исправления ошибок требуют детального контроля над тем, что делает аппаратное обеспечение и когда именно это происходит. Платформа IBM Quantum Platform и стек программного обеспечения Qiskit предоставляют этот контроль напрямую, а не скрывают его за «черным ящиком». Основную работу выполняют три группы возможностей:
- Измерения и обратная связь в реальном времени. Динамические цепи позволяют исследователям измерять кубиты в середине цепи и разветвлять выполнение в зависимости от результата в реальном времени (что лежит в основе извлечения синдромов и обратной связи) с помощью инструкций с низкими накладными расходами, таких как MidCircuitMeasure.
- Точное управление таймингом. Вы можете точно задавать момент отправки сигналов для защиты неактивных кубитов от шума, создавая пользовательские последовательности динамического подавления и настраивая тайминг цепей с помощью этапов планирования в компиляторе (транспайлере).
- Пользовательская калибровка. Помимо калибровок IBM по умолчанию, вы можете запршивать инструкции, откалиброванные под конкретную рабочую нагрузку, включая qec_experimental (экспериментальное значение по умолчанию для инструкции for_loop, лежащей в основе эксперимента с кодом повторения из следующего раздела), или запускать свежую калибровку внутри сеанса для противодействия дрейфу параметров во время долгих запусков.
Для команд, исследующих мягкие декодеры, также доступны необработанные данные считывания IQ, полезные для обнаружения утечек и оценки достоверности, путем установки уровня измерений.
Почему это важно: Реальные коды работают только тогда, когда эти возможности взаимодействуют друг с другом на оборудовании, достаточно быстром и мощном для их выполнения. Наличие прямого доступа к ним позволяет исследователям разрабатывать, отлаживать и проводить стресс-тестирование рабочих процессов исправления ошибок на реальных устройствах уже сегодня, а не только в симуляции. (Некоторые из них, например, внутрисеансовая калибровка и qec_experimental, являются экспериментальными и могут измениться.)
С чего начать: Динамические схемы и промежуточные измерения — лучший способ погружения; начните с руководств по кодам повторения или запутыванию на больших расстояниях. Для управления таймингом обратитесь к руководству по планированию; для борьбы с дрейфом во время длительных запусков появился новый раздел руководства по внутрисеансовой калибровке.
Код: Эксперимент с кодом повторения, приведенный ниже, напрямую задействует две из этих возможностей — экспериментальную калибровку qec_experimental и инструкцию MidCircuitMeasure. Чтобы ознакомиться с практическим примером, который также включает пользовательское динамическое развязывание и расширенное планирование, изучите руководство dc-hex-ising.
Код повторения
Теперь мы можем запустить эксперимент с кодом повторения на 1 000 000 раундов от начала до конца на IBM Quantum Platform. Это миллион слоев промежуточных измерений и сбросов в одной схеме. Это стало возможным благодаря инструкции for_loop, которая повторяет блок операций (включая промежуточные измерения) фиксированное количество раз, не разворачивая его в огромную схему.
Почему это важно: Это именно тот тип рабочей нагрузки QEC большой длительности, который вам понадобится, когда логические уровни ошибок станут очень низкими — то есть, когда вычисления с исправлением ошибок будут выполняться миллионы раундов. Возможность выполнить это от начала до конца сегодня позволяет исследователям разрабатывать и проводить стресс-тестирование таких рабочих процессов на реальном оборудовании уже сейчас.
С чего начать: Ознакомьтесь с руководством по пользовательской калибровке для инструкции for_loop и калибровки qec_experimental. Обратите внимание, что обе они являются экспериментальными и могут измениться. В частности, for_loop в настоящее время поддерживается только в заданиях Executor и клиентского Sampler.
Код: Вот структура эксперимента с кодом повторения с использованием for_loop — показано 100 раундов для иллюстрации шаблона. Та же схема масштабируется до миллионного запуска, описанного выше.
from qiskit import QuantumCircuit, QuantumRegister, ClassicalRegister from qiskit import transpile from qiskit.circuit.classical import expr, types from qiskit_ibm_runtime import QiskitRuntimeService from qiskit_ibm_runtime import Executor from qiskit_ibm_runtime.quantum_program import QuantumProgram from qiskit_ibm_runtime.circuit import MidCircuitMeasure service = QiskitRuntimeService() backend = service.backend("<backend_name>", calibration_id="qec_experimental") num_data_qubits = 5 num_rounds = 100 data = QuantumRegister(num_data_qubits, "data") ancilla = QuantumRegister(num_data_qubits - 1, "syndrome") # Holds the current round's measurement results cache = ClassicalRegister(num_data_qubits - 1, "cache") # One register per syndrome qubit, one bit per round checks = [ ClassicalRegister(num_rounds, f"syndrome_{i}") for i in range(num_data_qubits - 1) ] # Final readout of data qubits final_data = ClassicalRegister(data.size, "data") qc = QuantumCircuit(data, ancilla, cache, *checks, final_data) with qc.for_loop(range(num_rounds), expr.Var.new("r", types.Uint(32))) as r: qc.barrier() for i in range(num_data_qubits - 1): qc.cx(data[i], ancilla[i]) for i in range(num_data_qubits - 1): qc.cx(data[i + 1], ancilla[i]) qc.barrier() for i in range(num_data_qubits - 1): qc.append(MidCircuitMeasure(), ancilla[i], cache[i]) # Copy the result into this round's bit qc.store(expr.index(checks[i], r), cache[i]) # Measure data qubits for i in range(num_data_qubits): qc.measure(data[i], final_data[i]) # Layout and transpilation tqc = transpile( qc, backend, initial_layout=[0, 2, 4, 6, 8, 1, 3, 5, 7], optimization_level=0, ) executor = Executor(mode=backend) program = QuantumProgram(shots=10000) program.append_circuit_item(tqc) job = executor.run(program) result = job.result() # Boolean array with shape (shots, num_rounds) syndrome_0 = result[0]["syndrome_0"]
Запуск и масштабирование рабочих нагрузок
По мере усложнения квантовых рабочих нагрузок выполнение и оркестровка становятся не менее важными, чем сами схемы. Релизы этого года дают вам больше контроля над тем, как выполняется рабочая нагрузка — без потери производительности — и больше способов масштабировать ее с использованием квантовых и классических ресурсов. Обновления в использовании и пользовательском интерфейсе IBM Quantum Platform также делают квантовые рабочие нагрузки более управляемыми и понятными, а интерфейс управления квантовыми ресурсами (QRMI) укрепляет интеграцию квантовых вычислений в рабочие процессы высокопроизводительных вычислений.
Оценка рабочей нагрузки и расширение ресурсов платформы
Новые инструменты оценки использования на IBM Quantum Platform предоставляют пользователям большую прозрачность в отношении потребления ресурсов до выполнения, помогая им планировать, оптимизировать и уверенно запускать рабочие нагрузки. Платформа также расширяется для поддержки более широкого спектра возможностей квантовых и классических вычислений, что позволяет создавать более сложные рабочие процессы.
Для поддержки этих улучшений IBM Quantum вводит единицы ресурсов (Resource Units, RU) — унифицированную модель емкости для всех ресурсов платформы. Для стандартных рабочих нагрузок QPU 1 RU равен 1 минуте вычислительного времени QPU, поэтому существующая емкость и цены переносятся напрямую.
Почему это важно: Знайте, какой объем емкости, как ожидается, потребит ваша рабочая нагрузка до выполнения, чтобы вы могли оптимизировать использование ресурсов и проводить эксперименты с уверенностью.
С чего начать: Изучите наши планы доступа и обзор единиц ресурсов, а затем узнайте, как оценить использование перед запуском.
Код: Оцените использование рабочей нагрузки, не расходуя время QPU, выполнив пробный запуск:
service = QiskitRuntimeService() backend = service.backend("<backend_name>") executor = Executor(mode=backend) job = executor.run(program, dry_run=True) result = job.result() # randomized mock data usage = job.usage() # estimated consumption
Используйте оценку, чтобы правильно масштабировать свой эксперимент и проверить его соответствие вашему распределению перед отправкой.
Управляемые рабочие процессы
Пользователи планов Premium и Flex могут развертывать и запускать квантово-классические рабочие процессы на управляемой высокопроизводительной классической инфраструктуре.
- Запускайте свой рабочий процесс на управляемых вычислительных мощностях с большим объемом памяти и ускорением на GPU. Вы можете начать масштабный перебор параметров на своем ноутбуке, а управляемые рабочие процессы завершат и отследят выполнение целиком на IBM Quantum Platform.
- Полностью управляемые среды. Ваш рабочий процесс выполняется безопасно в управляемой среде с новейшими инструментами Qiskit. Вы также можете использовать свои собственные файлы wheel для пользовательских пакетов и сохранять данные в постоянное хранилище для создания контрольных точек между запусками.
- Сквозная наблюдаемость. Просматривайте весь жизненный цикл выполнения и базовые квантовые + классические ресурсы, используемые для каждой рабочей нагрузки, непосредственно в таблице рабочих нагрузок.
- Оплата классических вычислений единицами ресурсов. Вы можете запускать свой рабочий процесс на нескольких профилях классических вычислений и платить поминутно единицами ресурсов.
Почему это важно: Разверните свой квантово-классический рабочий процесс один раз и масштабируйте его с помощью мощных сред классических вычислений, выходящих за рамки вашего ноутбука.
Начало работы: узнайте, как развертывать управляемые рабочие процессы, прочитав документацию на IBM Quantum Platform, или используйте AI-навык для анализа и развертывания вашего собственного рабочего процесса.
Каталог IBM Quantum Functions
IBM Quantum Functions теперь находится в стадии бета-тестирования и включает несколько новых инструментов и улучшений, которые упрощают выполнение реальных задач на IBM Quantum Platform:
- Управляйте ошибками с помощью новых функций схем. Изучите функцию AI-QEM от LTM и функцию Orbit от Quantum Elements — надежные методы настройки и запуска схем в масштабе с минимальными накладными расходами.
- Решайте задачи оптимизации с помощью трех новых прикладных функций. Справляйтесь с оптимизацией при наличии ограничений с помощью Aqarios Constrained Quantum Optimizer, сокращайте глубину и накладные расходы с помощью Parity Twine Optimizer от ParityQC или выходите за рамки отображения 1:1 с помощью SQOASolver от Jij.
- Извлекайте квантовые признаки для конвейеров машинного обучения. Добавляйте извлечение квантовых признаков в существующие рабочие процессы машинного обучения с помощью функции Rimay от Kipu Quantum.
- Моделируйте квантовую динамику многих тел. Моделируйте временную эволюцию с помощью симуляции динамики на базе Q-CTRL. Укажите физическую модель, начальное состояние, параметры временной эволюции и наблюдаемые величины, а затем получите полный временной график ожидаемых значений.
- Платите за рабочую нагрузку с помощью новой гибкой модели биллинга. При запуске используйте функции каталога по модели с оплатой по факту использования без предварительных обязательств, оплачивая каждую рабочую нагрузку с использованием единиц ресурсов в рамках ваших планов Premium и Flex.
Почему это важно: используйте новейшие инструменты исследовательского программного обеспечения из нашей экосистемы для ускорения итераций прикладных исследований, теперь без бюрократических препятствий при закупках.
Начало работы: просмотрите каталог IBM Quantum Functions, чтобы увидеть полный список доступных функций, и добавьте их в свой существующий экземпляр несколькими щелчками мыши на IBM Quantum Platform.
Samplomatic и Executor
Samplomatic создает скрученные (twirled) аннотированные схемы, а Executor запускает их с полным контролем и прозрачностью — без скрытого подавления ошибок. Вместе эти инструменты составляют основу модели направленного выполнения.
Почему это важно: добавляйте компонуемые преобразования, такие как скручивание гейтов и измерений, а затем запускайте результат как единую программу — получайте повторяемые, прозрачные рабочие процессы по мере перехода от разовых демонстраций к более масштабным исследованиям или промышленным инициативам.
Начало работы: ознакомьтесь с документацией по Samplomatic и Executor на IBM Quantum Platform.
Код: следующий пример кода показывает, как упаковать и скрутить схему с помощью Samplomatic, упаковать ее как квантовую программу и запустить с помощью Executor.
from samplomatic.transpiler import generate_boxing_pass_manager from samplomatic import build from qiskit_ibm_runtime import Executor from qiskit_ibm_runtime.quantum_program import QuantumProgram # Создать менеджер проходов упаковки для группировки гейтов # и измерений в блоки и добавления # аннотации `Twirl`. boxes_pm = generate_boxing_pass_manager( enable_gates=True, # Добавить скручивание гейтов enable_measures=True, # Добавить скручивание измерений ) boxed_circuit = boxes_pm.run(isa_circuit) # Построить шаблонную схему и samplex template_circuit, samplex = build(boxed_circuit) # Добавить шаблонную схему и samplex как `samplex_item` program = QuantumProgram(shots=25) program.append_samplex_item( template_circuit, samplex=samplex, shape=(num_randomizations := 20,), ) executor = Executor(mode=backend) job = executor.run(program)
Результатом является скрученное, управляемое аннотациями выполнение, которое можно воспроизвести и масштабировать, не теряя при этом видимости того, что именно было выполнено.
Клиентские Sampler и Estimator
Новые клиентские примитивы Sampler и Estimator выполняют свою предварительную и последующую обработку — включая исправление ошибок — на стороне клиента, делегируя выполнение Executor. Поскольку эта логика находится в вашей среде, а не за «черным ящиком» на стороне сервера, вы можете проверять ее, настраивать или писать собственные методы непосредственно для Executor.
Почему это важно: удобство, когда оно нужно, и контроль, когда он необходим. Прикладные исследователи сохраняют привычный интерфейс примитивов, в то время как любой, кому нужен тонкий контроль, может видеть и настраивать именно то, что происходит перед запуском схемы. Локальное тестирование теперь применяет то же исправление ошибок, которое вы получили бы на оборудовании, поэтому прототипирование действительно отражает реальные запуски.
Начало работы: изучите документацию «Начало работы с Sampler» и «Начало работы с Estimator» на IBM Quantum Platform. Переносите существующий код? Ознакомьтесь с руководством по миграции на клиентские примитивы — или позвольте AI-навыку migrate-qiskit-ibm-runtime сделать это за вас.
Код: чтобы использовать клиентские примитивы, просто импортируйте и запустите их так же, как вы делали бы это с оригиналами.
from qiskit_ibm_runtime.executor_sampler import Sampler from qiskit_ibm_runtime.executor_estimator import Estimator # В qiskit-ibm-runtime 0.52.0 или более поздней версии эти импорты # можно упростить до: # from qiskit_ibm_runtime import Sampler, Estimator # Выборка результатов измерений из схемы sampler = Sampler(mode=backend) job = sampler.run([(isa_circuit, param_values)]) result = job.result() # Или оценка ожидаемых значений для наблюдаемой величины estimator = Estimator(mode=backend) job = estimator.run([(isa_circuit, isa_observable, param_values)]) expectation_values = job.result()[0].data.evs
Тот же интерфейс, больше прозрачности — исправление ошибок, которое раньше было скрыто на стороне сервера, теперь доступно вам для проверки и расширения.
qiskit-mitigation и qiskit-noise-learning
Новые модульные пакеты для исправления ошибок и обучения шуму Паули-Линдблада, включенные в модель направленного выполнения.
Почему это важно: больше никаких фиксированных конвейеров «черного ящика». Составляйте и настраивайте исправление ошибок самостоятельно — например, путем создания моделей шума с последующим отбором (postselected) для уменьшения накладных расходов на выборку PEC.
Начало работы: изучите документацию qiskit-mitigation и qiskit-noise-learning и узнайте, как сократить накладные расходы на выборку PEC с помощью моделей шума с последующим отбором в нашем руководстве по PEC с логическими моделями шума.
Код: полный рабочий процесс сложен, поэтому здесь приведен только ключевой шаг — после изучения модели шума Паули-Линдблада, а затем создания маски с последующим отбором, которая сокращает то, что PEC должен компенсировать. (Это иллюстративный пример, он не является готовым к запуску; в руководстве по PEC есть полная, рабочая версия.)
from qiskit_mitigation.noise import create_postselected_noise_mask # После изучения модели шума Паули-Линдблада с помощью qiskit-noise-learning, # создайте маску с последующим отбором, которая сокращает модель шума, которую должен компенсировать PEC local_scales, gamma2_post = create_postselected_noise_mask(boxed, noise_maps, detectors) # ~16-кратное снижение накладных расходов на выборку PEC в этом примере
Ознакомьтесь с полным руководством по PEC, чтобы увидеть весь конвейер — обучение модели шума, создание маски и запуск исправленной схемы от начала до конца с помощью Samplomatic и Executor.
Инструменты профилирования и производительности
Растущий набор инструментов, которые позволяют профилировать, проверять и настраивать эксперимент — до того, как вы выделите время QPU, и после, для отладки. Вы можете охарактеризовать текущие кубиты устройства, визуализировать планирование схемы, оценить использование в рамках вашего бюджета и увидеть точно, когда и в каком порядке выполнялись ваши схемы.
Почему это важно: для получения хороших результатов недостаточно только лишь хорошо спроектированной схемы — дрейф устройств, планирование, шум и время выполнения вашей задачи влияют на качество результата. Эти инструменты выводят такую информацию на экран, чтобы вы могли учесть ее заранее, а не тратить впустую время QPU на выполнение полноценного эксперимента.
Начало работы: узнайте, как оценивать использование QPU, проверять тайминг схем и предварительно оценивать пользу от подавления ошибок перед запуском на «железе», из нашего руководства по инструментам профилирования.
Код: в качестве примера мы визуализируем тайминг запланированной схемы, чтобы обнаружить простаивающие кубиты или проверить условные операции и операции с прямой связью в динамической схеме.
from qiskit_ibm_runtime.visualization import draw_circuit_schedule_timing # Получаем тайминг планировщика из результата задачи, а затем визуализируем его circuit_schedule = job_result[0].metadata["compilation"]["scheduler_timing"] fig = draw_circuit_schedule_timing(circuit_schedule=circuit_schedule, width=1000)
Другие инструменты в этом наборе включают бенчмаркинг качества кубитов (для обнаружения дрейфа калибровки перед выбором компоновки), калибровку в сеансах и интервалы выполнения — draw_chunk_timings(...) — для подтверждения порядка выполнения ваших схем.
Масштабирование рабочих процессов SQD
Квантово-классические рабочие процессы квантовой диагонализации на основе выборок (SQD) эволюционировали от разомкнутых к замкнутым, параллельным и распределенным вычислениям.
Почему это важно: интеграция HPC в этот контур сократила время одного вычисления с примерно трех месяцев до примерно 65 часов (примерно в 33 раза быстрее), что показывает, как целенаправленное выполнение масштабирует рабочий процесс, а не только отдельную схему.
Начало работы: ознакомьтесь с документацией по Qiskit SQD и узнайте, как оценивать энергию основного состояния молекулы с помощью квантовой диагонализации на основе выборок в нашем учебном пособии по SQD. Чтобы масштабировать этап диагонализации на CPU и GPU, объедините SQD с двумя новыми решателями собственных значений: решателем собственных значений SBD для MPI-параллельной диагонализации в выбранном базисе и Qiskit Fulqrum, обобщенным фреймворком решателя собственных значений в подпространстве. (См. также Qiskit Fermions, о котором рассказывается далее в этой статье и который создает схемы, на которых запускается SQD.)
Интерфейс управления квантовыми ресурсами
Традиционные менеджеры рабочих нагрузок HPC были разработаны для стабильных ресурсов, таких как CPU и GPU. Квантовые системы не укладываются в эти рамки — у них есть циклы калибровки, специфичные для провайдера модели очередей и сеансов, а их доступность меняется таким образом, который планировщики HPC изначально не учитывают.
Интерфейс управления квантовыми ресурсами (QRMI) устраняет этот разрыв. QRMI — это открытый, независимый от поставщика уровень, написанный на Rust с API на Python, который предоставляет средам HPC стандартизированный способ выделения ресурсов, отправки и мониторинга заданий, а также получения результатов на различных квантовых бэкендах, оставляя компиляцию и оптимизацию схем таким фреймворкам, как Qiskit или Pulser.
Почему это важно: администраторы HPC и исследователи получают видимость доступности квантовых систем, выполнения рабочей нагрузки и использования ресурсов с помощью инструментов, которые они уже используют, благодаря чему квантовые этапы вписываются в устоявшиеся рабочие процессы HPC без написания специфичного для поставщика связующего кода. Это более плавный путь к квантово-центричным суперкомпьютерам, позволяющий исследователям сосредоточиться на науке, а не на инфраструктуре.