Extractions API теперь доступен в альфа-версии на OpenRouter. Используйте его для извлечения конкретных данных из текста, изображений и PDF-файлов, описывая нужные вам поля, например, имена в электронном письме или итоговую сумму в чеке.
Мы запускаемся с тремя моделями извлечения от Cloudflare, Inception и ScaleDown. Начните работу, прочитав документацию или попробовав API в Playground.
Извлечение — это запрос, который называет поля, необходимые для получения из документа, и возвращает одно типизированное значение для каждого поля. Параметр state содержит текст (или ключ изображения или PDF-файла в assets), а fields сопоставляет каждое имя со спецификацией: типом и, при необходимости, инструкциями, поясняющими значение поля.
Существует девять типов полей, каждое из которых возвращается в виде типа JSON, который можно хранить без парсинга. Шесть из них были запрошены для этого счета, отправленного в качестве state; примеры в таблице — это то, что вернул Clairic, а выделенные слова — это места, откуда были взяты значения:
state · счет, как текст
Счет INV-4417 от Larkspur Studio, выдан 2026-10-14, условия оплаты нетто 45. Плательщик: Harbor & Pine LLC. Контакты: Dana Ruiz (dana@harborpine.example), Priya Shah. Позиции: аудит бренда 2,400.00; набор иконок 1,150.00; срочный сбор 300.00. Итого к оплате $3,850.00. За просрочку платежа начисляется 1.5% в месяц.
Запрошенными полями были invoice_number: text, total: number, due_date: date, contacts: list, po_number: text и days_to_pay: estimate.
Каждый ответ содержит свое значение; что еще он содержит, зависит от типа поля и модели. В Clairic значение, считанное из текста, сопровождается диапазоном [start, end) в state, отсчитываемым в кодовых точках Unicode, поэтому вы можете выделить фрагмент документа и показать, откуда оно взялось (список содержит диапазоны, по одному на элемент). Одиночные значения содержат p_null — вероятность того, что в документе нет данных для этого поля; значение становится null, когда этот показатель превышает 0.5 (установите null_threshold для каждого поля, чтобы изменить этот порог), при этом guess — это наиболее вероятное значение даже в этом случае. Они также содержат confidence — уверенность модели в значении, а строка, считанная с изображения, добавляет spell_confidence для проверки орфографии. Оценка или прогноз не имеют показателя уверенности; mean, median, p10 и p90 описывают их распределение, а ширина от p10 до p90 — это неопределенность. Extract возвращает уверенность для каждого значения и не возвращает p_null; для текста он также возвращает диапазоны, для PDF — нет (раздел 3).
Эти поля составляют модель доверия. Установите минимальный порог уверенности, отправляйте все, что ниже него, на проверку человеку, а остальное сохраняйте. Null — это ответ, а не низкая оценка: модель считает поле отсутствующим (его p_null превысил порог), а guess показывает, к чему она могла бы прийти. Значение без уверенности, например, оценка, оценивается по его распределению.
На вход подается документ и список именованных типизированных полей. На выходе получается одно значение на поле, диапазон, из которого было считано значение в тексте, уверенность и p_null для одиночных значений, а также распределение для оценки.
Запрос, выполненный на Clairic за $0.00011:
Clairic считал 1138 входных токенов и ответил (ответ без строки модели):
Для due_date в тексте нет даты, поэтому модель вычислила ее на основе даты выдачи и условий; po_number вернулся как null, при этом guess показывает, к чему она могла бы прийти; days_to_pay — это оценка, поэтому она возвращает распределение, а не точку, где 80% массы приходится на период от 42 до 47 дней. Разрежьте state с помощью каждого диапазона, чтобы показать подтверждение рядом со значением. В Python, где r — это ответ на запрос, приведенный выше:
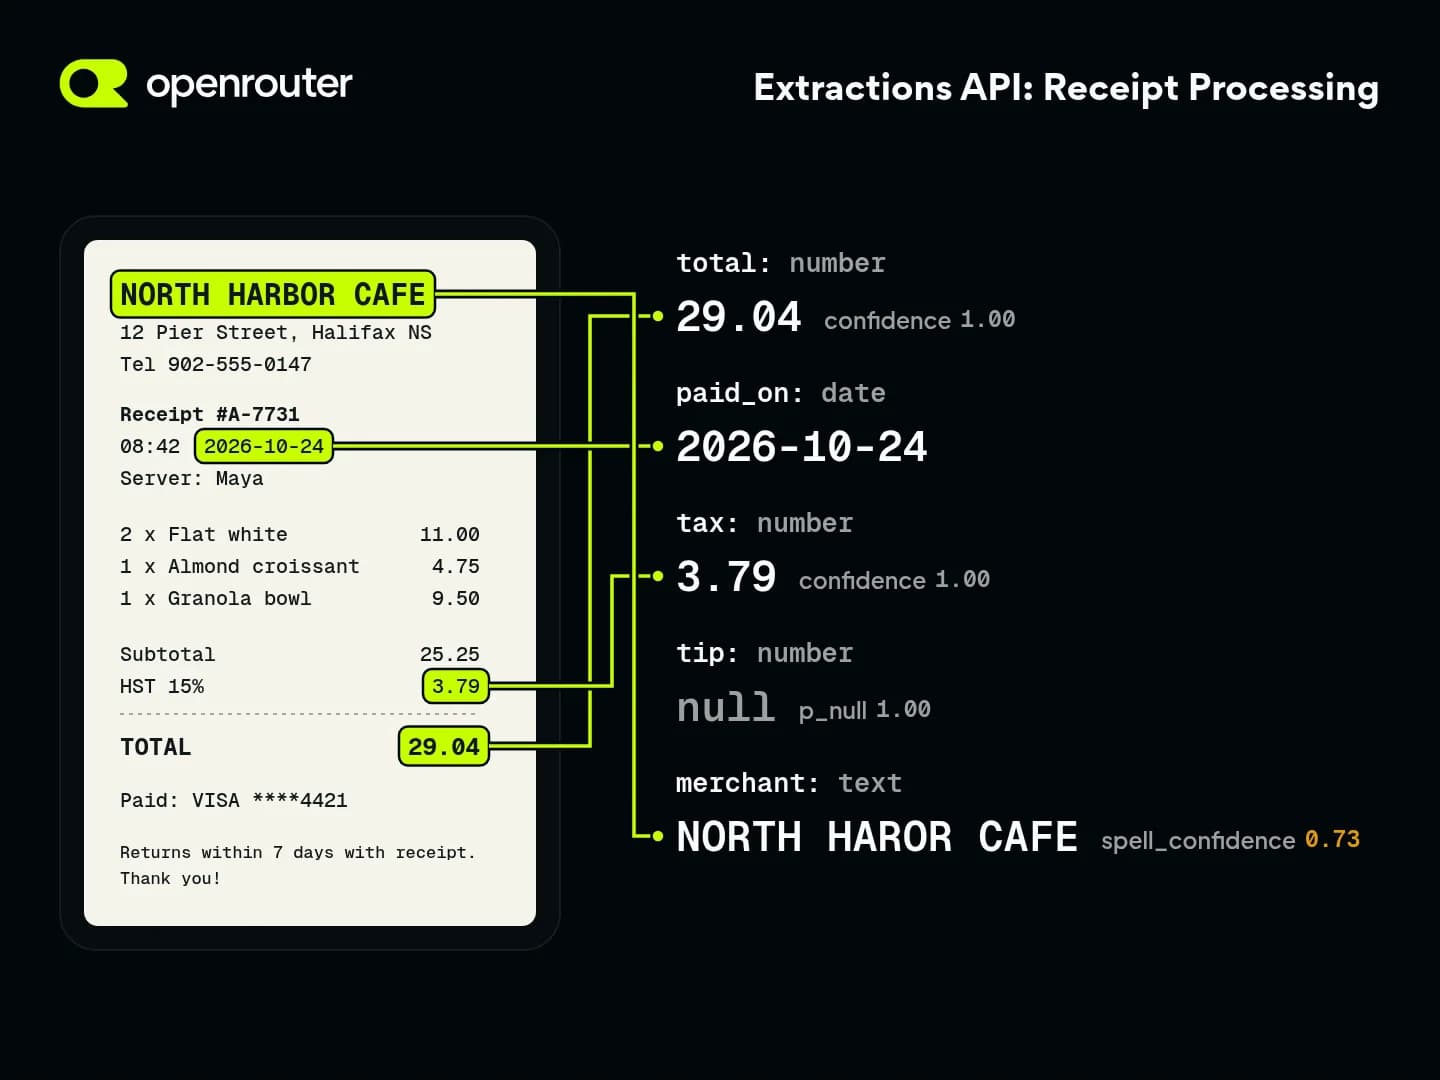
На вход подается изображение в assets, на которое ссылается его ключ из state, плюс такой же список полей. На выходе получается запись той же формы, с source: "image" для значений, которые модель помечает как считанные с картинки (source является необязательным, и в paid_on ниже он отсутствует, поэтому не используйте его как ключ) и spell_confidence для текста. Рамки на фото в клипе нарисованы для демонстрации; API возвращает значения, а не координаты изображения.
Запрос, выполненный на Clairic за $0.00025:
Clairic считал 1064 токена изображения и 2532 всего, и ответил (ответ без строки модели):
Каждое ненулевое числовое поле и поле даты вернулось с уверенностью выше 0.99, а tip — это явный null, а не выдуманный ноль, с p_null на уровне 0.9999. Название продавца неверно (в чеке написано “NORTH HARBOR CAFE”), и Clairic сообщает об этом: spell_confidence составляет 0.73, что на треть ниже всего остального в ответе. Это то самое поле, которое вы направляете человеку, и ответ подсказал вам, какое именно.
PDF-файлы также помещаются в assets с "type": "document" и "format": "pdf". Clairic считывает только изображения, поэтому PDF отправляется в ScaleDown Extract, который считывает один PDF или изображение за запрос и отвечает на текстовые и списковые поля. Рамки на странице в клипе нарисованы для демонстрации; Extract возвращает значения и показатели уверенности, а не координаты страницы.
Запрос, выполненный на Extract за $0.00016:
Extract считал 3972 входных токена из PDF и ответил за 2.9 секунды (ответ без строки модели):
Каждое значение верно, включая три позиции из таблицы. Два отличия от Clairic, которые стоит учесть: у Extract нет типов number или date, поэтому итоговая сумма и дата доставки возвращаются как строки со страницы, и он сообщает уверенность для каждого значения (и для каждого элемента списка), но не p_null или диапазон. Итоговая сумма с показателем 0.81 — это поле, на которое стоит обратить внимание; остальные находятся на уровне 1 или близки к нему.
Список моделей
На запуске доступны три модели, и один и тот же запрос работает со всеми ними, поэтому вы можете выбрать ту, которая подходит для задачи. Используйте Clairic для изображений, например, фото чека, и когда вам нужны числа, даты или оценки. Используйте ScaleDown Extract для извлечения текста из PDF, например, сторон в контракте. Используйте Mercury Decide для извлечения имен или фраз из обычного текста, например, электронных писем или тикетов поддержки.
Вывод бесплатен для всех трех моделей. Цены указаны по каталогу на 6 ноября 2026 года; на страницах моделей указаны актуальные цены.
Clairic от Cloudflare
Clairic (cloudflare/clairic), модель извлечения Cloudflare на Workers AI, — это та модель, с которой стоит начать. Она считывает текст и до четырех изображений PNG или JPEG за запрос, поддерживает все типы полей и является единственной моделью на запуске, которая возвращает p_null, диапазоны и распределения для оценки и прогноза. Разделы 1 и 2 выше были выполнены на ней. Две опции провайдера расширяют ответ: include_quantiles: true возвращает 99 перцентилей для каждой оценки и прогноза, а return_state_text: true возвращает точный текст, на который ссылаются смещения диапазона, чтобы вы могли проверить фрагмент по нему.
Extract (scaledown/extract) считывает текст или один PDF или изображение за запрос и отвечает на текстовые и списковые поля с уверенностью для каждого значения. Это модель для PDF на сегодняшний день (раздел 3). Она не сообщает вероятность null, поэтому отклоняет null_threshold; threshold и top_n в provider.options.scaledown настраивают выбор значений.
Mercury Decide от Inception
Mercury Decide (inception/mercury-decide) считывает только текст и отвечает на текстовые и списковые поля по самой низкой входной цене из трех. Она отклоняет reference_date; snap_to_words, threshold и group_fields в provider.options.inception являются ее опциями.
Текстовые поля работают везде. Мы отправили текстовые поля и поля списков инвойса из раздела 1 в Mercury Decide и Extract: оба вернули те же значения, а для текста — те же фрагменты (spans), что и Clairic, за $0,000015 и $0,000014. Extract не возвращает фрагменты для PDF (раздел 3).
Оба маршрута принимают один и тот же конверт (model, state, assets, provider) и различаются тем, что вы передаете модели и что она возвращает.
Decisions: вы пишете ответы, модель их взвешивает. Запрос Decisions содержит вопросы, и у каждого вопроса есть свое пространство ответов: noul — это одно утверждение, которое истинно или ложно, choice перечисляет варианты, score задает шкалу, box запрашивает область на изображении. Для noul, choice или score модель никогда не выдает значение, которое вы не указали; она распределяет вероятность между написанными вами ответами (box возвращает координаты описанной вами области). Это делает его подходящим инструментом для всего, что требует оценки: является ли это инвойсом, какой из этих пяти терминов применим, насколько это серьезно, содержит ли это изображение чек. Результатом является откалиброванное число, для которого можно установить порог, а неправильный ответ — это один из вариантов, которые вы уже обрабатываете.
Extractions: вы называете поле, модель находит значение. Запрос Extractions содержит поля, и каждое поле имеет имя и тип: text, number, date, list, duration, estimate, forecast. Пространством ответов является тип, а не написанный вами список, поэтому модель должна найти значение в документе (или вычислить его, например, дату оплаты на основе даты выставления и условий, или оценить количество дней до оплаты). Поскольку значение открытое, ответ сопровождается доказательствами: фрагментом (span), из которого оно было считано, p_null для обозначения того, содержит ли документ вообще что-либо для этого поля, и уверенностью (confidence). Это подходящий инструмент, когда ответом является само содержимое: номер на чеке, имена в контракте, дата в форме.
Тот же инвойс, что и в разделе 1, через Decisions на Clef Flash:
В том же инвойсе Decisions отвечает, что условия оплаты — net 45, с уверенностью 0,96, и что инвойс не просрочен. Extractions (раздел 1) возвращает номер инвойса INV-4417, найденный в символах с 8 по 16, и общую сумму 3850.
Как правило, используйте Decisions, когда вы можете перечислить возможные ответы перед отправкой запроса. Используйте Extractions, когда ответом является значение, написанное в документе.
Вы также можете использовать их вместе. Decisions может проверить, является ли документ инвойсом, а Extractions затем извлечет поля из тех документов, которые ими являются.
Оба API принимают почти одинаковые запросы. Разница в том, что Decisions задает вопросы, имеющие набор возможных ответов, таких как «да» или «нет» или выбор между вариантами, в то время как Extractions запрашивает поля, которые заполняются из документа. Чтобы переключить запрос с Decisions на Extractions, переименуйте questions в fields и перепишите каждый из них как поле.
Начало работы
Получите ключ API, откройте Playground на странице модели Clairic и запустите инвойс выше со своими полями, затем прочитайте руководство по Extractions и справочник API. Для выполнения той же задачи в Responses API с использованием ScaleDown Extract см. cookbook.
Расскажите нам, что вы извлекаете, в #feedback в Discord.
Часто задаваемые вопросы
Стабилен ли API?
Это альфа-версия. Структура может измениться, и руководство — это место, где изменения появляются в первую очередь.
Что происходит при неверном запросе?
Валидация происходит на стороне OpenRouter до того, как запрос попадет к провайдеру: неизвестный ключ, поле даты в Mercury Decide, пятое изображение в Clairic, PDF в Clairic или ресурс, на который ничего не ссылается, приведут к ошибке 400, в сообщении которой будет указана проблема. Отправка questions на этот маршрут вернет ошибку 400, которая укажет на /api/alpha/decisions.
Как поле становится null?
В Clairic — когда p_null превышает 0,5. Установите null_threshold для каждого поля, чтобы изменить этот порог, и посмотрите guess для значения, которое модель могла бы предложить. Extract не сообщает p_null, поэтому null от него — это прямой ответ модели, и он отклоняет null_threshold.
Что если в документе даты указаны без года?
Передайте reference_date, и модель привяжет их к этой дате. Модели без типа date отклоняют его: Mercury Decide и Extract.
Что если документ длинный?
truncated: true в ответе означает, что провайдер прочитал только начало (префикс) состояния. usage.passes подсчитывает количество внешних вызовов, которые потребовались вашим полям, когда они не поместились в один запрос, а schema_tokens — это стоимость спецификаций ваших полей в каждом запросе.
Можно ли перенести запрос Decisions?
Конверт тот же; переименуйте questions в fields и перепишите каждую спецификацию, так как выбор (choice) с вариантами — это другой тип запроса, нежели текстовое поле.
Как считаются фрагменты (spans)?
В кодовых точках Unicode, [start, end) в state. В языке, который индексирует строки в единицах UTF-16, делайте срез по кодовым точкам: в JavaScript это Array.from(state).slice(start, end).join(''), а не state.slice(start, end). Параметр return_state_text: true в Clairic возвращает точный текст, на который указывают смещения, чтобы вы могли проверить срез.
Поддерживает ли это Playground?
Да: на странице модели Clairic есть Playground, который принимает state и fields и показывает типизированные ответы.