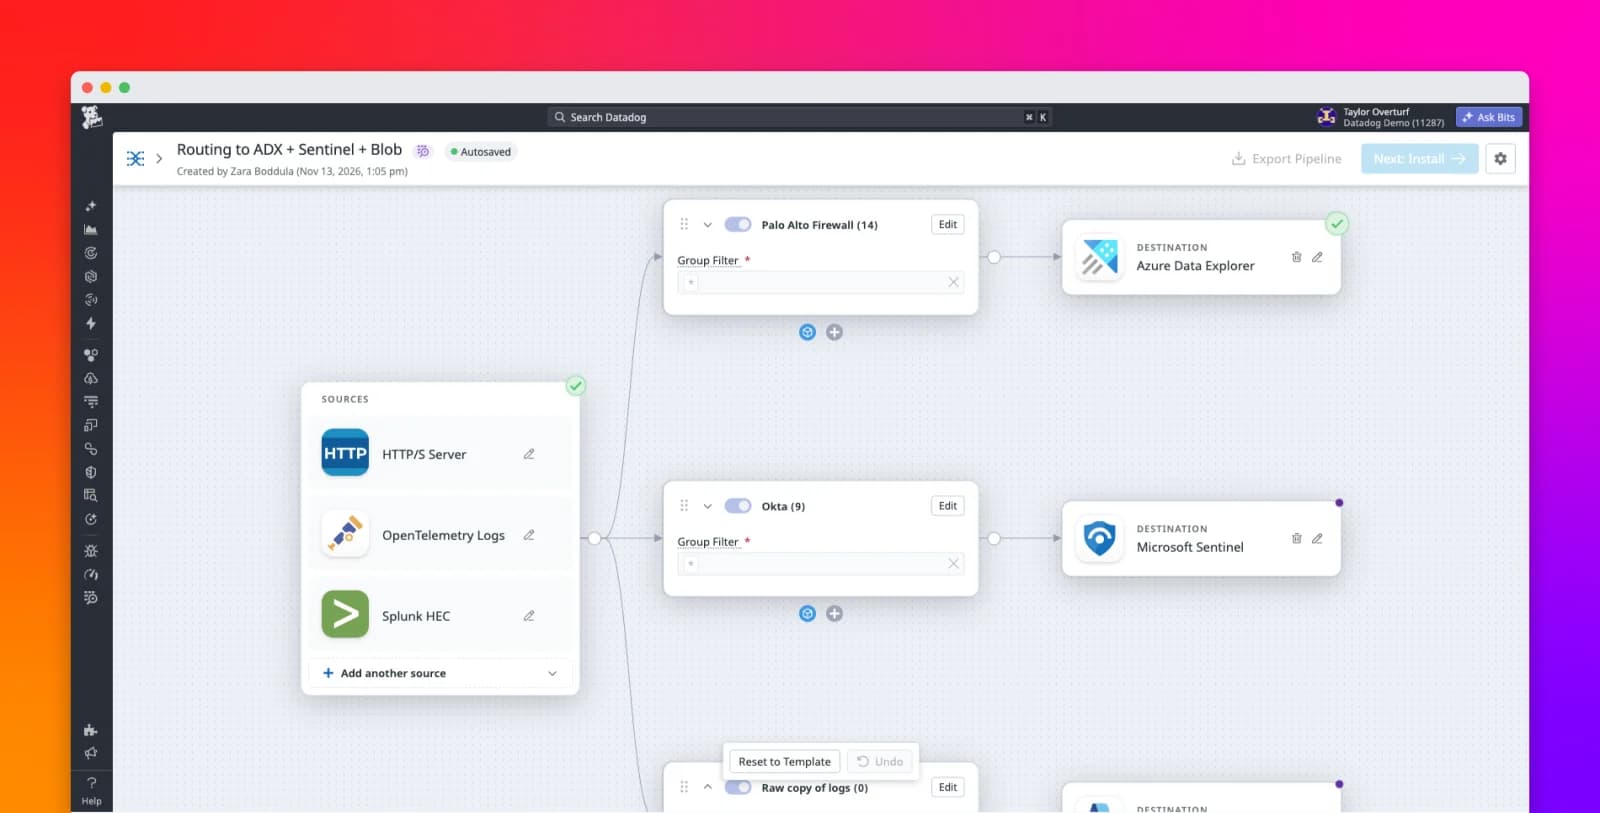
Если ваша организация использует большую часть своей инфраструктуры в Microsoft Azure, ваши команды могут применять Azure Data Explorer (ADX) для исследовательского анализа больших наборов данных. В ADX вы можете писать запросы на Kusto Query Language (KQL) для поиска угроз и объединения логов с бизнес-данными, которые уже хранятся в Azure. Однако полезность ADX напрямую зависит от качества поступающих в него логов. Логи приходят из десятков источников в разных форматах. Вам необходимо анализировать, очищать и сопоставлять логи каждого источника с нужной таблицей, прежде чем вы сможете эффективно выполнять к ним запросы. Эта работа обычно выполняется с помощью пользовательских скриптов приема, которые необходимо поддерживать. «Шумные» или неразобранные логи также могут стоить вам вдвойне: один раз при приеме и хранении, и еще раз каждый раз, когда вы пишете KQL для их очистки. Помимо затрат, нередактированные логи могут раскрыть конфиденциальные данные пользователям, имеющим доступ к таблице ADX.
Datadog Observability Pipelines теперь интегрируется с ADX, поэтому вы можете собирать, обрабатывать и направлять логи в ADX, меньше полагаясь на пользовательские скрипты приема. Благодаря этой интеграции вы централизуете обработку логов в рамках собственной инфраструктуры, редактируете конфиденциальные данные и отправляете в ADX только те логи, которые нужны вашим командам. Чтобы отслеживать, устранять неполадки и получать оповещения по тем же логам в режиме реального времени, добавьте Datadog Log Management в качестве еще одного пункта назначения.
В этой статье мы расскажем, как Observability Pipelines помогает вам:
- Обрабатывать и направлять логи до того, как они попадут в ADX
Обрабатывать и направлять логи до того, как они попадут в ADX
- Добавлять ADX наряду с вашей текущей платформой и сохранять архивы с полной точностью
Добавлять ADX наряду с вашей текущей платформой и сохранять архивы с полной точностью
Обрабатывать и направлять логи до того, как они попадут в ADX
С помощью Observability Pipelines вы можете использовать процессоры для анализа, фильтрации и преобразования логов в вашей собственной инфраструктуре перед отправкой их в ADX. Поля Table и Mapping Reference в пункте назначения ADX поддерживают синтаксис шаблонов, поэтому вы можете направлять логи в разные таблицы на основе установленного вами атрибута. Например, добавьте атрибут adx_table: "network_logs" к логам брандмауэра и adx_table: "identity_logs" к логам аутентификации, а затем установите поле таблицы назначения как {{adx_table}}.
Если вы инженер платформы в крупной компании, предоставляющей финансовые услуги, ваша команда безопасности может захотеть видеть логи брандмауэра Palo Alto Networks и Okta в Microsoft Sentinel для обнаружения угроз. Observability Pipelines может обрабатывать оба типа логов в одном конвейере и направлять каждый из них в свое место назначения. Чтобы удовлетворить потребности вашей команды безопасности, начните с анализа каждого типа логов с помощью процессора Grok Parser, который поддерживает библиотечные и пользовательские правила. Затем добавьте процессор Sensitive Data Scanner для редактирования номеров счетов и процессор Filter для удаления проверок работоспособности. Перед развертыванием конвейера используйте Pipeline Simulation, чтобы убедиться, что логи выходят из процессора Edit Fields с ожидаемым значением adx_table. После развертывания запустите Live Capture на том же процессоре, чтобы проверить отправляемые им логи.
При настройке пункта назначения ADX выберите параметры аутентификации и приема, соответствующие вашей среде Azure. Observability Pipelines поддерживает аутентификацию через Microsoft Entra ID, включая управляемые удостоверения и удостоверения рабочих нагрузок для Azure Kubernetes Service (AKS). Для приема выберите потоковый прием, когда вам нужны логи, доступные для быстрого запроса, или прием через очередь для высокопроизводительных пакетов.
Добавляйте ADX наряду с вашей текущей платформой и сохраняйте архивы с полной точностью
ADX редко является единственным местом назначения для логов. Одни и те же логи часто должны поступать в Datadog для мониторинга в реальном времени, в SIEM, такую как Microsoft Sentinel или Splunk, для обнаружения, и в облачное хранилище для долгосрочного хранения. Добавление ADX в этот список обычно означает перенастройку каждого источника, а затем проверку того, что новая платформа получает нужные логи в правильном формате. Observability Pipelines упрощает эту работу. Вы настраиваете свои источники один раз для отправки логов в Observability Pipelines Worker, а Worker направляет их в каждый пункт назначения.
Допустим, ваша команда безопасности хочет добавить ADX для долгосрочного поиска угроз наряду со Splunk. Вы можете настроить Observability Pipelines для дублирования одних и тех же логов на обе платформы, а затем выполнять запросы к обеим, чтобы убедиться, что ADX получает ожидаемые логи с правильными полями и значениями. Когда ваши потребности изменятся, вы обновите пункты назначения конвейера вместо перенастройки каждого источника. Observability Pipelines также поддерживает Datadog, Microsoft Sentinel, Google SecOps, Azure Storage и другие пункты назначения.
Observability Pipelines предоставляет мониторы и панель управления, которые помогают выявлять проблемы с работоспособностью конвейера во время проверки нового пункта назначения. Во время дублирования вы можете включить готовые мониторы для предлагаемых сценариев использования и настроить их для отслеживания потенциальных проблем. Когда монитор сигнализирует о проблеме, откройте панель управления Observability Pipelines Overview и отфильтруйте данные по конвейеру, Worker или компоненту, чтобы сузить область поиска места возникновения проблемы.
Чтобы сохранить нефильтрованные логи, добавьте еще один набор процессоров и пунктов назначения, которые архивируют их в Azure Storage, в то время как конвейер отправляет отфильтрованное подмножество в ADX. Архив сохраняет логи с полной точностью, доступные для будущих расследований, и вы контролируете, что именно попадает на вашу аналитическую платформу. Если эти логи понадобятся вам позже, вы сможете восстановить их в Datadog.
Начало работы с Datadog Observability Pipelines
Datadog Observability Pipelines помогает отправлять готовые к запросам логи в ADX путем фильтрации логов и редактирования конфиденциальных данных в вашей собственной инфраструктуре до того, как логи покинут вашу среду. Тот же конвейер также поддерживает постепенную миграцию и архивирует логи для будущих расследований.
Чтобы начать работу, настройте пункт назначения ADX в новом или существующем конвейере логов и добавьте процессоры, необходимые вашим командам.
Если вы еще не являетесь клиентом Datadog, зарегистрируйтесь для получения бесплатной 14-дневной пробной версии.