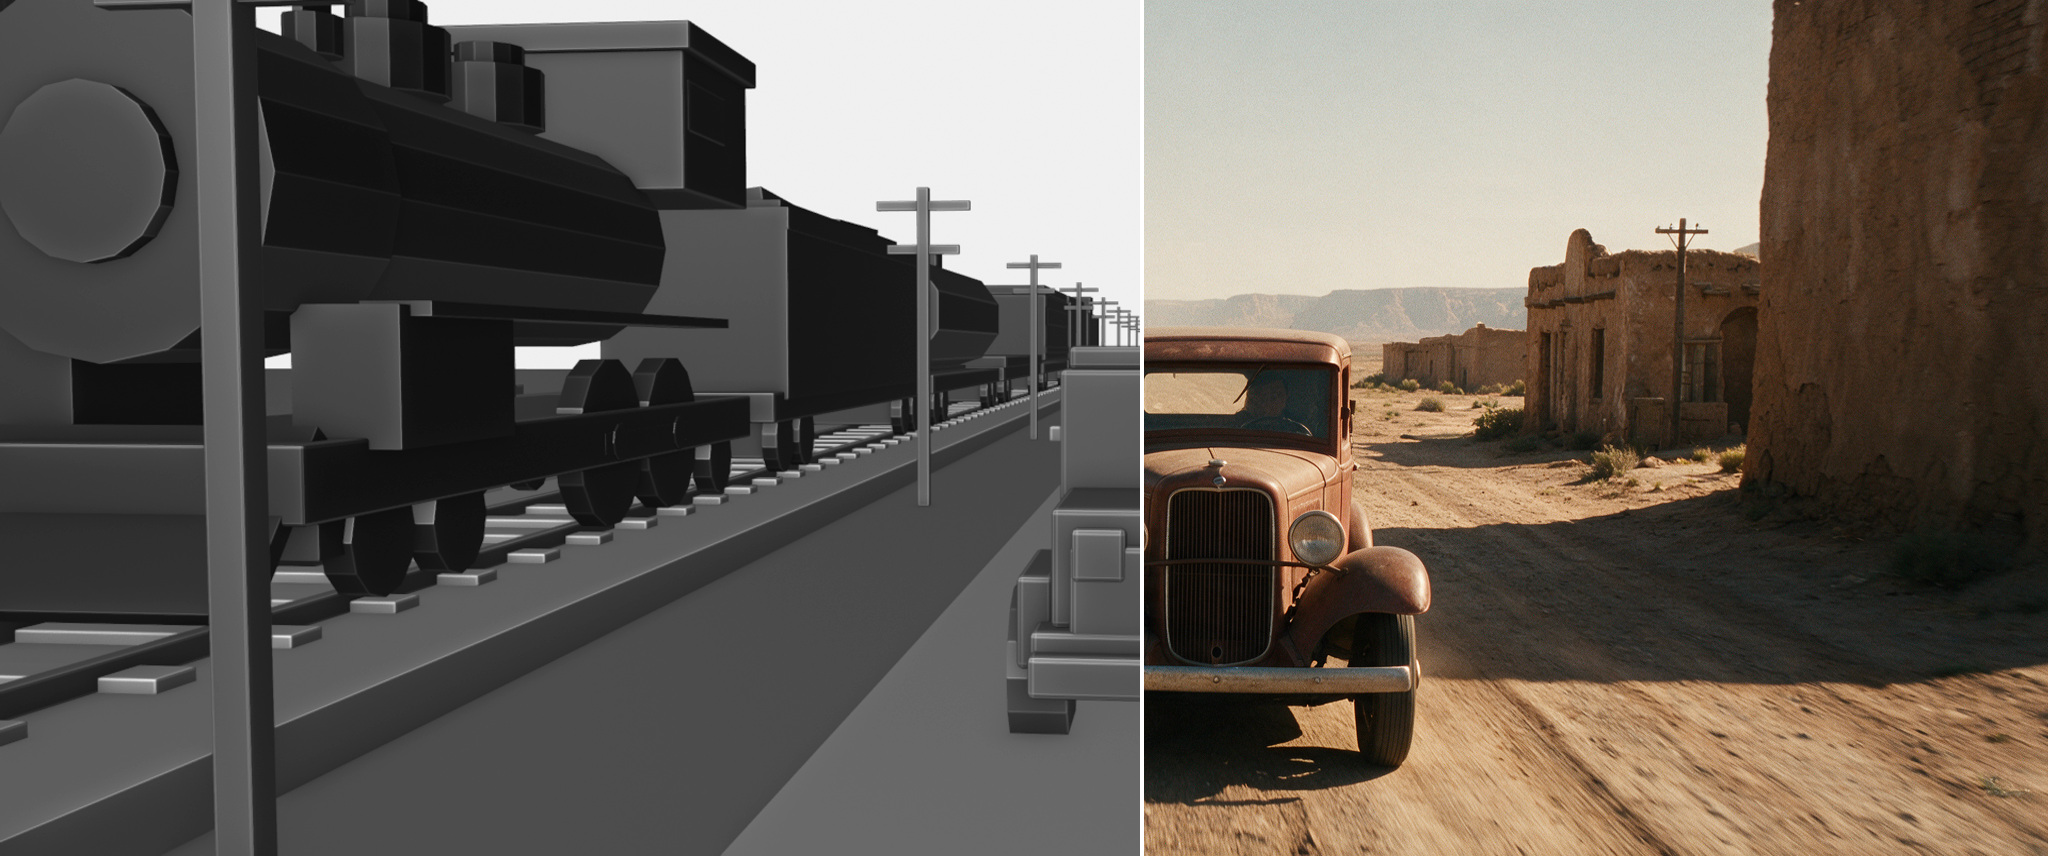
Мы создали короткометражный экшен-фильм — пикап 1930-х годов, мчащийся наперегонки с паровым грузовым поездом через пустынный городок и перепрыгивающий через него, — где всё в точности соответствует тому, что было спроектировано на ранних этапах: действие, анимация, расположение камеры, тайминг, монтажные склейки. В этой статье честно описывается весь конвейер: что сработало, что не удалось и сколько итераций на самом деле потребовалось. Кроме того, это примечания к выпуску нового адаптера 3DREAL Strong v2 с открытым исходным кодом, который отвечает за рендеринг финальных пикселей.
Обновление — 3DREAL Strong v2 выпущен и доступен с открытым исходным кодом. LoRA, которая формирует финальные пиксели этого фильма, теперь получила новый адаптер Strong v2: согласованность между сценами при склейках, синхронизированная генерация звука, гораздо более качественная анимация говорящих персонажей и в целом более четкий результат. Веса (Light, Strong, Strong v2) находятся на Hugging Face, а размещенный эндпоинт render-to-real уже использует их.
10 секунд, 12 кадров, быстрый монтаж — 3D-блокинг под каждым кадром, в черно-белом цвете. Включите звук.
Почему существует этот конвейер
Самые современные видеомодели действительно впечатляют. Image-to-video позволяет получить красивое движение из одного кадра, но вы не можете управлять им точно. Модели reference-to-video идут дальше и становятся очень хорошими, но они остаются дорогими, и даже лучшие из них не дают идеального контроля: точной траектории камеры, точной точки склейки, точной траектории грузовика, летящего над поездом.
Этот проект — не аргумент против таких моделей. Это ответ на конкретную потребность: полный контроль — не только камеры, но и самого действия: что движется, где, когда, как оно кадрировано и смонтировано. С сегодняшними инструментами, большинство из которых открыты.
Идея заключается в разделении работы:
- 3D-блокинг отвечает за геометрию — камеры, движение, тайминг, склейки. Серые кубы, реальная физика, ноль деталей. (Blender, управляемый полностью ИИ через Blender MCP — никакого ручного моделирования.)
- Имидж-модели отвечают за внешний вид — набор проверенных референсных изображений плюс один «ключевой кадр» на каждый план.
- render-to-real отвечает за финальные пиксели — на базе , который мы создали и выложили в открытый доступ на Hugging Face (теперь включая новый адаптер Strong v2): это in-context LoRA, чья специализация — превращение серого 3D-блокинга в фотореалистичный футаж при сохранении точной композиции, движения камеры и компоновки исходника. Размещенный эндпоинт: .
И одно честное предупреждение заранее: это не фокус с одним промптом. Конвейер работает на трех промптах — по одному на каждую фазу — с этапом проверки человеком между ними. Это разделение сделано намеренно: вы проверяете 3D перед генерацией изображений, вы проверяете изображения перед генерацией видео. Каждая фаза требовала итераций; первые результаты часто были ошибочными, и это часть метода, а не его провал.
3DREAL LoRA на Hugging Face — адаптеры Light, Strong и новый Strong v2.
Шаг 0 — Думайте о воссоздании во время создания
Вы все еще создаете настоящий короткометражный фильм — цель состоит в том, чтобы получить готовый, пригодный для просмотра 3D-экшен, а не техническую демонстрацию. Но во время создания вы должны мыслить немного иначе, потому что всё, что вы заблокируете, позже будет воссоздано ИИ:
- Первый кадр каждого плана должен четко показывать каждый ключевой элемент. Видеомодель управляется изображением первого кадра каждого плана. Если машина появляется только на 2-й секунде, ключевой кадр никогда не содержит машину, и модели приходится придумывать её в середине плана — она будет «плыть». Мы столкнулись именно с этим: один план начинался с пустой рампы, и решением было перемещение камеры в 3D-сцене, а не попытки подобрать более сложный промпт.
- Одна понятная идея камеры на план. Чрезмерно сложные или резкие движения могут нарушить стилизацию. Конкретное действие, четкие ракурсы.
- Держите главных героев в кадре в каждом плане. Согласованность между планами достигается за счет того, что модель видит одни и те же элементы снова и снова.
- Физическое движение. Постоянные скорости, правильные параболы для прыжков. Фальшивые, сглаженные дуги выглядят неправильно, когда становятся фотореалистичными.
Если план не соответствует этим правилам, вы можете просто смонтировать его иначе или вырезать позже — но гораздо дешевле подумать об этом на этапе блокинга.
Фаза 1 — Один промпт для всей 3D-сцены
Никто не моделировал, не анимировал и не расставлял камеры вручную. Вся сцена была построена Claude (Fable, в режиме глубокого мышления), подключенным к Blender через Blender MCP — это соединение позволяет модели действительно управлять Blender, а не просто говорить о нем.
Вот промпт для Фазы 1 целиком. Он длинный намеренно: чем больше ограничений вы закодируете здесь, тем меньше сюрпризов будет на последующих этапах. (История с поездом/машиной — это пример; объекты и окружение полностью взаимозаменяемы.)
Результат этой фазы намеренно уродлив, и в этом суть: плоский, однозначный «глиняный» фильм — чистая информация о движении.
Настоящая сессия Blender — вся сцена построена и анимирована через Blender MCP, камеры привязаны к маркерам таймлайна. Глиняный фильм — намеренно уродливый, чистая информация о движении.
Фаза 2 — Один промпт для всех изображений
Контрольная точка: начинайте эту фазу только тогда, когда блочный фильм — это именно то, что вы хотите.
В этой фазе есть два подэтапа, и порядок имеет значение: сначала референсы, затем ключевые кадры.
Почему сначала референсы? Потому что согласованность между 30+ сгенерированными изображениями не приходит случайно — она достигается за счет (а) канонического блока стиля, используемого дословно в каждом промпте, и (б) одних и тех же проверенных референсных изображений, внедряемых в генерацию каждого ключевого кадра.
Какую имидж-модель использовать на fal
Эта фаза по дизайну агностична к модели — любая мощная модель для редактирования нескольких изображений на fal может создать ключевые кадры. Четыре варианта, все протестированы на этом конвейере:
- Nano Banana Pro — edit — стандарт для этого фильма. Лучшее следование инструкциям из группы: она серьезно относится к контракту «изображение 1 — единственный источник истины», и её мульти-изображенческое кондиционирование (глиняный кадр + три референса) идеально подходит для этой задачи. Это также инструмент для хирургического вмешательства — заменить деформированную машину на удачном ключевом кадре, не затрагивая ни одного другого пикселя.
- Seedream 5.0 Pro — edit — самый мощный инструмент для фотореализма, который мы измерили: он продвигает блочную геометрию дальше всего в сторону «фотографии той эпохи». Два практических совета: всегда запрашивайте явный image_size (автоматические пресеты могут перекомпоновать кадр) и описывайте перспективу простыми предложениями — она следует естественному языку лучше, чем числовым координатам.
- GPT Image 2 — edit — отличные знания о мире и логика сцены (соответствующий эпохе реквизит, материалы, вывески); правильный выбор, когда ключевому кадру нужно семантическое обоснование больше, чем строгая геометрия.
- FLUX.2 [klein] 9B — edit — открытые веса и высокая скорость: вариант для объема, когда вы генерируете 20–40 кандидатов на план с надежным сохранением геометрии.
Какую бы модель вы ни выбрали: те же референсы, тот же канонический блок стиля, тот же контроль качества через наложение. Конвейеру не важно, какой кистью вы пользуетесь — ему важно, чтобы вы проверяли результат.
Как на самом деле пишутся промпты для ключевых кадров
Каждый промпт для ключевого кадра в этом проекте собирается из пяти одинаковых ингредиентов в таком порядке:
- Контракт — одна прямолинейная открывающая строка: «Изображение 1 — ЕДИНСТВЕННЫЙ источник истины для геометрии и композиции. Перерисовывайте только поверхности. Не меняйте кадрирование, не центрируйте и не приближайте».
- Роль каждого входного изображения — «Изображения 2–4 — это ТОЛЬКО СТИЛЬ — полностью игнорируйте их композицию». Модели редактирования по умолчанию смешивают входные данные; вам нужно явно это запретить.
- Пространственный обзор изображения 1 — несколько предложений, которые привязывают каждый элемент к кадру: что является огромным и обрезано каким краем, что находится в центре, в каком направлении все движется и что НЕ должно появляться («поезд движется от камеры — никакой передней части локомотива, никаких фар, ничего, что обращено к объективу»). Для экстремальных крупных планов эта часть обязательна: это единственное, что мешает модели вежливо отдаляться. Простой язык лучше координат: «пикап виден прямо сзади, немного левее центра, уносясь вдаль к точке схода».
- Канонический блок стиля, дословно — тот же абзац об эпохе/месте/освещении/кинопленке, вставленный без изменений в каждый промпт проекта. Согласованность между кадрами живет здесь, и больше нигде.
- Пункт самопроверки — «наложено с прозрачностью 50% на изображение 1, никаких двойных краев на дороге, рельсах, зданиях или транспортных средствах». Это заметно улучшает соблюдение условий и в точности отражает то, как результат будет оцениваться впоследствии.
Когда кадр постоянно не получается, решение почти никогда не заключается в «более сложном промпте». Это более точный обзор (ингредиент 3), или референсы, обрезанные точно под соотношение сторон фильма, или — для первого кадра, в котором не показан каждый ключевой элемент — перемещение камеры в Blender.
Чему мы научились на горьком опыте, чтобы вам не пришлось:
- Модели редактирования меняют композицию. Их инстинкт — сделать изображение красивее: отдалить, отцентрировать, приукрасить. Язык блокировки геометрии и процентные соотношения в обзоре — это то, что их останавливает. Потребовалось несколько неудачных попыток, чтобы прийти к результату; инструмент наложения — это то, что сделало каждую неудачу сразу заметной.
- Ловушка с соотношением сторон стоила нам целого цикла генерации: референсы 16:9 незаметно перекрывали кадр в формате 2.39:1. Обрезайте свои референсы.
- Объем — это преимущество. При 20-40 кандидатах на кадр идеальный вариант существует; ваша задача — выбор, а не надежда.
- Проверяйте с помощью наложений, а не «на глаз». Если края двоятся при 50% наложении, значит, перспектива «поплыла» — и видеомодель позже добросовестно анимирует этот дрейф.
Инструмент проверки ключевых кадров — каждый кандидат рядом со своим «глиняным» (черновым) кадром, наложение 50% снизу, оценка выравнивания.
Мы не пишем эти промпты вручную. Мы просим Fable написать их, смотрим на результаты и даем указания («машина должна быть строго фронтально», «не отдаляй»). Итерация — это и есть работа.
Фаза 3 — Один промпт для всех видео
Этап проверки: начинайте только тогда, когда каждый ключевой кадр чисто накладывается на свой «глиняный» кадр.
Почему эта модель: render-to-real специализируется на воспроизведении точного движения рендера, который вы подаете на вход — именно поэтому так важна вся проверка выше. Дайте ей ключевой кадр с ошибкой перспективы, и она красиво анимирует эту ошибку. Дайте ей чистый кадр, и она зафиксируется. И еще раз: этот шаг открыт — модель, которую мы обучили для LTX 2.3, находится на Hugging Face (варианты Light и Strong), и тот же конвейер работает через fal endpoint, используемый здесь.
Как 3DREAL работает «под капотом»
Краткое техническое отступление, так как это та часть, которую мы сделали открытой.
Базовая модель — LTX 2.3, видеодиффузионный трансформер. 3DREAL — это LoRA внутри контекста поверх нее: вместо того чтобы полагаться только на текст, модель получает сам CG-клип как плотный поток условий (движение, макет, камера) плюс один ключевой кадр как якорь внешнего вида. LoRA была обучена на парных последовательностях — 3D/CG-рендеры, выровненные с фотореалистичными кадрами той же композиции — поэтому она изучает именно то отображение, которое нам нужно: перерисовать поверхности, сохранив геометрию. Триггерное слово 3DREAL активирует ее.
Три адаптера балансируют между точностью и силой трансформации:
- Light — мягкое воздействие, максимальная структурная верность, минимум галлюцинаций. Начните с этого.
- Strong — агрессивный фотореалистичный упор для сложных сцен.
- Strong v2 (новый) — переобучен на последовательностях из нескольких кадров и совместном аудио: он сохраняет согласованность при склейках внутри одного клипа, генерирует синхронизированный звук, гораздо лучше справляется с говорящими персонажами (лица, движение губ) и в целом более четкий.
Механика эндпоинта, которую стоит знать (fal-ai/ltx-2.3-quality/render-to-real):
- video_url управляет движением, image_url управляет внешним видом — разделение, которое делает весь конвейер управляемым.
- num_frames должен соответствовать 8k+1 (17, 33, 41, 81, 97…): временной автоэнкодер сжимает время в 8 раз, плюс один опорный кадр. С самого начала нарезайте свои «глиняные» клипы под эти длины.
- Поскольку условия плотные, эндпоинт работает в дистиллированном режиме с низким guidance и малым количеством шагов — video-to-video здесь быстрее, чем text-to-video, а не медленнее.
- intensity выбирает пресет адаптера (рекомендуется strong-v2); enable_detail_refine добавляет проход 2× пространственного апскейла + детализации (мы запускаем его с силой 0.9) — именно так работы в 720p возвращаются в виде 2K.
- generate_audio запрашивает у Strong v2 синхронизированный саундтрек вместе с пикселями.
Прямо из render-to-real — переход через ущелье, внизу «глина». Прямо из render-to-real — фронтальная дуэль, внизу «глина». Четыре сида одного и того же кадра — при наличии объема ваша задача сводится к выбору. Инструмент выбора видео — один вариант на кадр из 132 дублей. Хостируемый эндпоинт на fal — тот же конвейер, никакой настройки.
В этом проекте полный прогон составил 33 проверенных ключевых кадра × 4 сида = 132 видео, сгенерированных без единого сбоя, каждое из которых было скачано сразу после завершения.
Фаза 4 — Монтаж, звук, музыка, цветокоррекция
Последняя фаза — самая классическая. Для каждого кадра выбирается одно видео, и фильм монтируется по порядку — здесь подойдет любой редактор (After Effects, Resolve, что угодно), и, честно говоря, Fable может составить монтаж самостоятельно с помощью ffmpeg, если попросить; именно так был собран этот фильм.
Затем работа со звуком:
- Звуковые эффекты: Mirelo (video-to-audio, эндпоинт mirelo-ai/sfx-v1.5/video-to-audio) генерирует звуки, синхронизированные с финальным видеорядом — текстовый промпт не нужен, само видео является промптом. Специально создано для ИИ-видео, что как раз и представляет собой наш материал.
- Музыка: трек в стиле эпохи, созданный с помощью Suno, наложенный под весь монтаж.
- Цветокоррекция: легкий проход для объединения кадров — поскольку все было сгенерировано из одного блока стиля и по одним и тем же референсам, потребовалось совсем немного.
Вот и весь фильм: спроектирован в серых боксах, закончен со звуком, музыкой и цветокоррекцией.
Готовое вступление — первые три кадра, Mirelo SFX и саундтрек, 3D внизу.
Честное резюме
Что было сделано на самом деле, от начала до конца: полная блочная сцена (построена, анимирована и проверена Fable через Blender MCP — включая собственные защитные механизмы ray-cast), «глиняный» фильм, 3 проверенных ключевых референса, 200+ оцененных кандидатов ключевых кадров, просмотренных с наложениями, 33 проверенных ключевых кадра, 132 видео render-to-real, финальный выбор для каждого кадра и монтаж, проход Mirelo SFX, саундтрек Suno и легкая финальная цветокоррекция.
Ошибки, о которых стоит знать: модели редактирования, перекомпоновывающие крупные планы (исправлено с помощью пространственных обзоров), ловушка соотношения сторон 16:9 (исправлено путем кадрирования ссылок), кадр, в котором на первом снимке не было автомобиля (исправлено в Blender, а не с помощью промптов), периодические отказы API при обработке пакетов с крупным планом (повторная попытка) и классическая ошибка ffmpeg в цикле, которая незаметно повреждала первые кадры трех снимков (-nostdin, всегда). Ни одна из этих ошибок не была обнаружена случайно — каждая из них была выявлена инструментом проверки, который конвейер создает сам для себя.
Честное резюме: это не магия, это метод. Три промпта, четкие контрольные точки, инструменты, делающие ошибки видимыми, и человек, который выбирает лучшие варианты. Контроль реален — и это та часть, которую ни одна современная видеомодель не дает вам сама по себе.