Основные выводы
Оптимизация инференса — это работа по снижению задержки, увеличению пропускной способности и уменьшению стоимости одного токена, когда обученная модель обслуживает реальный трафик. Подходящая методика зависит от того, является ли вашим узким местом префилл, декодирование, память, очередь или сеть.
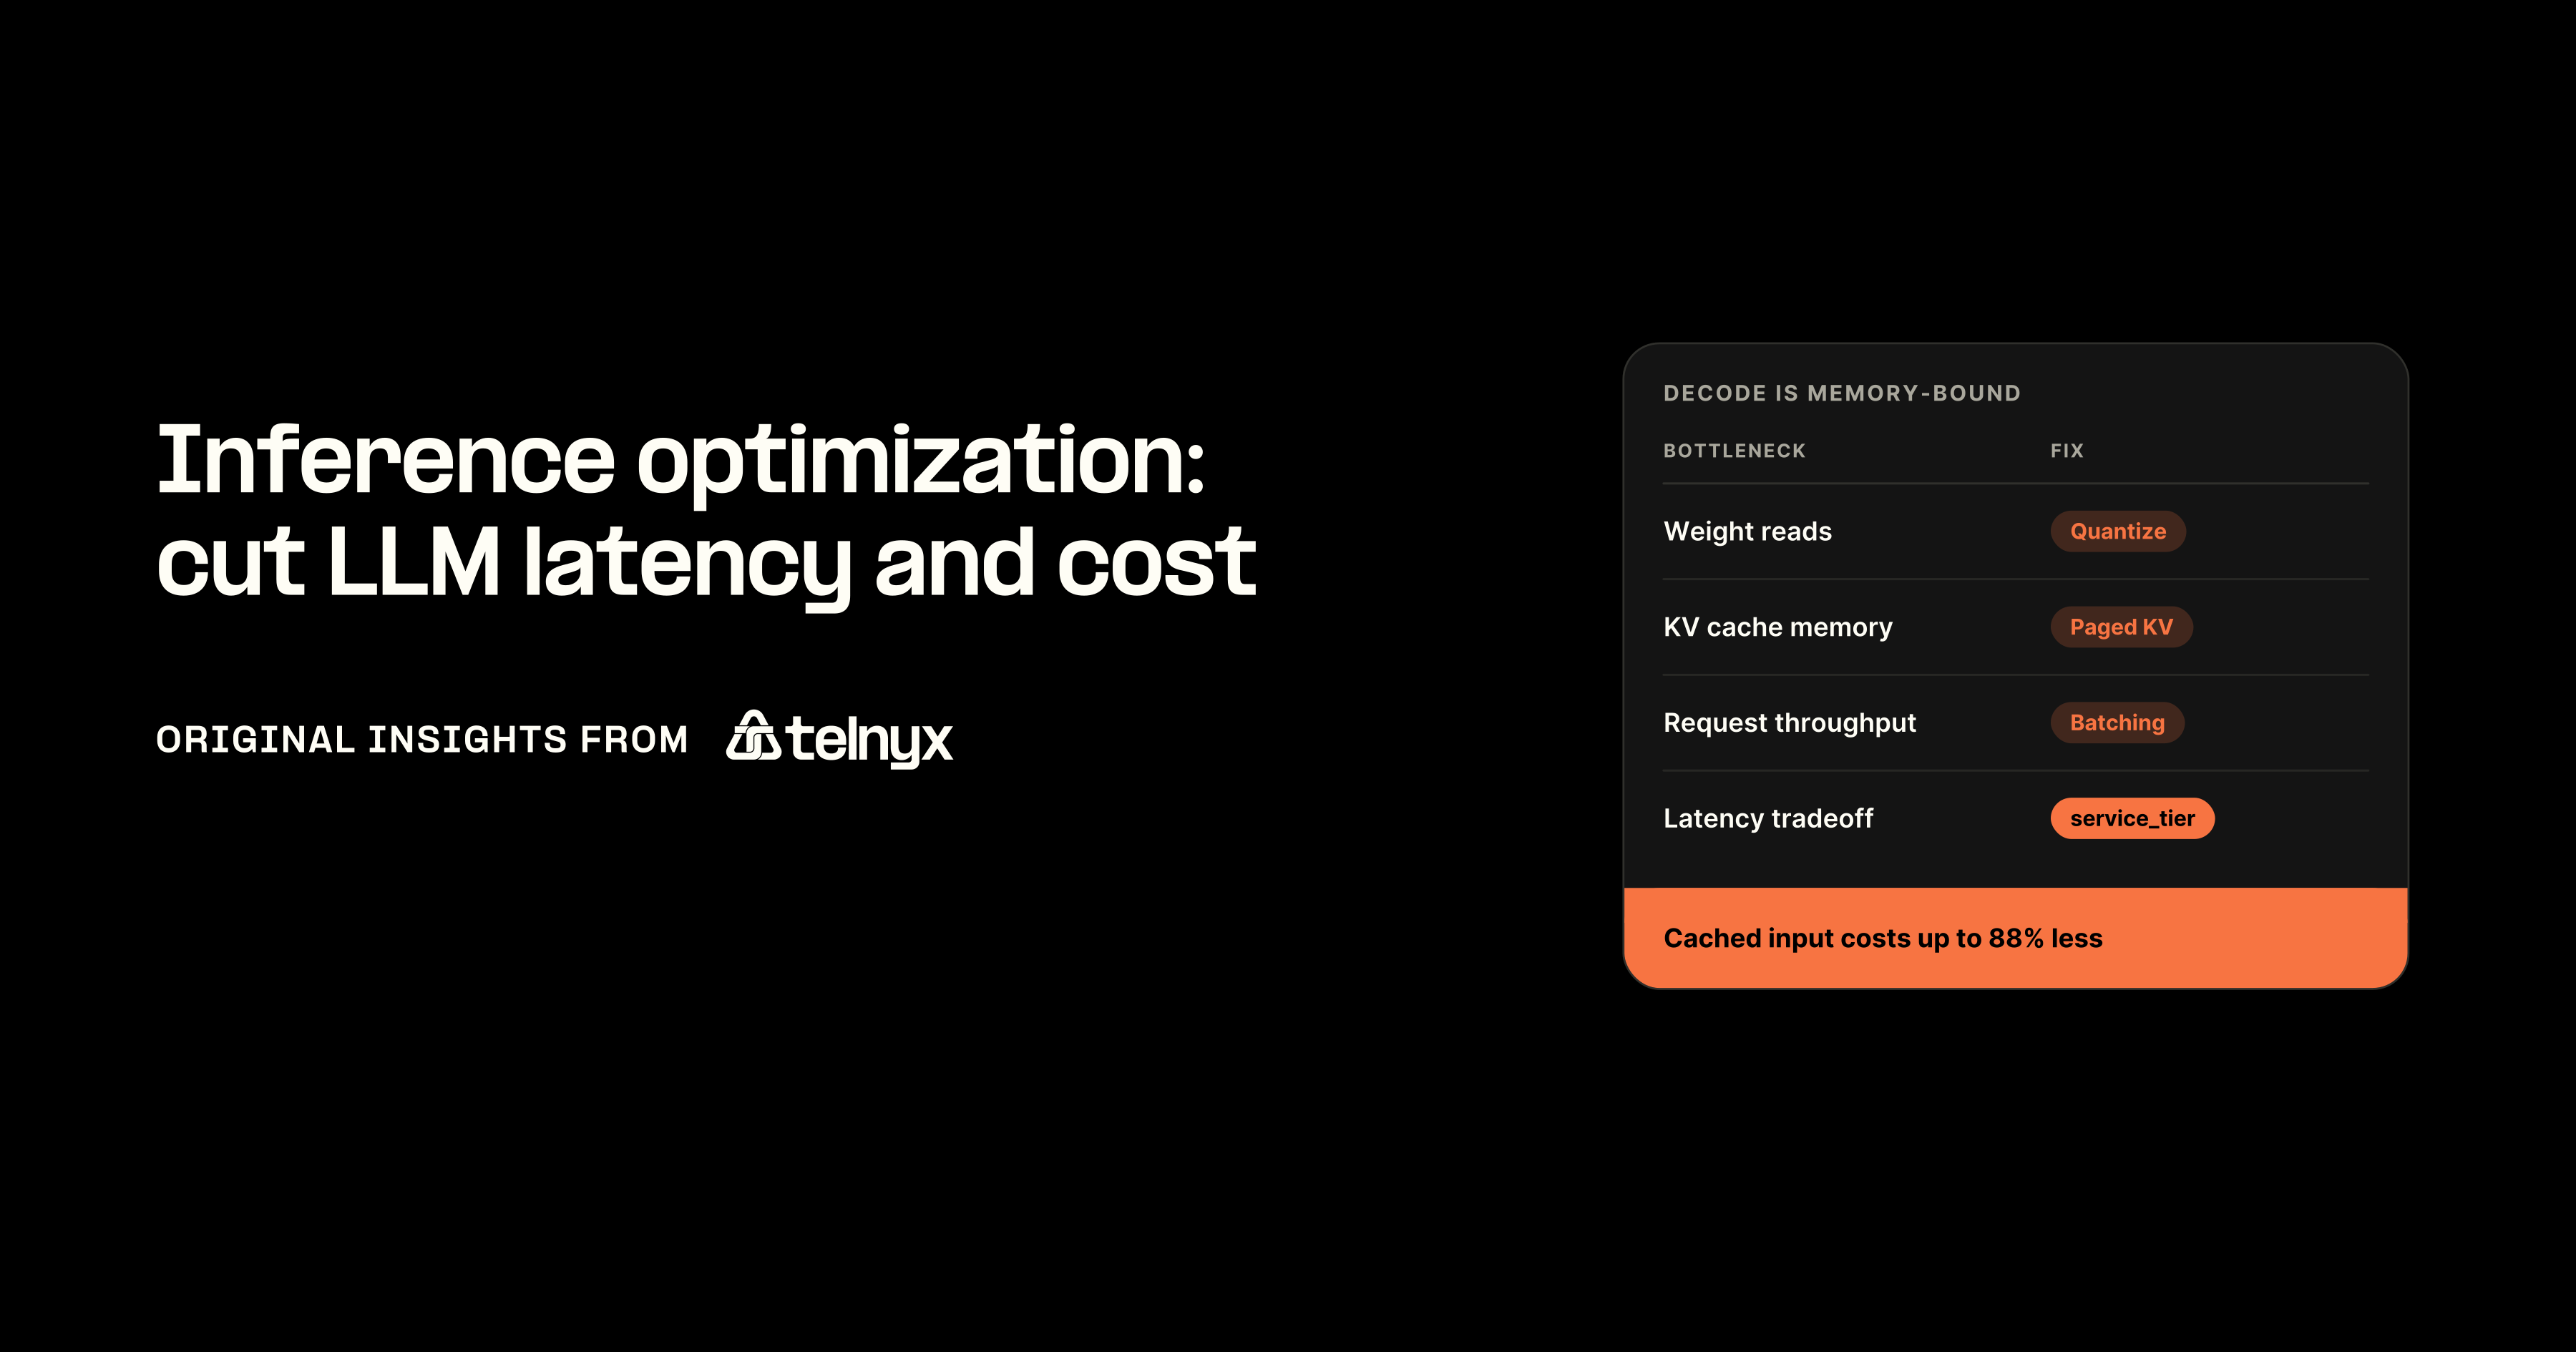
- Декодирование ограничено пропускной способностью памяти, поэтому наибольший прирост дает сокращение перемещаемых байтов: квантованные веса, пейджинговый кэш KV и непрерывный батчинг.
- vLLM и llama.cpp предоставляют эти методы в виде настроек, каждая из которых меняет задержку для конкретного пользователя на пропускную способность.
- В управляемом API инференса с уровнями обслуживания рабочая точка «задержка против пропускной способности» превращается в одно поле запроса (service_tier) на локальных GPU, а кэшированный ввод стоит до 88% дешевле.
Что такое оптимизация инференса и почему она важна?
Оптимизация инференса — это практика улучшения задержки, пропускной способности и стоимости одного токена обученной модели после того, как она начинает обслуживать производственный трафик. Обучение — это разовые затраты, а за инференс вы платите при каждом запросе. Эта работа происходит на трех уровнях: модель (квантование, дистилляция, прунинг), инфраструктура обслуживания (рантайм, батчинг, управление кэшем, размещение) и путь запроса, то есть очередь и сеть между вашим приложением и GPU.
Большинство руководств останавливаются на первых двух уровнях. На третьем уровне модель с отличными бенчмарками все равно выдает тайм-ауты.
Префилл и декодирование: две фазы, два разных узких места
Каждый запрос к большой языковой модели выполняется в две фазы, и оптимизация инференса LLM начинается с понимания того, какую из них вы ждете:
- Префилл: модель обрабатывает весь ваш промпт за один раз как матричную операцию, благодаря чему вычислительные блоки GPU загружены работой.
- Декодирование: модель генерирует по одному токену за шаг, и каждый шаг считывает веса и кэшированные ключи со значениями обратно из памяти GPU.
Это делает декодирование зависимым от памяти. Вычислений на каждом шаге мало, и вы ждете именно перемещения данных. Поэтому более быстрый GPU помогает декодированию меньше, чем сокращение объема перемещаемых байтов. По этой причине почти каждый метод в следующем разделе нацелен на декодирование, и именно поэтому ваши расходы на машинное обучение зависят от пропускной способности памяти сильнее, чем от пиковой производительности.
Метрики, которые нужно записать до внесения любых изменений
Оптимизация инференса ИИ работает только на основе базовых показателей. Сначала запишите эти пять чисел и сравните TTFT с общей задержкой (end-to-end), чтобы понять их практические различия:
- TTFT (время до первого токена): префилл плюс ожидание в очереди. Это первая задержка, которую ощущают ваши пользователи в чате и голосовых сервисах.
- Время на выходной токен: скорость декодирования, ограничена памятью. Определяет скорость стриминга ответа.
- Общая задержка (end-to-end): TTFT плюс каждый выходной токен плюс сеть. Любой запрос с тайм-аутом оценивается по этому параметру.
- Задержка p99: худший 1% запросов. Именно она нарушает SLA и циклы агентских инструментов.
- Стоимость одного токена: стоимость GPU, деленная на пропускную способность. Это число указано в вашем счете за инференс.
Эти метрики противоречат друг другу. Большие батчи увеличивают количество токенов в секунду, но каждый запрос ждет дольше начала своего выполнения, поэтому TTFT растет. Вы выбираете рабочую точку под целевую задержку, и максимальная пропускная способность редко является ею. Следите за p99 и общей задержкой, а не за средними значениями, если хотите снизить задержку инференса, которую замечают пользователи.
Общая задержка — это метрика, за которой стоит следить, потому что модель — лишь одна из точек на пути. Как выразился один из инженеров Telnyx:
«В этой сфере много очень хороших продуктов, и многие команды проделали отличную работу по оптимизации моделей, потоковой передачи, обнаружения реплик и промптов. Но в продакшене задержка часто связана не столько с одной медленной моделью, сколько с конфигурацией архитектуры: где запрос входит в систему, где закрепляется медиапоток, где запускается распознавание речи (STT), где работает LLM, где работает синтез речи (TTS) и сколько границ поставщиков или облака пересекает аудиосигнал по пути». Джеймс Уэдби (James Whedbee), вице-президент по инженерии в Telnyx
Сравнивайте токены в секунду только между моделями, использующими общий токенайзер. Другой токенайзер преобразует один и тот же текст в разное количество токенов, поэтому его токены в секунду являются другой единицей измерения.
Измерьте показатели моделей с открытыми весами перед их тюнингом
Telnyx Inference API обслуживает модели с открытыми весами на локальных GPU за эндпоинтами, совместимыми с OpenAI, что позволяет сначала записать TTFT и p99.
Попробуйте Telnyx Inference
Настройте баланс задержки с помощью одного поля
Выбирайте уровень обслуживания для каждого запроса на локальных GPU и платите на 88% меньше за кэшированные входные токены.
Методы оптимизации инференса LLM, которые меняют показатели
Эффективные методы оптимизации инференса LLM либо сокращают количество байтов, которые должно переместить декодирование, либо уменьшают объем работы, требуемый для каждого токена, но каждый из них снижает точность, объем памяти или задержку.
Какая оптимизация подходит для вашего узкого места?
- Ответы поступают медленно, длинные выводы: квантуйте веса и используйте пейджинговый кэш KV. Каждый шаг декодирования повторно считывает веса из памяти GPU, поэтому меньшие веса ускоряют стриминг токенов.
- TTFT растет при интенсивном трафике: ограничьте размер батча или выберите service_tier с приоритетом задержки. Большие батчи увеличивают количество токенов в секунду, но заставляют каждый запрос ждать дольше.
- Один и тот же длинный системный промпт при каждом вызове: зафиксируйте префикс промпта в Telnyx Inference. Кэшированный ввод стоит до 88% дешевле и позволяет пропускать повторную работу по префиллу.
- Модель показывает быстрые результаты в бенчмарках, но p99 все равно завершается по тайм-ауту: запускайте инференс на локальных GPU с помощью Telnyx Inference. Очереди и границы облака, пересекаемые запросом, а не сама модель, обычно определяют p99 и общую задержку.
- Автономные пакетные задания, никто не ждет: увеличьте размер батча с помощью непрерывного батчинга. При отсутствии целевой задержки максимальная пропускная способность дает наименьшую стоимость токена, так как стоимость представляет собой затраты на GPU, деленные на пропускную способность.
Квантование и кэш KV: математика памяти
Память GPU хранит две вещи, которые определяют объем обслуживаемого трафика: веса и кэш KV. В FP16 каждый параметр занимает 2 байта, поэтому модели с 7 млрд параметров (7B) требуется около 14 ГБ только для весов. Кэш KV хранит ключи и значения для каждого токена в каждом слое, поэтому его размер на один токен составляет: 2 х слои х размер скрытого слоя х байты на значение. Для модели класса Llama 2 7B с 32 слоями и размером скрытого слоя 4096 это составляет около 0,5 МБ на токен, или около 2 ГБ при 4096 токенах и батче 1. Батч 2 удваивает этот показатель, так как кэш растет линейно с размером батча и длиной последовательности.
Каждая проблема имеет свое решение. Квантование уменьшает веса: INT8 или INT4 только для весов сокращает количество байтов, считываемых при декодировании на каждом шаге, в то время как активации сложнее поддаются квантованию из-за выбросов значений. Посттренировочное квантование (PTQ) обходится дешево, а квантование с учетом обучения (QAT) лучше сохраняет точность ценой запуска процесса обучения. FP8, INT4, AWQ и GPTQ — распространенные форматы, и каждый из них требует оценки на ваших собственных промптах перед внедрением. Внимание с группированными запросами (GQA) и пейджинг уменьшают объем кэша, и по этой причине модель Llama 2 70B использует GQA.
PagedAttention и непрерывный батчинг: заполнение памяти GPU
Более старые серверы резервировали один непрерывный слот кэша на запрос его максимальной длины, поэтому слот на 2048 токенов для ответа из 50 токенов расходует практически весь объем впустую. В работе PagedAttention выделяется три вида потерь: зарезервированное пространство, внутренняя фрагментация и внешняя фрагментация. PagedAttention устраняет их, сохраняя кэш в блоках фиксированного размера, которые отслеживаются с помощью таблицы блоков, подобно тому, как операционная система страничный механизм памяти.
Непрерывный батчинг (continuous batching), также называемый батчингом на лету (in-flight batching), расходует эту освободившуюся память. Статический батчинг заставляет каждый запрос ждать самый длинный запрос в своем батче. Непрерывный батчинг исключает завершенные последовательности и принимает новые на каждом шаге, поэтому GPU остается загруженным, а количество токенов в секунду на один GPU растет.
Правило «пропускная способность против задержки»: удвоение батча примерно удваивает количество токенов в секунду на GPU до тех пор, пока не закончится память, но теперь каждый запрос ждет формирования батча, поэтому TTFT (время до первого токена) растет. Установите размер батча исходя из целевого показателя задержки, а затем масштабируйте пропускную способность за счет дополнительных реплик или другого уровня обслуживания.
Спекулятивное декoдирование и префиксное кэширование: уменьшение объема работы на один токен
Спекулятивное декодирование запускает небольшую черновую модель, которая предлагает несколько токенов, а целевая модель проверяет их за один параллельный проход. Когда черновик угадывает правильно, вы получаете несколько токенов по цене одного шага декодирования. Три фактора определяют, окупится ли это:
- Коэффициент принятия: черновик, который целевая модель часто отвергает, добавляет работы вместо ее сокращения.
- Загруженность батча: выгода уменьшается, когда батч уже максимально загружает GPU.
- Запас памяти: черновая модель должна помещаться рядом с целевой моделью и ее кэшем.
Префиксное кэширование пропускает уже выполненную работу. Оно сохраняет KV-кэш для общего системного промпта, схемы инструментов или истории диалога и переиспользует его при следующем запросе, поэтому префилл выполняется только для новых токенов. Для ИИ-агентов в электронной коммерции и других агентов, которые отправляют один и тот же системный промпт и инструменты при каждом вызове, этот повторяющийся префилл составляет большую долю расходов на входные данные.
Тензорный параллелизм и параллелизм конвейера вступают в игру, когда модель не помещается на один GPU. Оба метода разделяют ее между устройствами для снижения требований к памяти на каждое устройство, оба добавляют затраты на межсоединение, а параллелизм конвейера создает простаивающие «пузыри», пока этапы ждут друг друга. Найдите свое «узкое место» в таблице и изучите строку.
Методы оптимизации инференса LLM по узким местам и затратам
Применяйте их по порядку: запишите базовые показатели, квантуйте веса, организуйте кэш по страницам, используйте непрерывный батчинг, а затем выберите уровень обслуживания или добавьте реплики. Каждый шаг изменяет один показатель, который можно сравнить с предыдущим.
Оптимизация инференса vLLM и аналоги в llama.cpp
vLLM и llama.cpp — это два основных движка, которые используют большинство команд, и они применяют эти методы для разных рабочих нагрузок.
Что vLLM предоставляет «из коробки» и что все равно приходится настраивать
vLLM создан на базе PagedAttention и непрерывного батчинга, поэтому первый прирост производительности включен по умолчанию. Он также поддерживает тензорный параллелизм между GPU. Наше руководство по оптимизации инференса в vLLM подробно описывает сам движок.
То, что вам все еще нужно настраивать — это рычаги рабочей точки: доля памяти GPU, выделяемая под KV-кэш, максимальное количество токенов в батче и параллельных последовательностей, формат квантования чекпоинта, префиксное кэширование и спекулятивное декодирование. Каждый из них меняет задержку на пропускную способность. Больший объем памяти кэша позволяет формировать большие батчи, а большие батчи увеличивают TTFT. Точный флаг для каждого параметра находится в документации vLLM, которая соответствует текущему релизу.
Изменяйте то, что вы измерили в первую очередь: выделение большей памяти для KV-кэша одновременно повышает пропускную способность и TTFT. Если ваша проблема — тайм-ауты p99, обратите внимание на очереди и лимиты батчей, прежде чем выполнять квантование.
Где применима llama.cpp: квантованные веса на CPU и небольших GPU
llama.cpp запускает квантованные веса на процессорах, чипах Apple Silicon и одиночных потребительских видеокартах. Оптимизация инференса в llama.cpp сводится в основном к двум решениям: уровню квантования файла весов и количеству слоев, выгружаемых на GPU, а также длине контекста и количеству потоков. Названия параметров указаны в файле README репозитория llama.cpp. Она подходит для инференса на периферии (edge), локальных инструментов и задач с низкой степенью параллелизма, где модель должна помещаться на небольшом устройстве. При прямом сравнении эти два движка разделяются следующим образом:
- vLLM: непрерывный батчинг, блочное распределение PagedAttention, предварительно квантованные чекпоинты и тензорный параллелизм между GPU. Лучше всего подходит для большого числа одновременных пользователей на серверных GPU.
- llama.cpp: одиночные запросы или небольшие батчи, непрерывный кэш, размер которого определяется длиной контекста, уровень квантования, выбираемый для каждого файла весов, и выгрузка слоев на один GPU. Лучше всего подходит для локального использования, периферийных вычислений и работы с низкой конкуренцией.
TensorRT-LLM, SGLang и другие движки делают иной выбор компромиссов, и мы рассматриваем их в сравнении движков инференса.
Когда самостоятельный хостинг перестает окупаться
Самостоятельный хостинг оправдан, пока ваши GPU загружены работой, а у вашей команды есть время поддерживать стек. Три признака сигнализируют о том, что это прекратилось:
- Накладные расходы на обновление: инженеры тратят недели каждый квартал на новые версии движков и новые релизы моделей.
- Простаивающие GPU: ваши карты не используются в периоды между всплесками трафика, но вы все равно платите за них.
- Необъяснимые тайм-ауты: появляются скачки p99, причину которых ваши собственные метрики не могут отследить.
Если два из этих признаков проявляются в течение месяца, сравните ту же модель с открытыми весами за управляемой конечной точкой, совместимой с OpenAI, где автоматическое масштабирование от нуля избавляет вас от проблемы простоя GPU.
Какая платформа лучше всего подходит для оптимизации инференса ИИ?
Лучшая платформа для оптимизации ИИ-инференса позволяет выбирать рабочую точку соотношения задержки и пропускной способности для каждого запроса вместо перенастройки кластера, и именно так создана Telnyx Inference. Она предлагает тщательно отобранную библиотеку моделей с открытыми весами, включая модели от z.ai, DeepSeek и Minimax, в виде бессерверного инференса на GPU, принадлежащих Telnyx, с чатом, совместимым с API OpenAI, поэтому вы просто меняете базовый URL вместо перезаписи кода.
Это стоит на 75% дешевле проприетарных альтернатив, без платы за аренду GPU или минимальных платежей, а также поддерживает структурированный вывод в режиме JSON. Список размещенных моделей отображает актуальный ассортимент.
Управляемый API или собственный стек: правило принятия решений
Выбор сводится к тому, кто должен владеть инфраструктурой инференса, и простое правило решает это:
- Запускайте собственный хостинг, когда вам нужна модель, которую не размещает ни один провайдер, требуются пользовательские ядра или дообученный чекпоинт, который вы не можете загрузить, либо вы поддерживаете стабильную нагрузку, которая обеспечивает высокую загрузку ваших собственных GPU.
- Используйте управляемый API, когда ваш трафик носит всплескoвый характер, нужная вам модель есть в линейке хостинга, требования к резиденции данных обязывают использовать регионовые вычисления, или время вашей команды лучше потратить на продукт.
Выбирайте рабочую точку для каждого запроса с помощью уровня обслуживания
В Telnyx одна и та же размещенная модель и контекстное окно работают на разных мощностях обслуживания, поэтому единственное, что меняется между уровнями — это задержка и цена. Вы выбираете их с помощью поля service_tier в каждом запросе:
- Default: стандартная емкость по стандартным тарифам. Все опубликованные тесты и сравнения цен относятся к этому уровню, и именно его вы получаете, если опускаете параметр service_tier.
- Priority: высокая скорость обслуживания интерактивных рабочих нагрузок с низкой задержкой, включая голосовую оркестрацию для Telnyx Voice AI и ИИ для контакт-центров. Функция уже доступна для отдельных моделей, а в будущем появится поддержка новых моделей и регионов.
- Flex: самые выгодные тарифы для фоновых задач, таких как офлайн-оценка, обработка документов и суммирование, где допустима задержка в несколько минут. Запросы остаются синхронными, а Flex доступен в США для отдельных моделей.
Это превращает компромисс размера батча в поле запроса. Тестируйте интерактивный трафик на Priority и сравнивайте провайдеров на Default, чтобы показатели совпадали с опубликованными бенчмарками. Кэшированный ввод дешевле на величину до 88%, что придает реальную ценность кэшированию префиксов, а наше руководство по оптимизации затрат на инференс показывает, как это складывается вместе с тарифами на инференс в API.
"Мы часто зацикливаемся на скорости инференса LLM, но в голосовом ИИ сеть часто оказывается скрытым убийцей". Иэн Рейтер (Ian Reither), операционный директор Telnyx
Путь запроса — это уровень, который большинство работ по оптимизации обходят стороной. Telnyx Inference работает локально (in-region) в Северной и Южной Америке, Европе, на Ближнем Востоке и в Африке (MENA), а также в Азиатско-Тихоокеанском регионе (APAC), а скоро появится и поддержка LATAM. Ваши данные остаются там же, где ваши пользователи, без сохранения данных и без обучения на них. Между вашим запросом и моделью нет переходов между провайдерами, а сервис автоматически масштабируется от нуля до тысяч запросов в секунду без холодных стартов. Читайте подробнее о запуске графических процессоров в сети.
Отправьте один запрос к Telnyx Inference API
Это совместимый с OpenAI запрос на создание чата (chat completion), отправленный на эндпоинт Telnyx с указанием имени модели и одного сообщения. Чтобы выбрать уровень обслуживания, добавьте поле service_tier в тело запроса.
Shell
curl -i -X POST "https://api.telnyx.com/v2/ai/chat/completions" \ -H "Authorization: Bearer $TELNYX_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "moonshotai/Kimi-K3", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Модель в примере рассматривается в материале о Kimi K3 на Telnyx, а документация по шлюзу ИИ показывает, как перенаправить существующий код OpenAI SDK на тот же эндпоинт. Отсюда вы можете определить свое узкое место и выбрать способ его устранения: настроить все самостоятельно в vLLM или llama.cpp либо изменить одно поле в запросе Telnyx.
Часто задаваемые вопросы об оптимизации инференса
Насколько переход от закрытой рубежной модели (frontier model) к модели с открытыми весами может снизить наши затраты на инференс?
Это зависит от пары моделей и вашего набора токенов, но разница огромна. Telnyx Inference предлагает модели с открытыми весами по цене до 75% ниже проприетарных альтернатив, а кэшированный ввод — со скидкой до 88%. Агенты, которые отправляют один и тот же системный промпт при каждом вызове, получают наибольшую выгоду, поскольку именно этот повторяющийся ввод подпадает под действие кэшированных тарифов.
Почему одна и та же модель с открытыми весами выдает тайм-аут или работает медленнее у одного провайдера, чем у другого?
Веса одинаковы, но стек обслуживания — нет. Провайдеры выбирают разные размеры батча, объем кэш-памяти, форматы квантования и пропускную способность, а запросы проходят через разные сети для достижения графического процессора. Большие батчи одновременно повышают пропускную способность и TTFT (время до первого токена), поэтому провайдер, оптимизированный под пропускную способность, может демонстрировать пики p99, которые фиксируются вашим тайм-аутом. Сравнивайте провайдеров по p99 и сквозной задержке, а не по среднему количеству токенов в секунду.
Достаточно ли хороши модели с открытыми весами, чтобы заменить закрытую модель для производственных ИИ-агентов?
Для многих рабочих нагрузок агентов — да, но протестируйте это на собственном трафике перед переключением. Пропустите свои реальные промпты, вызовы инструментов и форматы вывода через модель с открытыми весами, проверьте точность, соответствие схеме и задержку по сравнению с вашей текущей моделью, а затем переводите трафик поэтапно. Функции структурированного вывода, такие как режим JSON, помогают поддерживать единообразие вызовов инструментов и форматов.
Что такое оптимизация инференса?
Оптимизация инференса — это работа по снижению задержки, увеличению пропускной способности и уменьшению стоимости за токен, когда обученная модель обслуживает рабочий трафик. Она охватывает саму модель (квантование, дистилляцию, прунинг), стек обслуживания (батчинг, управление кэшем, параллелизм) и путь запроса между вашим приложением и графическим процессором. Правильная техника зависит от того, что именно является вашим узким местом.
Стоит ли по-прежнему заниматься оптимизацией инференса или более быстрые графические процессоры сделают ее неактуальной?
Ею по-прежнему стоит заниматься. Процесс декодирования ограничен скоростью перемещения байтов в памяти, а этот показатель растет медленнее, чем вычислительная мощность, поэтому более быстрый графический процессор помогает меньше, чем квантование или пейджинг кэша. Модели и контекстные окна также продолжают расти, что увеличивает потребность в памяти. Кроме того, никакой графический процессор не устраняет задержку в очереди или сетевой переход, поэтому путь запроса по-прежнему требует доработки.
Устраните узкое место с помощью одного поля в запросе
Найдите свое узкое место, а затем настройте все самостоятельно или измените базовый URL и одно поле в запросе Telnyx. Совместимость с OpenAI, локальные графические процессоры, стоимость до 75% ниже по сравнению с проприетарными альтернативами.
Начать создание