Основные выводы
- «Frontier» (передовые) описывает уровень возможностей, а не тип лицензии. Некоторые модели с открытыми весами (open-weight) сейчас находятся на этом уровне или близки к нему, в то время как некоторые закрытые модели значительно отстают.
- Почти ни одна популярная модель не соответствует определению Open Source AI. Большинство моделей, продаваемых как open source, являются моделями с открытыми весами: веса предоставляются, а данные для обучения и код — нет.
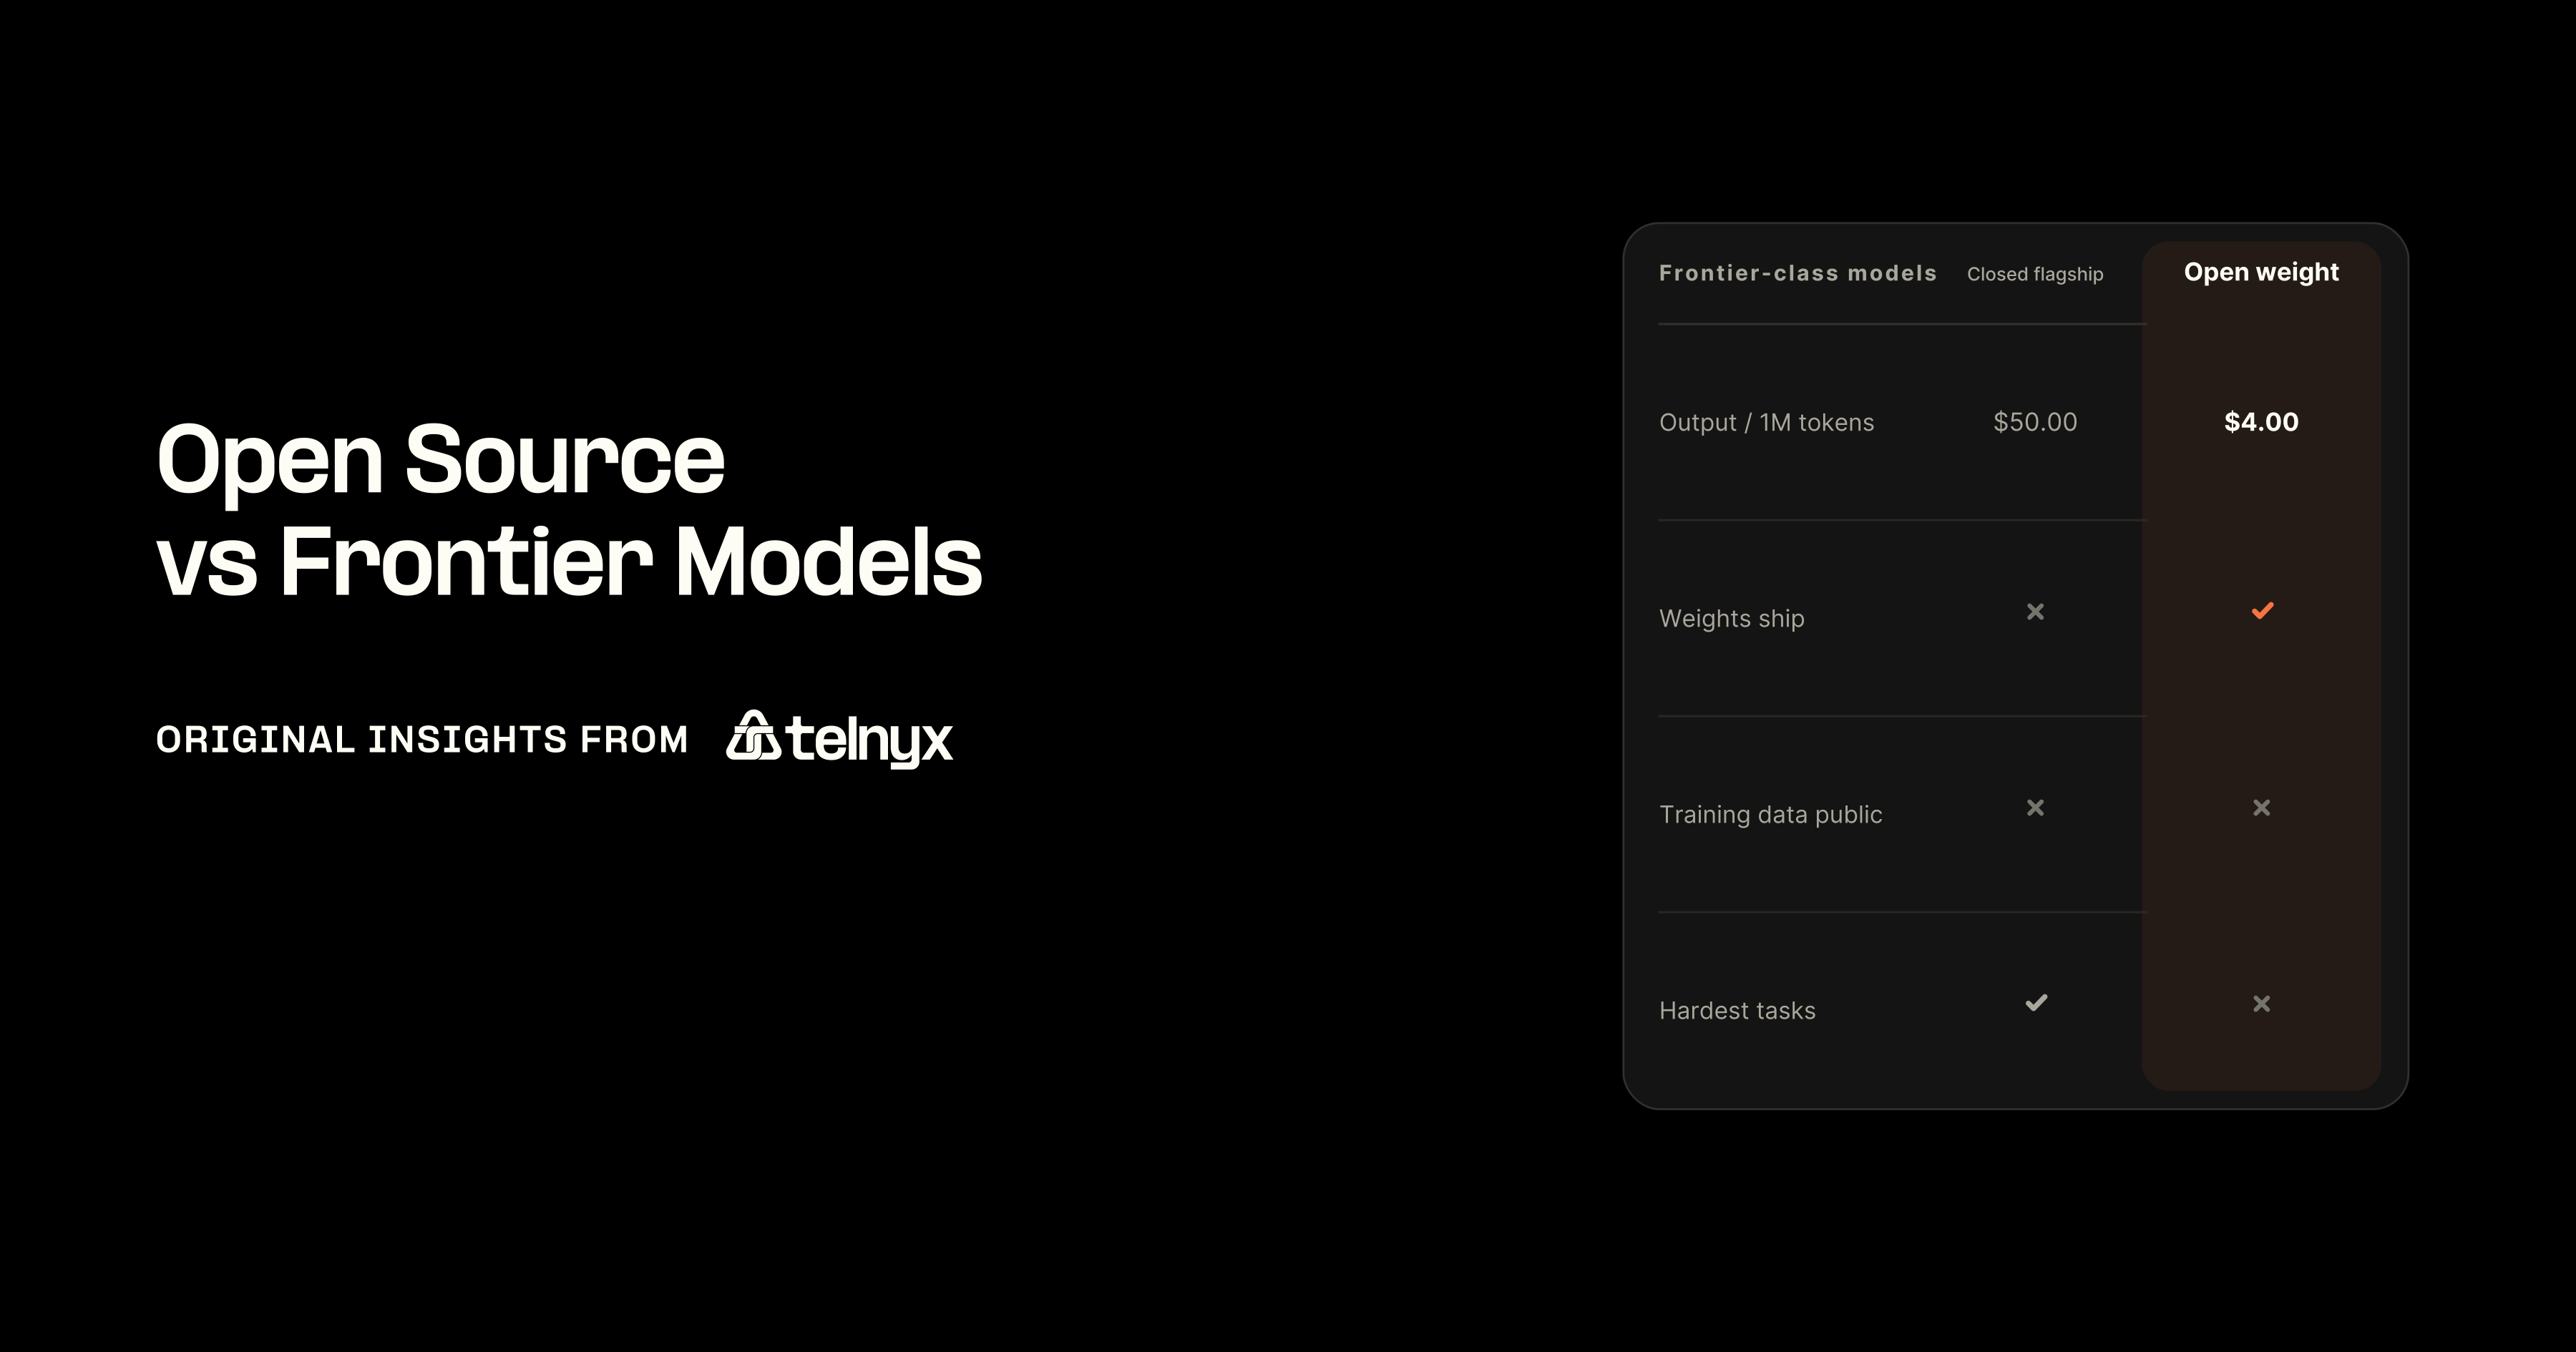
- При стандартных тарифах стоимость передовых моделей с открытыми весами составляет лишь малую часть от стоимости флагманских закрытых моделей в пересчете на миллион токенов. Вывод GLM-5.3 стоит 4,00 доллара против 50,00 долларов у GPT-6 Astra.
- Закрытые передовые модели по-прежнему оправдывают свою цену в самых сложных задачах с высокими ставками. Практический ответ для большинства команд, работающих с агентами, — это маршрутизация, а не лояльность одной модели.
- Относитесь к названию модели как к конфигурации. Флаг функции (feature flag) позволяет команде перенаправлять трафик между моделями без повторного развертывания.
Что такое frontier models
Frontier models — это самые мощные ИИ-модели, доступные в данный момент: системы, которые показывают лучшие результаты в тестах на рассуждение, программирование и агентные возможности. Этот статус изменчив. Модель, которая является передовой в январе, к октябрю может оказаться середнячком, поскольку лаборатории выпускают обновления каждые несколько недель.
Frontier vs non-frontier — это не то же самое, что closed vs open
Распространенное сокращение рассматривает «frontier» как синоним «closed». Эта концепция больше не актуальна.
Возможности и лицензия — это разные оси. Закрытая модель может быть маленькой и дешевой: OpenAI и Anthropic продают недорогие модели, созданные для классификации и маршрутизации. Модель с открытыми весами может быть огромной: Kimi K3 имеет 2,8 триллиона параметров и контекстное окно в 1 млн токенов. Распределение моделей по обеим осям дает четыре группы, и группа передовых моделей с открытыми весами растет быстрее всех.
Open source, open weight и closed: что дает каждый термин
Эти термины часто используются как взаимозаменяемые в маркетинговых материалах, но они предоставляют совершенно разные права. Определение Open Source AI (OSAID 1.0) от Open Source Initiative устанавливает самую строгую планку: модель считается таковой, только если опубликованы ее параметры, полный код, использованный для обучения и запуска, а также подробная информация об обучающих данных. Лишь немногие ведущие модели соответствуют всем трем критериям. Наше руководство по моделям с открытыми весами более подробно раскрывает это различие.
Что позволяет делать каждая категория моделей
Актуальный список моделей с открытыми весами, доступных через один OpenAI-совместимый эндпоинт, с указанием длины контекста и рекомендуемых сценариев использования, можно найти в каталоге моделей для инференса Telnyx.
Маршрутизация агентского трафика между open и frontier моделями
Используйте название модели как конфигурацию и перенаправляйте трафик между моделями без повторного развертывания, оплачивая тарифы open-weight там, где это уместно.
OS vs Frontier models: на чем стоит строить?
Модели с открытыми весами сейчас справляются с большинством рабочих задач агентов при гораздо меньших затратах. Закрытые передовые модели по-прежнему сохраняют преимущество в узком сегменте сложных задач, где цена ошибки высока.
На какой модели должен работать мой агент?
- Агент с большим объемом рутинных вызовов инструментов: используйте GLM-5.3 на Telnyx Inference. Стоимость вывода составляет 4,00 доллара за миллион токенов против 50,00 долларов у GPT-6 Astra.
- Один шаг, где неверный ответ обходится дорого: направляйте только этот шаг в GPT-6 Astra. Платить в 12,5 раз больше за токен вывода стоит того для самых сложных и ответственных задач.
- Целые контракты или кодовые базы в одном промпте: сначала протестируйте Kimi K3. Это модель с открытыми весами, она имеет 2,8 триллиона параметров и поддерживает контекстное окно в 1 млн токенов.
- Отдел комплаенса требует увидеть обучающие данные: выбирайте модель, соответствующую OSAID 1.0. Большинство релизов с открытыми весами предоставляют веса, но держат обучающие данные и код в секрете.
- Не уверены, какая модель будет лидировать в следующем квартале: сохраняйте название модели в флаге функции. Замена GPT-6 Astra на GLM-5.3 позже не потребует повторного развертывания.
«Моя лента полна людей, гордо демонстрирующих трофеи в виде '10 миллиардов токенов'. Что вижу я: 'Я только что переплатил OpenAI за то, что мог бы запустить на open-source моделях на 90% дешевле'. В этот момент OpenAI должна гравировать им: 'Спасибо за ваш вклад в наш ARR'. Тем временем те, кто реально работает на FOSS, слишком заняты экономией денег, чтобы писать об этом». Дэвид Кейсем, генеральный директор Telnyx
Где open source модели уже справляются
Модели с открытыми весами хорошо показывают себя в работе, составляющей основу агентского трафика. Наш рейтинг лучших open source LLM показал, что Kimi K3 и DeepSeek-V4.1-Flash идут наравне по независимым индексам оценки, при этом DeepSeek-V4.1-Flash стоит значительно дешевле в расчете на задачу.
Рабочие нагрузки, для которых модели с открытыми весами являются отличным выбором по умолчанию:
- Массовая сортировка обращений в поддержку, суммаризация и извлечение данных
- Агенты, вызывающие инструменты с четко определенными функциями
- Агенты-программисты, работающие внутри существующей кодовой базы
- Голосовые агенты в реальном времени, где время до первого токена важнее, чем разница в два балла в бенчмарках
Условия, при которых открытые веса подходят лучше:
- Объем токенов достаточно велик, чтобы цена за токен существенно влияла на бюджет
- Правила локализации данных определяют, где может выполняться инференс
- Команда хочет иметь возможность сменить провайдера или перейти на self-hosting в будущем
Где по-прежнему выигрывают frontier models
Закрытые флагманские модели по-прежнему лидируют по некоторым показателям общего интеллекта и в самых длинных, открытых задачах на рассуждение. Когда один неверный ответ стоит дороже, чем месяц затрат на токены, оплата самой мощной доступной модели часто является более дешевым выбором.
Триггеры эскалации: когда направлять запрос в закрытую передовую модель
- Модель с открытыми весами не справилась с одной и той же задачей в тестах более одного раза
- Задача требует долгосрочного рассуждения, где ошибка стоит дорого или ее трудно обнаружить
- Запрос требует возможности, которую открытая модель не поддерживает
- Контракт с клиентом требует использования конкретного вендора
Все остальное остается на модели с открытыми весами по умолчанию.
Стоимость за миллион токенов
Ценовой разрыв между двумя лагерями наиболее заметен в расчете на токен.
Стандартные прейскурантные цены за 1 млн токенов, проверено 13 октября 2026 года. Тарифы Telnyx взяты из прайс-листа Telnyx inference (уровень Default); тарифы Anthropic и OpenAI — из опубликованных API-прайсов каждого вендора.
GLM-5.3 стоит в восемь раз меньше, чем GPT-6 Astra на входе, и менее чем в двенадцать раз на выходе. MiniMax-M3 дешевле Claude Opus 5.5 примерно в 15 раз на входе и в 18 раз на выходе.
«Мы владеем GPU и сетью, поэтому в каждом токене нет наценки облачного провайдера, нет платы за аренду GPU, нет вычислительных надбавок, нет минимумов. Цена следует за физикой». Реджис Дэвид Соуза, ведущий инженер-программист Telnyx
Применимы два предостережения. Более дешевые токены помогают только в том случае, если модель проходит тесты рабочей нагрузки, а прейскурантная цена — это не общая стоимость: агент, который повторяет неудачный диалог, платит дважды.
Решает ли open source проблему суверенитета данных?
Частично. Открытые веса позволяют команде выбирать, где выполняется инференс, чего не позволяют закрытые API. Но суверенитет зависит от хоста, региона и политики хранения данных.
Лицензии также имеют свою географию. Meta Llama 4 Acceptable Use Policyограничивает права на свои мультимодальные модели Llama 4 для лиц, проживающих в ЕС, и компаний с основным местом деятельности там. Это ограничение не распространяется на конечных пользователей продукта, созданного на базе этих моделей.
Проверка суверенитета перед запуском
- Где физически выполняется инференс и можно ли закрепить регион?
- Сохраняет ли провайдер промпты или обучает на них модели?
- Ограничивает ли лицензия модели ее использование в юрисдикции вашей команды?
Telnyx Inference работает в различных регионах по всему миру — в Америке, Европе, на Ближнем Востоке, в Северной Африке и Азиатско-Тихоокеанском регионе — без сохранения каких-либо данных.
Почему граница эффективности вычислений постоянно смещается
Граница эффективности вычислений — это набор моделей, которые обеспечивают максимальную производительность на один доллар. Она смещается с каждым крупным релизом: GLM-5.3, Kimi K3 и DeepSeek-V4.1-Flash — все они выпустили открытые веса в период с конца июля по середину сентября 2026 года. Выбор модели, сделанный один раз и оставшийся без пересмотра, устаревает в течение квартала.
Бенчмарки задают предварительные ориентиры, но окончательное решение принимает ваша рабочая нагрузка
Публичные бенчмарки сужают список кандидатов, но редко выбирают победителя. Когда инженеры Telnyx протестировали три модели с открытыми весами на 45 многошаговых диалогах с агентами, результаты оказались очень близки по одной объективной проверке, но оценка завершенности четко их разделила. Kimi K3 успешно завершила все 30 проверок судьи; GLM-5.3 Flash завершила 90 процентов при самом быстром профиле задержки.
Как оценить релиз новой модели за пять минут
Шесть критериев отделяют полезный релиз от заголовка в СМИ:
- Лицензия: Apache 2.0 и MIT не накладывают никаких условий; пользовательские лицензии могут требовать указания авторства, устанавливать пороги доходов или шаги согласования.
- Кто проводил бенчмарк: результаты, заявленные производителем, часто оказываются выше, чем результаты независимого тестирования того же теста.
- Какой бенчмарк: выбирайте тот, который максимально близок к вашей реальной рабочей нагрузке, а не тот, у которого больше цифра.
- Активные параметры: для моделей с экспертной смесью (MoE) активные параметры влияют на стоимость обслуживания сильнее, чем общий размер.
- Контекст и модальности: убедитесь, что окно контекста и типы входных данных соответствуют реальным данным вашего агента.
- Стоимость хостинга: проверьте тарифы на входящие данные, кэшированные входящие данные и исходящие данные в прайс-листе провайдера.
Переключение моделей без повторного развертывания
Самый дешевый способ оставаться на границе эффективности — перестать жестко прописывать модель в коде. Сохраняйте ID модели во флаге, считывайте его во время запроса и изменяйте, когда результаты оценок начинают отдавать предпочтение новому релизу. Telnyx KV создана именно для таких небольших значений, к которым часто обращаются за чтением.
Приведенный ниже пример на Node.js считывает активную модель из пространства имен KV по REST API, а затем отправляет запрос на генерацию ответа в чате.
JavaScript
// Node 18+. Считывает ID активной модели из Telnyx KV, а затем вызывает метод создания ответа в чате.const API = "https://api.telnyx.com/v2";const headers = { Authorization: `Bearer ${process.env.TELNYX_API_KEY}` };const FALLBACK_MODEL = "zai-org/GLM-5.3-Flash";async function activeModel() { const url = `${API}/storage/kvs/${process.env.KV_NAMESPACE_ID}/keys/agent-model`; const res = await fetch(url, { headers }); if (!res.ok) return FALLBACK_MODEL; return (await res.text()).trim();}async function ask(messages) { const model = await activeModel(); const res = await fetch(`${API}/ai/chat/completions`, { method: "POST", headers: { ...headers, "Content-Type": "application/json" }, body: JSON.stringify({ model, messages }), }); const data = await res.json(); return { model, reply: data.choices[0].message.content };}ask([{ role: "user", content: "Summarize this ticket in one sentence." }]) .then(({ model, reply }) => console.log(`[${model}] ${reply}`));
Запись moonshotai/Kimi-K3 в ключ agent-model переводит каждого агента на модель Kimi K3 при следующем запросе. Возврат старого значения означает откат изменений. В продакшене кэшируйте флаг на несколько секунд, чтобы избежать чтения из KV при каждом вызове.
Часто задаваемые вопросы
Насколько модели с открытыми весами отстают от передовых моделей в работе с мультимодальными данными и видео?
Разрыв в обработке входных данных в основном сократился. Kimi K3 и MiniMax-M3 принимают текст, изображения и видео, а Qwen3.8-27B обрабатывает изображения и видео на одном GPU. Качество генерации при сложном визуальном рассуждении по-прежнему зависит от задачи, поэтому перед переключением протестируйте модель на реальных данных. Также проверьте условия лицензирования: мультимодальные модели Llama 4 имеют ограничения для ЕС.
Как перенести трафик агентов с закрытой модели на модель с открытыми весами без сбоев в работе агентов?
Сначала протестируйте кандидата с открытыми весами на записанных разговорах из продакшена, оценивая вызовы инструментов, соответствие формату и выполнение задач. Затем направьте небольшую долю реального трафика через флаг функции, сравните результаты и постепенно увеличивайте эту долю. Совместимая с OpenAI конечная точка позволяет сохранить клиентский код без изменений.
Как соотносятся цены на кэшированные входные данные между моделями с открытыми весами и передовыми моделями?
Кэшированные входные данные сокращают разрыв сильнее, чем предполагают стандартные тарифы. При стандартных тарифах Claude Opus 5.5 берет $0.20 за 1 млн кэшированных токенов входа, а GPT-6 Astra — $1.00, в то время как GLM-5.3 на Telnyx стоит $0.24, а Kimi K3 — $0.27. Основная экономия для моделей с открытыми весами достигается за счет невходящих кэшированных данных и исходящих токенов.
В чем разница между моделями с открытым исходным кодом и моделями с открытыми весами?
Искусственный интеллект с открытым исходным кодом в соответствии с OSAID 1.0 публикует веса, полный код для обучения и инференса, а также подробную информацию о тренировочных данных. Модели с открытыми весами публикуют обученные веса и лицензию, как правило, без данных и кода обучения. Практически каждая ведущая «открытая» модель сегодня является моделью с открытыми весами.
Что дешевле: развернуть модель с открытыми весами самостоятельно или использовать хостинговый API?
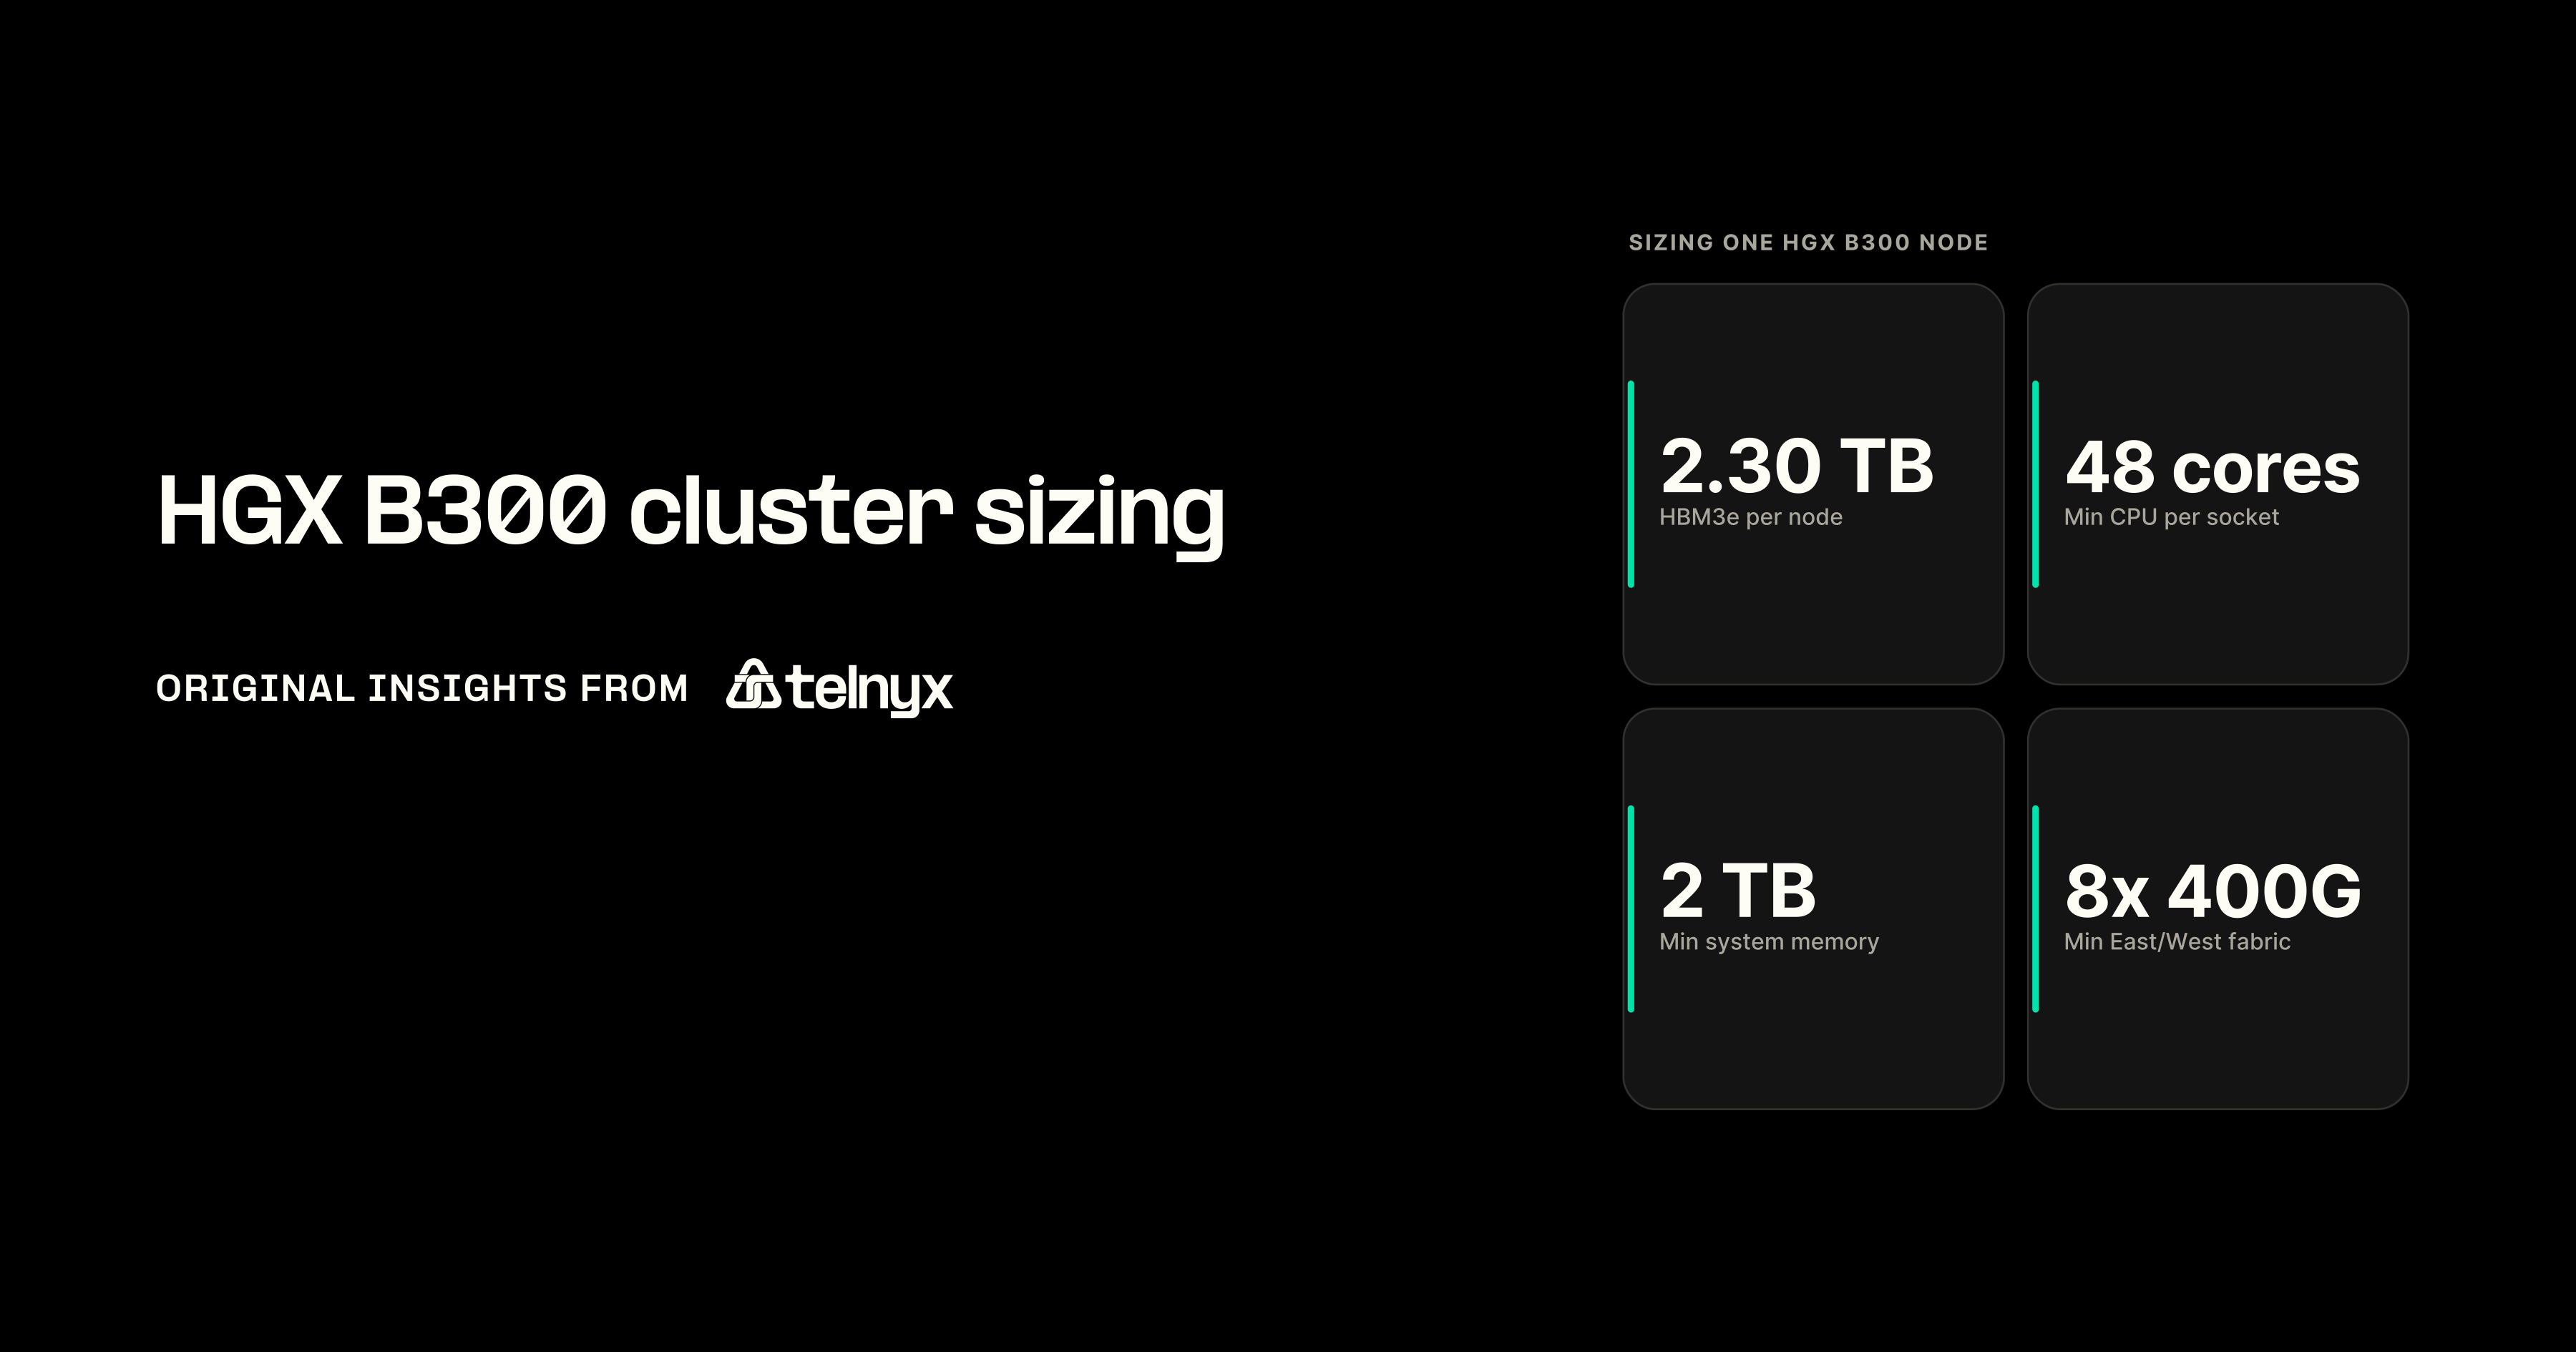
Для большинства команд хостинговый API обходится дешевле, пока объем запросов не станет очень большим и стабильным. Передовые открытые модели требуют серьезного аппаратного обеспечения: для GLM-5.3 реально требуется узел с восемью графическими процессорами, а полные веса Kimi K3 занимают около 1.56 ТБ. Самостоятельный хостинг также добавляет хлопот по планированию ресурсов и операционной работе, которые отсутствуют при ценообразовании за токен.
Создавайте агентов на базе передовых открытых моделей
Передовые возможности больше не требуют использования закрытого API. Telnyx Inference запускает GLM-5.3, Kimi K3, MiniMax-M3, DeepSeek-V4.1-Flash и другие модели на собственных графических процессорах Telnyx через единую конечную точку, совместимую с OpenAI, с локальным обслуживанием в регионах и без минимальных требований.
Начните разработку с Telnyx Inference → https://telnyx.com/products/inference
Создавайте агентов на основе модели, оптимальной для каждой конкретной задачи
Запускайте первоклассные модели с открытыми весами за малую часть стоимости закрытых флагманских моделей и оставляйте закрытые передовые модели для самых сложных и ответственных задач.
Начать маршрутизацию моделей