Основные выводы
- Периферийный вывод выполняет обученную модель на ближайшем уровне с достаточной для задачи вычислительной мощностью: на самом устройстве, на локальном сервере, на графическом процессоре на сетевой периферии внутри сети оператора или в центральном облачном регионе. Выбор правильного уровня для каждой рабочей нагрузки определяет вашу задержку, стоимость и то, куда передаются ваши данные.
- Для агентов реального времени сетевой путь определяет задержку в той же мере, что и сама модель. Приближение модели сокращает только сетевой отрезок каждого вызова.
- Одно поле запроса позволяет перенаправить интерактивный вызов, например один ход речевого диалога, на емкость с оптимизированной задержкой, а фоновую задачу — на более дешевую емкость, используя ту же модель.
- Лишь немногие провайдеры серверного вывода обслуживают модели в том же регионе за пределами США, поэтому перед любым сравнением проверяйте, где физически расположены графические процессоры (GPU).
Что такое периферийный вывод?
Периферийный вывод — это выполнение обученной модели, при котором входные данные преобразуются в выходные в точке, расположенной близко к вашим пользователям или источнику данных, а не в удаленном центральном облачном регионе. Этот термин используется в разных значениях. В некоторых руководствах под ним понимают исключительно обработку на устройстве, другие делят мир на ближнюю и дальнюю периферию, а третьи используют понятия «устройство», «шлюз» и «туманные вычисления». Более наглядная карта состоит из четырех уровней, упорядоченных по расстоянию от пользователя.
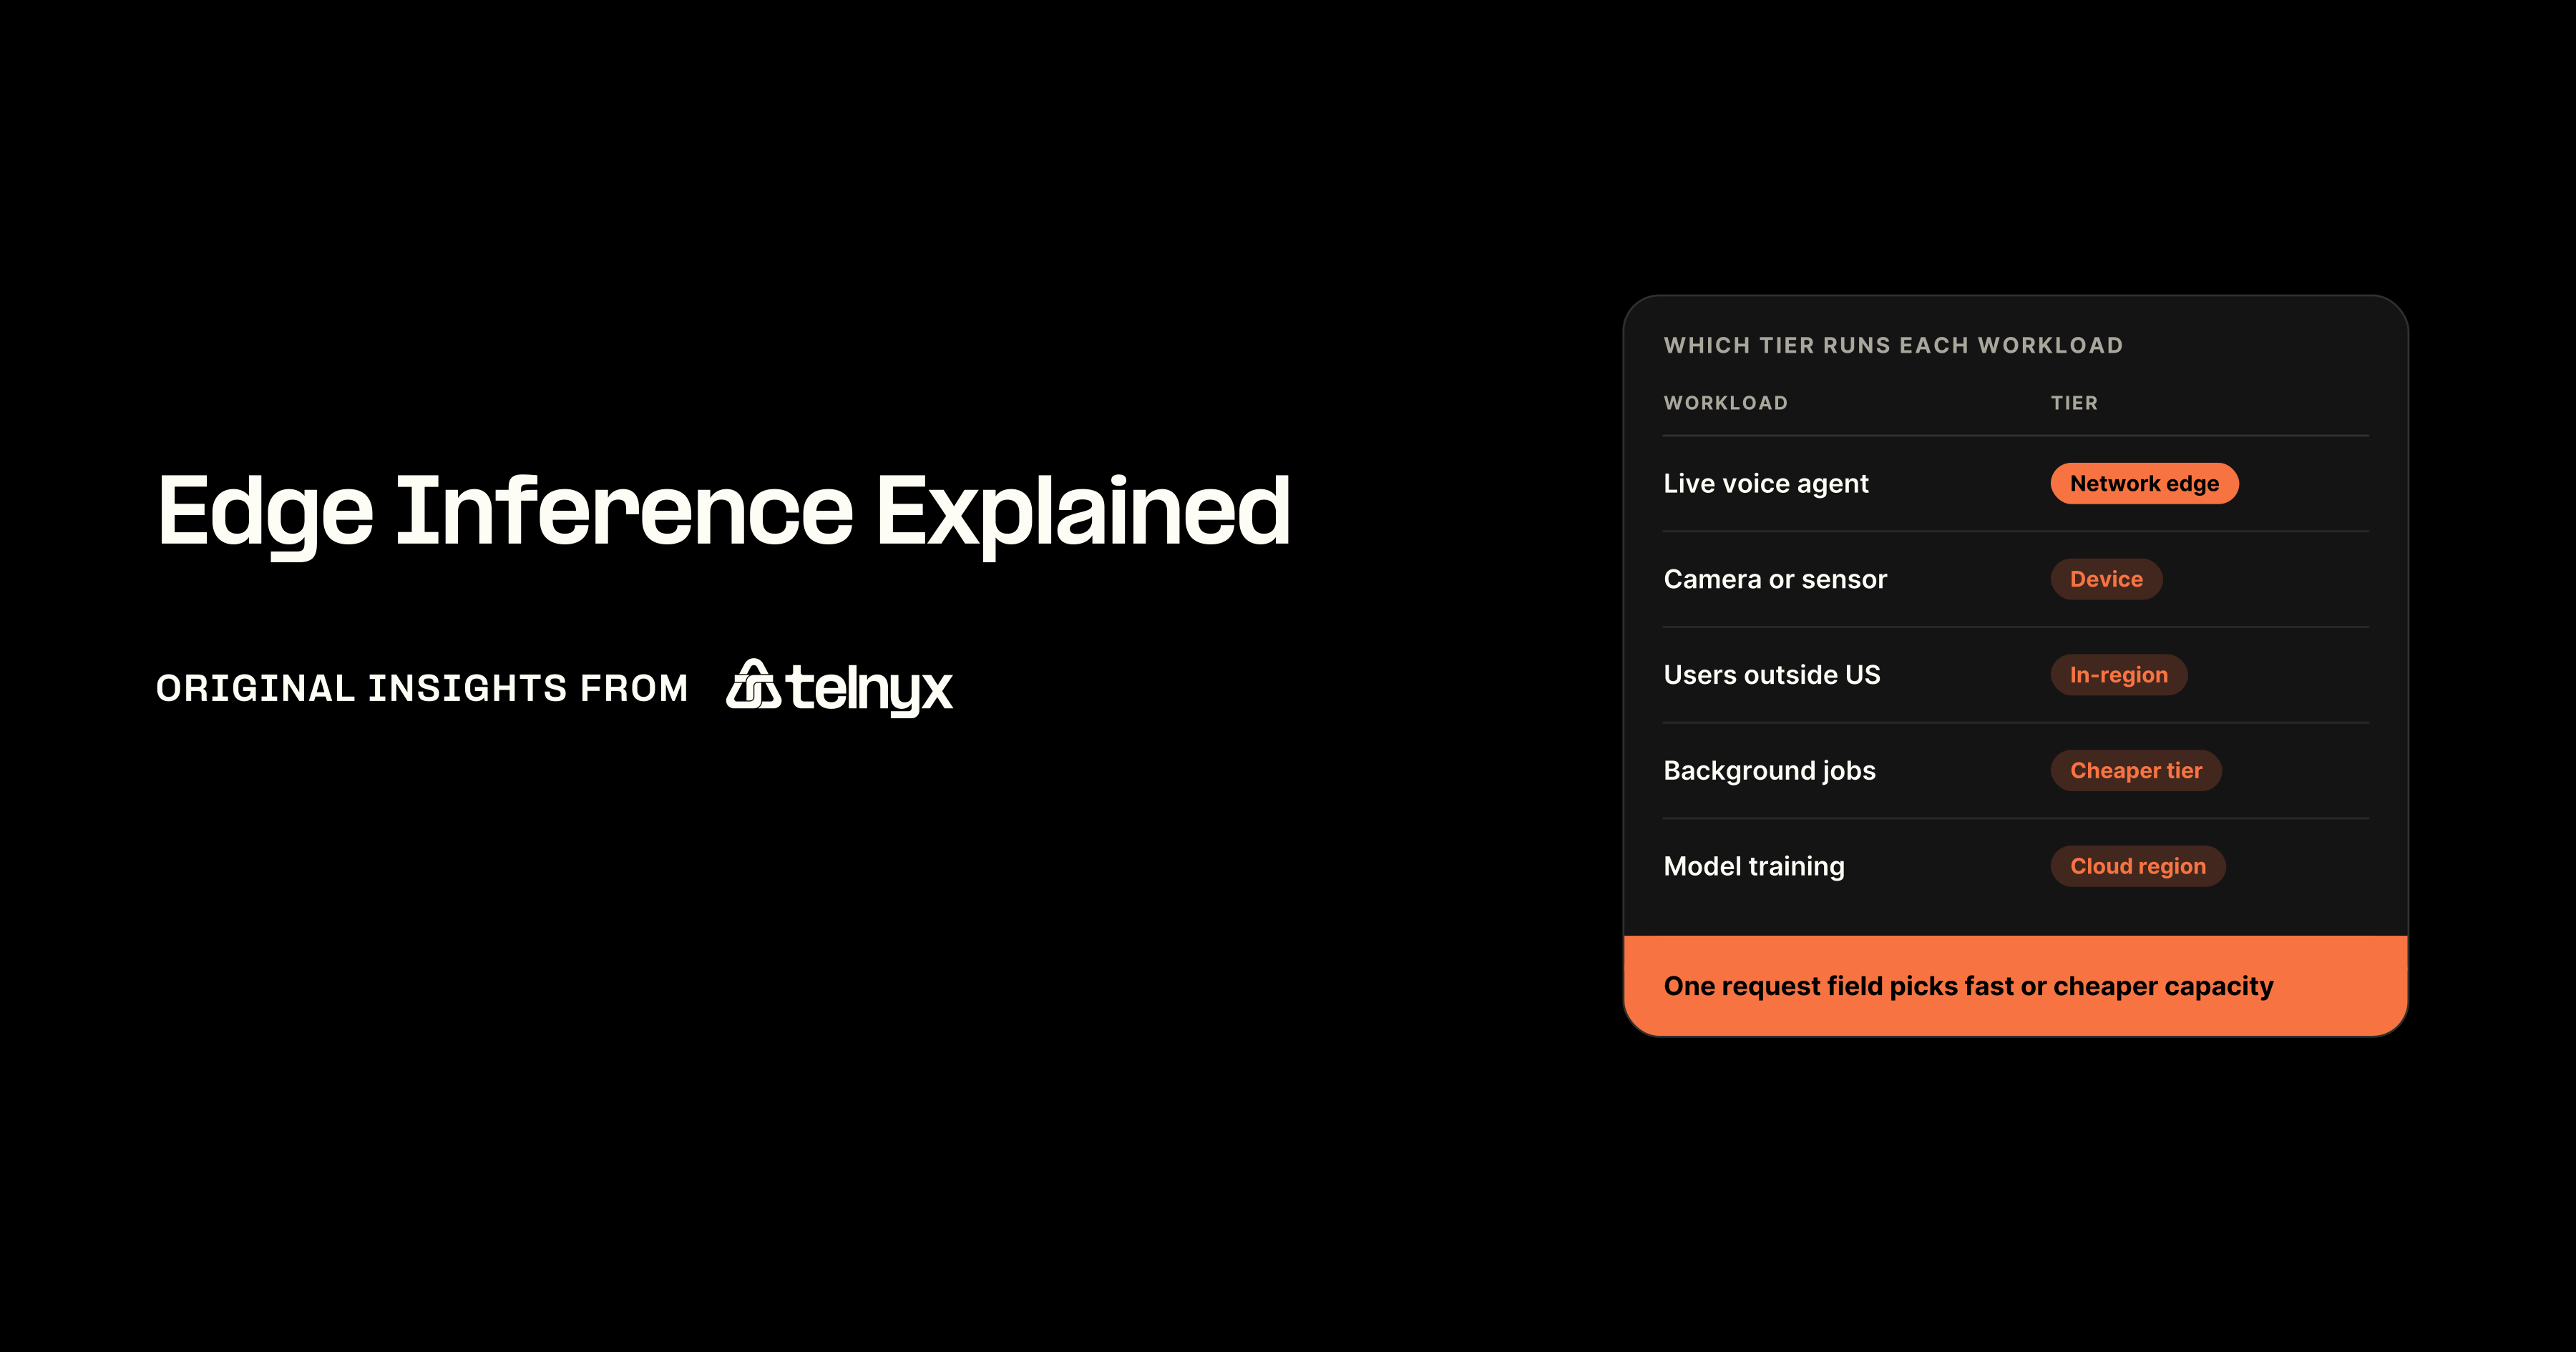
Какой уровень запустить для моей модели?
- Говорите с голосовым агентом в реальном времени: используйте Telnyx AI Inference на емкости с оптимизированной задержкой на сетевой периферии. Графические процессоры внутри сети оператора сокращают сетевой отрезок каждого диалогового шага.
- Небольшая модель внутри камеры или датчика: запустите ее на самом устройстве. Модель помещается на вашем «железе», а исходные данные никогда не покидают датчик.
- Пользователи в Европе, странах Ближнего Востока, Северной Африки (MENA) или Азиатско-Тихоокеанского региона (APAC): вызывайте Telnyx AI Inference в своем регионе с нулевым хранением данных. Промпты остаются локальными вместо того, чтобы пересылаться в облако другого провайдера и обратно.
- Фоновые задачи, которых никто не ждет: отправляйте их на более дешевую емкость с помощью одного поля запроса в Telnyx AI Inference. Та же модель, что и для интерактивных вызовов, но ниже стоимость одной задачи.
- Обучение на больших наборах данных: оставьте его в центральном облачном регионе. Долгим задачам для GPU требуются крупнейшие вычислительные кластеры, к тому же обучение не запускается при каждом запросе.
Telnyx выполняет вывод на третьем из этих уровней — сетевой периферии — на графических процессорах, размещенных на тех же узлах связи, которые обслуживают ваших пользователей. С помощью Telnyx AI Inference запросы обрабатываются локально в регионах Северной и Южной Америки, Европы, MENA и APAC без сохранения данных, поэтому промпт не попадает в облако другого провайдера и обратно, прежде чем ваш агент ответит.
Запуск открытых моделей на расстоянии одного «хопа» от пользователей
Telnyx AI Inference обслуживает модели с открытыми весами на локальных GPU через API, совместимый с OpenAI, поэтому вы можете просто изменить базовый URL и сохранить свой SDK.
Попробуйте Telnyx Inference
Что означает «периферия» (edge): устройство, локальная инфраструктура, сетевая периферия
Каждый уровень определяется тем, где расположено оборудование и кому оно принадлежит.
- Периферия устройства: модель работает на датчике, камере, телефоне или автомобиле, которые производят данные, а оборудование принадлежит вам или вашему клиенту.
- Локальная периферия (on-prem): шлюз или сервер на вашей площадке запускает одну модель для нескольких устройств, и вы сами владеете им и управляете.
- Сетевая периферия: графический процессор в региональной точке присутствия внутри сети оператора связи, которая уже обслуживает трафик ваших пользователей; управляется оператором сети, а вы используете ее как сервис.
- Центральное облако: крупный регион, часто удаленный от большинства ваших пользователей, с самыми большими парками GPU, управляемый облачным провайдером.
Уровни устройств и локальной инфраструктуры жертвуют вычислительной мощностью ради приближения к источнику данных. Центральное облако жертвует близостью ради вычислительной мощности. Сетевая периферия располагается между ними: она достаточно близка для интерактивных циклов и достаточно мощна для работы полноценных моделей с открытыми весами, которые никогда бы не поместились на телефоне или камере.
Периферийный вывод против периферийных вычислений против периферийного ИИ (Edge AI)
Эти три термина описывают разные масштабы. Периферийные вычисления относятся к тому, где располагаются вычислительные мощности — близко к пользователям или данным. Периферийный ИИ — это любая рабочая нагрузка ИИ в этом месте, включая аналитику или локальную донастройку (fine-tuning). Периферийный вывод еще более узок: это только тот шаг, на котором обученная модель выдает результат.
На практике обучение обычно остается в центральном дата-центре, где находятся большие наборы данных и долгие задачи для GPU. Вывод — это та часть, которая смещается наружу, поскольку он выполняется при каждом запросе, а каждый запрос несет издержки расстояния.
Соотнесите каждый вызов с правильной емкостью
Направляйте голосовые реплики на емкость с оптимизированной задержкой, а фоновые задачи — на более дешевую емкость, используя одно поле запроса и ту же модель.
Как работает периферийный вывод
Каждый вызов вывода тратит время в четырех местах: на сетевой путь к модели, на очередь ожидания вычислительной мощности, на собственные вычисления модели и (для языковых моделей) на ожидание потоковой передачи первого токена. Приближение модели сокращает только первое из этих условий, о чем более подробно рассказано в материале об объяснении задержки вывода. Именно поэтому выбор уровня имеет наибольшее значение для небольших, частых, интерактивных вызовов и наименьшее — для пакетных задач, которые в любом случае выполняются минутами.
Жизненный цикл такого вызова следует одной и той же схеме на каждом уровне. Вы обучаете или выбираете модель централизованно, уменьшаете ее для целевого уровня с помощью квантования, прунинга или дистилляции, если «железо» слабое, развертываете ее, запускаете вывод и отправляете наверх только результаты или обобщенные признаки. Затем вы отслеживаете точность и дрифт данных, а также отправляете обновления на все узлы, где запущена модель.
Примечание: Приближение модели сокращает только сетевой отрезок. Очередь, вычисления модели и время до первого токена остаются там, где работает модель. Измерьте все четыре показателя, прежде чем решать, что уровень достаточно быстр.
Где работает модель: четыре уровня и их особенности
Каждый уровень подходит для определенного типа рабочей нагрузки, причем сетевая периферия — это тот вариант, который большинство руководств по edge опускают.
Каким задачам соответствует каждый уровень вывода
На сетевой периферии Telnyx размещает графические процессоры в сети, обслуживающей ваших пользователей, поэтому запросы избегают как трансграничной маршрутизации, так и передачи данных другому провайдеру. Продукт обеспечивает нулевое хранение данных, не обучает свои модели на вашей информации и автоматически масштабируется на собственной инфраструктуре GPU без необходимости планирования емкости и без холодного старта.
Какую роль играют процессоры (CPU) в периферийном выводе?
Процессоры выполняют все задачи вокруг модели. Они отвечают за оркестрацию, предварительную обработку (например, декодирование аудио, изменение размера видеокадров и токенизацию текста), постобратку результатов работы модели, а также за небольшие модели вроде классификаторов или детекторов ключевых слов. Графические процессоры (GPU) и нейропроцессоры (NPU) выполняют насыщенный матрицами прямой проход (forward pass) более крупных моделей, на что и уходит больше всего вычислительного времени.
На уровнях устройств и локальных серверов вы выбираете среду выполнения (runtime), подходящую под ваше «железо». ONNX Runtime работает с одним форматом моделей на чипах разных производителей, в то время как NVIDIA TensorRT компилирует модели для максимальной скорости на GPU от NVIDIA. На сетевой периферии провайдер управляет средой выполнения, а вы просто отправляете запросы.
Какая сеть вам нужна для вывода ИИ на периферии?
Сеть должна доставлять ваши данные к уровню с моделью и обратно — быстро и предсказуемо при каждом вызове. Для агентов реального времени это означает четыре вещи:
- Низкое и стабильное время кругового пути (RTT) до модели, поскольку колебания портят разговор точно так же, как и общая задержка.
- Достаточная пропускная способность восходящего канала для отправляемых «сырых» данных, таких как аудиопотоки или кадры с камер.
- Частное подключение к AWS или другому облачному региону, используемому в качестве резервного, благодаря чему избыточный трафик не выходит в публичный интернет.
- Медиаданные обрабатываются в той же сети, что и инференс для голосовых функций, поскольку аудиоданные, которые перекодируются или подвергаются понижению дискретизации между операторами, могут поступать к вашей речевой модели с меньшей детализацией, чем ожидалось.
Когда вам требуется собственная логика рядом с моделью, Edge Compute выполняет ваш код в той же сети Telnyx, поэтому предварительная обработка, правила маршрутизации и вызовы инструментов не добавляют лишних переходов.
Вызов локальной модели из собственного кода
Если вы уже используете SDK, совместимый с OpenAI, уровень пограничной сети (network edge) сводится к одному HTTP-запросу. Вот задокументированный вызов chat completions:
Shell
curl -i -X POST "https://api.telnyx.com/v2/ai/chat/completions" \ -H "Authorization: Bearer $TELNYX_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "moonshotai/Kimi-K3", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Если поле service_tier не указано, запрос выполняется на стандартной емкости (Default). Добавление service_tier и выбор уровня Priority перенаправляет тот же запрос на вычислительные мощности, оптимизированные для интерактивных задач с низкими задержками. Уровень Priority сохраняет ту же модель и контекстное окно, поэтому вы просто меняете одно поле в теле запроса вместо подключения второго провайдера.
Пограничный инференс против облачного инференса для ИИ-агентов
Пограничный инференс выигрывает для ИИ-агентов всегда, когда агент участвует в диалоге или цикле управления, поскольку короткий и стабильный сетевой путь снижает как задержку, так и ее вариативность. Централизованное облако побеждает, когда вам нужны самые большие модели или когда задачу можно отложить. Telnyx выполняет инференс на региональном уровне, поэтому ваши данные остаются там же, где находятся ваши пользователи, а уровень Priority создан для интерактивных рабочих нагрузок, таких как голосовая оркестрация.
Компромиссы распределяются по пяти факторам:
- Задержка и джиттер: пограничные уровни находятся на коротком пути с минимальной вариативностью, в то время как удаленный облачный регион располагается в конце интернет-маршрута, который меняется от вызова к вызову.
- Размер модели: локальные устройства и серверы ограничены местным «железом», в то время как графические процессоры на периферии сети и в центральном облаке запускают полноценные модели с открытыми весами.
- Резидентность данных: региональный инференс без сохранения данных оставляет информацию в регионе пользователя, в то время как центральный регион может передавать ее через границы.
- Ценовая модель: Telnyx взимает плату за токен без платы за аренду GPU или минимальных платежей, в то время как другие провайдеры часто выставляют счета за запрос или за GPU-час.
- Подключение: модель на устройстве работает офлайн, периферия сети требует канала связи оператора, а облако нуждается в публичном интернете.
Резидентность данных также важна для клиентов: согласно опросу Telnyx среди 106 взрослых жителей США (SurveyMonkey, 2026), 25% респондентов назвали проблемы конфиденциальности и безопасности данных главным опасением при взаимодействии с голосовой ИИ-системой (доверительный интервал 95% составляет 18–35%). Эта цифра носит ориентировочный характер, но она показывает, что люди на другом конце вашего агента заботятся о том, куда уходят их данные.
Требования к задержкам для ИИ-приложений реального времени в масштабах предприятия
Требования ИИ-агента к задержке определяются циклом, в котором он работает. Ответ в речевом диалоге должен поступить до того, как абонент заметит паузу. Цикл управления робота требует ответа до совершения следующего действия. Конвейер обработки документов может ждать минуты без каких-либо неудобств для пользователей.
Эти циклы указывают на разные уровни обслуживания, и Telnyx предлагает три таких уровня для одних и тех же моделей. Default — это стандартная емкость. Priority оптимизирован для интерактивной работы с низкими задержками, включая голосовую оркестрацию. Flex предназначен для фоновых задач, таких как офлайн-оценка, обработка документов и суммаризация, где допустимы минуты сквозной задержки.
Где размещенный в облаке инференс добавляет задержки и джиттер
Когда модель размещается третьей стороной в публичном облаке, она находится в конце интернет-пути, который вы не контролируете, поэтому вы платите как за расстояние, так и за вариативность. Симптом знаком каждому, кто объединял в цепочку стороннего провайдера распознавания речи, размещенную LLM и движок синтеза речи (TTS): в демо агент звучит отлично, но начинает тормозить или перебивать собеседника в долгих разговорах, и панель управления ни одного из провайдеров не показывает причину.
«Когда вы действительно используете модель инференса или синтеза речи, размещенную на серверах стороннего вендора, они обычно используют публичную облачную сеть. Это влечет за собой множество задержек и джиттера». Абхишек Шарма (Abhishek Sharma), старший технический писатель в Telnyx
Пограничный инференс быстрее для отдельного вызова, но он не обязательно быстрее в целом от начала до конца. Небольшой модели на устройстве, которой приходится передавать сложный запрос более крупной модели в облаке, приходится оплачивать два вызова инференса и пересылку данных между ними, из-за чего полный ответ может оказаться медленнее, чем один вызов способной модели в том же регионе.
Когда имеет смысл гибридная настройка из периферии и облака
Гибридный подход лучше всего работает на основе правил маршрутизации. Небольшая модель на устройстве или локальном сервере принимает первоначальное решение — например, фиксирует ли кадр дефект или закончил ли собеседник говорить, — а более крупная региональная модель обрабатывает реплики, требующие рассуждений. Пакетные суммаризации и оценки при этом передаются на мощности Flex.
Поскольку уровни Telnyx работают на моделях, размещенных самой Telnyx, перенос рабочей нагрузки между Default, Priority и Flex сводится к изменению одного поля в запросе, а не к подключению второго провайдера инференса со своим собственным контрактом и режимами сбоев.
Сценарии использования пограничного инференса, где задержка определяет результат
Сценарии, получающие наибольшую выгоду от пограничного инференса, имеют одну общую черту: кто-то или что-то ждет каждого ответа. Telnyx запускает синтез речи, голосовой ИИ и телефонию на той же инфраструктуре, что и инференс. Тот же ключ API, та же сеть, тот же счет, поэтому весь цикл голосового агента может выполняться в рамках одной сети.
Голосовые ИИ-агенты в реальном времени
Голосовой агент выполняет полную цепочку инференса на каждом этапе диалога.
«Мы часто зацикливаемся на скорости инференса LLM, но в голосовом ИИ сеть часто оказывается скрытым убийцей». Иэн Райтер (Ian Reither), операционный директор Telnyx
Аудио поступает, модуль распознавания речи превращает его в текст, LLM пишет ответ, а TTS снова преобразует его в аудио, пока абонент ждет завершения всего процесса. Каждый переход между провайдерами увеличивает паузу, как показывают сравнения задержек голосовых агентов для разных стеков. Telnyx объединяет медиаплоскость, оркестрацию и инференс в единую сеть, предлагая емкость Priority для голосовой оркестрации, а масштабирование инференса автоматически происходит от 0 до тысяч запросов в секунду без предварительного планирования ресурсов.
Если у вас есть разработчик, пример из репозитория примеров кода Telnyx `edge-merge-ai-receptionist-python` демонстрирует этап инференса внутри живого вызова, где пограничный воркер отвечает на звонки с помощью Telnyx Voice, AI Inference и Edge Compute. Это эталонный пример, который еще не прошел проверку на соответствие с SDK, и его шаг инференса вызывает ту же конечную точку chat completions, что показана ранее:
Python
def call_inference(prompt, context): try: resp = requests.post(INFERENCE_URL, headers=HEADERS, timeout=15, json={ "model": AI_MODEL, "messages": [ {"role": "system", "content": f"You are a professional receptionist. Use this context to route the call:\n{json.dumps(context)}\nBe concise. 1-2 sentences."}, {"role": "user", "content": prompt} ] }) if resp.ok: return resp.json()["choices"][0]["message"]["content"] except Exception as e: app.logger.error("Inference failed: %s", e) return "Let me transfer you now."
«Большинство заявлений об „сквозном голосовом ИИ“ рассыпаются, когда вы измеряете то, что действительно важно: опыт конечного клиента в реальном времени. Задержка при переходе (turn latency), джиттер, обработка прерываний. Не бенчмарки на слайде, а поведение во время живого звонка. Это возможно только тогда, когда вы контролируете весь стек: сеть, плоскость передачи медиаданных, оркестрацию и пути вывода, а не хрупкую цепочку сторонних сервисов через публичный интернет. Именно к этому стандарту должен стремиться голосовой ИИ». Ян Райтер (Ian Reither), операционный директор Telnyx
Робототехника, промышленный осмотр и прогнозное обслуживание
Контурам управления и линиям инспекции нужен ответ до совершения следующего физического действия. Это указывает на уровень устройства или локальной инфраструктуры (on-prem) для рефлексов — например, остановки манипулятора или выбраковки детали, — а также на периферию сети (network edge) для более тяжелых моделей восприятия и планирования, которые не поместятся на самом устройстве. Команды, управляющие парками роботов, размещают мощности графических процессоров по регионам, чтобы удерживать целевые показатели задержки на разных объектах. Беспилотные автомобили и устройства умного дома используют такое же разделение между бортовыми рефлексами и удаленным принятием решений.
Регулируемые данные в здравоохранении и финансах
Для данных пациентов и учетных записей решающим фактором является то, куда могут перемещаться эти данные. Инференс в пределах региона с нулевым сохранением данных и без трансграничной маршрутизации гарантирует, что сведения о звонящем остаются в том же регионе, где он находится. Это критически важно для голосовых решений в сфере здравоохранения, а также для банков и страховых компаний, подчиняющихся региональным нормам работы с данными.
Голосовой ИИ-агент
Периферия сети. Каждый цикл (turn) выполняет распознавание речи (speech-to-text), работу языковой модели (LLM) и синтез речи (text-to-speech), пока абонент ждет ответа.
Робот или инспекционная линия
Устройство или локальная инфраструктура (on-prem) для рефлексов, периферия сети для моделей восприятия и планирования.
Данные пациентов или учетных записей
Периферия сети в конкретном регионе или локальная инфраструктура (on-prem), выбранные в зависимости от того, куда разрешено передавать данные.
Как сравнивать платформы периферийного инференса
Первый вопрос для любой платформы периферийного инференса заключается в том, обслуживает ли она модели в том регионе, где находятся ваши пользователи. Поддержка Kubernetes, панели мониторинга и каталоги моделей имеют меньшее значение, если каждый запрос все равно пересекает океан. Telnyx выполняет бессерверный инференс (serverless inference) на собственных графических процессорах внутри региона и тарифицирует его по токенам.
Чек-лист для оценки вариантов периферийных вычислений для ИИ-инференса
Пройдите эти семь критериев по порядку, начиная с региона:
- Обслуживание в регионе: Telnyx осуществляет инференс в Северной и Южной Америке, Европе, регионе Ближнего Востока и Северной Африки (MENA), а также в Азиатско-Тихоокеанском регионе (APAC).
- Хранение данных: нулевое сохранение данных и отсутствие обучения на ваших данных.
- Совместимость с API: эндпоинты, совместимые с OpenAI, поэтому вы можете просто изменить базовый URL, сохранив свой SDK и оркестрацию.
- Выбор уровня задержки (Latency tier): Default (по умолчанию), Priority (приоритетный) и Flex (гибкий), выбираемые с помощью поля service_tier.
- Автомасштабирование: собственные графические процессоры масштабируются вместе с вашим трафиком без необходимости планирования емкости.
- Структура ценообразования: тарифы за токен, которые варьируются в зависимости от модели и уровня (до 75% дешевле проприетарных моделей), без платы за аренду GPU и минимальных платежей.
- Совместно размещенная среда выполнения (Co-located runtime): Edge Compute запускает ваш собственный код рядом с моделью.
Какие вендоры поддерживают периферийный инференс в масштабе?
Многие провайдеры инференса предлагают бессерверные API, но гораздо меньшее их число запускает эти бессерверные API в конкретных регионах за пределами США. Вот как Telnyx видит этот рынок:
«Дело в том и в другом, но неприятная правда заключается в том, что большинство конкурентов вообще не предлагают бессерверные решения внутри регионов. Together сосредоточена в США и не имеет рекламируемых бессерверных мощностей в ЕС или APAC. У Fireworks более 15 регионов, но выделенные развертывания (dedicated deployments) доступны только за пределами США. Мы же уже сегодня запускаем бессерверный инференс в Америке, Европе и APAC, а скоро запустим в Дубае и Сан-Паулу. Данные остаются там, где ваши пользователи, потому что наши GPU физически находятся там, а не потому, что вы переключили какую-то настройку». Режис Давид Соуза (Regis David Souza), старший инженер-разработчик Telnyx
На практике это означает, что Together концентрирует свои бессерверные мощности в США без рекламируемых вариантов бессерверных вычислений в ЕС или APAC, а Fireworks указывает более 15 регионов, но предлагает выделенные развертывания только за пределами США. Если ваши пользователи находятся во Франкфурте или Сиднее, выделенное развертывание означает оплату зарезервированных графических процессоров, в то время как бессерверный API в регионе позволяет платить за токен.
Где Telnyx запускает бессерверный инференс сегодня
Telnyx осуществляет инференс в регионах Северной и Южной Америки, Европы, MENA и APAC, а скоро появится поддержка Латинской Америки. Графические процессоры находятся в той же сети, по которой передаются звонки и сообщения ваших пользователей, поэтому данные остаются в том регионе, где начался запрос.
Каждая модель может работать на трех уровнях обслуживания. Default — это стандартная емкость, которую получает каждый запрос, если поле уровня не указано. Priority оптимизирован для интерактивных рабочих нагрузок с низкой задержкой, включая голосовую оркестрацию, и уже доступен для отдельных моделей. Flex предлагает самые низкие тарифы для задач обработки потока данных (throughput), где допустима задержка в несколько минут; он доступен в США для отдельных моделей и обрабатывает все запросы синхронно.
Что касается цен, то Telnyx AI Inference стоит до 75% дешевле проприетарных моделей, кэшированный ввод обходится со скидкой до 88%, при этом отсутствуют плата за аренду GPU, надбавки за вычисления и минимальные платежи.
Часто задаваемые вопросы (FAQ)
Могу ли я использовать API инференса только для этапа LLM, распознавания речи или синтеза речи, сохранив собственную оркестрацию?
Да. Telnyx AI Inference предоставляет эндпоинты, совместимые с OpenAI, поэтому вы можете заменить только шаг LLM, просто изменив базовый URL в существующем SDK. Ваша оркестрация, промпты и инструменты остаются на прежних местах. Распознавание и синтез речи работают в той же сети Telnyx и с тем же ключом API, если вы захотите перенести и эти этапы позже.
Может ли инференс выполняться в определенном регионе — например, на западном и восточном побережьях США, — чтобы соответствовать целевой задержке?
Telnyx осуществляет инференс в регионах по всему миру (Америка, Европа, MENA и APAC), поэтому запросы от ваших пользователей остаются близко к ним. Если вам нужно закрепить емкость за конкретными мегаполисами (например, за обеими побережьями США), обратитесь к команде Telnyx, чтобы обсудить целевые показатели задержки и трафик для подтверждения размещения вашей рабочей нагрузки.
Сколько одновременных запросов инференса я могу запустить, прежде чем достигну лимита?
Telnyx AI Inference автоматически масштабируется на собственной инфраструктуре GPU, поэтому вам не нужно заранее резервировать мощности — вы платите только за используемые токены. Для очень высоких постоянных объемов или для лимитов вашего собственного кода, запущенного в Edge Compute, ознакомьтесь с документацией для разработчиков или проконсультируйтесь с командой Telnyx перед запуском.
Всегда ли периферийный инференс быстрее облачного?
Нет. Периферийный инференс сокращает протяженность сетевого участка, но очереди, вычисления модели и время до первого токена (time to first token) остаются прежними независимо от того, где запущена модель. Небольшая периферийная модель, которая вынуждена эскалировать сложные запросы на более крупную облачную модель, в конечном итоге может работать медленнее, чем один вызов мощной модели в регионе.
Могут ли периферийные устройства запускать большие языковые модели?
Небольшие модели, после квантования, работают на устройствах с достаточным объемом памяти. Более крупным моделям с открытыми весами требуются графические процессоры дата-центров. Уровень сетевой периферии закрывает этот пробел: модель работает на графических процессорах в региональной точке присутствия рядом с вашими пользователями, поэтому вы получаете полноразмерные модели без задержек центрального облачного региона.
Когда имеет смысл гибридная архитектура периферийного и облачного вывода?
Гибридный подход имеет смысл, когда быстрое локальное решение фильтрует большую часть трафика, а для некоторых запросов требуется модель покрупнее. Камера может зафиксировать движение на устройстве и отправить дальше только отмеченные кадры, или голосовой помощник может локально определить конец речи и отправить сложные реплики в региональную LLM.
Разместите вывод в одном «прыжке» от ваших пользователей
Выполняйте каждый вызов на том уровне, который требует ваш бюджет времени отклика, используя региональные графические процессоры Telnyx в Америке, Европе, странах Ближнего Востока и Северной Африки, а также в Азиатско-Тихоокеанском регионе. API совместим с OpenAI, поэтому вы меняете базовый URL и сразу начинаете работу.
Начать разработку