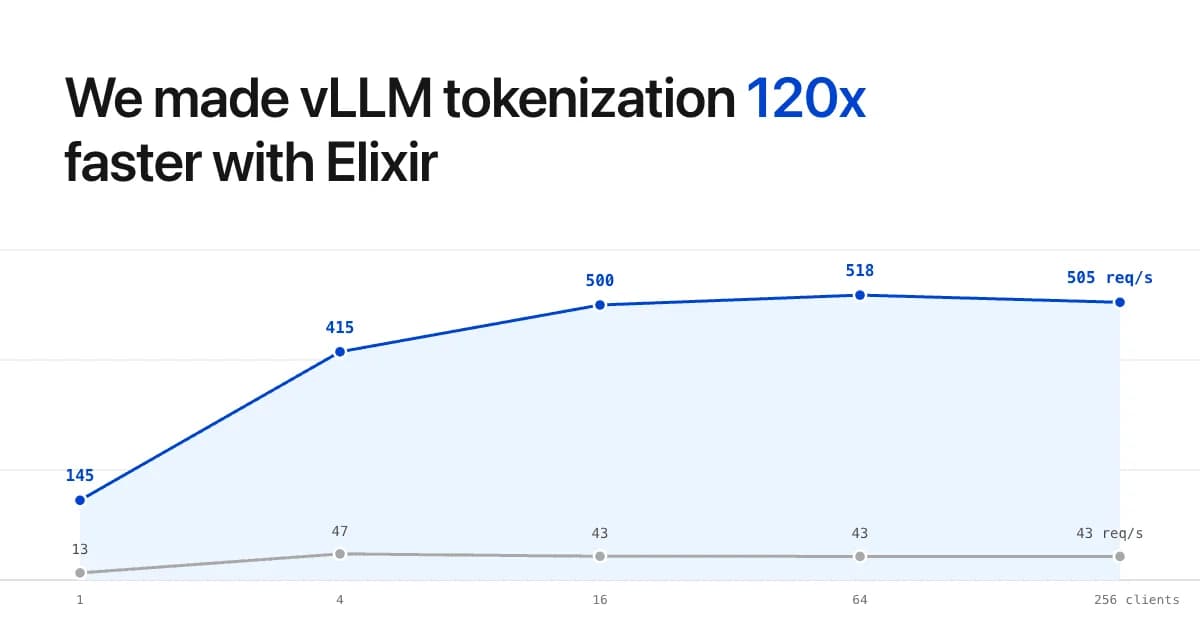
Мы потратили месяцы на инвестиции в наш стек маршрутизации инференса, сделав ставку на кастомный маршрутизатор запросов, написанный на Elixir. Это первая статья из серии публикаций в блоге, посвященных нашему прогрессу и опыту масштабирования до триллионов токенов в день. Этот пост посвящен токенизаторам и тому, как нам удалось ускорить токенизацию в SGLang в 33 раза, а в vLLM — в 12 раз исключительно за счет оптимизации.
Почему токенизация вообще важна?
При обработке запроса на инференс до получения первого выходного токена происходит 4 основных этапа: токенизация, маршрутизация, префилл (prefill) и декодирование.
Наш уровень маршрутизации принимает решения на основе длины контекста ввода. Чтобы узнать длину ввода, необходимо его токенизировать или использовать грубую оценку (например, один токен на четыре символа ввода). После маршрутизации запроса мы выполняем префилл и декодирование с помощью одного из популярных движков инференса с открытым исходным кодом. Все эти движки предоставляют возможность либо принимать запрос на завершение чата (chat completion), либо принимать сырые идентификаторы токенов (raw token IDs). Раньше мы полагались на то, что движки с открытым исходным кодом сами выполняют токенизацию, префилл и только затем начинают декодирование.
Наш уровень маршрутизации токенизирует запрос, чтобы получить оценку того, сколько токенов займет этот запрос. Движки инференса могут обрабатывать запросы быстрее, если ограничить длину контекста ввода, поэтому знание длины запроса позволяет направлять короткие запросы в «короткие пулы», которые обеспечивают прирост производительности по сравнению с пулами, настроенными на максимальную длину контекста модели. Токенизатор, который мы использовали для нашего продакшн-пути (hot path), — это (от Actual, Inc.) с той оговоркой, что он не обрабатывает шаблоны чата и написан на C, что не является родным для нашего стека маршрутизации и потребовало усилий для интеграции.
По мере масштабирования нагрузки за последние несколько месяцев мы исчерпали возможности движков с открытым исходным кодом и теперь используем внутренние форки как vLLM, так и SGLang с патчами для повышения эффективности. Мы по-прежнему сталкиваемся с фундаментальными ограничениями, поскольку их фронтенды написаны на Python — однопоточном интерпретируемом языке, что приводит к замедлениям, конкуренции за GIL (Global Interpreter Lock) и другим проблемам, которые влияют на TTFT (время до первого токена). Вместо отправки сырых JSON-запросов вы можете снизить накладные расходы на токенизацию, выполняемую в процессе Python, отправляя движкам сырые идентификаторы токенов!
Бенчмаркинг библиотек токенизации
Учитывая все это, мы создали ChatTokenizer, чтобы проверить, насколько лучше мы можем сделать!
Приведенные здесь графики получены в результате нашего внутреннего бенчмарка библиотек токенизации с открытым исходным кодом и оценки их производительности на различных полезных нагрузках и вычислительных ресурсах. Наша методология приведена в приложении в конце этого поста.
Наша цель при проведении бенчмарков заключалась в следующем:
- Как токенизация меняется в зависимости от размера полезной нагрузки? Подтверждает ли это нашу гипотезу о том, что диалоги с большим контекстом вызывают значительные задержки?
- Каковы лучшие готовые варианты?
Из графиков видно, что сами по себе vLLM и SGLang отнюдь не являются самыми эффективными токенизаторами. SGLang поставляется со своим собственным шлюзом, написанным на Rust, который является одним из лучших вариантов (с оговоркой: он не токенизирует изображения). Осознав недостатки и низкую производительность вариантов с открытым исходным кодом, стало очевидно, что пора поднимать планку.
Что делает наш инструмент быстрее?
Мы являемся сторонниками Elixir и BEAM и используем их в продакшене с декабря прошлого года для нашего маршрутизатора. Платформа Open Telecom Platform (OTP) от Ericsson стала фундаментальной причиной того, как нам удалось масштабироваться до сотен миллионов ежедневных запросов. Тем не менее, она недостаточно быстра, чтобы превзойти другие токенизаторы из этого списка, поэтому мы решили задействовать Native Implemented Functions (NIFs), что позволило нам использовать Rust, C и ассемблер в рамках дерева надзора BEAM.
Ядром нашего токенизатора по-прежнему является toks от Actual, который использует оптимизированный ассемблер для генерации идентификаторов токенов, полностью совпадающих с токенизаторами Hugging Face, но работающих в 13–151 раз быстрее! Однако toks пока не поддерживает рендеринг шаблонов чата и изображений, а также некоторые другие функции, которые нам требовались внутри компании. Это побудило нас создать вокруг него вспомогательную библиотеку на Rust и Elixir для поддержки этих и других возможностей.
elixir
Основные улучшения
Каждое из улучшений, описанных ниже, более подробно рассматривается далее в статье, но чтобы текст не получился слишком длинным, вот краткие выжимки (tl;dr) некоторых крупных улучшений, которые мы сделали.
- Шаблоны чата Deepseek v4.1 Flash и Kimi K3.1 Pro были портированы на чистый Rust, при этом код на Jinja/Python сохранен в качестве эталона и проверен модульными тестами.
- Квадратичный цикл в энкодерах Deepseek был удален, а повторяющиеся фрагменты шаблонов Kimi мемоизировались в рамках одного запроса.
- Идентификаторы токенов передаются из C/Rust в Elixir в виде бинарных данных (binary) из little-endian u32 вместо списка (list), чтобы избежать накладных расходов на передачу списков.
- Интерлайн-изображения base64 обнаруживаются с помощью SIMD-сканирования байтов и передаются в Rust как подбинарные данные (sub-binaries), указывающие на исходный запрос, вместо их копирования.
- Мы избегаем многократного парсинга всего тела JSON и вместо этого извлекаем только те поля, которые необходимы движку.
Чтение метаданных изображения вместо всего изображения
Трафик агентов полон изображений. Один запрос на 1 млн токенов с 8 встроенными изображениями представляет собой примерно 30 МБ JSON, и почти всё это — данные в формате base64. Наивный подход (который мы использовали изначально) заключается в том, чтобы распарсить всё тело запроса, скопировать каждую строку изображения, декодировать base64 и открыть изображение просто для того, чтобы узнать его размер, поскольку это всё, что на самом деле нужно знать движку для определения количества вставляемых токенов-заполнителей изображения.
Поэтому мы перестали это делать:
- Перед парсингом чего-либо мы выполняем SIMD-сканирование байтов (memchr) по сырому запросу в поисках строк вида data: длиной более 4 КиБ.
- Каждое изображение попадает в Rust в виде суббинарных данных (sub-binary), что является способом BEAM указывать на исходный бинарный файл запроса, а не копировать его. В JSON мы заменяем изображение крошечным маркером (data:x-chat-tokenizer-ref,0), благодаря чему запрос размером 30 МБ парсится как несколько мегабайт текста, какими они и являются на самом деле.
- Мы считываем ширину и высоту прямо из заголовка PNG/GIF/WebP/JPEG, пока он все еще находится в base64, не декодируя ни единого пикселя (и применяем ориентацию EXIF там, где это делает движок).
- Собственные правила изменения размера модели (Deepseek v4.1, Kimi K3, Qwen-VL и др.) преобразуют этот размер в точное количество токенов изображения, которое сгенерировал бы движок.
Это позволило нам увеличить скорость с 22,5 до 167 запросов в секунду на запросах размером в миллион токенов, а время обработки одного запроса на одном ядре сократилось с 240 мс до 28 мс. Для сравнения, собственная предобработка в vLLM и SGLang обеспечивает 1,3 и 1,6 запроса в секунду на тех же запросах, занимая примерно по 2–3 секунды каждый.
Парсите только тот JSON, который вам нужен
Другая вещь, которая нас удивила, — это то, сколько времени уходило просто на чтение запроса с последующим отбрасыванием большей его части;
- serde_json проверяет UTF-8 для каждой строки с помощью скалярного цикла, на что уходила примерно десятая часть всего запроса чата. Мы выполняем одну SIMD-проверку UTF-8 для всего тела запроса заранее, а затем парсим его как уже проверенную строку.
- Запросы чата в основном представляют собой крошечные объекты (сообщение, часть содержимого, вызов инструмента) с небольшим количеством ключей. Хешировать каждый ключ — это избыточно, поэтому для всего, что содержит 8 или меньше ключей, мы просто сканируем их.
- Мы извлекаем только те поля, которые читает движок, и применяем собственные правила запросов движка (например, то, как vLLM предварительно парсит аргументы вызова инструментов) на Rust, поэтому тело запроса никогда не парсится дважды и не сериализуется повторно.
- Текст, поступающий в toks, проходит такую же SIMD-проверку UTF-8. Стандартная библиотека работала со скоростью около 3 ГБ/с на промптах с преобладанием CJK, что составляло пятую часть всего времени кодирования в toks.
Не все сработало. Мы пробовали параллельный парсинг JSON и параллельный рендеринг шаблонов и в итоге отказались от обоих вариантов. Пробуждение потоков стоило дороже, чем сэкономленная ими работа.
Под нагрузкой
Измерять пропускную способность — это здорово, и вы всегда можете сделать так, чтобы ваши цифры выглядели в несколько раз выше, чем они будут на самом деле в продакшене. В рамках создания нашей библиотеки мы протестировали, как растет «длинный хвост» под нагрузкой, задаваясь вопросом: по мере того как обслуживающий экземпляр становится более загруженным, насколько медленными становятся медленные запросы?
Для промптов размером от 8K до 160K токенов на обеих моделях наше значение p99 ниже медианы шлюза SGLang. Для Deepseek при размере около 37K токенов наш p99 составляет 2,6 мс, в то время как их p50 равен 2,9 мс (а их p99 составляет 15,9 мс). Это стало возможным благодаря тому, что NIF запускаются на планировщиках dirty CPU, запрос на миллион токенов никогда не стопорит остальную часть BEAM, а роутер может продолжать маршрутизацию, пока токенизатор обрабатывает крупные или многочисленные запросы.
Как это соотносится с движками?
Мы взяли собственную предварительную обработку запросов vLLM и SGLang (применение шаблона чата, парсинг тела и последующую генерацию токенов) и провели бенчмарк внутри процесса по сравнению с нашим решением.
Мы оказались в 53–181 раз быстрее для любого размера на обеих моделях. Теперь, когда мы отправляем сырые ID токенов вместо сырого JSON в движки инференса, мы хотели оценить влияние этого на движки инференса.
Отправка ID увеличивает показатели SGLang с 31 до 1031 запр/с (в 33 раза), а vLLM — с 43 до 505 запр/с (в 12 раз). При отправке сырого чата каждый процесс API-сервера упирается в потолок примерно на одном ядре, поскольку токенизация выполняется на Python под GIL этого процесса. Запуск 4 процессов увеличивает производительность vLLM всего с 13 до 43 запр/с на машине с 8 vCPU, в то время как отправка наших ID позволяет тем же 4 процессам достичь 505. Это то самое изменение на критическом пути из начала статьи: мы выполняем токенизацию один раз в роутере, и после этого движку инференса больше никогда не нужно делать это снова.
Точность токенизации
Ключевым требованием к нашему токенизатору является идентичность вывода с движками. Если отправленные нами ID токенов не будут точно соответствовать тому, что движок сгенерировал бы из сырого чата, модель увидит промпт, отличный от отправленного пользователем, что может привести к странному поведению модели — когда мы углубились в этот вопрос, оказалось, что большинство токенизаторов вне самих движков не обеспечивают этого!
Сложность заключается в том, что токенизация — это не просто прогон текста через токенизатор. Каждый движок сначала рендерит шаблон чата и применяет собственные правила запросов; у каждого движка есть свои странные особенности, которые создают немного другие токены. vLLM, например, парсит аргументы вызова инструментов и сериализует их заново, поэтому JSON, который видит модель, не совпадает байт-в-байт с тем, что отправил клиент. Именно поэтому мы выполняем токенизацию по-разному в зависимости от движка, которому отправляем запрос, гарантируя правильность токенов для этого движка.
В каждом бенчмарке мы также сравнивали токены с токенами vLLM, и в 100% запросов, при любом размере промпта и на обеих моделях наши результаты совпадали 1 в 1. Другие показывают хорошие результаты на коротких чатах, но начинают расходиться, когда в запросах появляются вызовы инструментов и более длинные беседы. При размере около 8K токенов шлюз SGLang совпал только в 16% запросов (что было ожидаемо, так как SGLang рендерит шаблон иначе, чем vLLM), NVIDIA Dynamo — в 73%, а HF transformers — в 96%. При размере около 1M токенов с изображениями все остальные библиотеки совпали в 0% случаев, а на Kimi K3.1 HF transformers рендерит совершенно не тот промпт, так как игнорирует reasoning_effort.
Дополнительные сравнения токенизаторов
Baseten написали в блоге о том, как они ускорили токенизацию Kimi с помощью своей библиотеки, , поэтому мы хотели сравнить обе библиотеки на Kimi K3.1. Их токенизатор на Rust не умеет рендерить шаблоны чата Kimi, поэтому в продакшене рендеринг выполняется на Python, а кодирование — на Rust. Чтобы всё было честно, мы сравнили только шаг кодирования на их собственном API, причем обе библиотеки кодировали абсолютно одинаковые предварительно отрендеренные сегменты Kimi K3.1.
С 8 воркерами мы работаем в 1,9–5,7 раза быстрее их самой быстрой настройки при размере от примерно 200 до примерно 1,1 млн токенов.
Агентские рабочие нагрузки и кэширование
Большая часть нашего трафика связана с агентами, которые при каждом шаге отправляют всю беседу заново. Поэтому мы воспроизвели 8 агентских бесед по 213 шагов каждая, с размером от 2K до 160K токенов на шаг.
Кэш сегментов адресуется по содержимому и является общим для всех процессов BEAM, поэтому после того, как кусок беседы был закодирован, он больше никогда не кодируется заново. Примерно после 30-го шага 98–99% токенов берутся напрямую из кэша. Прирост составляет «всего» 1,2–1.8x, потому что даже для полностью закэшированного шага все равно требуется распарсить запрос и отрендерить всю беседу целиком, и этот объем растет с каждым шагом, что по-прежнему остается узким местом, которое мы хотим решить!
Что дальше?
Отправка ID токенов увеличила показатели SGLang с 31 до 1031 запр/с, а vLLM — с 43 до 505 запр/с на длинных промптах, а ChatTokenizer работает в 53–181 раз быстрее собственной предварительной обработки движков, при этом точно совпадая с их ID.
Это первая статья в серии, и в следующей мы хотим рассказать о том, как запускать 10 000+ одновременных веб-сокетов для наших GPU-воркеров с горстки узлов Elixir, как мы маршрутизируем запросы инференса между движками и пулами, и что мы узнали об увеличении количества попаданий в префиксный кэш.
Если такая работа кажется вам интересной, мы нанимаем сотрудников в инженерный отдел. Приходите работать к нам! (если нет подходящей вакансии, напишите мне на email или в личку).
Приложение 1: Методология бенчмарка
Все тесты выполнялись на CoreWeave, на одном узле Xeon 8562Y+ с 8 эксклюзивными vCPU на запуск. Каждая библиотека запускалась на одном и том же узле друг за другом с холодными кэшами, и каждое число представляет собой медиану двух 10-секундных прогонов после 3-секундного прогрева. Запросы взяты из WildChat, наборов glaive function-calling и траекторий SWE-agent для зафиксированных коммитов, разбитых по бакетам в зависимости от размера промпта (XS ~140 токенов, S ~1,4K, M ~8K, L ~37K, XL ~160K, XXL ~1M плюс 8 изображений).
Версии: vLLM 21d9da46b3, SGLang 31e55a5120, basetenkenizer 0.2.9, dynamo-llm 1.6.2, Kimi K3.1 Pro на коммите 6d0a020.
- На каждом графике представлена Deepseek v4.1 или Kimi K3.1, как указано подписи, с 8 vCPU.
- ChatTokenizer, шлюз SGLang, Baseten (basetenkenizer 0.2.9), NVIDIA Dynamo и HF transformers запускались друг за другом на одной и той же машине.
- vLLM и SGLang измерялись по их собственной внутренней предварительной обработке запросов в отдельном сеансе в другом регионе CoreWeave.
- vllm-rs не имеет режима работы внутри процесса, поэтому он измерялся по протоколу HTTP при 256 одновременных клиентах, что включает накладные расходы HTTP, которых нет у остальных.
- Наши результаты совпали с идентификаторами vLLM для 100% запросов. Исключения для остальных: шлюз SGLang совпал на 98% при ~140 токенах, на 87% при ~1,4K, на 16% при ~8K и на 0% при ~1M (он пропускает развертывание изображений); Baseten и HF transformers — на 96% при ~8K; NVIDIA Dynamo — на 73% при ~8K. Все остальное совпало на 100%. Запросы с несовпадениями все равно учитываются при расчете их пропускной способности.
- На Kimi K3.1 «Baseten» — это их рабочий путь для K3 (пайтон-рендерер модели плюс энкодер basetenkenizer), поскольку одна лишь библиотека на Rust не может рендерить чаты Kimi. NVIDIA Dynamo не может загрузить Kimi K3.1, а HF transformers формирует для него некорректный промпт (игнорирует reasoning_effort).
- HF transformers означает применение apply_chat_template на Python с последующей токенизацией.
- Во всех графиках используются линейные шкалы. Там, где значения охватывают несколько порядков, каждый размер промпта (или движок) получает собственную ось, поэтому сравнивайте высоту столбцов внутри одной панели, а не между панелями.
Приложение 2: Ускорение токенизации в vLLM и SGLang
Показатель 120x в заголовке относится к Deepseek v4.1 при ~1 млн токенов с 8 встроенными изображениями, где наш токенайзер выполняет 162 запр/с по сравнению с собственной предварительной обработкой vLLM со скоростью 1,35 запр/с. Ниже приведены данные для каждого размера промпта на обеих моделях, чтобы вы могли увидеть весь диапазон. Все значения указаны в запр/с с 8 vCPU, внутри процесса, с использованием собственной предварительной обработки запросов vLLM и SGLang (рендеринг шаблона чата плюс токенизация) для версий, указанных выше. Для каждого размера мы в 61–181 раз быстрее vLLM и в 53–112 раз быстрее SGLang, причем большинство значений находится в диапазоне около 90–120x.