Аналитика для пользователей может привести к тому, что приложения перерастут базу данных MySQL или PostgreSQL задолго до того, как это произойдет с остальной частью приложения, особенно по мере роста числа пользователей и объемов данных. Обе базы данных предоставляют разработчикам привычный и простой путь от прототипа к производственной среде и могут годами обслуживать транзакционные рабочие нагрузки.
По мере того как команды добавляют отчетность в реальном времени, поиск, рекомендации и другие функции, требующие интенсивной работы с данными, аналитические запросы в сочетании с транзакциями доводят параллелизм до предела. Растущие объемы данных и параллельное использование могут затруднить поддержание высокой скорости отклика.
Команды могут предоставить приложениям возможность масштабирования, перейдя на распределенную SQL-базу данных. Но делать это за один подход сложно и рискованно. Большинство пользователей предпочитают постепенный путь, который позволяет им масштабироваться, снижая при этом риски.
Постепенный перенос приложения требует отдельной копии данных, которая остается актуальной, пока приложение продолжает выполнять запись в исходную базу данных. Захват изменений данных (CDC) поддерживает эту копию в актуальном состоянии, отслеживая вставки, обновления и удаления в исходной базе данных.
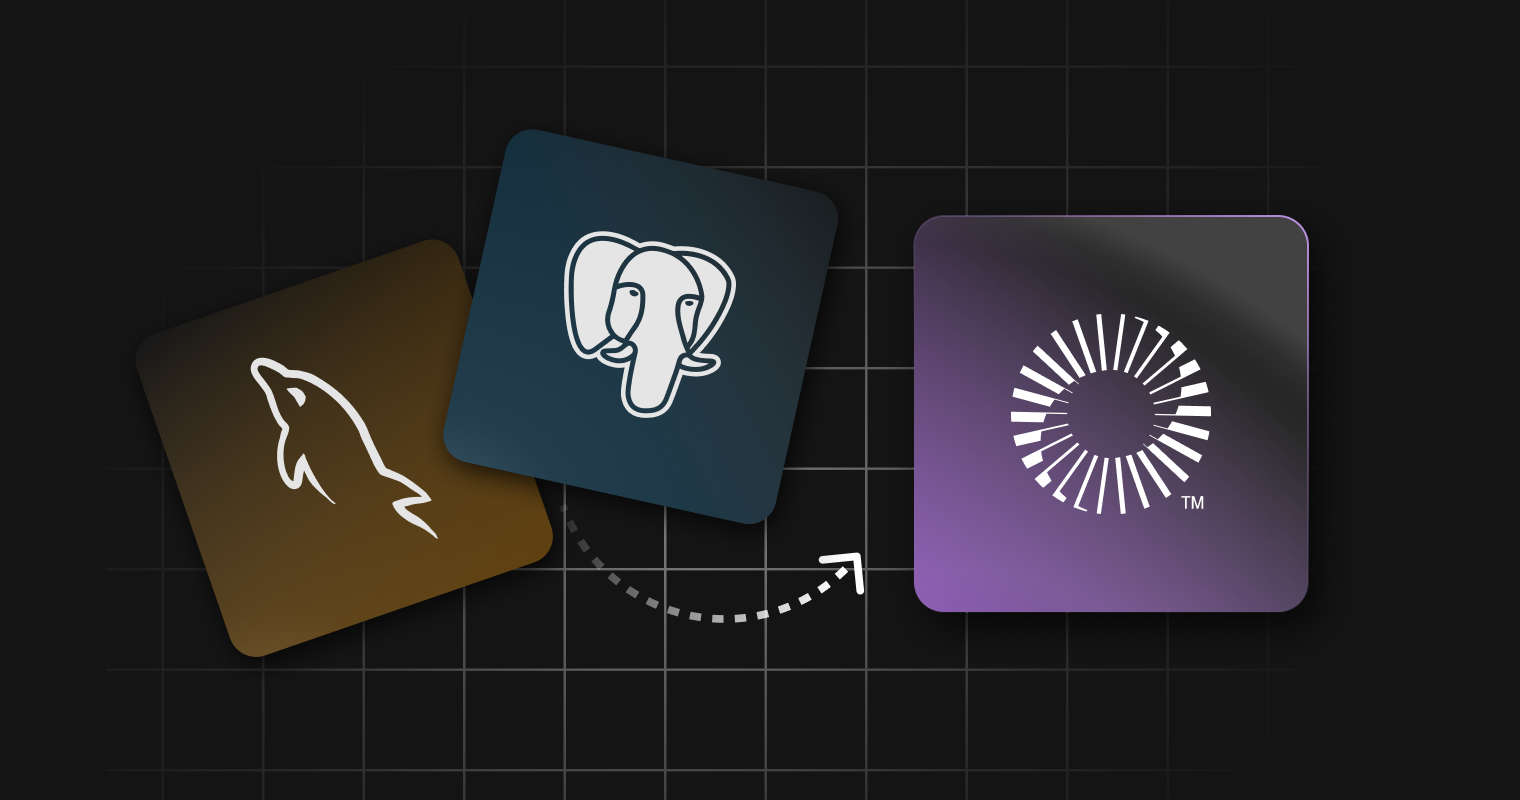
SingleStore Flow использует CDC для непрерывной репликации этих изменений из MySQL или PostgreSQL в SingleStore Helios. Затем разработчики могут постепенно переносить аналитические части своей рабочей нагрузки в Helios, снижая нагрузку на исходную базу данных, пока их существующие приложения продолжают работать.
Проблема роста приложения
Платформе безопасности может потребоваться поиск и агрегация миллионов событий в условиях непрерывного поступления новых событий. Финтех-приложению может потребоваться объединение транзакционных данных с анализом рисков или счетов в реальном времени. Приложению для наблюдаемости может потребоваться прием телеметрии в больших объемах, позволяя пользователям интерактивно фильтровать и агрегировать недавние события. SaaS-платформа может предоставлять аналитику использования, сегментацию и отчетность прямо внутри своего продукта.
Эти рабочие нагрузки создают сложную комбинацию требований:
- Высокая пропускная способность записи из операционного приложения
- Увеличение объемов данных
- Высокий уровень параллелизма по мере роста клиентской базы
- Низкая задержка точечных поисковых запросов
- Агрегации и соединения (JOIN) по крупным наборам данных
- Свежие результаты по данным, которые могли поступить секунды или миллисекунды назад
- Предсказуемое время отклика приложения по мере роста нагрузки
Разработчики могут какое-то время справляться с этим. Они добавляют индексы, уровни кэширования, реплики для чтения, предварительно вычисленные таблицы, фоновые задания или отдельные аналитические базы данных. Но в какой-то момент вопрос сводится не столько к оптимизации еще одного запроса, сколько к тому, соответствует ли архитектура базы данных текущей рабочей нагрузке.
CDC превращает миграцию в постепенное изменение приложения
Распределенный SQL распределяет хранение и обработку запросов по нескольким узлам, предоставляя ресурсоемким рабочим нагрузкам пространство для масштабирования. Внедрение такого решения может потребовать перемещения больших наборов данных во время продолжения операций записи, проверки совместимости приложения, тестирования производительности и координации перехода в производство. Захват изменений данных (CDC) позволяет командам осуществлять этот переход постепенно, поддерживая синхронизацию второй базы данных с исходной во время тестирования и переноса отдельных рабочих нагрузок.
С помощью SingleStore Flow разработчики могут создавать управляемые CDC-конвейеры из таких баз данных, как MySQL и PostgreSQL, в SingleStore Helios. Миграция может происходить в то время, когда существующее приложение продолжает работать с текущей базой данных.
Процесс выглядит примерно так:
MySQL / PostgreSQL → Конвейер CDC → SingleStore Helios → Рабочая нагрузка приложения
Flow выполняет начальную синхронизацию существующих данных, а затем продолжает обрабатывать изменения из исходной базы данных. Новые транзакции, записанные приложением, распространяются в SingleStore без необходимости для разработчиков создавать и обслуживать собственную инфраструктуру репликации.
Вместо:
мигрировать базу данных → изменить приложение → переключиться → надеяться, что все работает
команды могут использовать прогрессивный подход:
реплицировать данные → проверить рабочую нагрузку → перенести запросы → измерить производительность → расширить внедрение
Это позволяет разработчикам внедрять SingleStore на уровне рабочих нагрузок, а не переносить все приложение целиком за один раз.
Начните с рабочих нагрузок, требующих масштабирования
Это особенно полезно для приложений, которые переросли MySQL или PostgreSQL в отношении конкретных функций, интенсивно использующих данные, но еще не готовы полностью заменить свою операционную базу данных. Например, команда приложения может сохранить транзакционную запись в PostgreSQL, одновременно перенеся аналитические запросы, ориентированные на клиентов, в SingleStore.
Архитектура приложения принимает следующий вид:
Запись в приложение → PostgreSQL
PostgreSQL → CDC → SingleStore
Запросы аналитического приложения → SingleStore
Затем разработчики могут перенести запросы туда, где распределенное выполнение дает наибольшие преимущества: крупные агрегации, высококонкурентная отчетность, оперативная аналитика, поиск или запросы, охватывающие большие объемы недавних и исторических данных.
Метрики производительности миграции
Недавние реальные внедрения демонстрируют возможности высокой пропускной способности SingleStore Flow для крупномасштабных наборов данных и различных исходных движков:
- Мигрировано 600 ГБ данных MySQL за 3 часа.
- Мигрировано 1,5 ТБ данных Postgres менее чем за 2 часа.
- Мигрировано 75 ТБ данных MySQL по 4 000 таблиц за неделю.
Существующий путь транзакций не обязательно менять в первый же день. После того как рабочая нагрузка будет проверена, команда может решить, должен ли SingleStore оставаться уровнем аналитического обслуживания или следует перенести дополнительные рабочие нагрузки приложения. Это снижает как технические, так и организационные риски.
SingleStore поддерживает протокол подключения MySQL, позволяя командам использовать множество существующих драйверов, ORM и инструментов баз данных, совместимых с MySQL.
Избегайте создания еще одной платформы репликации
Команды могут создавать CDC-конвейеры с помощью таких инструментов, как Kafka и Debezium, но при этом они берут на себя ответственность за мониторинг репликации, восстановление после сбоев, обработку изменений схемы и масштабирование инфраструктуры по мере роста трафика.
SingleStore Flow — это служба приема данных CDC, интегрированная в Helios. Разработчики настраивают источник и назначение и создают конвейер без развертывания и эксплуатации отдельной инфраструктуры репликации.
Создавайте приложения реального времени, интенсивно использующие данные, а не просто более быстрые дашборды
Конечная цель заключается не просто в ускорении загрузки существующего дашборда. Она заключается в расширении возможностей приложения при работе с его операционными данными.
Как только команды приложений получают возможность запрашивать большие объемы свежих данных с низкой задержкой, они могут создавать продукты, которые сложно поддерживать с помощью традиционной архитектуры транзакционных баз данных.
Это может включать интерактивную клиентскую аналитику по миллиардам записей, расследование мошенничества или рисков в реальном времени, исследование событий безопасности, анализ наблюдаемости и телеметрии, измерение использования, операционный мониторинг, персонализацию, рекомендации в реальном времени или поиск по быстро меняющимся данным приложения.
Это не традиционные аналитические рабочие нагрузки, где данные копируются в хранилище и запрашиваются часами позже. Путь запроса является частью пользовательского интерфейса приложения, и пользователи ожидают, что результаты будут отражать то, что происходит прямо сейчас.
Это создает рабочую нагрузку, при которой транзакции, прием данных, поиск и аналитика все больше сближаются.
Распределенный SQL позволяет уровню данных масштабироваться вместе с этой рабочей нагрузкой, вместо того чтобы заставлять разработчиков распределять каждую новую функцию приложения по специализированным базам данных и конвейерам.