По мере того как системы ИИ становятся все более мощными, исследователи все чаще задаются практическим вопросом: может ли ИИ не просто помогать писать код для вычислительных систем? В частности, может ли он принимать активное участие в проектировании сложных вычислительных систем и быстро преобразовывать алгоритмы в кремний? Новые работы в области проектирования чипов на базе ИИ показывают, что ответ положителен. Но многообещающий алгоритм — это лишь начало разработки аппаратного обеспечения. Превращение его в эффективный чип требует поиска способов организации вычислений, перемещения данных и использования ограниченных аппаратных ресурсов. Каждый выбор открывает новые альтернативы. Каждая альтернатива требует инженерных усилий для реализации и оценки.
ИИ-агенты могут расширить этот поиск. Работая вместе, они могут предлагать архитектурные изменения, писать реализации, проверять корректность и использовать результаты синтеза для принятия решений о том, что попробовать в следующий раз. Препятствие заключается в стоимости: экономика токенов LLM для разработки аппаратного обеспечения и рентабельность исследования пространства проектирования. Одно поисковое исследование может потреблять сотни миллионов токенов, а применение этого подхода к множеству компонентов и вариантов дизайна может потребовать сотен таких исследований.
Новая демонстрация от IBM Research показывает, как открытые передовые модели и эффективный распределенный инференс могут изменить этот расчет. Используя фабрику агентов для оптимизации оборудования под квантовую коррекцию ошибок, исследователи достигли 52-кратного ускорения по сравнению с базовым проектом по оценкам высокоуровневого синтеза при затратах на инференс примерно в 26 долларов. При том же бюджете поиска конфигурация проприетарной передовой модели обошлась в 11,5 раз дороже, чем конфигурация, использующая открытые передовые модели на всех этапах — 299 долларов против 26 долларов соответственно. Проприетарная конфигурация обеспечила более высокое ускорение (204x), но конфигурация с открытой моделью продемонстрировала иной результат: существенной оптимизации аппаратного обеспечения можно добиться при гораздо меньшем бюджете на инференс, получив при этом самую компактную по площади конструкцию.
Это преимущество в стоимости создает возможность более широкого применения автоматизированного поиска и реинвестирования сэкономленных средств в поиск лучших проектов.
Результаты также показывают, что практическая ценность проектирования чипов с помощью ИИ зависит не только от наилучшего проекта, который может создать агент. Она также зависит от того, какой объем проверенного поиска организация может себе позволить. Возможности моделей, распределение ролей агентов и инфраструктура, обслуживающая эти модели, — все это определяет аппаратные улучшения, достижимые в рамках реального инженерного бюджета. Объединив открытые передовые модели с недорогим распределенным инференсом llm-d, компания IBM доказала, что фабрики ИИ-агентов могут выйти за рамки помощи в написании кода и стать активными участниками проектирования аппаратного обеспечения, причем делать это экономически эффективно.
От генерации кода к исследованию архитектур
Проектирование аппаратного обеспечения остается одной из самых трудоемких задач в вычислительной технике. Высокоуровневый синтез (HLS) повышает уровень абстракции с уровня регистровых трансфертов (RTL), используемого в языках описания аппаратного обеспечения, до C или C++, но инженерам по-прежнему приходится принимать бесчисленные решения о структуре циклов, параллелизме, организации памяти, потоках данных и директивах синтеза. Эти выборы взаимодействуют сложным образом. Например, одновременное выполнение большего числа вычислений помогает только в том случае, если система памяти может обеспечить подачу их входных данных. Дизайн, который работает быстрее, также может требовать больше аппаратных ресурсов. Поиск полезного баланса требует повторяющихся экспериментов, и пространство проектирования быстро становится слишком большим для исчерпывающего изучения человеком.
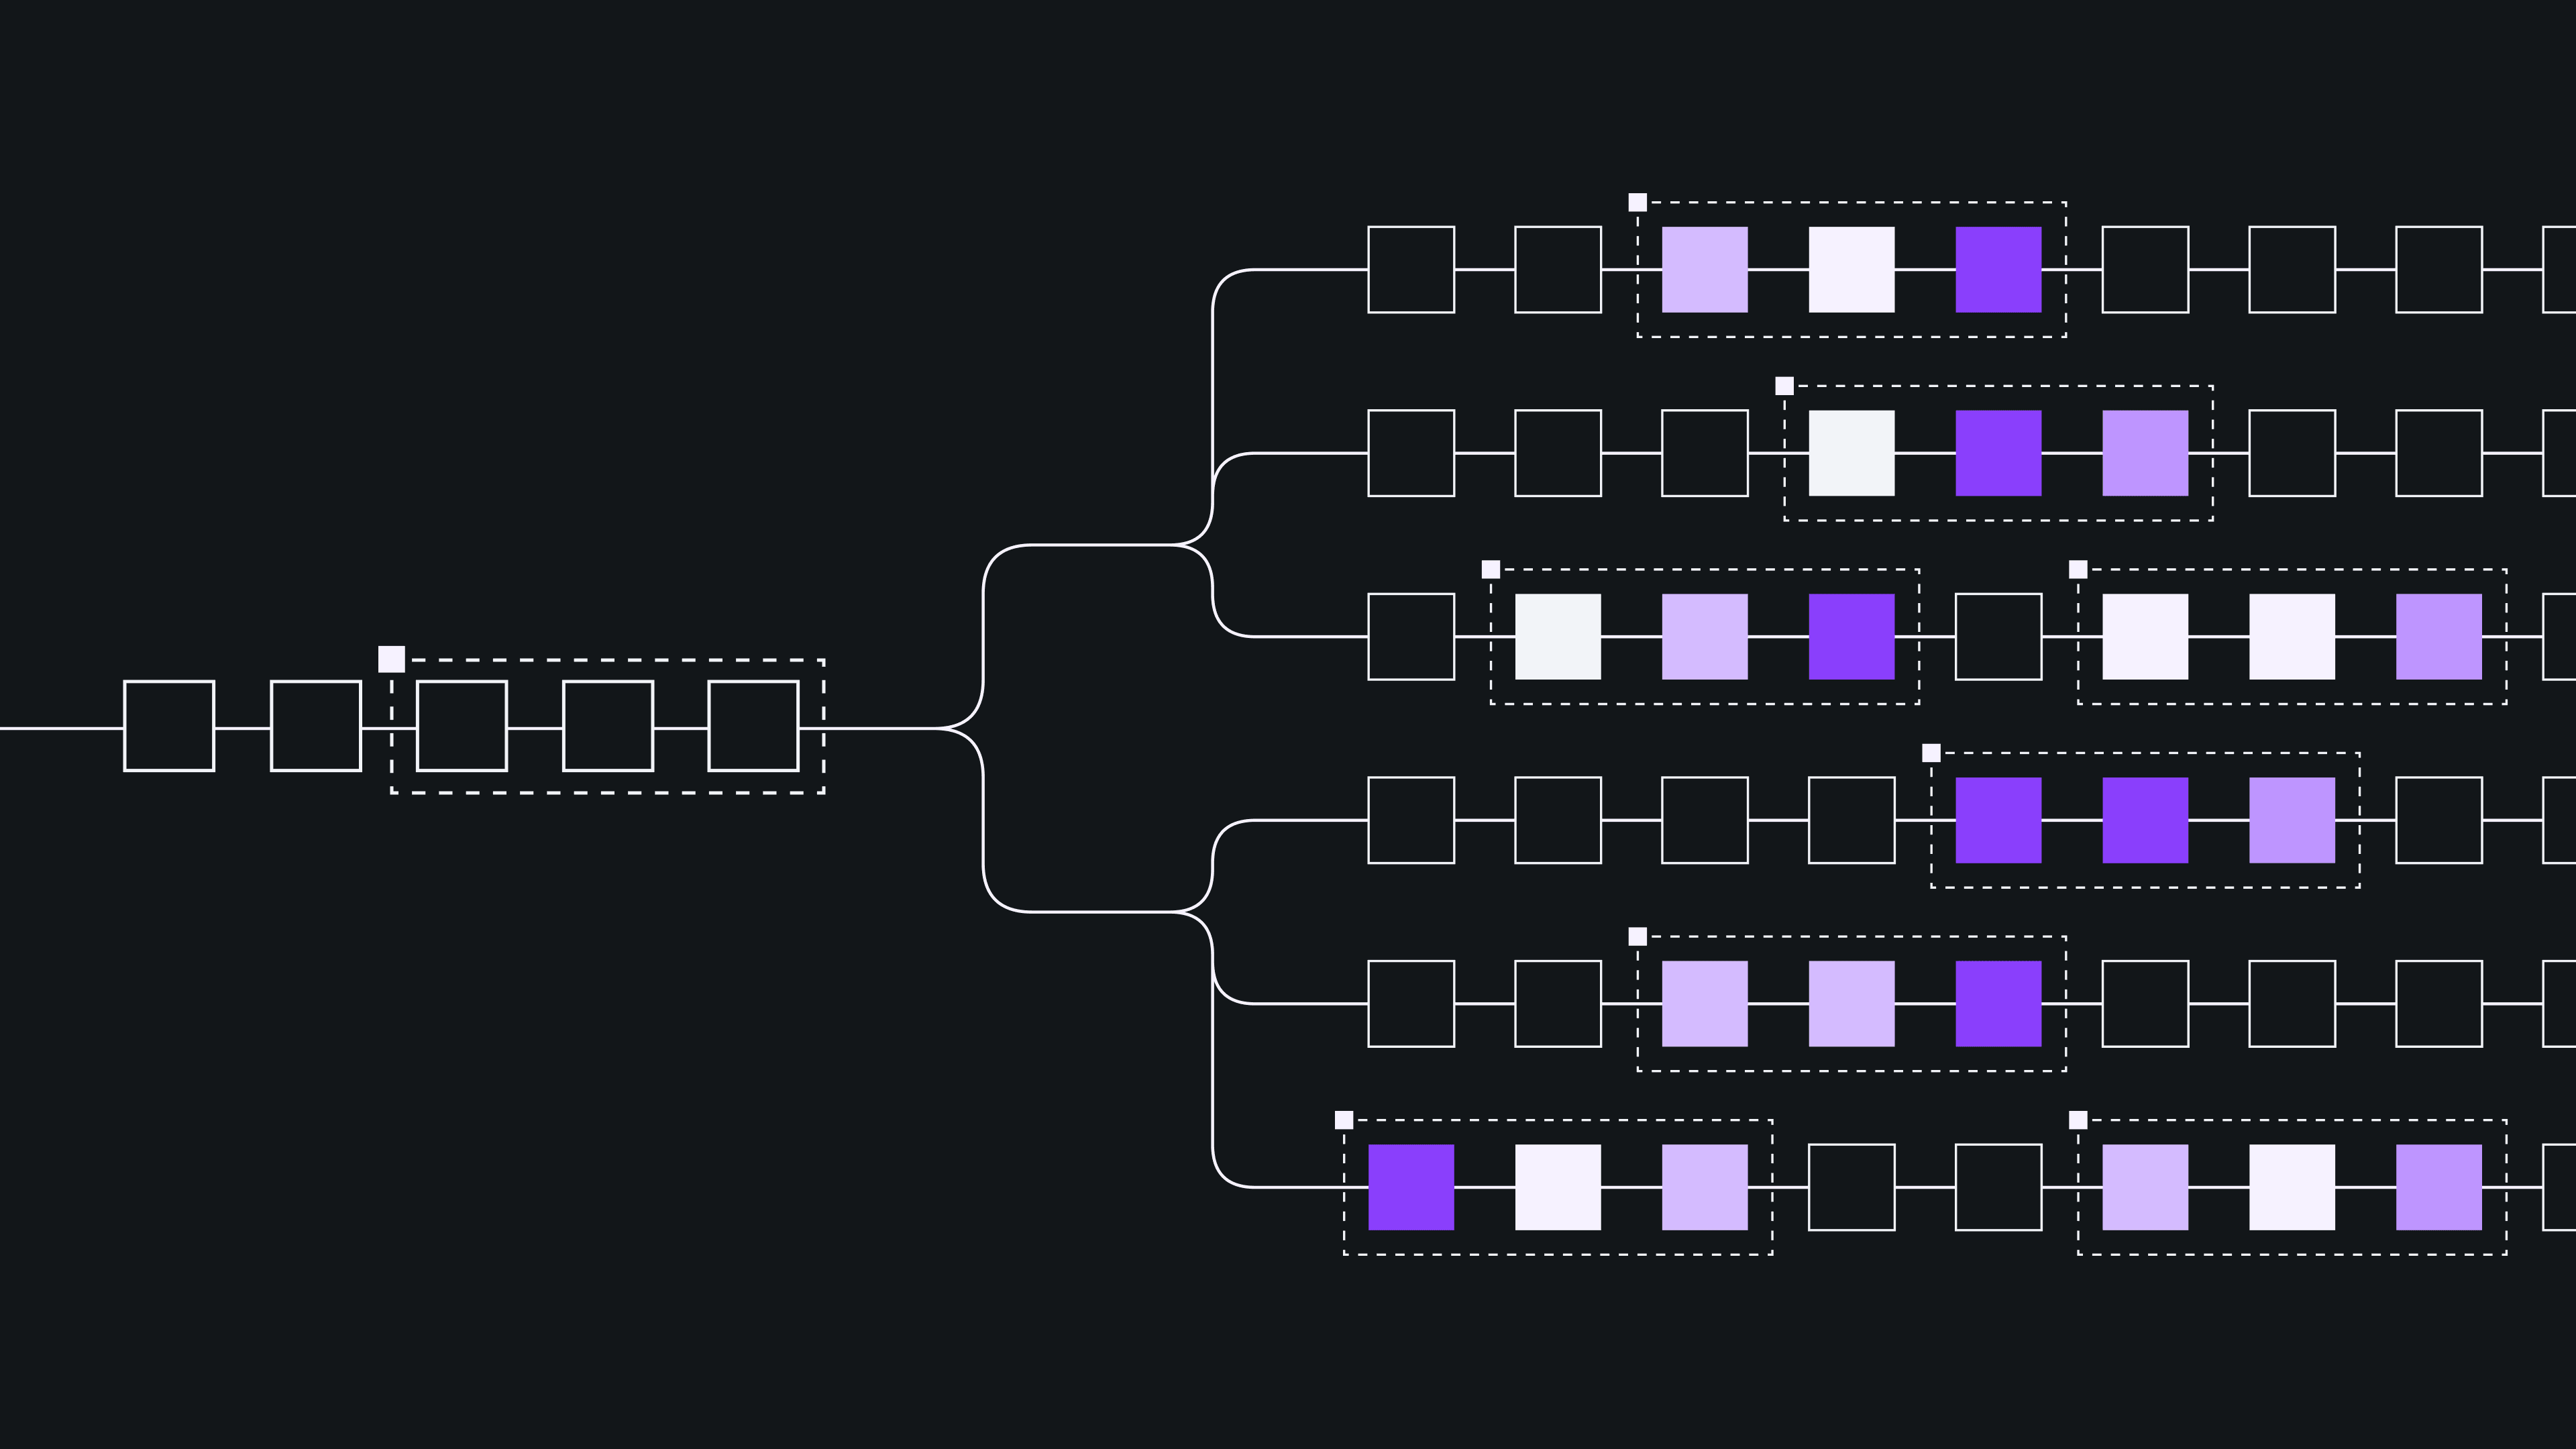
«Фабрика агентов» организует эту работу. «Фабрика агентов превращает аппаратную оптимизацию в скоординированный цикл исследования: агент-координатор направляет параллельных агентов-исполнителей на разработку и синтез альтернативных вариантов дизайна в рамках определенного бюджета поиска», — сказал Ручир Пури (Ruchir Puri), феллоу IBM и главный научный сотрудник IBM Research.
Когда эти агенты приступают к выполнению своей задачи, они независимо исследуют стратегии оптимизации. «Верификатор проверяет правильность предложенных улучшений, а проекты ранжируются по задержке и использованию аппаратных ресурсов. Эти результаты определяют следующий раунд исследований, позволяя фабрике уточнять поиск по мере обнаружения лучших проектов», — добавил Пури. Вместо поиска единственного решения фабрика исследует множество возможностей параллельно, используя обратную связь синтеза для направления дальнейших поисков.
В новом исследовании координатор планировал поиск и распределял гипотезы оптимизации между четырьмя параллельными агентами-исполнителями. Исполнители модифицировали реализацию декодера, а проверки корректности и результаты HLS обеспечивали обратную связь для последующих раундов. Каждая конфигурация получала бюджет из 100 гипотез.
Агенты исследовали изменения, имеющие архитектурные последствия. Одна из трансформаций реорганизовала хранение сообщений таким образом, чтобы инструмент синтеза мог идентифицировать независимые обращения к памяти и выполнять больше работы параллельно. Другая заменила последовательные сокращения древовидными структурами, которые обеспечивали параллельные вычисления. Ценность заключалась в связывании изменений кода с их аппаратными эффектами посредством многократной оценки.
Классическая аппаратная задача в основе квантовых вычислений
Ключевой вопрос, затронутый в новой статье, заключался в том, можно ли масштабировать этот подход с финансовой эффективностью, используя открытые передовые модели и инфраструктуру распределенного инференса. Для оценки этой идеи Пури и его команда продемонстрировали подход с использованием Relay-BP, алгоритма декодирования с квантовой коррекцией ошибок, для [[144,12,12]] двумерного велосипедного кода.
Квантовая коррекция ошибок опирается на классические вычисления. Измерения дают подсказки об ошибках, затрагивающих квантовую информацию, а декодер должен интерпретировать эти подсказки и сделать вывод об исправлениях. Быстрое выполнение этой задачи в пределах практических ограничений аппаратных ресурсов является важнейшей частью построения отказоустойчивых квантовых систем.
Relay-BP является полезным тестом, поскольку его повторяющаяся передача сообщений по своей сути параллельна, но разреженное представление графа и шаблоны доступа к памяти в базовой реализации затрудняют использование этого параллелизма инструментами HLS.
Это также делает декодер сложной проверкой аппаратного исследования на базе ИИ, поскольку агенты должны сохранять вычисления, одновременно изменяя то, как аппаратное обеспечение их выполняет.
Что дает один и тот же бюджет поиска
Исследователи сравнили три конфигурации при одинаковом бюджете в 100 гипотез: проприетарную передовую модель в качестве координатора и исполнителей, открытую передовую модель в обеих ролях и гибридную модель с проприетарным координатором и исполнителями на базе открытой модели. Открытая модель запускалась локально с помощью llm-d.
Все три варианта обнаружили проверенные аппаратные улучшения, но они привели к различным компромиссам. Открытый и гибридный поиск позволили найти полезные компактные проекты, в то время как проприетарная конфигурация более эффективно преобразовала дополнительные ресурсы в параллелизм и меньшую задержку. Каждая конфигурация оценивалась за один прогон поиска, поэтому эти результаты характеризуют наблюдаемый поиск, а не устанавливают универсальный рейтинг моделей.
Полнооткрытый поиск также потребовал больше токенов: примерно 241 миллион по сравнению с 216 миллионами для полнопроприетарного поиска. Его более низкая стоимость была обусловлена экономикой обработки этих токенов. Это различие имеет значение для фабрик агентов, где каждая гипотеза может включать множество раундов рассуждений, написания кода, отладки и интерпретации результатов работы инструментов.
Почему инфраструктура инференса имеет значение
Фабрика агентов многократно возвращается к одним и тем же данным: исходному коду, проектным ограничениям, предыдущим изменениям и отчетам о синтезе. Эффективная обработка позволяет повторно использовать вычисления, связанные с этим общим контекстом.
В исследовании использовался llm-d, открытый распределенный фреймворк инференса, для поддержки этой рабочей нагрузки. Его маршрутизация с учетом кэша направляет запросы на серверы, хранящие повторно используемый контекст. Она также отделяет обработку промптов от генерации токенов, позволяя системе выделять ресурсы для каждого процесса независимо. Эти возможности помогают сократить объем повторяющейся работы и эффективно использовать емкость ускорителей.
Поскольку предприятия стремятся обуздать растущие затраты на инференс и сохранить контроль над своими конфиденциальными данными, эта последняя демонстрация показала, что модели с открытыми весами, развернутые локально через стек распределенного инференса llm-d, могут значительно снизить затраты на обслуживание и при этом находить ценные аппаратные оптимизации.
Для рабочей нагрузки по проектированию чипов в документе сообщается о коэффициенте попадания в кэш префиксов примерно в 98% и усредненной стоимости обслуживания около $0,11 за миллион токенов. Развертывание обслуживало фабрику наряду с другими задачами агентов на общей инфраструктуре. Открытые весы также позволили команде запустить модель локально и сохранить контроль над проектными артефактами, обрабатываемыми этими агентами.
Таким образом, ценовое преимущество является результатом сочетания открытой модели и эффективной системы обслуживания. И то, и другое способствует тому, чтобы непрерывный поиск оставался финансово доступным.
Что дальше: превращение более низкой стоимости в лучший дизайн
Более низкая стоимость инференса создает пространство для дополнительного поиска, но увеличение затрат не обязательно приводит к пропорциональным улучшениям. Расширение полнооткрытой кампании со 100 до 200 гипотез увеличило ускорение с 52× до 60×. Прирост сохранился, но уменьшился.
Следующим шагом является улучшение использования этого дополнительного бюджета фабрикой агентов. В дальнейшей работе будет изучено адаптивное распределение ресурсов, более широкий спектр архитектурных гипотез и выборочное использование более мощных моделей для сложных преобразований или координации поиска. Цель состоит в том, чтобы осознанно маневрировать в рамках компромисса между стоимостью и качеством: определять, где дополнительные рассуждения, другая модель или новое архитектурное направление с наибольшей вероятностью улучшат проект.
Оценка также должна учитывать затраты на синтез и верификацию наряду с инференсом. Снижение затрат на одну часть рабочего процесса наиболее ценно тогда, когда весь процесс в целом может выдержать дополнительный объем исследований, который это открывает.
ИИ для проектирования чипов объединяет две формы прогресса в отношения взаимной поддержки: более совершенное железо делает возможным создание более способного ИИ, а более способный ИИ может помочь инженерам разрабатывать более совершенное железо. Рентабельные фабрики агентов делают эти отношения более практичными. Делая каждый поиск более доступным, открытые модели и распределенный инференс создают возможности для тестирования больших идей и, благодаря лучшим стратегий поиска, превращения этой возможности в лучшие чипы.