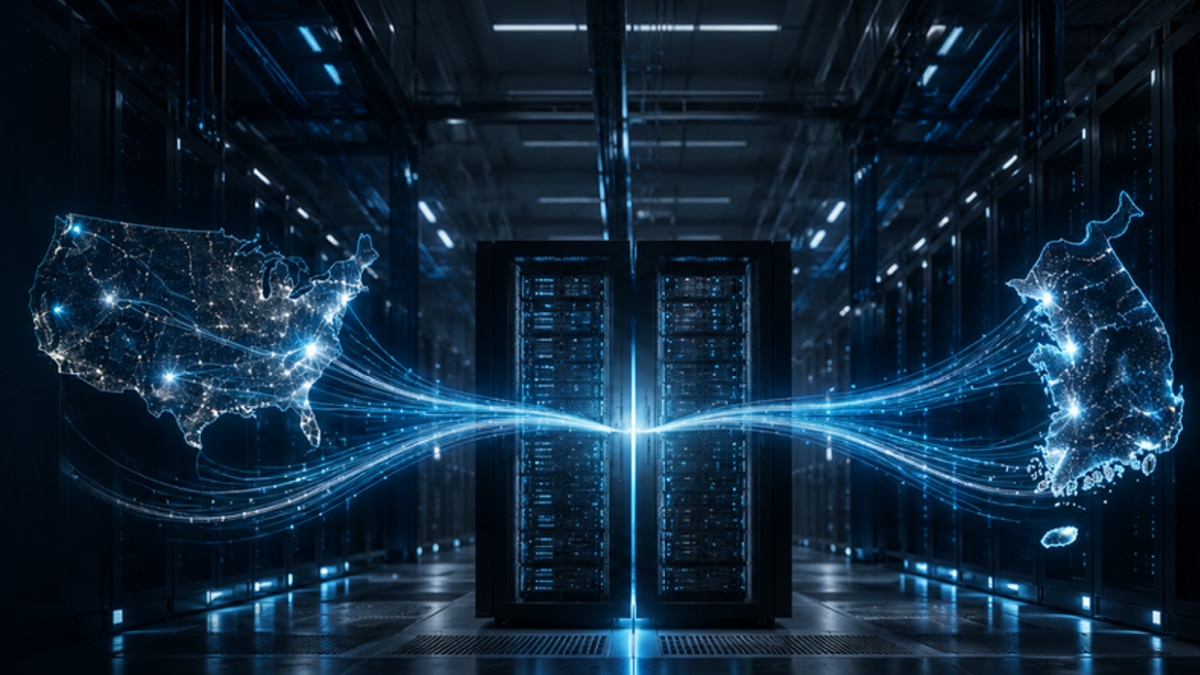
Представляем Mango Inference, новый бессерверный сервис логического вывода, который предоставляет готовый к промышленному использованию доступ к ведущим открытым моделям через привычные API и оплату по факту использования, с инфраструктурой на базе графических процессоров AMD Instinct™ и программного обеспечения AMD ROCm™.
Краткий обзор
Открытые модели приближаются по качеству к закрытым передовым моделям во многих корпоративных рабочих нагрузках. По мере сокращения разрыва в производительности организации уделяют больше внимания эффективности обслуживания, скорости развертывания, контролю затрат и выбору инфраструктуры.
Mango Inference — это новый бессерверный сервис логического вывода (LLM-as-a-service) от MangoBoost, который дает разработчикам доступ к растущему каталогу ведущих открытых моделей. Сервис сочетает в себе высокопроизводительный логический вывод с оплатой по факту использования и интуитивно понятной консолью управления с API, совместимыми с OpenAI и Anthropic. Он работает на графических процессорах AMD Instinct™ и программном обеспечении AMD ROCm™.
MangoBoost управляет вычислительными мощностями на базе графических процессоров AMD Instinct в Корее и США как единой средой обслуживания. Такой подход предоставляет клиентам доступ к открытым моделям через одну конечную точку, поддерживая при этом региональное хранение данных и снижение задержек при логическом выводе для пользователей в Корее и Азиатско-Тихоокеанском регионе.
Рисунок 1. Архитектура Mango Inference, конечная точка и мощности обслуживания AMD Instinct в Корее и США.
Готовый к промышленному использованию логический вывод открытых моделей
Mango Inference доступен как бессерверный сервис с оплатой за токен. MangoBoost управляет моделями, ускорителями и инфраструктурой центра обработки данных, позволяя командам разработчиков сосредоточиться на приложениях, а не на операциях по обслуживанию моделей.
Разработчики могут получать доступ к нескольким моделям через одну конечную точку и менять модели с помощью обновления конфигурации в одну строку. Стандартные API также упрощают внедрение сервиса или перенос рабочих нагрузок без перепроектирования интеграции приложений. На рисунке 2 показано, что получают разработчики с Mango Inference.
Рисунок 2. Что получают разработчики с Mango Inference.
Простая интеграция и экономика на основе использования
Привычные API. Сервис поддерживает клиентов, совместимых с OpenAI и Anthropic, а также агентов кодирования, включая Claude Code, OpenCode и OpenHands.
Готовые к работе возможности. Mango Inference поддерживает потоковую передачу, вызов инструментов, структурированные выходные данные и рассуждения. Стандартные ответы HTTPS, коды состояния, заголовки Retry-After и идентификаторы запросов интегрируются с существующей логикой повторных попыток и инструментами наблюдаемости.
Прозрачное потребление. Клиенты пополняют предоплаченные счета и платят за использование токенов. Каждый ответ содержит отчет о потреблении токенов, что дает командам прямое представление о расходах. Кэшированные входные данные оплачиваются отдельно по более низкой ставке, что может снизить затраты для агентских рабочих нагрузок, которые многократно отправляют длинные системные промпты.
Упрощенное подключение. Разработчики могут войти в систему, создать ключ API, протестировать модели и подключить приложения через единую консоль управления. Консоль предоставляет доступ к каталогу моделей, информации о длине контекста, доступности и элементам управления использованием. (Рисунок 3 ниже)
Рисунок 3. Mango Inference предлагает пользователям удобный процесс для начала работы и развертывания в своих приложениях.
Mango Inference также предлагает единую удобную консоль администратора (Рисунок 4), чтобы пользователи могли делать все необходимое для управления, отслеживания, тестирования и развертывания сервисов логического вывода.
Рисунок 4. Консоль Mango Inference, страница «Модели» с каталогом моделей, длиной контекста и доступностью.
Производительность, подтвержденная на графических процессорах AMD Instinct
MangoBoost применяет полностековую оптимизацию для обслуживания моделей, системного программного обеспечения, сетей и распределенной инфраструктуры. Работа компании с AMD демонстрирует этот опыт на протяжении четырех последовательных раундов MLPerf® Inference, отраслевого стандартного набора тестов от MLCommons.
- MLPerf Inference v5.0, апрель 2025 г. Четыре узла AMD Instinct MI300X обеспечили первый многоузловой результат MLPerf Inference на AMD Instinct и достигли примерно 103 000 токенов в секунду в тесте Llama 2 70B Offline, что стало самым высоким результатом на тот момент. (AMD, ROCm)
- MLPerf Inference v5.1, сентябрь 2025 г. Четыре узла MI300X и два узла MI325X обслуживали Llama 2 70B как единую систему со скоростью примерно 160 000 токенов в секунду и побили предыдущий рекорд, установленный в v5.0, создав первый кластер MLPerf, объединяющий поколения графических процессоров. (AMD)
- MLPerf Inference v6.0, апрель 2026 г. MangoBoost объединила мощности MI355X в США с системами MI300X и MI325X в Корее, чтобы создать первый многорегиональный кластер MLPerf, охватывающий три поколения графических процессоров, достигнув 95,5% эффективности масштабирования на Llama 2 70B на двух континентах. (AMD, ROCm)
- MLPerf Inference v6.1, сентябрь 2026 г. Развертывание 32 графических процессоров на четырех площадках и двух континентах обслуживало GPT-OSS-120B через одну конечную точку и достигло 97% эффективности масштабирования, что стало крупнейшим многорегиональным кластером, когда-либо представленным в MLPerf. (AMD, ROCm)
Для получения дополнительной информации об этих этапах обратитесь к https://mlcommons.org/benchmarks/.
Рисунок 5. Результаты MangoBoost MLPerf Inference на графических процессорах AMD Instinct. Цитаты из анонса MLPerf Inference v5.1 (MLCommons, Dell Technologies) и анонса MLPerf Inference v6.1 (AMD).
Оптимизации обслуживания, лежащие в основе этих результатов, включая дезагрегацию префилла/декодирования и гетерогенное планирование, встроены в Mango Inference. Подробные описания каждой заявки MLPerf, включая конфигурацию системы и методологию, по состоянию на сентябрь 2026 года доступны в блоге MangoBoost.
Выбор моделей с опциями суверенного ИИ
Mango Inference в настоящее время включает GLM-5.2, DeepSeek-V4 и MiniMax-M3. Внутренние процессы автоматизации и оптимизации разработаны для быстрого внедрения новых открытых моделей в инфраструктуру графических процессоров AMD Instinct по мере развития рынка.
Для программ суверенного ИИ выбор модели — это лишь часть требований. Организациям также нужна ясность в отношении того, где выполняется логический вывод, кто управляет инфраструктурой и как перемещаются конфиденциальные данные. MangoBoost управляет собственным центром обработки данных ИИ в Сеуле с мощностями графических процессоров AMD Instinct MI355X и MI350P. Таким образом, корейские клиенты могут запускать рабочие нагрузки на инфраструктуре, расположенной и управляемой внутри Кореи, наряду с доступом к глобальным мощностям обслуживания в США.
Общая конечная точка обеспечивает доступ к каждой модели в каталоге. Команды могут выбирать подходящую модель для каждой рабочей нагрузки без изменения интеграции приложения, поддерживая требования к хранению данных, языковые требования и более широкий выбор моделей.
Открытый производственный стек на базе AMD
Mango Inference построен на графических процессорах AMD Instinct и программной платформе с открытым исходным кодом AMD ROCm. Программное обеспечение ROCm предоставляет доступ к программному стеку, необходимому для оценки, оптимизации и развертывания рабочих нагрузок ИИ на инфраструктуре AMD. MangoBoost сочетает эту открытую основу со своей системной инженерией для эксплуатации производственного сервиса логического вывода, оптимизированного для производительности и масштабирования.
Результатом является открытый стек от модели до инфраструктуры: модели с открытыми весами, стандартные API, графические процессоры AMD Instinct и программное обеспечение ROCm. Эта гибкость может помочь предприятиям и программам суверенного ИИ уменьшить зависимость от одного закрытого поставщика моделей или инфраструктуры.
Начните работу с Mango Inference
Разработчики могут начать работу на inference.mangoboost.io, создав учетную запись и API-ключ, выбрав модель и подключив приложение, совместимое с OpenAI или Anthropic. В честь запуска новые учетные записи получают бесплатные кредиты для изучения каталога моделей и запуска своих первых рабочих нагрузок. MangoBoost также продемонстрирует сервис на SC26.
Для получения поддержки или запросов на добавление моделей пишите на support@mangoboost.io или используйте меню «Поддержка» в консоли Mango Inference.