Когда ИИ-модель отвечает на вопрос или выполняет задачу, она осуществляет инференс, то есть использует обученную модель для генерации ответа на основе входных данных. Однако делать это в больших масштабах гораздо сложнее, чем кажется. Запустить большую языковую модель на графическом процессоре — это одно. Обслуживать эту модель для тысяч или даже миллионов людей и ИИ-агентов одновременно — совсем другое.
Запросы поступают с разным приоритетом и разной длины, что предъявляет уникальные требования к вычислениям. Одни пользователи ждут немедленного ответа на простые вопросы, в то время как другие отправляют объемные задачи, которые могут выполняться в фоновом режиме. Трафик ИИ-агентов создает новый шаблон: агенты могут отправлять всплески связанных запросов, приостанавливать работу для вызова инструмента, а затем возвращаться с практически тем же контекстом. Между тем система должна эффективно использовать дорогостоящие ускорители, не создавая длинных очередей и не выполняя многократно одни и те же вычисления.
Эта задача напоминает управление воздушным движением. Загруженный аэропорт не может просто отправить каждый прибывающий самолет на первую доступную полосу. Диспетчеры в башне должны учитывать местоположение самолета, пункт назначения, размер и потребности в топливе, а также трафик, который уже движется в системе. Задача была бы простой, если бы все, что нужно диспетчерам воздушного движения, — это держать каждую взлетно-посадочную полосу занятой, но аэропорт — это не парковка, и к каждому самолету нельзя подходить одинаково.
Распределенный инференс выполняет аналогичную координирующую роль для инференса LLM, работая на уровне выше серверов моделей, таких как vLLM и SGLang, где он управляет реальным трафиком и оптимизирует его. В то время как эти серверы эффективно запускают модели на отдельных серверах, инфраструктура распределенного инференса координирует группы серверов моделей в кластере. Ее маршрутизатор может учитывать глубину очереди, доступность кэша и роли серверов, прежде чем принять решение о том, куда должен направиться запрос.
Чтобы понять, как работает распределенный инференс, мы рассмотрим шесть заметных технических инноваций: маршрутизацию с учетом кэша префиксов, выгрузку KV-кэша, управление потоком, оптимизацию пакетного инференса, дезагрегацию префилла/декодирования и широкое экспертное параллельное вычисление. Мы также увидим, как все это объединяется в llm-d, инфраструктуре инференса с открытым исходным кодом, созданной для Kubernetes.
- Маршрутизация с учетом кэша префиксов: отправка работы туда, где уже находится контекст
- Выгрузка KV-кэша: расширение рабочей памяти модели
- Управление потоком: определение того, что и когда перемещается
- Оптимизация пакетного инференса: заполнение свободных мощностей без перегрузки системы
- Дезагрегация префилла/декодирования: разделение двух разных типов работы
- Широкое экспертное параллельное вычисление: распределение гигантской модели по всему кластеру
- Координация всей системы инференса
Маршрутизация с учетом кэша префиксов: отправка работы туда, где уже находится контекст
Когда языковая модель читает промпт, она создает внутреннее представление слов и их взаимосвязей, сохраняя большую часть этого промежуточного состояния в кэше ключей-значений, или KV-кэше. Если последующий запрос начинается с того же текста или даже с частей того же текста, модель может повторно использовать эти сохраненные вычисления вместо повторной обработки общего текста. Например, если существующий промпт звучит как «Какова столица Канзаса?», а затем вы спрашиваете «Какова столица Калифорнии?», KV-кэш для части «какова столица» используется повторно.
Такая возможность часто возникает в реальных рабочих нагрузках. Чат-бот получает одни и те же системные инструкции в начале каждого разговора. Помощник по написанию кода неоднократно изучает один и тот же репозиторий. ИИ-агент может возвращаться к длинной записи предыдущих шагов при тестировании различных решений. В каждом случае большая часть промпта остается неизменной от шага к шагу.
Обычный балансировщик нагрузки может отправить следующий запрос на тот сервер, который кажется наименее загруженным, независимо от того, содержит ли его кэш соответствующий контекст. В результате модель вынуждена заново читать материал, который другой сервер уже обработал.
Маршрутизация с учетом кэша префиксов вместо этого задает два вопроса: какой сервер уже содержит наибольшую часть префикса этого промпта и у какого сервера достаточно емкости для обработки запроса? Маршрутизатор llm-d использует информацию о кэше и условия работы для оценки доступных серверов моделей и выбора подходящего назначения. Существует как приближенная реализация, включающая легковесный индекс недавних решений маршрутизации, так и точная реализация на основе фактических данных токенов и обновлений состояния кэша с серверов моделей.
Если у самолета пассажиры, багаж и наземный персонал уже ждут у одного выхода на посадку, отправка самолета к другому выходу приведет к ненужной работе. Точно так же система распределенного инференса пытается отправить запрос на тот сервер модели, который уже содержит необходимый контекст. Результатом являются меньший объем избыточных вычислений префилла, меньшая задержка и более высокая пропускная способность.
В недавней демонстрации команды разработчиков llm-d маршрутизация с учетом префиксов captured 97% of the available reuse в тестируемой рабочей нагрузке. Более того, этот метод особенно полезен для агентских систем, поскольку их запросы часто разделяют длинные инструкции, исходный материал, истории разговоров и результаты работы инструментов.
Проект llm-d был запущен в мае 2025 года в результате совместных усилий членов-основателей IBM Research, Red Hat, Google Cloud, NVIDIA и CoreWeave. Несколько партнеров-основателей также приняли участие с самого начала, включая лидеров индустрии AMD, Cisco, Hugging Face, Intel, Lambda и Mistral AI, а также академических сторонников из Калифорнийского университета в Беркли и Чикагского университета.
IBM Research, Red Hat и Google Cloud продолжают руководить разработкой llm-d и сегодня, а ее сообщество партнеров и контрибьюторов значительно выросло. В марте 2026 года основатели передали llm-d фонду Cloud Native Computing Foundation в качестве проекта-песочницы для продвижения миссии развертывания стеков инференса для любой модели, на любом ускорителе и в любом облаке.
Выгрузка KV-кэша: расширение рабочей памяти модели
Маршрутизация с учетом кэша наиболее ценна, когда кэшированная информация остается доступной. Проблема заключается в том, что хотя память ускорителя работает быстро, ее пространство может быстро заполниться длинными промптами, большим количеством одновременных пользователей и продолжительными сеансами работы агентов.
Когда свободное место заканчивается, сервер модели может вытеснить более старые записи KV-кэша. Если для последующего запроса этот материал понадобится снова, модель должна будет вычислить его заново, тратя циклы ускорителя на восстановление контекста, который существовал мгновением ранее.
Распределенный инференс решает эту проблему с помощью выгрузки KV-кэша. Вместо того чтобы рассматривать память ускорителя как единственное место, где может храниться кэшированный контекст, он выбирает цель выгрузки на основе требований рабочей нагрузки. Наиболее востребованные записи могут оставаться в памяти ускорителя с высокой пропускной способностью, в то время как другие записи могут перемещаться на более емкие, но более медленные уровни, такие как память ЦП, локальное твердотельное хранилище или общая файловая система. Индекс кэша отслеживает, что и где хранится, позволяя уровню маршрутизации учитывать выгруженные данные при принятии решений.
Извлечение кэшированной информации из памяти или хранилища процессора происходит медленнее, чем чтение напрямую из памяти ускорителя, но это гораздо быстрее и дешевле, чем повторное вычисление всего промпта. Таким образом, выгрузка расширяет эффективную емкость кэша системы за пределы физической памяти, доступной на ее ускорителях.
Это имеет наибольшее значение для рабочих нагрузок с длинными многократно используемыми контекстами и большим количеством одновременных сеансов. В той же демонстрации llm-d, упомянутой в предыдущем разделе, память GPU обеспечивала около 90–92% повторно используемых префиксных кэшей префилла для 128 параллельных запросов, а выгрузка на CPU помогала сохранять префиксы, превышающие емкость GPU. В другой демонстрации выгрузка на CPU помогла системе поддерживать высокую пропускную способность и низкое время до первого токена в рамках долгого бенчмарка, управляемого агентами. Поскольку выгрузка выполняется во время префилла, а запись в более медленные уровни происходит асинхронно, эти преимущества достигаются без замедления генерации токенов.
Управление потоком: определение того, что и когда перемещается
Маршрутизация ответов определяет, куда должен направиться запрос. Но в условиях нагрузки система также должна решать, какие запросы перемещаются первыми, а какие ждут. Когда внезапно поступает всплеск трафика, одинаковая обработка каждого запроса может привести к тому, что запрос, чувствительный к задержкам, застрянет за очередью задач с более низким приоритетом.
Диспетчеры воздушного движения сталкиваются с той же проблемой и решают ее с помощью управления потоками воздушного движения. Когда спрос превышает пропускную способность, они дозируют вылеты, упорядочивают прибытия и задерживают трафик с более низким приоритетом на земле, чтобы полностью заправленный авиалайнер на конечной прямой не задерживался из-за грузового рейса, который с тем же успехом мог бы подождать несколько минут.
Распределенный инференс требует такой же дисциплины. Управление потоками в llm-d регулирует прием и упорядочивание запросов по мере их поступления в систему, обеспечивая справедливость для пользователей и приоритетность для рабочих нагрузок. Интерактивный трафик, чувствительный к задержкам, может быть защищен, в то время как пиковая или отложенная работа распределяется по времени в соответствии с оставшейся емкостью. Это предотвращает снижение скорости отклика для всех остальных из-за одного шумного арендатора или внезапного всплеска активности агентов.
Это становится особенно важным при работе с агентским трафиком, который по своей природе неравномерен: агент может простаивать, затем выдать всплеск связанных запросов, а затем сделать паузу для вызова инструмента. Управление потоками сглаживает эту неравномерность, превращая всплески в упорядоченный поток, а не позволяя им перегрузить кластер.
Оптимизация пакетного инференса: заполнение свободных ресурсов без перегрузки системы
Далеко не каждый запрос на инференс требует немедленного ответа. Исследовательские оценки, обработка документов, генерация синтетических данных и крупномасштабное тестирование могут включать тысячи или миллионы промптов, которые могут быть выполнены с течением времени.
Эти пакетные задания могут повысить эффективность использования оборудования за счет задействования ресурсов, которые в противном случае могли бы простаивать, подобно тому, как авиагрузоперевозки направляются на неиспользуемые взлетно-посадочные полосы. При плохой организации пакетные задания могут затопить систему и задержать интерактивный трафик. Пакетная рабочая нагрузка не должна заставлять человека без необходимости ждать помощника по написанию кода или ответа службы поддержки.
llm-d поддерживает пакетный и оффлайн-инференс с помощью двух дополняющих друг друга компонентов. Пакетный шлюз предоставляет совместимый с OpenAI интерфейс для отправки, отслеживания и управления заданиями пакетного инференса. Асинхронный процессор может извлекать отдельные запросы из очередей сообщений, включая Redis и Google Pub/Sub, и отправлять их на маршрутизатор llm-d.
Эта архитектура разделяет управление заданиями и размещение запросов. Пакетный уровень определяет, как работа попадает в систему, в то время как маршрутизатор по-прежнему решает, где должен выполняться каждый отдельный запрос. Пакетные задания полагаются на управление потоком, чтобы распределять их поступление в соответствии с текущей нагрузкой, а не запускать все задание в кластер одновременно.
Результатом является более быстрая пакетная обработка, а также более упорядоченное использование общей инфраструктуры. Организации могут поддерживать высокую производительность ускорителей, одновременно защищая оперативность приложений с более высоким приоритетом.
Дизагрегация префилла и генерации (decode): разделение двух разных типов работы
Генерация ответа LLM включает в себя два вычислительных этапа. Во время префилла модель обрабатывает входной промпт и строит кэш KV. Этот этап может включать в себя большие объемы параллельных вычислений, особенно когда промпт содержит десятки тысяч токенов. Во время генерации (decode) модель выдает ответ по одному токену за раз. Генерация является последовательной и крайне чувствительной к доступу к памяти и задержкам связи, что предъявляет к оборудованию требования, отличные от префилла.
Обычная система обслуживания может выполнять оба этапа на одной группе ускорителей, что упрощает развертывание, но создает конкуренцию между разнородными рабочими нагрузками. Крупное задание префилла может прервать или задержать непрерывную генерацию токенов, в то время как оборудование, настроенное на оперативную генерацию, может плохо подходить для обработки очень длинных промптов.
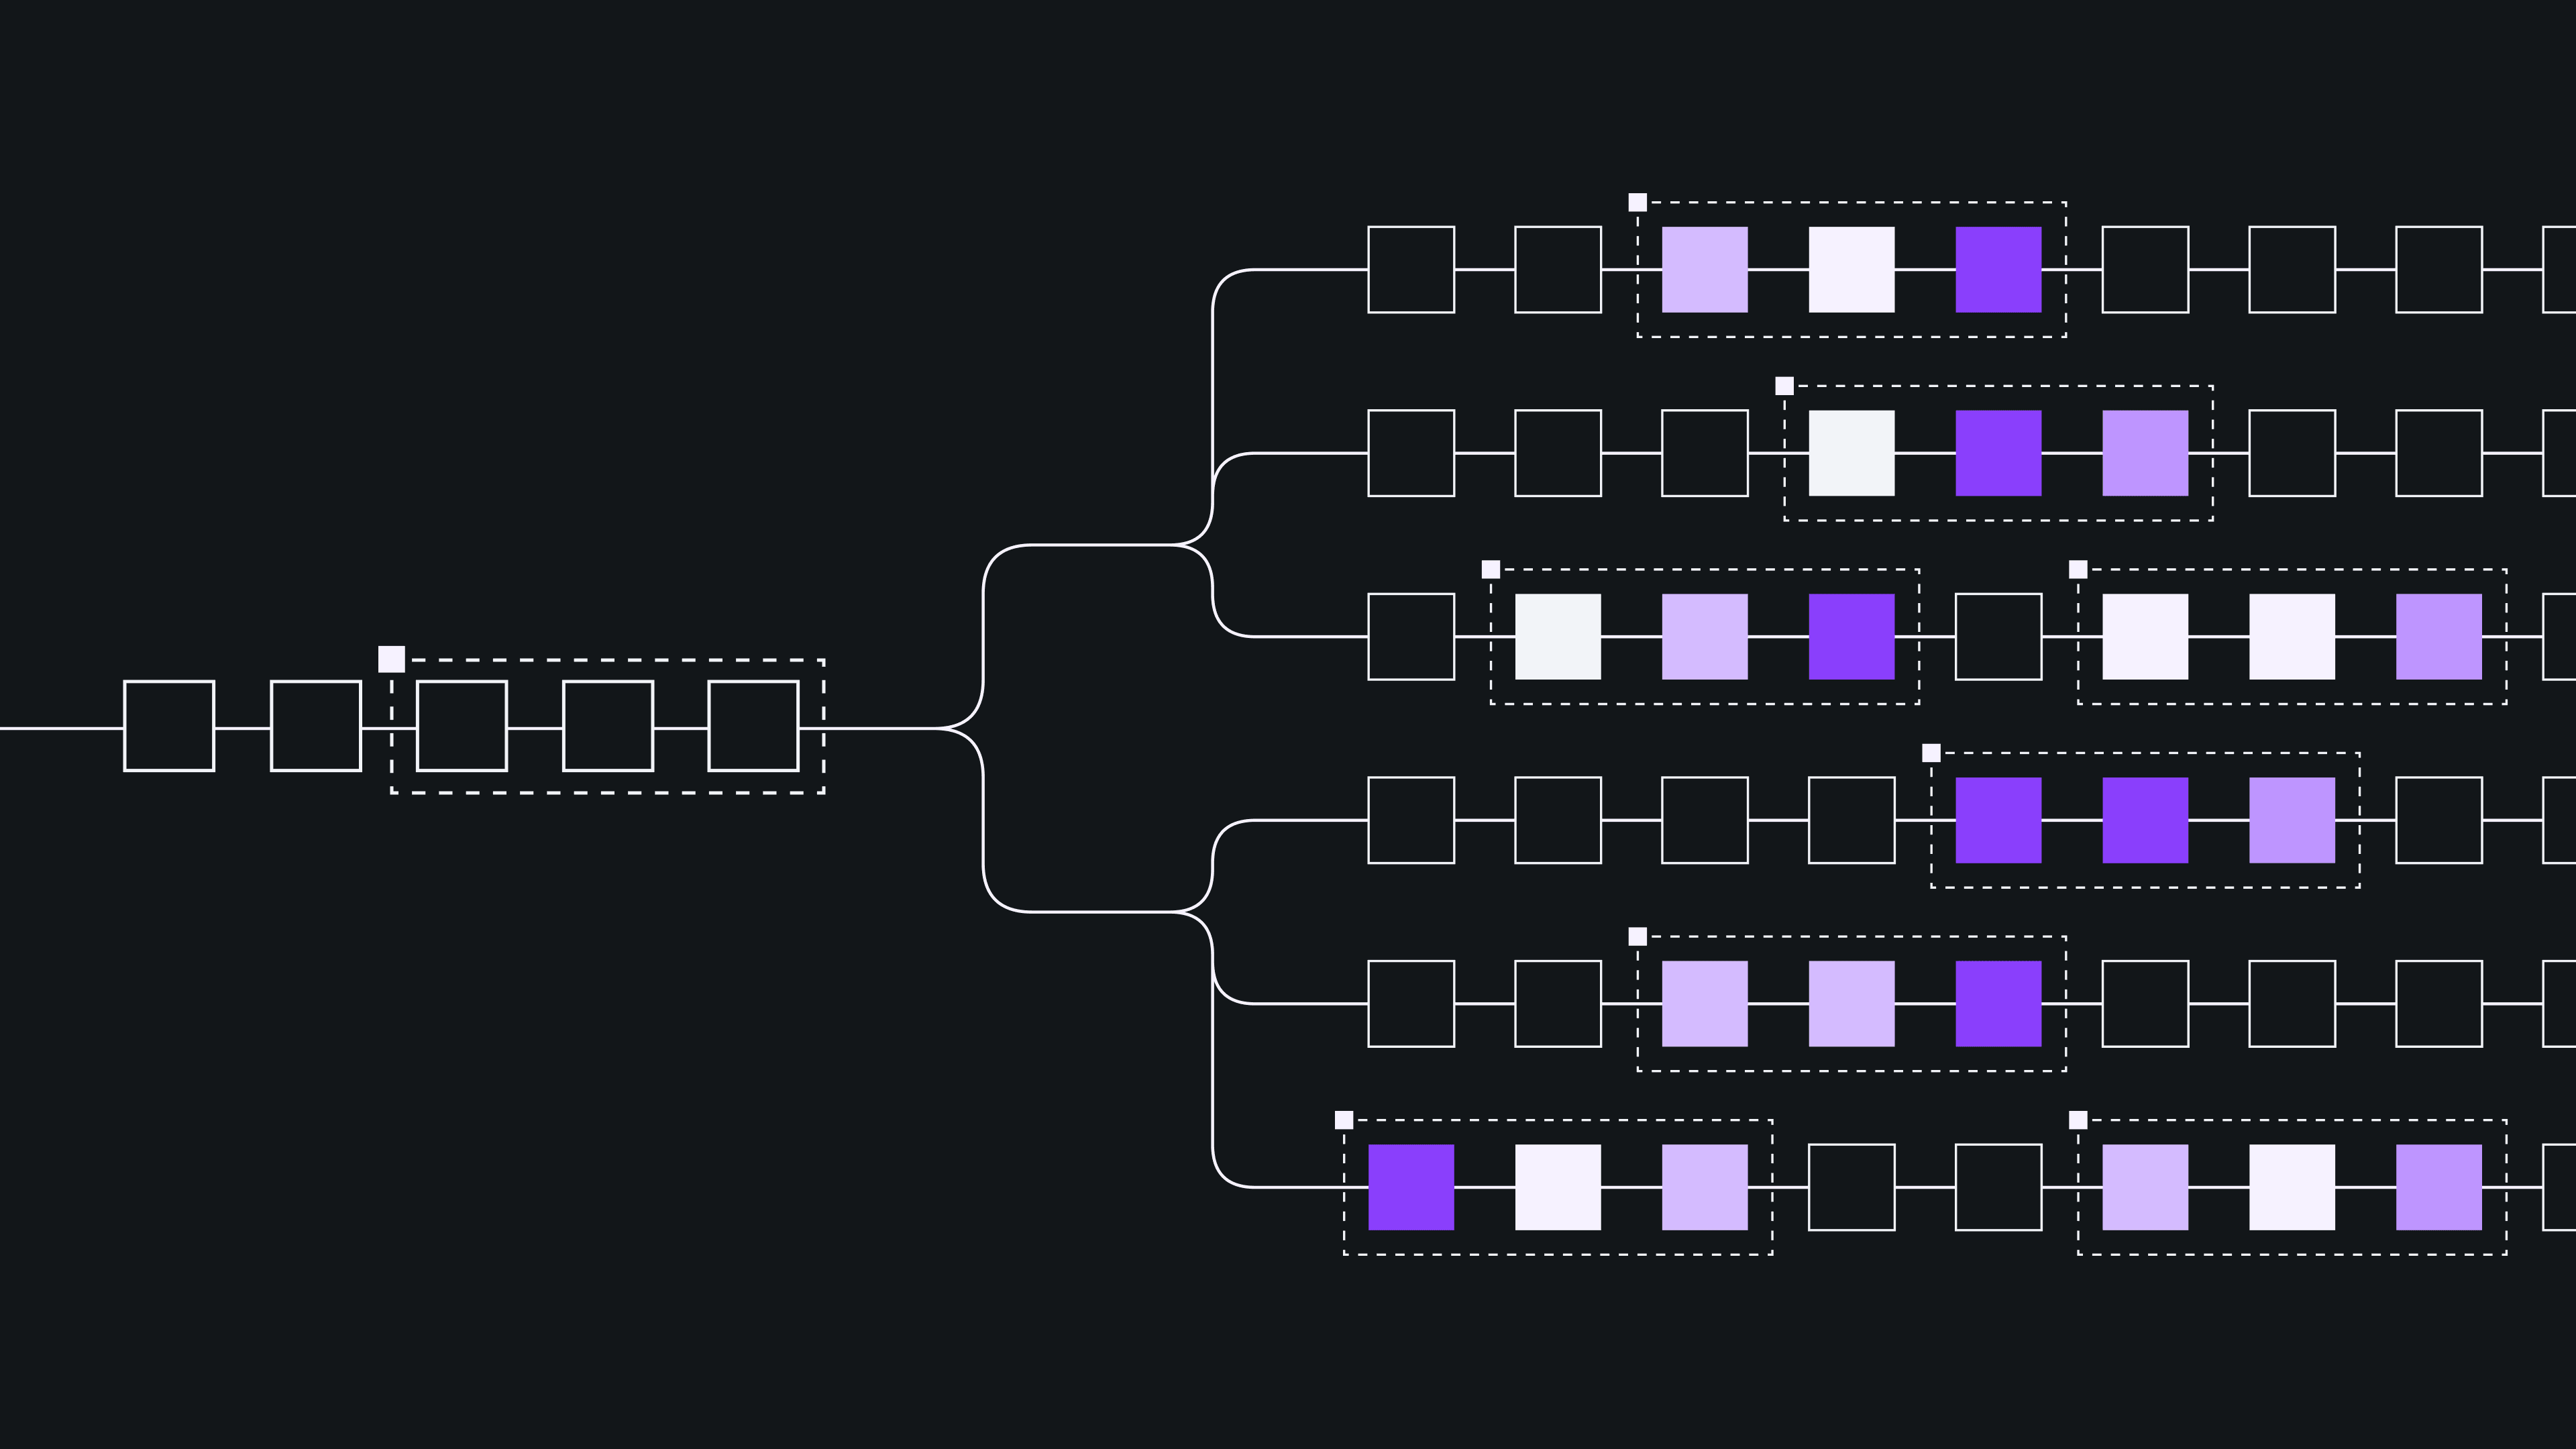
Prefill/decode disaggregation позволяет системе распределенного инференса назначать этапы специализированным воркерам и масштабировать их независимо друг от друга. Маршрутизатор выбирает эндпоинт префилла и эндпоинт декодирования, а затем координирует передачу результирующего состояния KV-кэша между ними.
Это разделение делает инфраструктуру более адаптивной. Рабочая нагрузка, состоящая в основном из длинных документов, может потребовать большей емкости префилла. Сервису, поддерживающему множество активных разговоров, может потребоваться большая емкость декодирования. Вместо расширения всего кластера обслуживания операторы могут добавлять ресурсы там, где действительно существует нагрузка.
Дизагрегация также снижает интерференцию между этапами. Обработка промптов может быть оптимизирована по пропускной способности, в то время как генерация может быть оптимизирована для стабильной доставки токенов. Дизагрегация префилла и генерации позволяет масштабировать оба этапа независимо, повышая эффективность при переменной нагрузке.
Широкий параллелизм экспертов: распределение гигантской модели по кластеру
Некоторые из сегодняшних крупнейших языковых моделей используют архитектуру смеси экспертов (MoE). Вместо применения каждой части модели к каждому токену, модель MoE содержит множество специализированных нейронных сетей, называемых экспертами. Механизм маршрутизации выбирает лишь небольшое подмножество экспертов для каждого токена.
Этот подход снижает объем вычислений, необходимых для каждого запроса, но не устраняет необходимость хранения полного набора весов модели. Большие модели MoE могут требовать сотен гигабайт памяти только для хранения всех своих весов, оставляя меньше памяти ускорителя для KV-кэша и других частей инференса.
Традиционный тензорный параллелизм решает проблему с памятью путем разделения отдельных операций модели между несколькими GPU, что может потребовать частой связи между GPU. Для моделей, использующих определенные механизмы внимания, это также может создавать несколько копий одних и тех же данных KV-кэша, уменьшая емкость, доступную для длинных контекстов и одновременных пользователей.
Широкий экспертный параллелизм использует иной подход. Он распределяет экспертов модели между графическими процессорами (GPU), а при необходимости — и между физическими серверами. Когда модель определяет, какие эксперты должны обработать токен, система отправляет этот токен только на те GPU, на которых размещены выбранные эксперты. Эти эксперты выполняют свои вычисления, и результаты возвращаются на исходный путь обработки. Поскольку этот обмен данными является разреженным, GPU обмениваются информацией, необходимой только для выбранных экспертов, вместо того чтобы постоянно синхронизировать каждую операцию модели.
Говоря терминами авиасообщения, системе не требуется, чтобы каждый специалист в аэропорту работал с каждым самолетом. Она направляет каждую задачу только тому небольшому числу специалистов, которые действительно нужны. Эффективность использования памяти — значительное преимущество этого метода. Распределение весов экспертов по более широкой группе ускорителей оставляет больше памяти на каждом GPU для KV-кэша.
Эффект может быть существенным. В исследовании этого года от IBM и Red Hat широкая компоновка позволила хранить около 65,1 ГиБ весов экспертов на GPU по сравнению с 89,5 ГиБ при использовании тензорного параллелизма. На том же оборудовании широкие конфигурации обеспечили от трех до девяти раз большую емкость KV-кэша, в зависимости от топологии.
Таким образом, широкий экспертный параллелизм помогает распределенным системам вывода, таким как llm-d, обслуживать очень большие MoE-модели, сохраняя при этом место для длинных промптов и множества активных сессий. Он также дополняет дезагрегацию префилла/декодирования: один метод разделяет вывод по фазам, а другой распределяет экспертов модели по кластеру. Используемые вместе, они позволяют llm-d более точно адаптировать организацию оборудования к структуре модели и требованиям рабочей нагрузки.
Координация всей системы вывода
Как и в случае с системой авиадиспетчеров, наземных служб и летных экипажей в аэропорту, каждый элемент ценен сам по себе, но не может управлять операцией в одиночку.
Маршрутизация с учетом префиксного кэша определяет, где находится повторно используемый контекст. Выгрузка KV-кэша сохраняет больше этого контекста в иерархии памяти и хранилищ. Управление потоками регулирует входящие запросы для поддержания емкости для одновременных пользователей. Пакетный вывод контролирует, как большие объемы фоновых задач поступают в систему. Дезагрегация префилла/декодирования направляет принципиально разные фазы вывода на ресурсы, подходящие для каждой из них. А широкий экспертный параллелизм физически распределяет большие модели по кластерам, чтобы максимально эффективно использовать память ускорителей.
Вместе они превращают обслуживание LLM из набора изолированных серверов моделей в скоординированную и распределенную систему. Это различие становится все более важным по мере того, как ИИ выходит за рамки простого чата и переходит к агентам, которые поддерживают длинные контексты, вызывают инструменты, сотрудничают с другими агентами и генерируют нерегулярные всплески трафика.
Аналогия с управлением воздушным движением имеет свои границы, но ее главный урок остается в силе: производительность зависит от координации, а не только от «сырой» мощности. Строительство новых взлетно-посадочных полос не делает аэропорт автоматически эффективным, а добавление новых ускорителей не делает вывод автоматически быстрым или доступным. Системе также нужно знать, куда направлять работу, что можно использовать повторно, какие задачи могут подождать и какие ресурсы лучше всего подходят для каждого этапа.
Именно эту роль призван выполнять распределенный вывод.