Ваши разработчики не привязаны к какому-то одному ИИ-ассистенту программирования. Исследование Sonar State of Code Developer Survey показало, что команды разработчиков в среднем используют четыре разных инструмента ИИ, а передовые технологии меняются каждые несколько месяцев.
Команды переходят от ассистентов к ассистентам: от Copilot к Claude Code, к Cursor, к Codex и к тому, что появится в следующий раз. Базовые модели этих ассистентов также меняются, зачастую еще быстрее: появляется новая модель, предпочтения разработчиков следуют за ней в течение нескольких недель, и ассистент в вашей IDE выполняет рассуждения на другой модели, чем в прошлом квартале. Мобильность и гибкость в выборе инструментов — это сильная сторона, когда она повышает скорость. Но она становится уязвимым местом в тот момент, когда ваш стандарт проверки оказывается привязан к тому ассистенту, который случайно написал этот код.
Никто намеренно не назначает ассистента высшим судьей качества. Эту роль он берет на себя постепенно, накапливая ее с помощью небольших, инкрементальных шагов в течение долгого времени. Каждый ассистент поставляется со своим собственным этапом проверки и собственным сигналом о том, что работа выполнена и тесты пройдены, — уже настроенным и уже оплаченным. Добавьте сюда контроль доступа, который различается в зависимости от репозитория, и 35% использования ИИ-инструментов через личные аккаунты, и планка, которой соответствует изменение, наследуется от инструмента, создавшего его. Каждый инструмент проверяет свою собственную работу по-своему, и качество кода становится функцией выбора вендора, а не инженерного принципа.
Полезный вопрос заключается в том, как проверить вывод любого ИИ-ассистента программирования, каким бы инструментом он ни был создан.
Может ли ассистент проверить собственный вывод?
До определенного момента. В небольшой предсказуемой кодовой базе ассистент, проверяющий собственную работу, справляется неплохо. Код локализован, соответствующие пути вызовов помещаются в контекст, а ошибки, как правило, поверхностны. Это также описывает большинство пилотных проектов, поэтому самопроверка выглядит убедительно при оценке и менее надежно в продакшене.
Масштаб и сложность задают границу. В крупной корпоративной среде условия меняются: взаимосвязанные системы, стеки, объединяющие унаследованные и современные системы, десятки команд, выполняющих коммиты в сотни репозиториев, и поведение, зависящее от кода, которого у ассистента никогда не было в контексте. Чистый результат в изолированном репозитории говорит очень мало о том, как все это будет держаться там.
Три вещи перестают работать в таком масштабе:
- Отсутствие разделения обязанностей. Ассистент, написавший код, приносит те же контекст и предположения при оценке кода, поэтому структурная ошибка, допущенная при генерации, воспринимается как правильная при проверке.
- Отсутствие воспроизводимого результата. Проверка, основанная исключительно на рассуждениях, дает разную обратную связь по одному и тому же коду от запуска к запуску, без детерминированного слоя в основе, который мог бы ее закрепить.
- Отсутствие аудируемости. Проверка без детерминированной основы не оставляет повторяемой записи о прохождении/непрохождении, на которую можно сослаться, когда служба комплаенса или постмортем спрашивает, что произошло.
Независимость обеспечивается отдельной методологией, применяемой чем-то отличным от проверяемой системы. Именно это работает, когда инфраструктура вырастает до масштабов, при которых ни одно окно контекста не охватывает ее целиком.
Проверка человеком не спасает положение. Исследование Уортонской школы (Шоу и Нейв, 2026 г.) описывает тип сбоя, который авторы называют «когнитивным капитулированием»: участники следовали советам ИИ в 92,7% случаев, когда они были верны, и в 79,8% случаев, когда ИИ уверенно ошибался. Система безопасности, которая подчиняется тому, что она должна проверять, перестает функционировать как система безопасности.
Объемы ставят точку в этом вопросе. Пулл-реквесты ассистентов обычно в 10 раз больше человеческих. Ручная проверка не может масштабироваться до таких объемов, и любой подход, зависящий от генерирующей системы, способной находить собственные ошибки, не масштабируется тем более.
Что требуется для верификации кода, не зависящей от инструментов
Проверка должна выполняться отдельно от того, что сгенерировало код. Это основной принцип, у которого есть четыре несущих элемента.
- Независимый стандарт. Многоуровневая проверка с нулевым доверием применяет одинаковые строгие, повторяемые и проверяемые проверки ко всему коду, независимо от того, написан ли он человеком, Copilot, Claude Code, Cursor, Codex и т. д. Единый стандарт для каждого инструмента.
- Детерминированный анализ. Детерминированный анализ кода выявляет сложные, труднообнаружимые проблемы в синтаксисе, потоках данных, потоках управления и структуре, которые пропускает проверка генерирующего ассистента. Он возвращает одинаковый результат каждый раз, что и делает его проверяемым.
- Разделение обязанностей. Проверка использует другую методологию, чем генерация. Это разделение улавливает то, что один цикл генерации структурно не может обнаружить.
- Ответственность человека, обеспечиваемая в CI. Шлюз качества в вашем CI/CD-пайплайне превращает стандарт в обязательное решение. Кто-то отвечает за прохождение, и что-то фиксирует это.
Ни один отдельный слой не охватывает все. Многоуровневая структура с нулевым доверием сочетает в себе детерминированный алгоритмический анализ структуры с контекстно-зависимыми рассуждениями о намерениях и бизнес-логике, поэтому то, что пропускает один слой, улавливает другой, независимо от того, как был написан код.
Проверка также должна быть встроена в циклы, в которых уже работают разработчики: цикл работы ассистента, где пишется код, цикл проверки CI, где он проходит шлюз контроля, и цикл сопровождения кода, где он поддерживается годами. Стандарт, который появляется после того, как все три цикла завершились, просто обходят стороной.
Где применим MCP: интеграция верификации в рабочие процессы ассистентов
Независимый стандарт доказывает свою ценность, когда он достигает разработчиков там, где они уже работают — внутри ассистента и в командной строке.
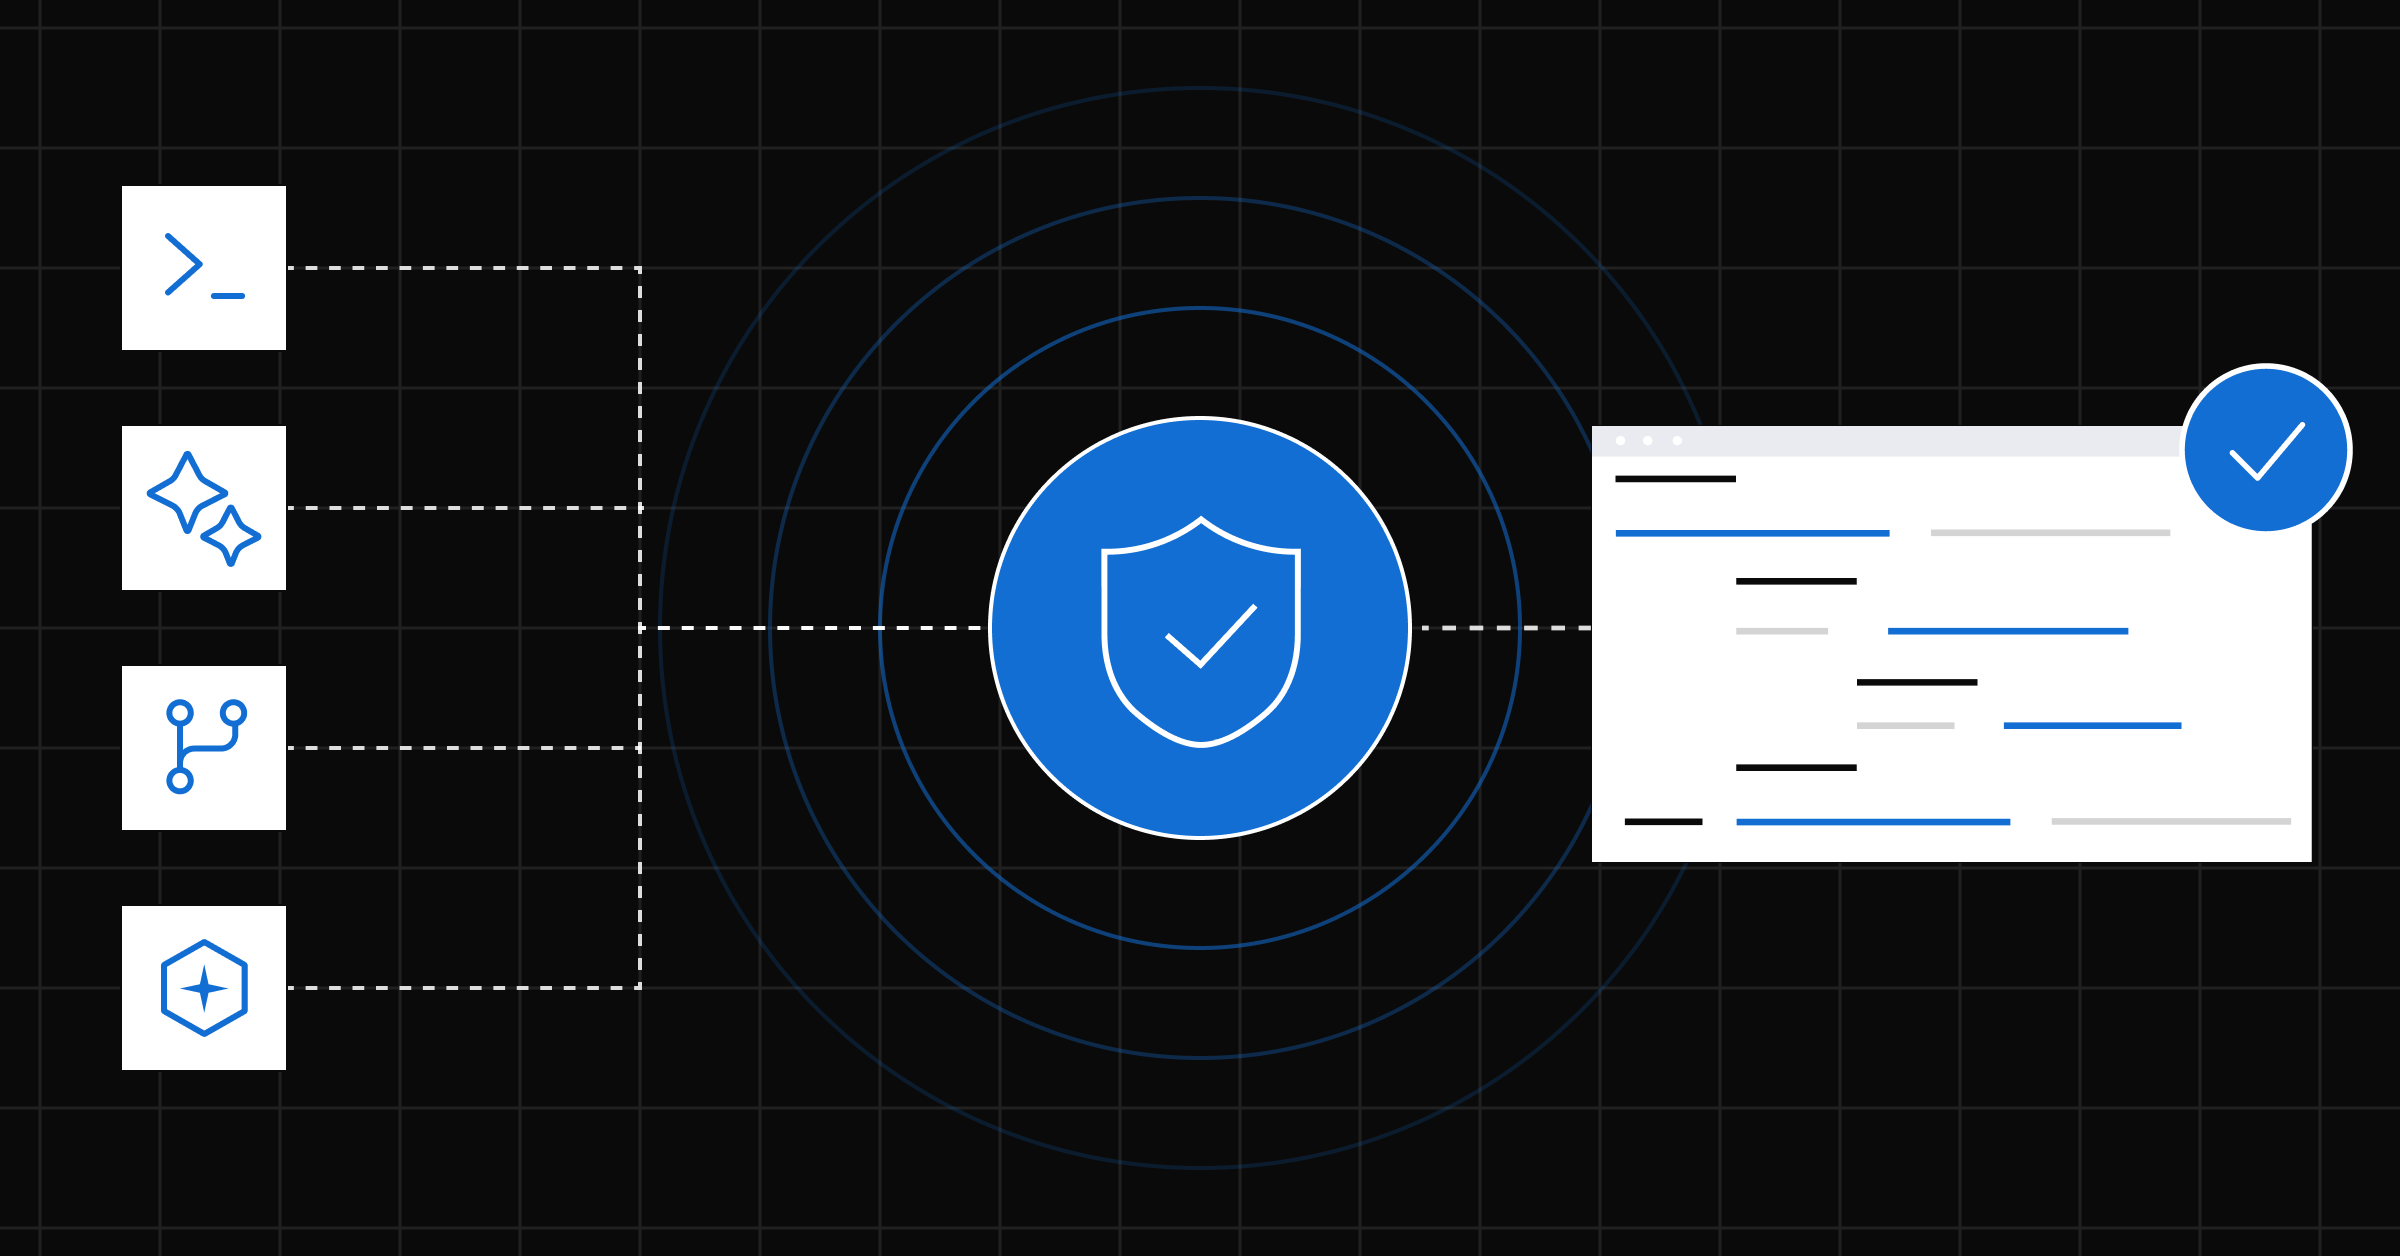
Model Context Protocol — это механизм совместимости, который передает надежные сигналы анализа кода в совместимые рабочие процессы ассистентов. Он переносит контекст проекта и верификацию Sonar прямо в ассистент, благодаря чему стандарт следует за инструментом.
SonarQube MCP Server — это соединение, которое доставляет сигнал, и оно опирается на SonarQube для выполнения базового анализа. SonarQube — это независимый уровень проверки, который выдает результат, и сигнал настолько достоверен, насколько достоверен этот анализ.
Это различие имеет значение. Совместимость — это то, что позволяет одному стандарту охватывать многоинструментальный стек. Анализ, лежащий в его основе, — это то, почему стандарту стоит доверять.
Практический рабочий процесс для разных ассистентов
Одна и та же модель работает независимо от того, использует ли ваша команда ведущие современные инструменты программирования с ИИ или те, которые появятся в следующем квартале.
- Генерируйте с помощью того ассистента, который лучше всего подходит для задачи.
- Проверяйте на соответствие единому независимому стандарту через SonarQube MCP Server, чтобы ассистент получал детерминированную обратную связь во время работы, за несколько часов до создания пулл-реквеста.
- Настройте шлюз в CI, чтобы вывод каждого ассистента проходил через один и тот же шлюз качества перед отправкой в релиз.
- Несите ответственность за результат: с человеком, ответственным за слияние, и проверяемой записью позади него.
Смените ассистента, а стандарт останется прежним. В этом и заключается суть.
Что нужно проверить перед отправкой кода ассистента в релиз
Для верификации, не зависящей от ассистентов, необходим конкретный контрольный список. Прежде чем код какого-либо ассистента будет отправлен в релиз, проведите валидацию изменений кода ассистента по пяти пунктам:
- Качество. Поддерживаемость, сложность и дублирование — свойства, которые определяют, будет ли следующее изменение быстрым или болезненным.
- Безопасность. Уязвимости и небезопасные шаблоны выявляются в самом источнике. Согласно одному исследованию, автономные передовые модели, которым было поручено самостоятельно исправить уязвимости, терпели неудачу в 52% случаев и привносили новый баг или уязвимость в 25% случаев. Исправление работает тогда, когда за ним стоит уровень верификации, подтверждающий, что исправление действительно применилось.
- Риск зависимостей. Происхождение и известные проблемы в ваших зависимостях, проверяемые в рамках того же стандарта.
- Поддерживаемость. Структурный дрейф, который накапливается незаметно. Исследователи из Университета Карнеги-Меллона зафиксировали постоянный рост предупреждений статического анализа на 30% и увеличение сложности кода на 41% в проектах, которые внедрили ИИ-агент — замедление, которое пережило первоначальный всплеск скорости.
- Работоспособность сборки. Проверка того, действительно ли код собирается и проходит тесты, осуществляемая до того, как он попадет к человеку-рецензенту.
Как узнать, сокращает ли верификация объем переделок
Верификация, которая создает узкое место при ревью, потерпела неудачу по собственным критериям. Сигнал того, что она работает — это сокращение объема переделок.
Отслеживайте это напрямую:
- Часы на переделки. Меньше времени тратится на исправление результатов работы агента постфактум.
- Время цикла. Более быстрый путь от генерации до слияния проверенного кода.
- Проблемы, выявленные до слияния, по сравнению с проблемами после слияния. Больше проблем решается в источнике, меньше проникает в продакшн.
- Тренд технического долга. Стабильное или снижающееся соотношение долга даже при росте объема кода, генерируемого агентами.
Когда верификация сокращает объем переделок, скорость становится преимуществом. Когда этого не происходит, процесс разрастается, а доверие к нему — нет.
Стандарт остается неизменным независимо от инструмента
ИИ-агенты для написания кода будут продолжать меняться. Стандарт верификации, который применим ко всем ним, дает вашим командам стабильную основу для контроля.
Привяжите качество к какому-то одному инструменту, и вы унаследуете его слепые зоны и нестабильность. Установите один независимый, детерминированный, аудируемый стандарт, и результаты работы каждого агента будут соответствовать единой планке, что позволит вам выпускать продукты быстрее и управлять процессом с уверенностью.
ИИ генерирует. Sonar верифицирует. Ознакомьтесь с возможностями Sonar по верификации агентской разработки, чтобы применять единый стандарт для каждого ИИ-агента кодирования, используемого вашей командой.