В течение многих лет надежность сводилась к простому вопросу: работает ли система?
Однако современные системы сделали надежность более сложным понятием, чем просто время безотказной работы. Поскольку приложения становятся все более распределенными и взаимосвязанными, система может быть технически доступной, но при этом обеспечивать низкое качество обслуживания, если она работает медленно, функционирует с ограничениями или дает сбои на каком-то этапе пути клиента. Это, в свою очередь, сместило фокус обсуждения надежности с простого времени безотказной работы на клиентский опыт, влияние на бизнес и способность системы обнаруживать сбои и реагировать на них.
Для New Relic это меняющееся определение надежности очень актуально. Наши клиенты полагаются на New Relic, чтобы создавать и эксплуатировать надежные системы. Авиакомпании, ритейлеры, стриминговые платформы и компании из всех отраслей используют нашу платформу для мониторинга и защиты критически важных цифровых сервисов. Когда авиакомпания обрабатывает тысячи бронирований, когда ритейлер находится в середине распродажи, когда стриминговая платформа проводит трансляцию в прямом эфире и трафик возрастает в 100 раз, эти команды наблюдают за дашбордами New Relic в режиме реального времени. Это означает, что они полагаются на New Relic не только для того, чтобы узнать, когда что-то сломалось. Они полагаются на нас, чтобы мы помогли им понять, что происходит, выявить проблемы на ранней стадии и отреагировать до того, как эти проблемы превратятся в инциденты, затрагивающие клиентов.
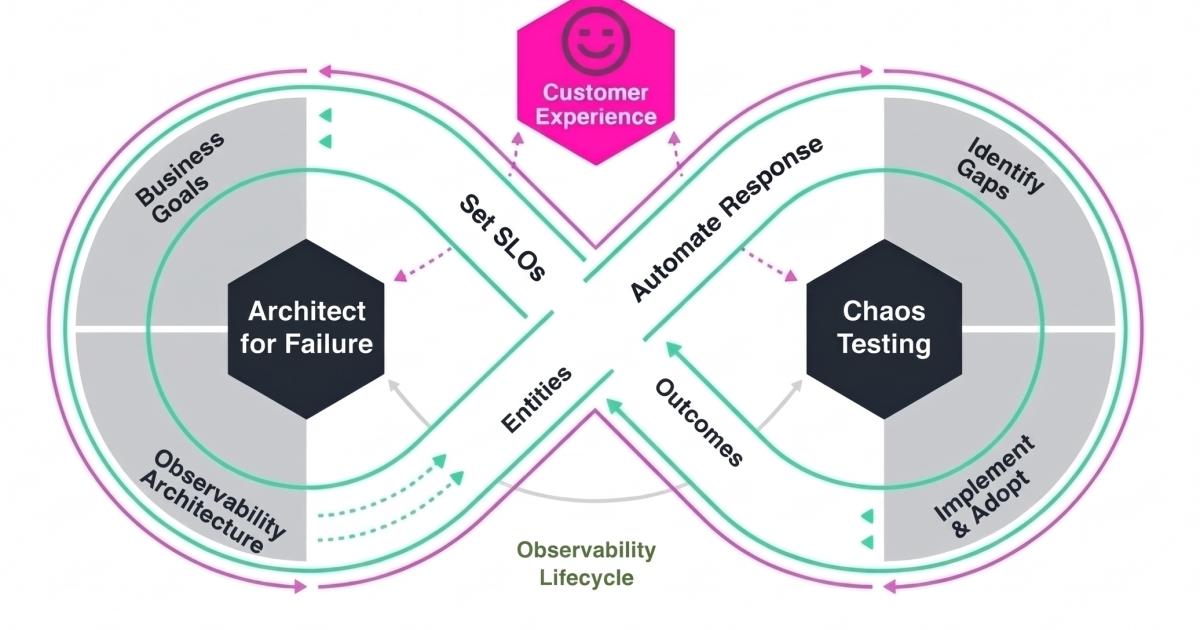
Именно это повышает ставки для нас. Когда наши клиенты зависят от New Relic в вопросах мониторинга и защиты критически важных цифровых сервисов, наша надежность становится частью их надежности. Вот почему мы постоянно стремимся повышать планку надежности. За последние несколько лет New Relic повысила свою надежность более чем на 50%. Чтобы улучшить собственное время безотказной работы, мы сосредоточились на нескольких ключевых областях, которые принесли высокую окупаемость инвестиций (ROI). Это потребовало отношения к надежности как к тому, что мы проектируем осознанно: постоянное измерение, проектирование с учетом отказоустойчивости с самого начала и автоматизация реагирования, чтобы скорость восстановления не зависела от того, кто именно находится на дежурстве.
Давайте поговорим о практиках, которые помогли нам спроектировать более надежную платформу.
Отслеживайте то, что важно
Надежность начинается с понимания того, что нужно измерять. Это означает отслеживание не только того, когда что-то ломается, но и того, как быстро вы это обнаруживаете и сколько клиентов ощущают последствия. В New Relic мы относимся к метаданным инцидентов с той же строгостью, что и к телеметрии производительности приложений, занося каждое потенциальное снижение качества обслуживания в NRDB.
Для каждого инцидента мы фокусируемся на четырех показателях, которые говорят нам о том, насколько эффективно мы работаем:
- Время до обнаружения (TTD): сколько времени проходит с момента возникновения проблемы до момента, когда мы о ней узнаем.
- Время до устранения (TTM): сколько времени проходит с момента обнаружения до устранения влияния на клиента.
- Процент затронутых клиентов: радиус влияния любого инцидента, который говорит нам, имеем ли мы дело с масштабным сбоем или локальной проблемой.
- Частота сбоев при изменениях: как часто изменения в наших системах приводят к инциденту или влиянию на клиентов.
Каждый инцидент помечается богатым набором атрибутов, таких как затронутые продукты и функции, команда, ответственная за вышедшую из строя систему, и причина события — будь то изменение кода, обновление конфигурации, аппаратный сбой или зависимость от стороннего сервиса. Все это хранится в NRDB как пользовательские события. Поскольку каждый сервис оснащен инструментами New Relic, мы можем сопоставлять историю инцидентов с уровнями обслуживания, маркерами изменений, расходами на облако и другой собираемой нами телеметрией, а затем запрашивать эти данные для выявления тенденций надежности. Со временем эти закономерности могут выявить повторяющиеся типы сбоев, «горячие точки» надежности или категории изменений, которые постоянно создают риски. Сами по себе данные могут ничего не исправить. Но они делают закономерности видимыми, а видимые закономерности — это то, с чем можно работать.
Проектируйте отказоустойчивость с самого начала
Одна из самых распространенных ошибок компаний в отношении надежности — рассматривать ее как нечто, что можно добавить позже. Вы создаете систему, выпускаете продукт, а затем пытаетесь сделать его стабильным постфактум. Такой подход редко работает, а в масштабе становится практически невозможным, потому что область потенциальных сбоев растет быстрее, чем любая команда может исправлять их реактивно.
В New Relic отказоустойчивость является частью процесса проектирования с самого начала. Крупные архитектурные изменения проходят формальную проверку, которая включает в себя явный аудит на предмет типов сбоев. Может ли этот сервис справиться с внезапным скачком обратного давления? Что произойдет, если нисходящая зависимость замедлится или отключится? Где находятся «горячие точки» и как нам распределить нагрузку вокруг них?
Мы используем ячеистую архитектуру, чтобы ограничить радиус поражения при любом сбое. Если проблема возникает в одной ячейке, трафик может быть перенаправлен в другую. Наш уровень маршрутизации использует архитектуру active-active, поэтому ни одна система не является критической точкой отказа. Эти решения являются осознанным выбором при проектировании, чтобы избежать единой точки отказа. Философия проста: предвидьте возможные сбои и внедряйте средства защиты до того, как они произойдут. Исходите из того, что что-то пойдет не так, и убедитесь, что система готова к этому.
Но проектирование с учетом отказоустойчивости также означает учет деградации внешних сервисов, от которых мы зависим. Этими системами бывает трудно управлять, поэтому цель состоит в том, чтобы использовать телеметрию для раннего выявления проблем и проектировать систему так, чтобы локализовать их влияние. Вот несколько примеров того, как мы применяем этот принцип к зависимостям и инфраструктуре, которые мы не можем полностью контролировать.
- Проектирование с учетом внешних зависимостей. Некоторые внешние зависимости, такие как сети доставки контента (CDN), являются критически важной инфраструктурой для систем, ориентированных на клиентов, включая крупных провайдеров телеметрии и наблюдаемости, таких как New Relic. Сбои CDN находятся вне нашего прямого контроля, и наш ответ на это — не принимать риск, а проектировать систему в обход него. Мы работаем с несколькими CDN-провайдерами одновременно через архитектуру multi-CDN с активными узлами и постоянно собираем телеметрию от всех провайдеров. Когда эта телеметрия указывает на деградацию у одного провайдера, наша система автоматически перенаправляет трафик на работоспособного провайдера, помогая поддерживать непрерывность приема данных. Используя телеметрию состояния и производительности провайдеров для автоматического принятия решений о переключении, мы можем достичь более высокой надежности, чем мог бы обеспечить любой из провайдеров по отдельности. Мы заметили снижение влияния сбоев CDN на клиентов на 60% с момента внедрения этой архитектуры. Тот же подход применим к любой внешней зависимости. Вместо того чтобы пытаться контролировать каждую часть вашего стека, ожидайте сбоя и проектируйте систему с учетом этого. Клиенты могут применять этот же принцип к своей собственной телеметрии, используя ее не только для понимания того, что происходит, но и для принятия обоснованных решений и запуска автоматизированных ответов. Превратите свою телеметрию в действия, и вы сможете быстрее локализовать сбои и защитить клиентский опыт.
Проектирование с учетом внешних зависимостей
Некоторые внешние зависимости, такие как сети доставки контента (CDN), являются критически важной инфраструктурой для систем, взаимодействующих с клиентами, включая крупных провайдеров телеметрии и наблюдаемости, таких как New Relic. Сбои в работе CDN находятся вне нашего прямого контроля, и наш ответ на это заключается не в принятии риска, а в проектировании архитектуры с учетом этого фактора.
Мы работаем с несколькими CDN-провайдерами одновременно через архитектуру multi-CDN в режиме active-active и постоянно собираем телеметрию от всех провайдеров. Когда эта телеметрия указывает на деградацию у одного из провайдеров, наша система автоматически перенаправляет трафик на работоспособного провайдера, помогая поддерживать непрерывность приема данных. Используя телеметрию состояния и производительности провайдеров для автоматического принятия решений о переключении при сбоях, мы можем достичь более высокой надежности, чем мог бы обеспечить любой из провайдеров по отдельности. Мы заметили 60-процентное снижение влияния сбоев CDN на клиентов с момента внедрения этой архитектуры.
Тот же подход применим к любой внешней зависимости. Вместо того чтобы пытаться контролировать каждую часть вашего стека, ожидайте сбоев и проектируйте архитектуру с учетом этого. Клиенты могут применять этот же принцип к своей собственной телеметрии, используя ее не только для понимания того, что происходит, но и для принятия обоснованных решений и запуска автоматических ответов. Превратите свою телеметрию в действия, и вы сможете быстрее локализовать сбои и защитить пользовательский опыт.
- Защита от деградации облачной инфраструктуры. Проблемы с инфраструктурой не всегда начинаются с полного отказа. Облачная инфраструктура может деградировать по-разному и часто подает предупреждающие сигналы до того, как сервис выйдет из строя. Одним из примеров является узел, который начинает демонстрировать TCP-ошибки по мере деградации его аппаратного обеспечения. New Relic отслеживает TCP-метрики на узлах каждые несколько секунд в качестве одного из способов обнаружения этих сигналов. Когда узел пересекает порог деградации, внутренняя служба автоматизации переносит рабочие нагрузки с этого узла, прежде чем это приведет к простою. Обнаружение деградации на уровне сигналов, а не ожидание инцидента, позволяет исключить целый класс сбоев. Аппаратное обеспечение заменяется без какого-либо влияния на клиентов или необходимости вызова дежурного инженера. Это тот же принцип, что и при работе с избыточностью CDN: используйте данные телеметрии, чтобы определить, когда что-то идет не так, и автоматизируйте ответ. Чем больше режимов сбоев вы можете обрабатывать автоматически, тем меньше ваша надежность зависит от того, как быстро кто-то сможет отреагировать.
Защита от деградации облачной инфраструктуры
Проблемы с инфраструктурой не всегда начинаются с полного отказа. Облачная инфраструктура может деградировать по-разному и часто подает предупреждающие сигналы до того, как сервис выйдет из строя. Одним из примеров является узел, который начинает демонстрировать TCP-ошибки по мере деградации его аппаратного обеспечения.
New Relic отслеживает TCP-метрики на узлах каждые несколько секунд в качестве одного из способов обнаружения этих сигналов. Когда узел пересекает порог деградации, внутренняя служба автоматизации переносит рабочие нагрузки с этого узла, прежде чем это приведет к простою. Обнаружение деградации на уровне сигналов, а не ожидание инцидента, позволяет исключить целый класс сбоев. Аппаратное обеспечение заменяется без какого-либо влияния на клиентов или необходимости вызова дежурного инженера. Это тот же принцип, что и при работе с избыточностью CDN: используйте данные телеметрии, чтобы определить, когда что-то идет не так, и автоматизируйте ответ. Чем больше режимов сбоев вы можете обрабатывать автоматически, тем меньше ваша надежность зависит от того, как быстро кто-то сможет отреагировать.
Систематическое оповещение для сокращения времени обнаружения (TTD)
Ответственность за наблюдаемость тысяч компаний практически во всех отраслях дает New Relic уникальную возможность увидеть, что именно замедляет обнаружение. Одни и те же два шаблона возникают снова и снова, независимо от размера компании или уровня зрелости инженерных процессов.
- Пробелы в оповещении. Новые сервисы запускаются быстрее, чем добавляется покрытие оповещениями, и ни одна команда не имеет полного представления о том, что охвачено, а что нет. Эти пробелы становятся местами, где скрываются инциденты, пока их не обнаружат клиенты. New Relic решает эту проблему с помощью Smart Alerts, которые постоянно сканируют сервисы на предмет отсутствия адекватного покрытия и выявляют «слепые зоны» до того, как они станут инцидентами. Лучшие практики оповещения также кодируются как модули Terraform, наложенные поверх провайдера New Relic Terraform, поэтому новые сервисы по умолчанию наследуют надежную базу оповещений, а не начинают с нуля.
Пробелы в оповещении
Новые сервисы запускаются быстрее, чем добавляется покрытие оповещениями, и ни одна команда не имеет полного представления о том, что охвачено, а что нет. Эти пробелы становятся местами, где скрываются инциденты, пока их не обнаружат клиенты. New Relic решает эту проблему с помощью Smart Alerts, которые постоянно сканируют сервисы на предмет отсутствия адекватного покрытия и выявляют «слепые зоны» до того, как они станут инцидентами. Лучшие практики оповещения также кодируются как модули Terraform, наложенные поверх провайдера New Relic Terraform, поэтому новые сервисы по умолчанию наследуют надежную базу оповещений, а не начинают с нуля.
- Отсутствие тестового покрытия сложных конвейеров. Отдельные сервисы могут выглядеть идеально работоспособными, в то время как путь клиента нарушен где-то в конвейере, обслуживаемом несколькими командами. Это одна из самых сложных проблем обнаружения, поскольку модульные или сервисные тесты проверяют только то, что видит каждая команда, но ни одна команда не владеет всем конвейером целиком. Один из способов обнаружения таких сбоев — сквозной синтетический мониторинг. В New Relic мы используем так называемые проверки «агент-запрос». Каждая проверка отправляет тестовые данные в New Relic так же, как это сделал бы агент клиента, а затем выполняет запрос, чтобы подтвердить, что данные отображаются в результатах. Таким образом, каждая проверка проходит через весь конвейер, охватывая все этапы передачи между командами, поэтому она обнаруживает сбои в точках интеграции, до которых никогда не доходят тесты отдельных сервисов. Если данные не возвращаются должным образом, проверка завершается неудачей и срабатывает оповещение. Поиск того, какой этап сломался и какая команда за него отвечает, — это задача для телеметрии, которую каждый сервис уже отправляет в New Relic.
Отсутствие тестового покрытия сложных конвейеров
Отдельные сервисы могут выглядеть идеально работоспособными, в то время как путь клиента нарушен где-то в конвейере, обслуживаемом несколькими командами. Это одна из самых сложных проблем обнаружения, поскольку модульные или сервисные тесты проверяют только то, что видит каждая команда, но ни одна команда не владеет всем конвейером целиком.
Один из способов обнаружения таких сбоев — сквозной синтетический мониторинг. В New Relic мы используем так называемые проверки «агент-запрос». Каждая проверка отправляет тестовые данные в New Relic так же, как это сделал бы агент клиента, а затем выполняет запрос, чтобы подтвердить, что данные отображаются в результатах. Таким образом, каждая проверка проходит через весь конвейер, охватывая все этапы передачи между командами, поэтому она обнаруживает сбои в точках интеграции, до которых никогда не доходят тесты отдельных сервисов. Если данные не возвращаются должным образом, проверка завершается неудачей и срабатывает оповещение. Поиск того, какой этап сломался и какая команда за него отвечает, — это задача для телеметрии, которую каждый сервис уже отправляет в New Relic.
Сосредоточившись на охвате оповещений и сквозном тестировании, мы улучшили наш собственный показатель TTD на 40% за последний год.
Сокращение времени на устранение (TTM) с помощью Change Tracking и SRE Agent
Более быстрое обнаружение не поможет, если устранение по-прежнему зависит от того, что кто-то должен проснуться, просмотреть дашборд, выяснить, что изменилось, и решить, что делать. В масштабах компании, где множество сервисов, команд и инцидентов конкурируют за внимание одних и тех же дежурных инженеров, это «узкое место» становится серьезной проблемой для надежности. Цель состоит в том, чтобы исключить участие человека во всем, что можно автоматизировать, чтобы люди могли сосредоточиться на проблемах, которые действительно требуют принятия решений. New Relic решает проблему «узкого места» при устранении неполадок с помощью двух возможностей:
- Change tracking: Первое, о чем спрашивает любой инженер, когда что-то ломается, — это «что изменилось?». Большинство инцидентов в продакшене связаны с недавним развертыванием, обновлением конфигурации или изменением инфраструктуры. New Relic Change Tracking записывает эти события в виде маркеров в NRDB вместе со всей остальной телеметрией. Когда происходит инцидент, соответствующие изменения отображаются на той же временной шкале, и никому не нужно сверяться с журналами развертывания, примечаниями к выпуску или ветками в Slack.
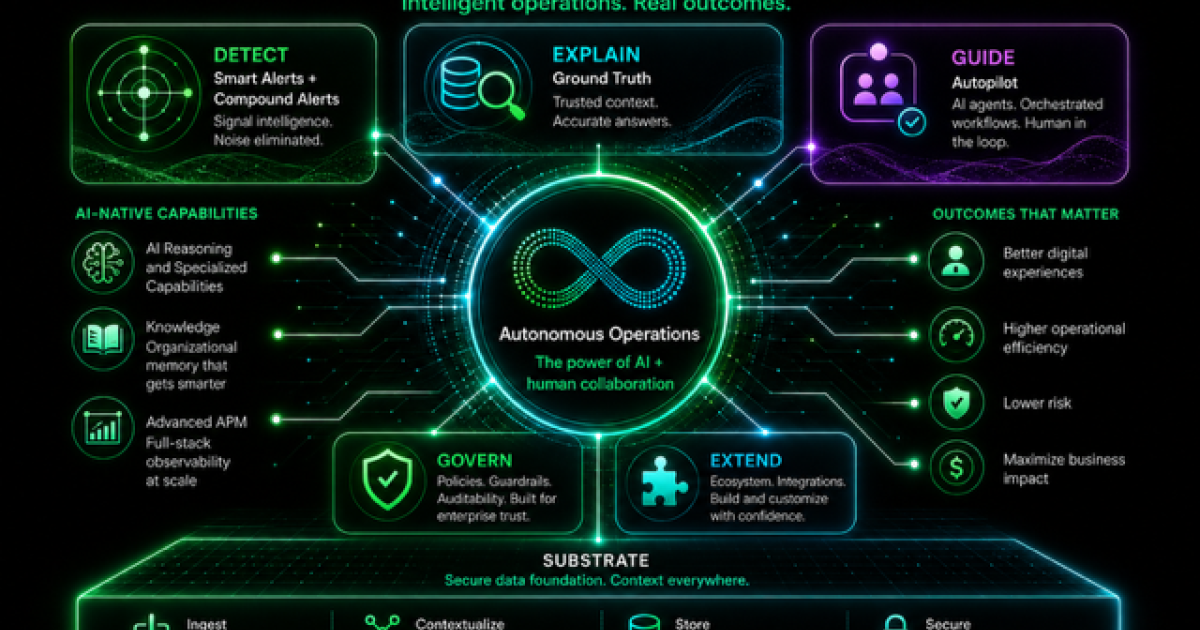
- Autopilot: New Relic Autopilot использует ИИ, чтобы помочь инженерам быстрее расследовать инциденты. Он выполняет сортировку входящих оповещений, собирает контекст, такой как связанные сущности и недавние развертывания, а также анализирует трассировки, логи и метрики для выявления вероятной первопричины. Затем он рекомендует дальнейшие шаги, например, откат развертывания или корректировку распределения ресурсов.
Вместе они сокращают время от обнаружения до разрешения, уменьшая при этом частоту случаев, когда инженеров привлекают к инцидентам, которые можно устранить автоматически.
Что это значит, если вы являетесь клиентом New Relic
Каждая практика, описанная в этом блоге, применяется нами к платформе, которой вы доверяете свои системы. Те же архитектурные решения, те же системы обнаружения, та же автоматизация — они управляют нашими системами так же, как мы рекомендуем им управлять вашими.
Именно поэтому это не просто советы по лучшим практикам. Мы зависим от New Relic в вопросах собственной наблюдаемости, а это означает, что стабильная работа системы так же критически важна для нас, как и для вас. Следуя тем же практикам, вы можете уверенно выполнять развертывание, зная, что наша и ваша системы будут оставаться работоспособными.
Мехрин Тахир — инженер-программист и технический писатель в New Relic.
Кевин Скалдеферри — главный инженер-программист и архитектор системы баз данных New Relic. Он любит математику и распределенные системы и, вероятно, слишком часто произносит слово «моноид».
Мнения, выраженные в этом блоге, принадлежат автору и не обязательно отражают взгляды New Relic. Любые решения, предложенные автором, зависят от конкретной среды и не являются частью коммерческих решений или поддержки, предлагаемых New Relic. Пожалуйста, обращайтесь исключительно в Explorers Hub (support.newrelic.com) по вопросам и поддержке, связанным с этим постом в блоге. Этот блог может содержать ссылки на контент сторонних сайтов. Предоставляя такие ссылки, New Relic не принимает, не гарантирует, не одобряет и не поддерживает информацию, мнения или продукты, доступные на таких сайтах.