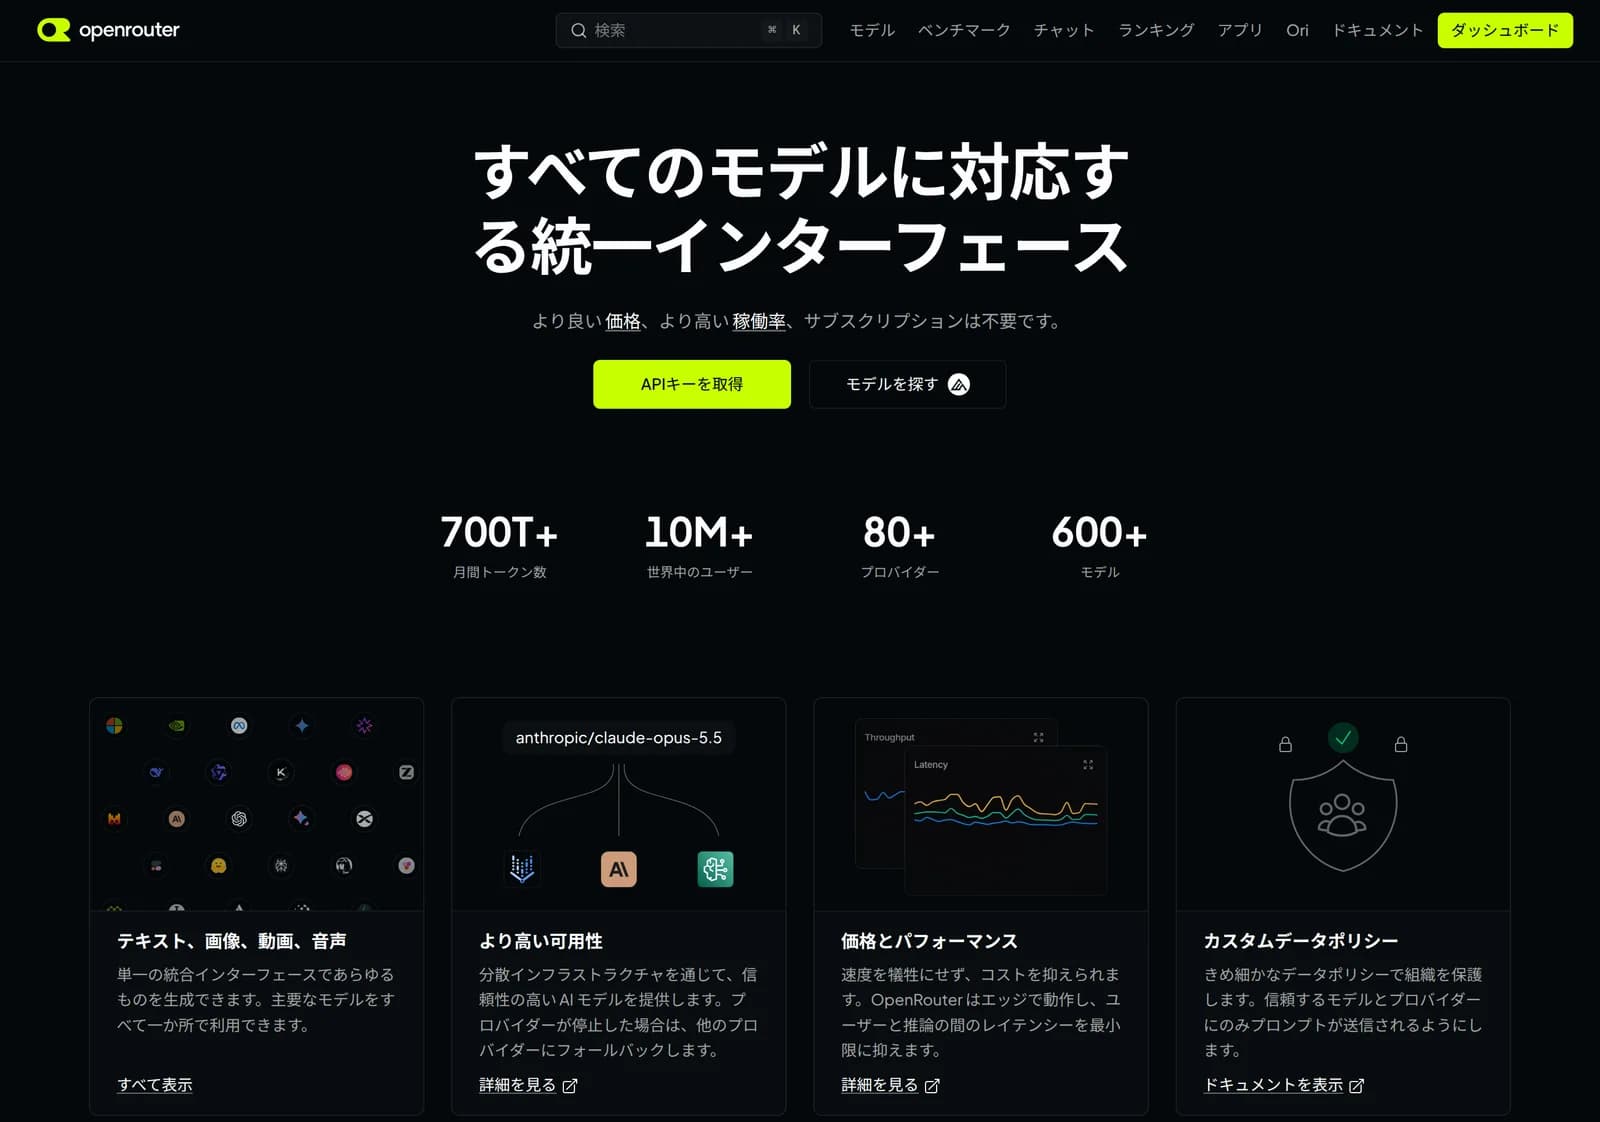
В OpenRouter теперь наряду с английским поддерживаются упрощенный китайский (简体中文), испанский (Español), португальский (Бразилия) (Português (Brasil)), немецкий (Deutsch), французский (Français), японский (日本語) и корейский (한국어) языки. Локализация находится в бета-тестировании начиная с сегодняшнего дня. Чтобы переключиться, выберите язык в меню учетной записи или перейдите сразу по адресу, например openrouter.ai/ja или openrouter.ai/ko/models.
Переводить веб-сайт и поддерживать актуальность этого перевода сложно, и для нас это справедливо вдвойне. На сайте OpenRouter насчитывается 16 918 английских строк, и мы ежедневно меняем часть из них, поэтому единовременный перевод устарел бы в течение недели. Мы создали цикл, который помогает нам решать эту задачу в автоматическом режиме. Каждый день он находит изменившиеся строки, переводит их, проверяет в коде, а затем задействует вторую модель для сверки смысла с оригиналом на английском. Если проверка или верификатор отклоняют перевод, цикл отправляет его обратно с указанием причины и повторяет попытку. Этот цикл повторных попыток и представляет собой ту часть системы, которая исправляет себя сама.
Некоторые ошибки все же проскальзывают мимо, и их замечают люди. Когда рецензенты и читатели сообщают об ошибке, мы превращаем ее в правило глоссария, стилевую заметку или переопределение, а ошибки, выявляемые в ходе ежедневной проверки, также становятся тестовыми примерами, которые обязана проходить любая будущая модель. Весь конвейер работает на базе OpenRouter.
Переводы хранятся в Git рядом с кодом
Прежде чем к делу подключится какая-либо модель, для переводов нужно подготовить место. Мы используем среду выполнения с открытым исходным кодом General Translation для обертывания строк в нашем коде на React. Мы коммитим переводы в виде JSON-каталогов рядом с кодом и загружаем их локально во время выполнения, поэтому никакой сторонний сервис переводов не участвует в обработке запросов. Строка отправляется на перевод в течение дня после слияния ветки. До тех пор на странице отображается английский исходный текст. Каждая переведенная запись также хранит «отпечаток» (fingerprint) исходного английского текста, из которого она была получена. Когда кто-то редактирует английскую версию, отпечаток перестает совпадать, и запись возвращается в очередь. Это правило позволяет ежедневно находить все устаревшие записи без повторного перевода всего каталога.
Конвейер
Каждая строка из этой очереди проходит пять этапов, прежде чем попасть на сайт.
Скрипт сканирует фронтенд и записывает каждую обернутую английскую строку в исходный каталог. Каждая запись фиксирует свой файл и роль в интерфейсе — например, кнопка, заголовок или шапка таблицы. Роль имеет значение, поскольку одно и то же английское слово в разных местах может требовать разного перевода. Слово «Queue» на кнопке является инструкцией, и один из дефектов, описанных далее в этой статье, заключается в том, что модель перевела его как существительное.
2. Перевод
Мы отправляем новые и измененные строки модели GPT-6.1 Sol батчами до 40 штук и используем структурированные выходы (Structured Outputs) для соблюдения строгой схемы JSON. Каждый запрос содержит наши глобальные и языковые стилевые заметки, правила глоссария для всех терминов продукта в текущем батче, а также роль каждой строки в интерфейсе.
Ниже приведен упрощенный пример запроса переводчика для одного японского батча с сокращенными стилевыми заметками и правилами глоссария.
Поскольку любая модель на OpenRouter принимает одинаковый формат запроса, смена переводчика сводится лишь к изменению идентификатора (slug) модели. Именно так мы провели сравнение моделей, описанное далее в этой статье.
3. Проверка
Код отклоняет ответ, если он нарушает целостность ICU-плейсхолдера, ветвления множественного числа, тега форматирования текста, начальных или конечных пробелов, а также если термин продукта используется в форме, запрещенной глоссарием. Отклоненный батч отправляется повторно меньшими частями с указанием причины сбоя (по умолчанию до 4 попыток). Это лимит, который можно увеличить до 20. Строка, которая продолжает выдавать ошибку после последней попытки, остается на английском языке и помечается в пулл-реквесте.
4. Верификация
Второй вызов той же модели, выступающей в роли верификатора, сверяет каждый перевод с английским оригиналом и перечисляет ошибки по степени их серьезности. Любая критическая или серьезная ошибка, такая как пропущенный фрагмент или искаженный смысл, возвращает строку переводчику со всеми замечаниями. Переводчику предоставляется до 3 повторных попыток после первой неудачной, причем последняя попытка выполняется с повышенным уровнем рассуждения (reasoning effort). Затраты на одну строку не имеют отдельного ограничения, так как они уже ограничены лимитами повторных попыток. С учетом повторных отправок на этап проверки строка может потребовать до четырех попыток перевода (до четырех проверок каждая), плюс вызов верификатора после каждой попытки. В худшем случае это составляет около 20 вызовов модели на одну строку для каждого языка. Если верификатор недоступен, конвейер ничего не записывает, и строка остается на английском. Пользователь, который видит английский текст в течение одного дня, находится в лучшем положении, чем тот, кто видит непроверенный перевод.
5. Рецензирование
Каждый ежедневный батч поступает в виде пулл-реквеста. AI-рецензент читает diff и публикует свои выводы, после чего человек выполняет слияние (merge) пулл-реквеста.
Как мы производим оценку
Оставшаяся часть этой статьи опирается на три набора тестов (eval suites), поэтому перед тем, как перейти к цифрам, полезно узнать, что именно проверяет каждый из них.
- Сравнение моделей (254 кейса) запускает конвейер с различными моделями-переводчиками и оценивает каждый ответ с помощью производственного верификатора. Мы использовали этот набор для выбора переводчика.
- Сравнение конвейеров (454 кейса) запускает одну и ту же модель дважды: один раз через полный конвейер, а второй — с простым промптом из двух строк. Результаты оценивают программные проверки, верификатор, судьи из трех других семейств моделей и проверка обратным переводом.
- Набор дефектов (22 кейса) содержит реальные ошибки, которые ежедневная проверка упустила после прохождения верификатора. Каждый кейс исключает повторение отправленной ранее ошибки.
Что мы попробовали и отбросили
Конвейер сейчас выглядит простым, потому что мы удалили три компонента из первоначального проекта после того, как тесты показали их неэффективность.
Более дешевый переводчик
Сначала мы протестировали меньшую по размеру и более дешевую модель GPT-6 Luna (openai/gpt-6-luna). В сравнении моделей она успешно прошла 91,7% кейсов с первой попытки по сравнению с 99,2% у GPT-6.1 Sol. Ее самыми слабыми языками оказались корейский и японский. Самыми сложными проблемами стали ответы, которые General Translation, наш фреймворк перевода, не мог скомпилировать — например, перевод выражения «Legacy alias of {value}». Эти сбои сохранялись при любых повторных попытках.
Более тяжелая модель обошлась примерно в 3,4 раза дороже: $1,94 против $0,57 за те 254 кейса. Мы платим эту разницу, потому что исправление неверной строки, которая никак не сходится к правильному варианту, требует больше времени и усилий, чем правильный перевод с самого начала.
Отдельная модель-судья
До появления верификатора отдельная модель-судья оценивала каждый перевод, и мы переводили заново все, что она помечала как ошибочное или сомнительное. Чтобы проверить эффективность этого подхода, мы разметили бенчмарк тремя типами строк: известные ошибки, исправленные вручную версии прошлых ошибок (которые должны проходить) и чистая выборка. Судья действительно выявлял реальные проблемы. В одном из прогонов бенчмарка он отметил 91% реальных дефектов этого прогона как сомнительные. При этом он также забраковал 11 из 14 исправленных переводов и 42 из 150 чистых, то есть отправлял на перевод огромное количество хорошей работы.
После внедрения верификатора отключение судьи снизило точность с первой попытки с 99,2% до 98,8%, оставив конечный результат прежним. Судья отправлял на повторный перевод около 45% первых черновых вариантов. Теперь мы оставляем его отключенным по умолчанию.
Оставляем сложные строки для человека
Поначалу строка, которую верификатор отклонял при каждой попытке, оставалась непереведенной, пока кто-то не исправлял ее вручную. Полный повторный перевод каталога, состоящего из 16 274 строк на 7 языков, оставил 97 таких строк (0,09%). Теперь конвейер ранжирует отклоненные черновики на основе выводов верификатора, фиксирует наименее ошибочный вариант и помечает его в запросе на слияние (pull request) для проверки. Цикл всегда заканчивается переводом, даже если в нем все еще содержится помеченная ошибка, и эта пометка выводит его на первое место для человека, который выполняет слияние запроса.
Что конвейер добавляет к базовой модели
Большая часть того, что добавляет конвейер, — это сокращение количества явных ошибок. Чтобы измерить это, наша оценка прогоняет одну и ту же модель по 454 случаям дважды: один раз через полный конвейер, а другой — с двухстрочной подсказкой без примечаний к стилю, глоссария или повторных попыток. Базовая модель вернула один некорректный ответ, что оставляет 453 пары для сравнения.
Авторская проверка — это написанное вручную правило для одного оценочного случая. Например, «Queue» на китайском языке не должно переводиться как 队列, форма существительного, которая была выпущена. Количество сбоев при проверке сократилось со 147 до 4, что является результатом работы глоссария и повторных попыток.
Показатели первого прохода верификатора используют разные базы. Для базовой модели это 306 строк, прошедших проверку кода, а для конвейера — все 454. Верификатор принадлежит к тому же семейству моделей, что и переводчик, поэтому его процент успешных проходов показывает нам, как часто модель соглашается сама с собой. Мы используем GPT-6.1 Sol для обеих задач, поскольку это была более точная из двух протестированных нами моделей-переводчиков. Для получения стороннего мнения оценка также отправляет каждую пару переводов без меток трем судьям из других семейств моделей: Claude Opus 5.5, Gemini 4 Argon и DeepSeek V4 Pro. В сумме три судьи обнаружили 109 критических ошибок в выводе конвейера и 203 в выводе базовой модели. Ошибки каждого судьи подсчитываются отдельно, поэтому строка, которую помечают все трое судей, добавляет три к общему количеству.
Что касается общего предпочтения по 453 парам, судьи выбрали конвейер в 139 случаях, а базовую модель — в 117, при этом было 61 совпадение и 136 пар, где оба перевода были идентичны. Этот разрыв намного меньше, чем показывают сбои при проверке и критические ошибки, поэтому ценность конвейера заключается в основном в устранении конкретных ошибок.
Последняя строка переводит каждый ответ обратно на английский язык и спрашивает, сохранился ли смысл. Она оценила базовую модель в 90,8%, а конвейер — в 89,3%. Обратный перевод не может увидеть терминологию или регистр, что составляет большую часть того, что меняет конвейер, поэтому мы считаем этот результат ничьей.
Петля обратной связи
Верификатор ловит большинство ошибок до того, как они будут выпущены, а читатели ловят некоторые из оставшихся.
Включите функцию «выбрать для сообщения» (select-to-report) в диалоговом окне «Язык», затем выделите любой переведенный текст, добавьте примечание и отправьте его. Каждый отчет приходит с указанием языка, страницы и точного текста. Модель сначала сортирует его, выбирает один из четырех вариантов исправления и применяет его в течение нескольких минут. Наш ИИ-рецензент проверяет исправление, а человек выполняет окончательное слияние.
- Неверный смысл. Строка возвращается к английскому языку в тот же день, а затем получает исправленный перевод.
- Неверный термин. Мы добавляем термин в глоссарий с принятой формой и формами, которые следует отклонить для этого языка. Мы закрепляем названия соответствия и протоколов, такие как HIPAA, SOC 2, OAuth и SAML, чтобы конвейер оставлял их на английском языке.
- Неверный тон или пунктуация. Правило попадает в примечания к стилю этого языка.
- Одна плохая строка. Точное переопределение закрепляет утвержденную формулировку, и никакой последующий запуск не может ее изменить.
Ошибки, которые ежедневная проверка обнаруживает после того, как верификатор их пропустил, попадают в набор дефектов. На данный момент в нем 22 случая. Они включают «Queue», переведенное как существительное на кнопке, где требовался глагол, «shadow traffic», переведенное как дорожный трафик, и настройку HIPAA, смысл которой был инвертирован. Каждый случай запрещает ошибку, которая была выпущена, поэтому любая будущая модель, подсказка или изменение глоссария, которые возвращают ее, не проходят оценку.
Сколько это стоит
Когда мы впервые оценили стоимость, полный повторный перевод всех 16 274 строк на 7 языков, всего 113 918 переводов, составил около 430 долларов, включая перевод и верификацию. Мы пришли к этой цифре, оценив партии производственного размера на каждом языке и масштабировав их. Это составляет менее половины цента за строку на язык. Верификация составляет чуть больше половины, около 228 долларов, или 0,002 доллара за строку на язык. С тех пор каталог вырос до 16 918 строк, и полный повторный перевод сегодня стоит около 460 долларов. Ежедневный цикл отправляет только то, что изменилось, и день с 677 измененными строками на 7 языках стоит примерно 18 долларов.
Обе цифры покрывают только вызовы перевода и верификации. Они не включают время инженеров на создание конвейера, вызовы, сделанные ИИ-рецензентом и моделью сортировки, а также человека, который выполняет слияние каждого ежедневного запроса.
Сегодняшние 16 918 строк содержат 136 429 слов на английском языке, поэтому 7 языков в сумме составляют 955 003 слова, что ставит нашу стоимость на уровень около 0,0005 доллара за слово. Вот тот же полный повторный перевод по начальным ставкам за слово, которые публикуют Smartling и Gengo по состоянию на 10 ноября 2026 года.
Это прейскурантные цены; корпоративные контракты обсуждаются, и каждая строка выше, касающаяся машинного перевода, включает человеческую проверку или управление проектом, которые наша цифра не учитывает. Самый близкий вариант для сравнения — машинный перевод Smartling, и наш конвейер стоит около 6% от этой суммы.
Что вы можете использовать повторно
Если вы локализуете свой собственный продукт, четыре части этого дизайна переносятся напрямую.
- Создавайте отпечаток (fingerprint) каждого перевода относительно его английского источника, чтобы устаревшие записи вставали в очередь на повторную обработку.
- Пусть код отклоняет сломанные заполнители, ветки множественного числа, теги и запрещенные термины до того, как какая-либо модель проверит смысл.
- Используйте верификатор, который называет каждую ошибку и ее серьезность, и отправляйте эти возражения обратно переводчику.
- Превращайте каждую ошибку, которую замечает человек, в правило глоссария, примечание к стилю, переопределение или оценочный случай.
Отправьте нам свой отзыв
Некоторые формулировки будут неточными, пока мы находимся в бета-версии, и самый быстрый способ исправить это — сообщить о них с помощью функции «выбрать для сообщения» в диалоговом окне «Язык». Мы просматриваем каждый отчет и превращаем его в правило глоссария, примечание к стилю или переопределение.
Часто задаваемые вопросы
Какие языки поддерживает OpenRouter?
OpenRouter доступен на английском, упрощенном китайском, испанском, бразильском португальском, немецком, французском, японском и корейском языках. Локализация находится в бета-версии.
Как изменить язык в OpenRouter?
Выберите язык в меню учетной записи или откройте локализованный адрес, например openrouter.ai/ja.
Какие модели переводят OpenRouter?
GPT-6.1 Sol (openai/gpt-6.1-sol) переводит каждую строку, а второй вызов той же модели проверяет ее на соответствие английскому тексту. Оба работают через API OpenRouter.
Сколько стоит перевод всего сайта?
Полный повторный перевод сегодняшних 16 918 строк на 7 языков стоит около 460 долларов, включая перевод и верификацию, что составляет менее половины цента за строку на язык. Та же работа стоит около 7 200 долларов по опубликованной ставке машинного перевода Smartling и от 57 300 до 191 000 долларов по опубликованным ставкам ИИ и человеческого перевода.
Как сообщить о плохом переводе?
Включите функцию выбора для отправки отчета в диалоговом окне «Язык», выделите текст, который кажется неверным, добавьте примечание и отправьте его.