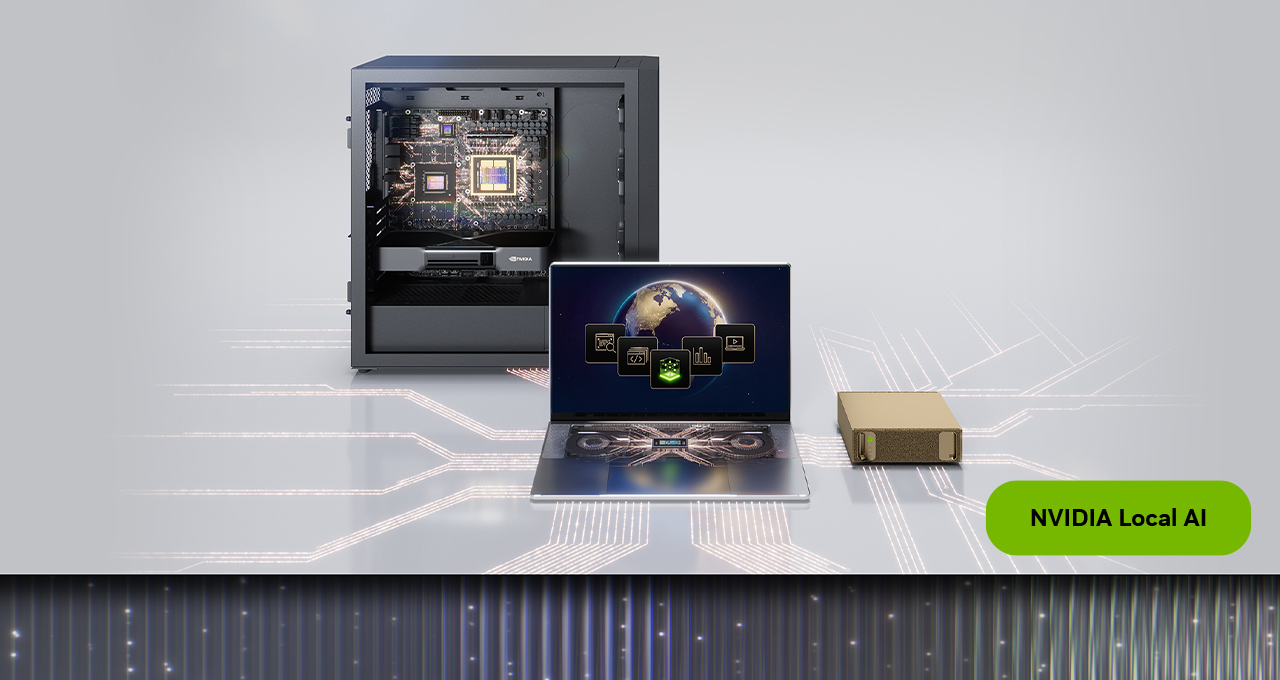
На GTC Berlin компания NVIDIA представляет всю линейку локального оборудования для ИИ. RTX Spark, выпущенный на прошлой неделе, обеспечивает работу персональных агентов на ПК с Windows; DGX Spark помогает разработчикам создавать и масштабировать приложения на Linux; а DGX Station служит для корпоративных команд, выполняющих передовые рабочие нагрузки на Linux, причем версия для Windows появится в декабре.
Среди анонсов:
- Настольный агент Underdog теперь доступен для RTX Spark
- DGX Spark 64GB доступен в пятницу, 23 октября
- NVIDIA Sync получит поддержку восьми DGX Spark и инструмент Model Launcher в этом месяце
- Октябрьское обновление ПО DGX Spark добавляет Wi-Fi Assistant и обновляет навыки DGX Spark Skills
- DGX Station улучшает управляемость благодаря семи новым интеграциям
- DGX Station для Windows запускается в декабре с поддержкой множества приложений для производства и агентов
- Три новых проекта с открытым исходным кодом для робототехники на DGX Station
- NVIDIA Cloud Functions становится доступна по предварительному заказу для DGX Station
- Recursive Flint, новая локальная модель программирования, теперь доступна для локального оборудования NVIDIA
- Поддержка Day-0 для новых моделей ИИ Nemotron, GLM, DeepSeek, Qwen, MiniMax и FLUX.3
- Новые ускорения для движков вывода llama.cpp и vLLM, а также новая коллекция контрольных точек, оптимизированных для локального оборудования ИИ.
Узнайте больше об этих анонсах локального ИИ ниже и ознакомьтесь с демоверсиями и сессиями на GTC Berlin.
RTX Spark приносит персональных агентов на ПК с Windows
RTX Spark — это новое начало для ПК: работа персональных агентов, ускоренное создание контента и игры в разрешении 1440p при 100 кадрах в секунду с объемом унифицированной памяти до 128 ГБ и производительностью ИИ в 1 петафлоп.
Вот что говорят первые рецензенты о платформе после ее выпуска 16 октября:
«Машина мечты для серьезных создателей контента...» — CGMag
«Создано для будущего ИИ...» — The Verge
«Чрезвычайно способная, удивительно портативная и эффективная машина...» — PCMag
Underdog, новое настольное агентское приложение, созданное для полностью локального и конфиденциального ИИ, также переносит свой опыт на RTX Spark. Работающий на базе специализированного движка вывода Husky, Underdog запускает модели полностью на устройстве, поэтому персональные агенты могут выполнять работу без передачи пользовательских данных за пределы ПК. Underdog теперь доступен для download.
Чтобы разработчики и энтузиасты могли лучше создавать и настраивать локальные агенты, многие ноутбуки с RTX Spark поставляются с разблокированным загрузчиком.
Во время основного доклада на GTC основатель и генеральный директор NVIDIA Дженсен Хуанг продемонстрировал, как ИИ-агенты, работающие на RTX Spark, могут использоваться для обучения робота Microduck компании Hugging Face с помощью NVIDIA Isaac Lab, Hermes Agent и Nemotron 3.5 Bolt 74B.
Ноутбуки ASUS, Dell Technologies, HP, Lenovo, Microsoft и MSI уже доступны в продаже, а Acer появится в ближайшее время.
Узнайте больше о RTX Spark и начните работу с новейшими руководствами по RTX Spark.
DGX Spark дает разработчикам пространство для творчества
Новые системы DGX Spark на 64 ГБ, способные запускать такие модели, как Nemotron 3.5 Bolt 74B 24GB, Qwen3.8 27B и Gemma 4 26B-A4B, поступают в продажу от партнеров в пятницу, 23 октября.
Когда для рабочих нагрузок требуется большая емкость, разработчики могут объединять несколько систем DGX Spark с помощью встроенной сети NVIDIA ConnectX-7 и NVIDIA Sync Cluster Assistant. Это позволяет пользователям запускать передовые модели кодирования, такие как Qwen 3.8 Flash Next, DeepSeek v4 Flash 0731 и GLM 5.3 Flash.
Теперь DGX Spark поддерживает кластеры размером до восьми устройств в ручной конфигурации, что позволяет использовать более крупные модели, больший контекст, параллельных агентов и распределенную разработку. Идеально подходит для небольших команд, использующих один кластер в качестве бэкенда, где каждый разработчик запускает параллельные сеансы для одной и той же модели, обеспечивая 1 ТБ унифицированной памяти — достаточно для запуска моделей пограничного класса, таких как GLM 5.3.
Начните работу с руководством по кластерам DGX Spark.
NVIDIA Sync Model Launcher также станет доступен позже в этом месяце. Он упрощает доступ к локальному ИИ на одном DGX Spark или в кластере. Всего несколькими кликами Model Launcher загружает модель и контейнер, подходящие под конфигурацию, и подключает модель к OpenCode. Он автоматически загружает DGX Spark Skills для устранения неполадок, обслуживания устройств, доступа к официальной документации и другим рекомендациям по рабочим процессам.
Октябрьское обновление ПО DGX Spark приносит новый помощник Wi-Fi Assistant, который позволяет пользователям переключать сети, когда DGX Spark работает в режиме устройства. Кроме того, DGX Spark Skills предоставляют ориентированные на рабочий процесс рекомендации по устранению неполадок и обслуживанию устройств прямо в NVIDIA Sync через OpenCode.
Системы DGX Spark доступны напрямую от Acer, ASUS, Dell Technologies, GIGABYTE, HP, Lenovo, MSI и NVIDIA.
DGX Station приносит передовой интеллект на ваш рабочий стол
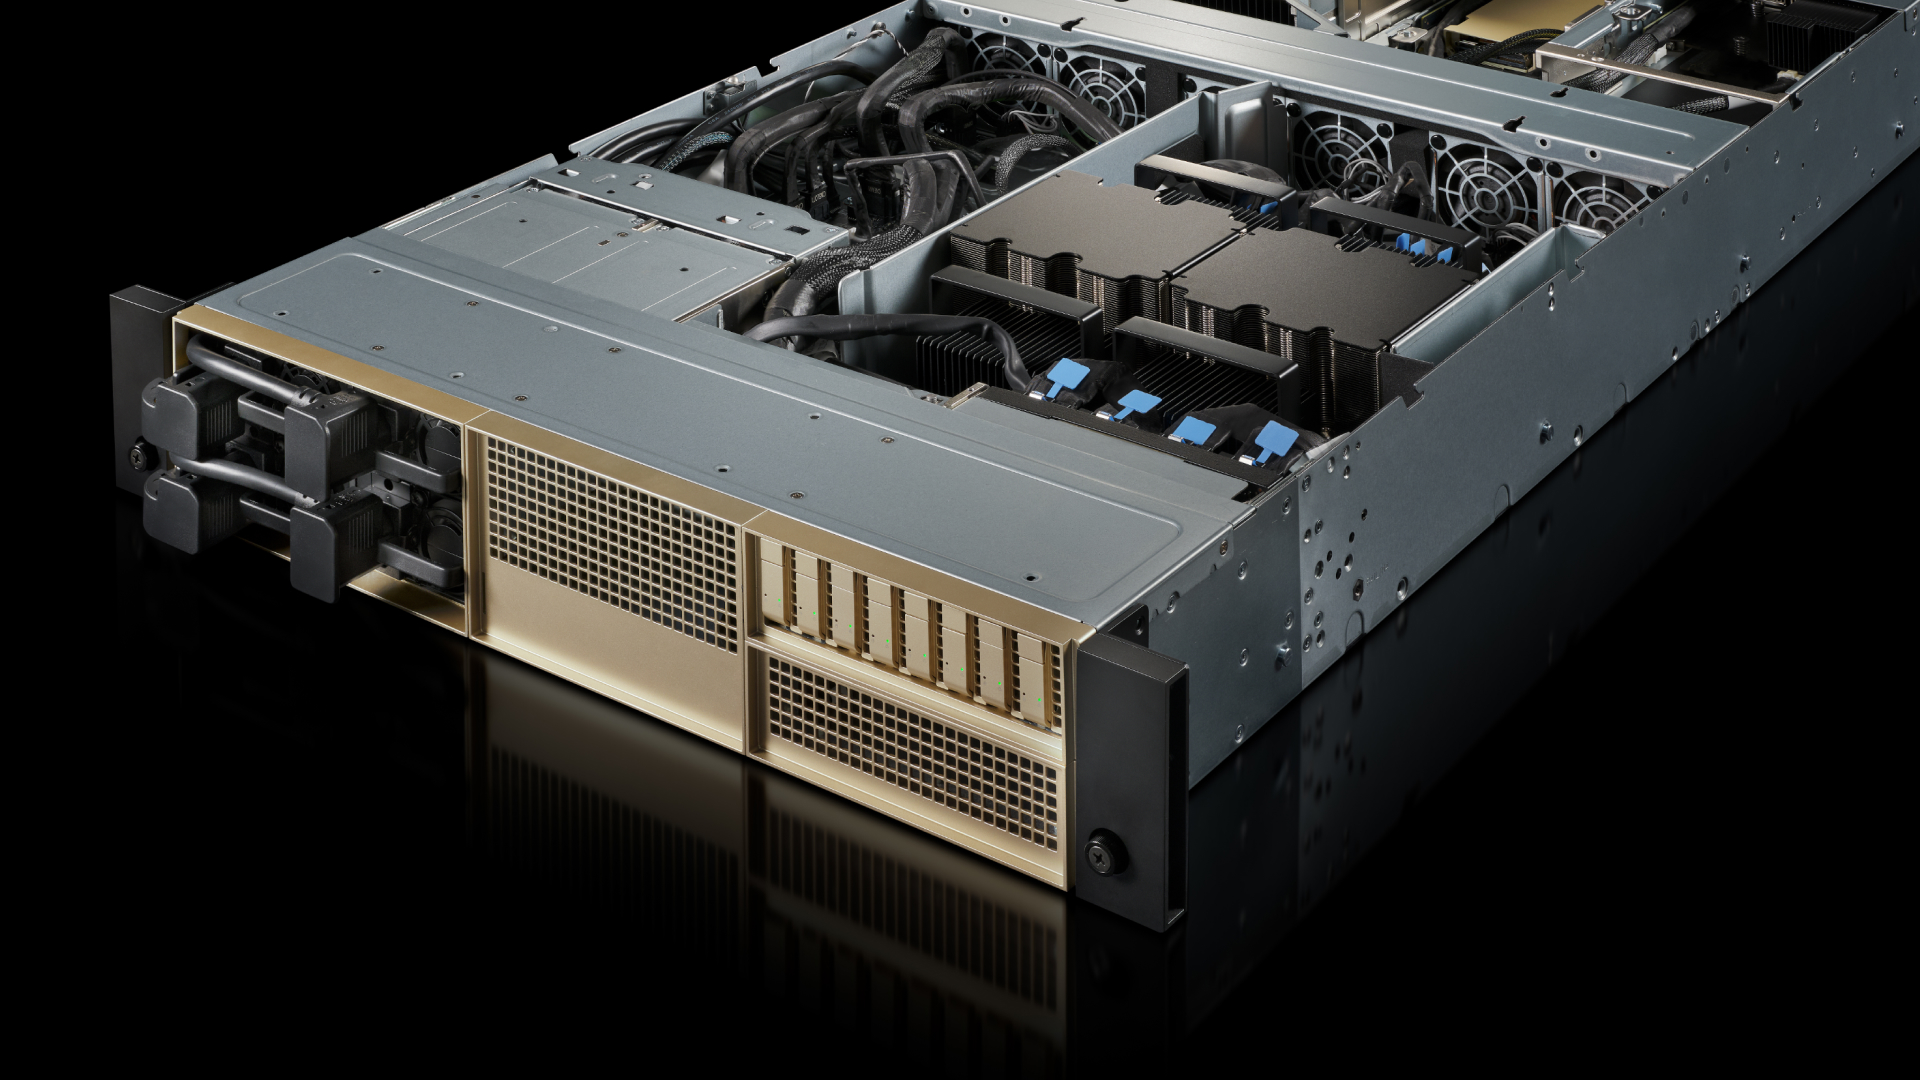
Для крупных команд DGX Station предлагает 748 ГБ когерентной памяти и до 20 петафлоп производительности ИИ, позволяя разработчикам запускать передовые модели, такие как GLM 5.3, и обслуживать более 30 пользователей на скоростях, сопоставимых с облачными моделями. Для масштабирования NVIDIA Sync теперь поддерживает DGX Station, упрощая соединения между двумя системами на базе Linux.
Новые интеграции с Absolute Security, Splunk от Cisco, Fleet Device Management, Microsoft Intune, Perforce Puppet, Progress Software Chef и Tanium позволяют ИТ-командам управлять системами DGX Station в рамках корпоративных процессов настройки, управления и соответствия требованиям, помогая ускорить согласования и снизить риски развертывания при минимизации времени до получения первого токена.
Благодаря будущим системам на базе Windows разработчики смогут создавать рабочие процессы, использующие профессиональные приложения, работающие на графических процессорах NVIDIA RTX PRO и управляемые агентами, которые запускают свои большие языковые модели (LLM) на системах NVIDIA GB300 — и все это на одном устройстве.
DGX Station для Windows, ожидаемая от партнеров-производителей систем в декабре, расширяет возможности локального ИИ в приложениях и операционной среде, которые предприятия уже используют. Инженеры могут запускать локальные модели и агенты в нативном программном устройстве Windows с доступом к моделям ИИ, инструментам и агентам на одной системе.
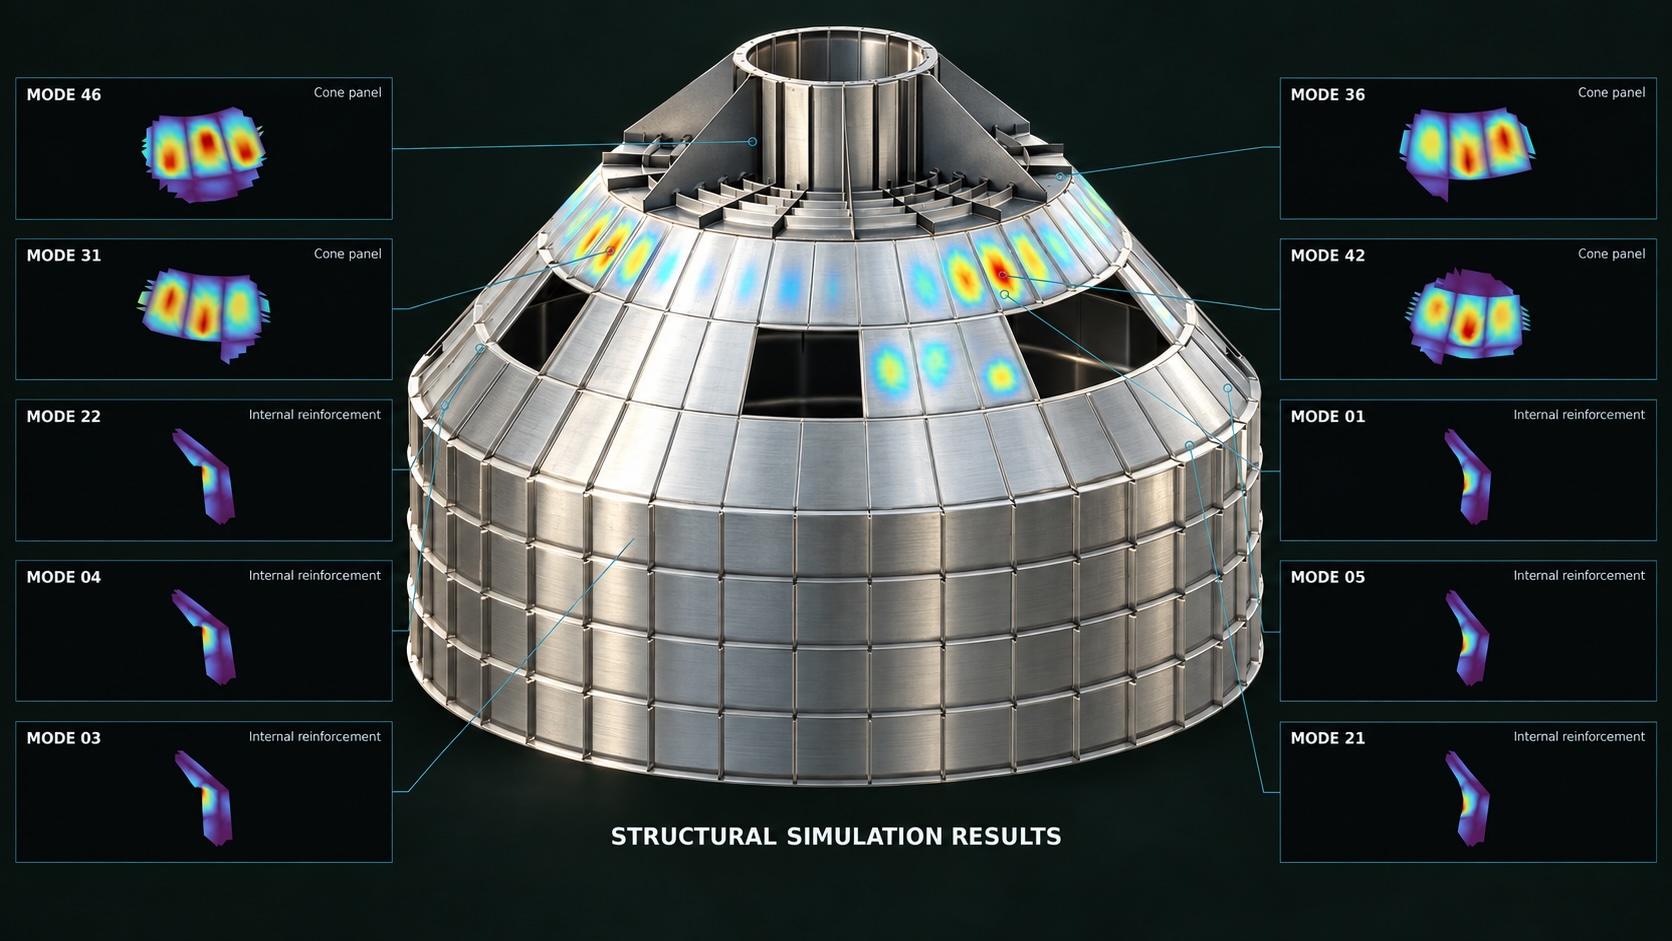
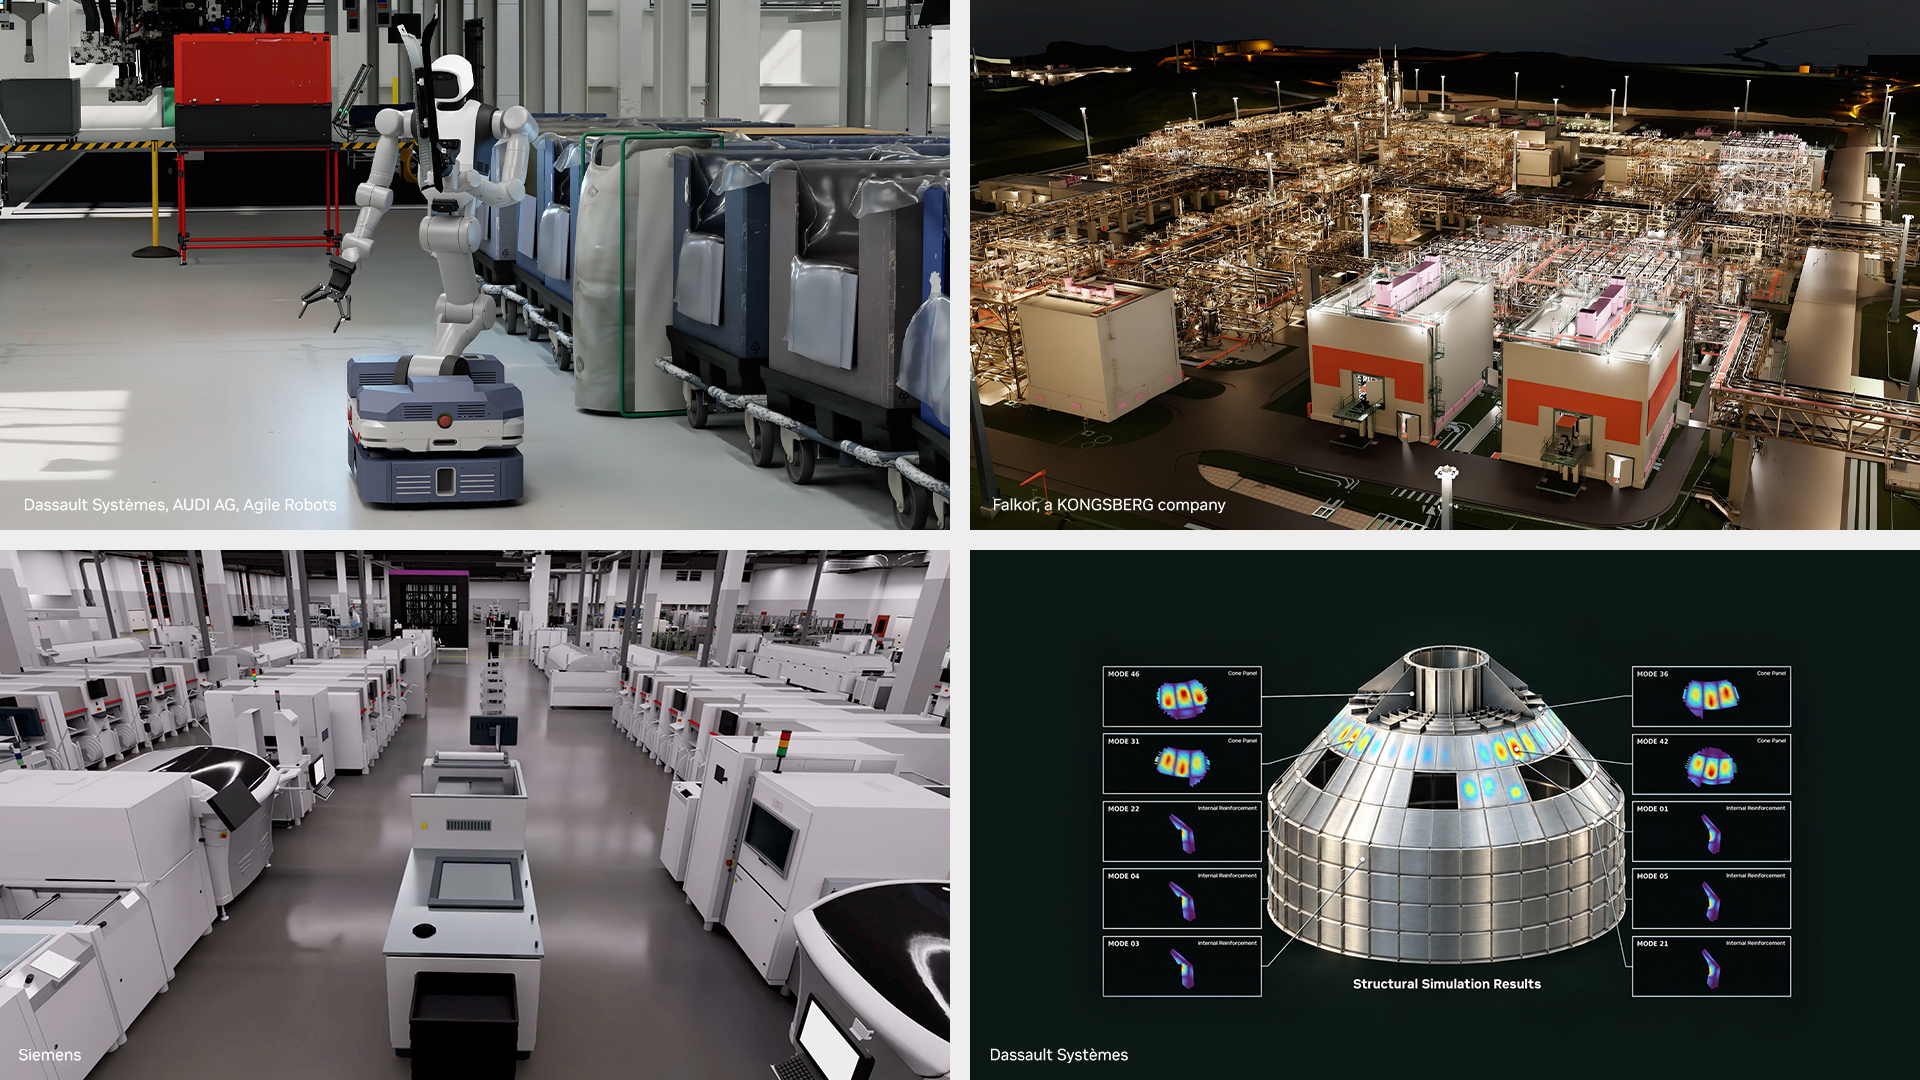
DGX Station для Windows будет поддерживать производственные приложения от nTop, Dassault Systèmes, Keysight Technologies, MathWorks, Rockwell Automation, Siemens, Synopsys, Unity и Altera для проектирования, моделирования, валидации и автоматизации инженерных задач с помощью ИИ. Пользователи смогут локально запускать агенты с использованием Hermes Agent, Perplexity или Aible для агентного управления в корпоративных средах.
Такая же локальная контролируемая модель вычислений распространяется и на робототехнику. DGX Station предоставляет робототехническим командам специализированные вычислительные мощности для постобучения, симуляции и оценки, сокращая циклы итераций без ожидания общей инфраструктуры.
NVIDIA выпустила три эталонных рабочих процесса с открытым исходным кодом, которые переносят GPT-6 Astra, NVIDIA Isaac Lab, Isaac Lab-Arena и Cosmos на NVIDIA DGX Station. Разработчики могут использовать их для доработки моделей GR00T 1.7 с помощью обучения с подкреплением, тренировки навыков ловкого манипулирования и постобучения мировых моделей Cosmos для генерации синтетических данных.
NVIDIA Cloud Functions выходит в режиме раннего доступа для систем DGX Station на базе Linux. Команды могут регистрировать локальные конечные точки моделей в общем каталоге и обращаться к ним через единую точку входа, совместимую с OpenAI.
Разработчики могут обновлять модель за конечной точкой без изменения кода приложения, в то время как коллеги могут использовать общие модели без прямого доступа к машине. Это превращает DGX Station в локально контролируемую службу выводов для всей команды.
DGX Station обеспечивает локальную итерацию при разработке фабрик искусственного интеллекта. На выставочной площадке GTC Berlin компания NVIDIA представляет превью DSX OS, работающей на базе DGX Station, для симуляции операций фабрики ИИ до появления полноценной инфраструктуры. Другая демонстрация покажет системы DGX Station, обеспечивающие работу локальной фабрики токенов для более чем 30 разработчиков программного обеспечения.
Системы DGX Station поставляются сегодня компаниями ASUS, Dell Technologies, GIGABYTE, HP, MSI, Supermicro и Exxact. Поставки систем DGX Station для Windows ожидаются позже в этом году от ASUS, Dell Technologies, GIGABYTE, HP, MSI и Supermicro.
Представляем Recursive Flint — новую локальную модель для написания кода, оптимизированную для RTX Spark
Сегодня передовая лаборатория ИИ Recursive Superintelligence выпустила Recursive Flint, локальную LLM, созданную для быстрого и точного написания кода. Модель с 40 миллиардами параметров mixture-of-experts и 2,5 миллиарда активных параметров, Recursive Flint обеспечивает быстрый вывод — более 220 токенов в секунду на 64GB RTX Spark — наряду с лучшими в своем классе результатами в бенчмарках агентского программирования, таких как SWE-Bench Pro v2, Terminal-Bench 2.1 и SWE-bench verified.
Recursive Flint была создана с помощью системы Eureka Machine от Recursive, предназначенной для крупномасштабных автоматизированных исследований в области ИИ. Она автоматизирует полный цикл исследований: предлагает идеи, реализует их, запускает эксперименты для проверки идей и использует результаты для принятия решений о том, что попробовать дальше, создавая специализированные ядра, которые увеличили скорость генерации Flint на RTX Spark на 55% без изменения весов модели.
Разработчики могут загрузить открытые веса на Hugging Face по лицензии Apache 2.0 и запускать модель на системах RTX Spark и DGX Spark, а также на видеокартах GeForce RTX и RTX PRO. Разработчики также могут дообучать модель с помощью NeMo Automodel для контролируемой точной настройки и низкоранговой адаптации (LoRa), а также NeMo RL для групповой оптимизации относительной политики.
Новые модели с поддержкой с первого дня
NVIDIA также добавляет поддержку моделей в день выпуска для NVIDIA Nemotron Bolt E4B 4B, GLM, DeepSeek, Qwen, MiniMax, Liquid AI LFM2.5-24B-A2B, а также диффузионной модели FLUX.3 Klein.
Nemotron Bolt E4B 4GB сочетает в себе навыки естественной беседы и многошаговых агентов всего в 4 ГБ памяти, обеспечивая работу быстрых локальных голосовых помощников, интерактивных игровых персонажей и встроенных интерфейсов на видеокартах NVIDIA GeForce RTX, устройствах NVIDIA Jetson, а также на RTX и DGX Spark. Bolt E4B 4GB выходит в пятницу, 23 октября.
FLUX 3 Image Klein от Black Forest Labs — это модель изображений с открытыми весами и 5,6 миллиарда параметров для генерации и редактирования. Оптимизированные NVIDIA сборки позволяют ей работать на видеокартах GeForce RTX всего с 8 ГБ видеопамяти и создавать изображение размером 1 мегапиксель примерно за четыре секунды на графическом процессоре RTX 5090.
MiniMax M3.1 Flash — это новая открытая модель, созданная для NVIDIA DGX Station и DGX Spark, которая привносит ИИ с длинным контекстом на ПК. LFM2.5-24B-A2B от Liquid AI — это модель рассуждений с открытыми весами, которая задействует всего 2 миллиарда из своих 24 миллиардов параметров на токен, что делает ее достаточно быстрой для запуска конфиденциальных ИИ-агентов с вызовом инструментов прямо на ПК.
Кроме того, NVIDIA выпустила новую коллекцию контрольных точек моделей, оптимизированных по эффективности использования RAM на локальном аппаратном обеспечении ИИ, что позволяет передовым открытым моделям работать с достаточным запасом памяти для кэша KV. Каждая контрольная точка квантуется при сохранении точности, близкой к полной точности, начиная с Qwen3.8-Flash-Next-FP4-Local на одной системе DGX Spark 128GB или RTX PRO 6000 и GLM-5.3-Flash-FP4-Local на двух системах.
Разработчики могут проводить пост-тренировку в день запуска с помощью NeMo AutoModel на DGX Station и RTX Spark, используя примеры рецептов для Nemotron Bolt E4B, Flux 3 Image Klein и многое другое.
Ускоренный вывод ИИ
NVIDIA продолжает сотрудничать с открытыми сообществами llama.cpp и vLLM для ускорения рабочих нагрузок агентов на локальном оборудовании.
В llama.cpp новая поддержка спекулятивного декодирования с MTP для Qwen 3.8 Flash Next делает сквозные задачи агентов в 1,4 раза быстрее на NVIDIA RTX PRO 6000 Blackwell.
В vLLM более быстрое спекулятивное декодирование и новые ядра предварительного заполнения FlashInfer для слоев линейного внимания Qwen ускоряют выполнение агентских задач с Qwen3.8 27B в 1,3 раза на DGX Spark. На DGX Station модель GLM 5.3 Flash обеспечивает до 1,2 раза более высокую пропускную способность.
Ознакомьтесь с рецептами локального вывода ИИ от NVIDIA, чтобы опробовать эти новейшие оптимизации.
Следите за новостями NVIDIA RTX Spark в X, Instagram, TikTok и Facebook — и оставайтесь в курсе событий, подписавшись на информационную рассылку NVIDIA Local AI. Следите за новостями NVIDIA Workstation в LinkedIn и X.
См. notice в отношении информации о программных продуктах.