Основные выводы
Голосовой вывод в реальном времени передает аудио звонящего через системы распознавания речи (speech-to-text), языковую модель и синтез речи (text-to-speech), пока абонент еще говорит. При телефонном звонке бюджет задержки начинает расходоваться еще на уровне оператора связи.
- Два участка сети оператора и любые переходы между облаками — это обычно та часть ожидания, которую никто не учитывает. Более быстрая модель оставляет их там, где они были.
- Перебивание и паузы возникают из-за определения момента окончания фразы и джиттера, и оба этих фактора проявляются только во время «живых» звонков.
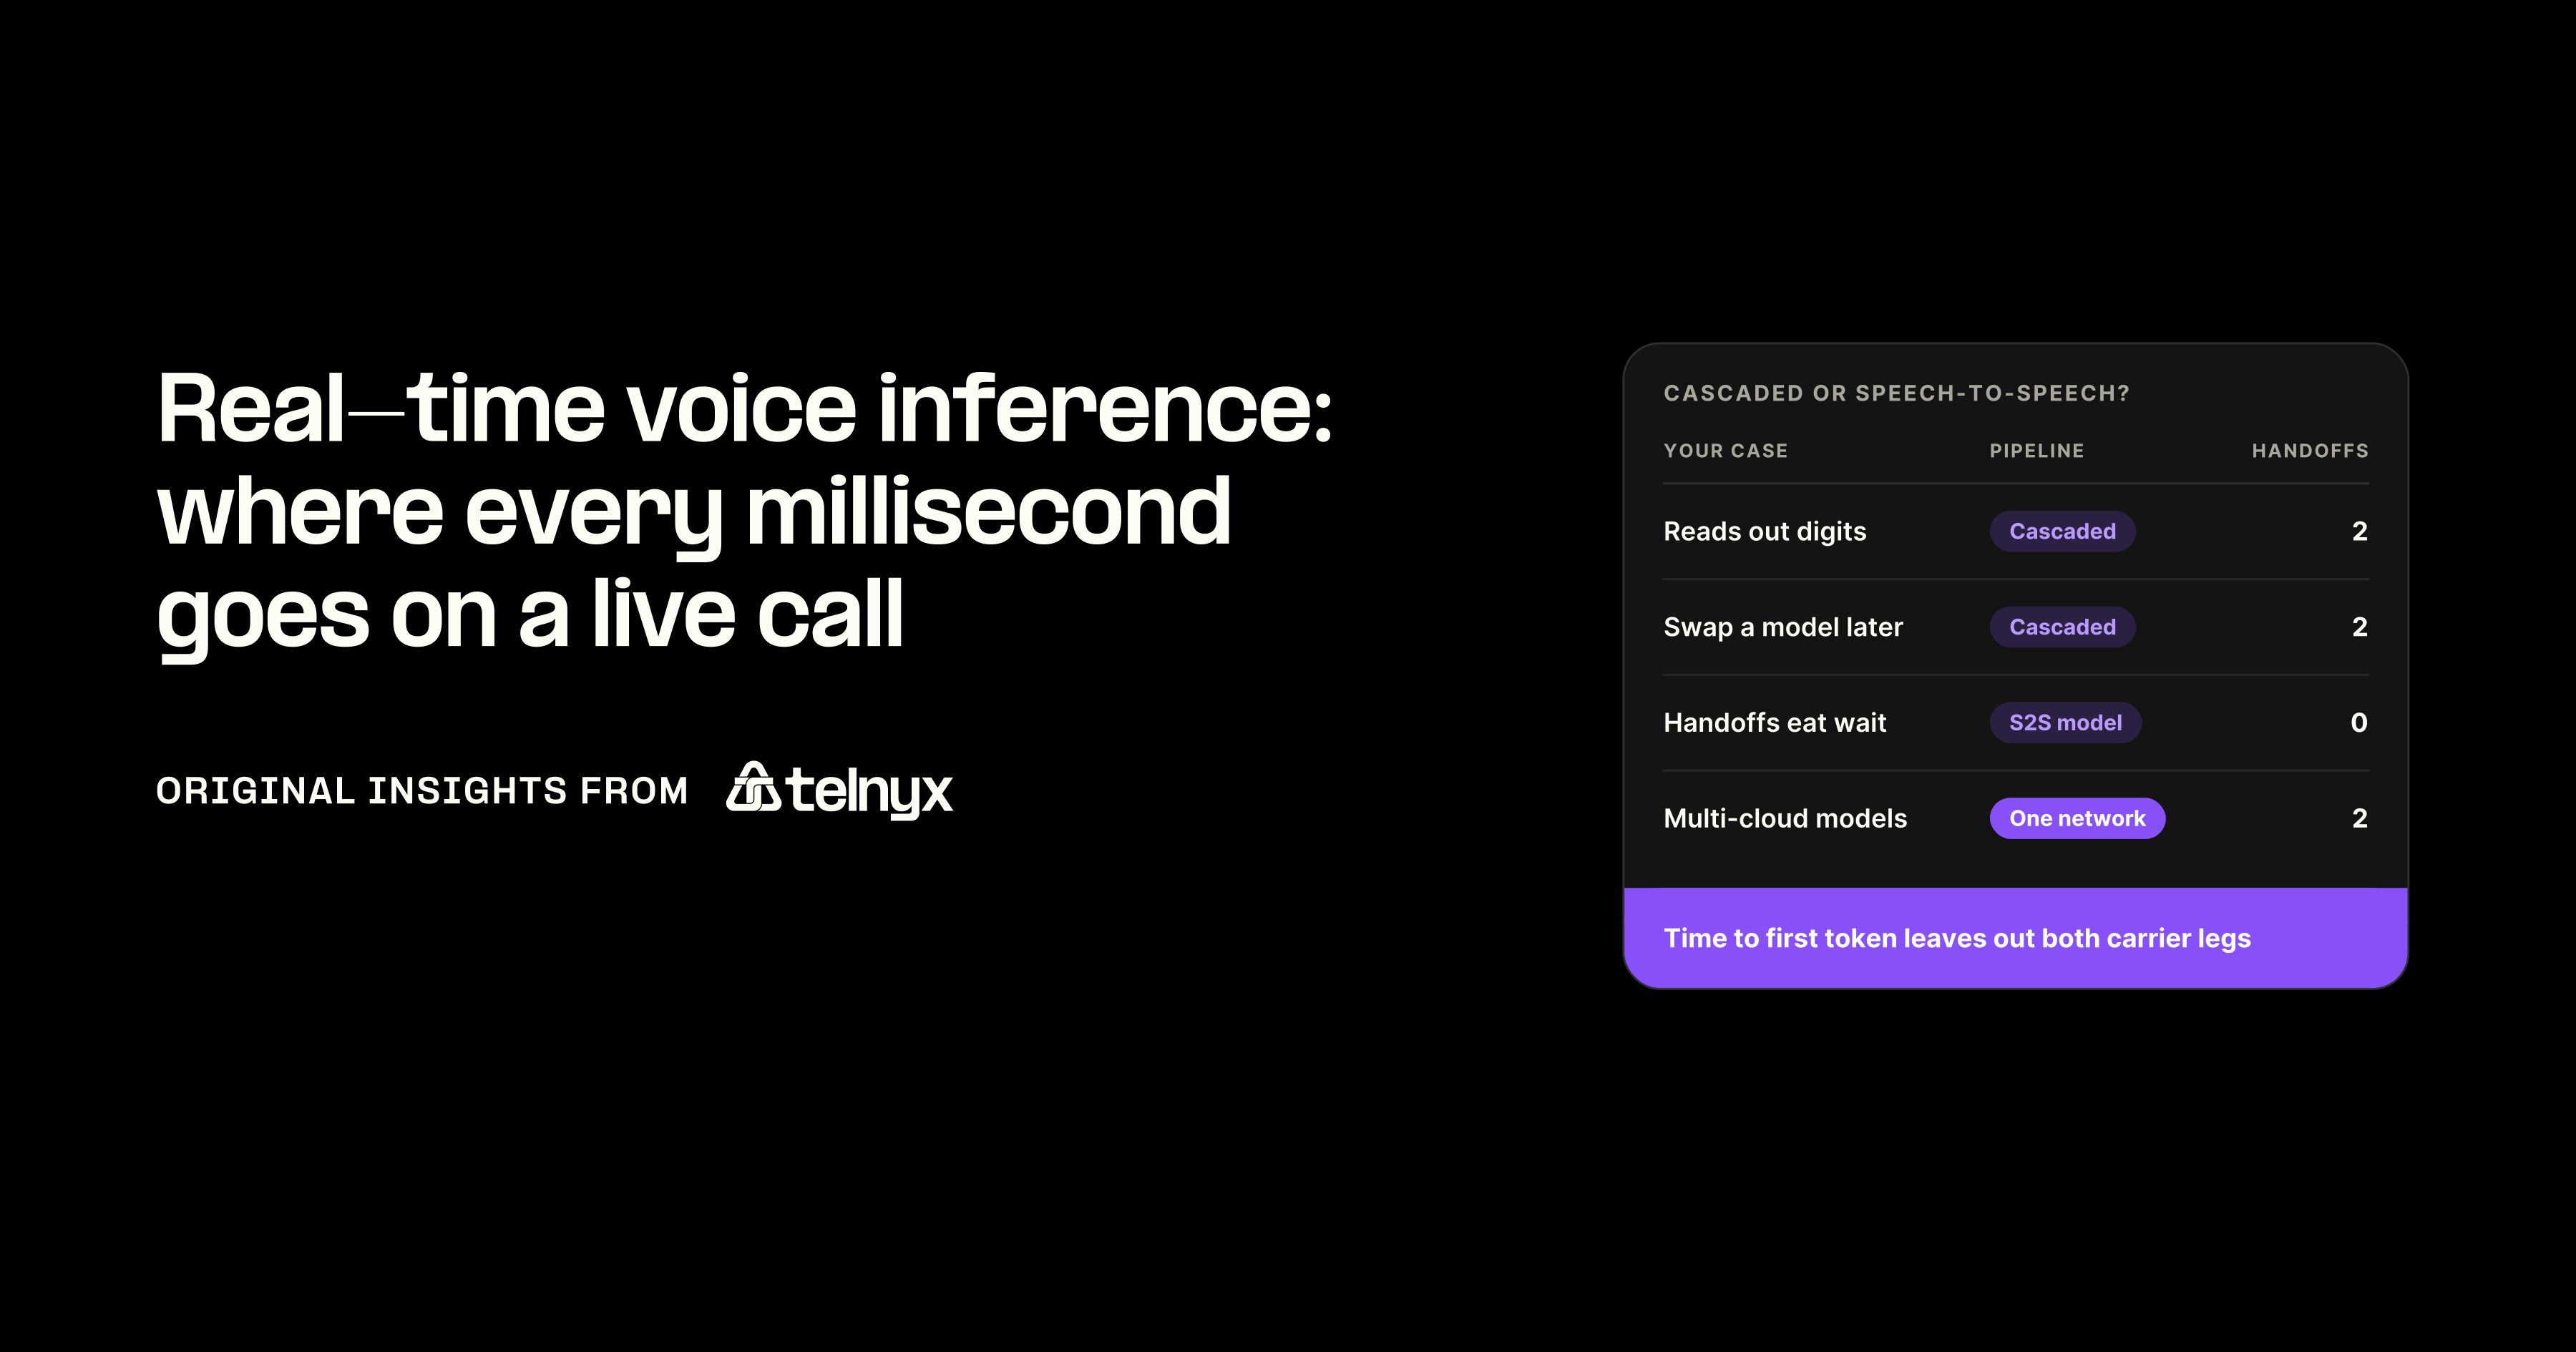
- Время до первого токена не учитывает оба участка сети оператора. Измеряйте время ожидания со стороны звонящего.
Что такое голосовой вывод в реальном времени?
Абонент начинает говорить, и его голос покидает телефон в виде небольших аудиофреймов, по одному каждые 20 мс, еще до того, как предложение будет полностью сформировано. Голосовой вывод в реальном времени означает, что каждая модель в вашем конвейере начинает работу над этим частичным вводом и передает свой вывод дальше, прежде чем абонент закончил говорить.
Должен ли мой голосовой агент быть каскадным или speech-to-speech?
- Абоненты диктуют номера счетов: используйте каскадный конвейер. Текст между моделями точно показывает, какие цифры были распознаны, поэтому неправильно услышанный номер можно отследить.
- Хотите заменить одну модель позже: сохраняйте speech-to-text, LLM и text-to-speech как отдельные модели. Замена одной оставляет две другие нетронутыми, ценой двух передач данных.
- Передачи данных съедают большую часть измеренного времени ожидания: попробуйте модель speech-to-speech. Аудио на входе и аудио на выходе исключают обе текстовые передачи, но вы теряете транскрипт для отладки.
- Каскадный конвейер, модели распределены по облакам: запустите все три на Telnyx Inference. Speech-to-text, LLM и text-to-speech используют одну сеть, поэтому переходы между облаками не выходят за рамки бюджета.
Почему вывод по принципу «запрос-ответ» нарушает «живой» звонок
Вывод по принципу «запрос-ответ» ожидает всю запись целиком. API пакетной транскрипции берет готовый файл и возвращает готовый транскрипт, поэтому каждая секунда обработки доходит до абонента как «мертвый эфир». Текстовый чат может поглотить эту задержку, потому что пользователь читает. Телефонный звонок — нет, и это главное различие между разговорным ИИ и голосовым ИИ.
Каскадный конвейер или модель speech-to-speech?
Конвейеры реального времени бывают двух видов, и бюджет из следующего раздела применим к обоим:
- Каскадный (speech-to-text, LLM, text-to-speech): текст передается между тремя моделями. Вы можете заменить любую модель и прочитать транскрипт, но вы платите за две передачи данных.
- Модель speech-to-speech: аудио входит и аудио выходит. Две передачи данных исчезают, как и ваше представление о том, что услышала модель, что затрудняет отладку неправильно услышанного номера счета.
В любом случае телефонный звонок добавляет то, чего никогда не покажет демо в браузере: прежде чем какая-либо модель увидит аудио абонента, оно проходит через сеть оператора. В Telnyx языковая модель работает как OpenAI-совместимые чат-комплишены на моделях с открытыми весами, размещенных на GPU, принадлежащих Telnyx, а speech-to-text и text-to-speech работают на той же платформе.
Запустите весь свой голосовой конвейер в одной сети
Telnyx запускает OpenAI-совместимый вывод, speech-to-text и text-to-speech на одной платформе, поэтому каждая модель в вашем конвейере использует одну сеть.
Попробуйте Telnyx Inference
Измеряйте время ожидания со стороны звонящего
Найдите участки сети оператора и переходы между облаками, которые более быстрая модель оставляет в вашем бюджете голосовой задержки.
Куда уходит бюджет задержки в конвейере голосового вывода в реальном времени
Ожидание вашего абонента длится с момента, когда он перестал говорить, до первого слога ответа. В этом окне находятся шесть «прыжков» (hops), и два из них принадлежат телефонной сети.
Шесть «прыжков» между моментом, когда звонящий замолчал, и началом ответа
Отсчитайте время от последнего слова звонящего и оцените своего агента по каждой строке:
Шесть «прыжков» в одном телефонном диалоге
Почему сеть — это «прыжок», который никто не учитывает
Команды, борющиеся с «мертвым эфиром», обычно начинают с модели. Они заменяют ее на более быструю, перезапускают бенчмарк и наблюдают улучшение, в то время как «живые» звонки все еще кажутся медленными, потому что бенчмарк охватывал только строки с третьей по пятую.
«Мы часто зацикливаемся на скорости вывода LLM, но в голосовом ИИ сеть часто является «тихим убийцей». Ян Рейтер, операционный директор Telnyx
Опубликованные бюджеты задержки вендоров начинаются от микрофона и не учитывают оба участка сети оператора. ITU-T G.114 рекомендует поддерживать одностороннюю задержку от рта до уха на уровне 150 мс для большинства приложений, и каждый телефонный диалог оплачивает одностороннюю задержку дважды: один раз на входе и один раз на выходе. Эти участки могут занимать большую часть естественного диалога еще до запуска модели, поэтому измерение «от конца до конца» должно быть одним из ваших принципов производства голосового ИИ.
Телефония до того, как начнется голосовой вывод
Прежде чем какая-либо модель услышит звонящего, оператор маршрутизирует, пакетирует и терминирует его аудио. Этот путь определяет, сколько бюджета осталось и насколько чистым будет аудио, когда оно придет.
От PSTN или SIP до медиа-плоскости
Звонок проходит через коммутируемую телефонную сеть общего пользования (PSTN) или SIP-транк к оператору, чья медиа-плоскость терминирует поток протокола передачи в реальном времени (RTP). Только тогда аудио может попасть в модель speech-to-text, а ответ совершает тот же путь в обратном направлении. WebRTC-клиенты пропускают телефонную сеть, но сервер все равно должен терминировать их медиа.
Если ваш провайдер телефонии, вендор speech-to-text и языковая модель принадлежат трем разным компаниям, аудио пересекает общедоступный интернет между каждой из них, каждый раз добавляя расстояние и джиттер. Telnyx запускает text-to-speech, голосовой ИИ и телефонию на одной инфраструктуре, с одним API-ключом и одним счетом. Звонки поступают через Voice API в сети операторского класса, принадлежащей Telnyx, поэтому участок оператора и участок вывода используют один путь.
Аудио 8 кГц G.711 и то, что ожидает ваша модель STT
Большинство телефонного аудио поступает в формате G.711, с частотой дискретизации 8 кГц в 20-мс фреймах. Многие модели speech-to-text ожидают 16 кГц PCM, и апсемплинг не может восстановить частоты, которые узкополосная линия уже отсекла. Точность распознавания имен и цифр частично определяется до начала вывода, поэтому, когда вы сравниваете движки из обзоров программного обеспечения для преобразования голоса в текст, тестируйте их на записанном телефонном аудио 8 кГц.
Где должен работать голосовой вывод в реальном времени?
Оценивайте каждый вариант хостинга по одному вопросу: сколько сетевых переходов находится между оператором вашего абонента и GPU, на котором работает ваша модель?
Edge PoP, регион GPU гиперскейлера или размещение вместе с сетью
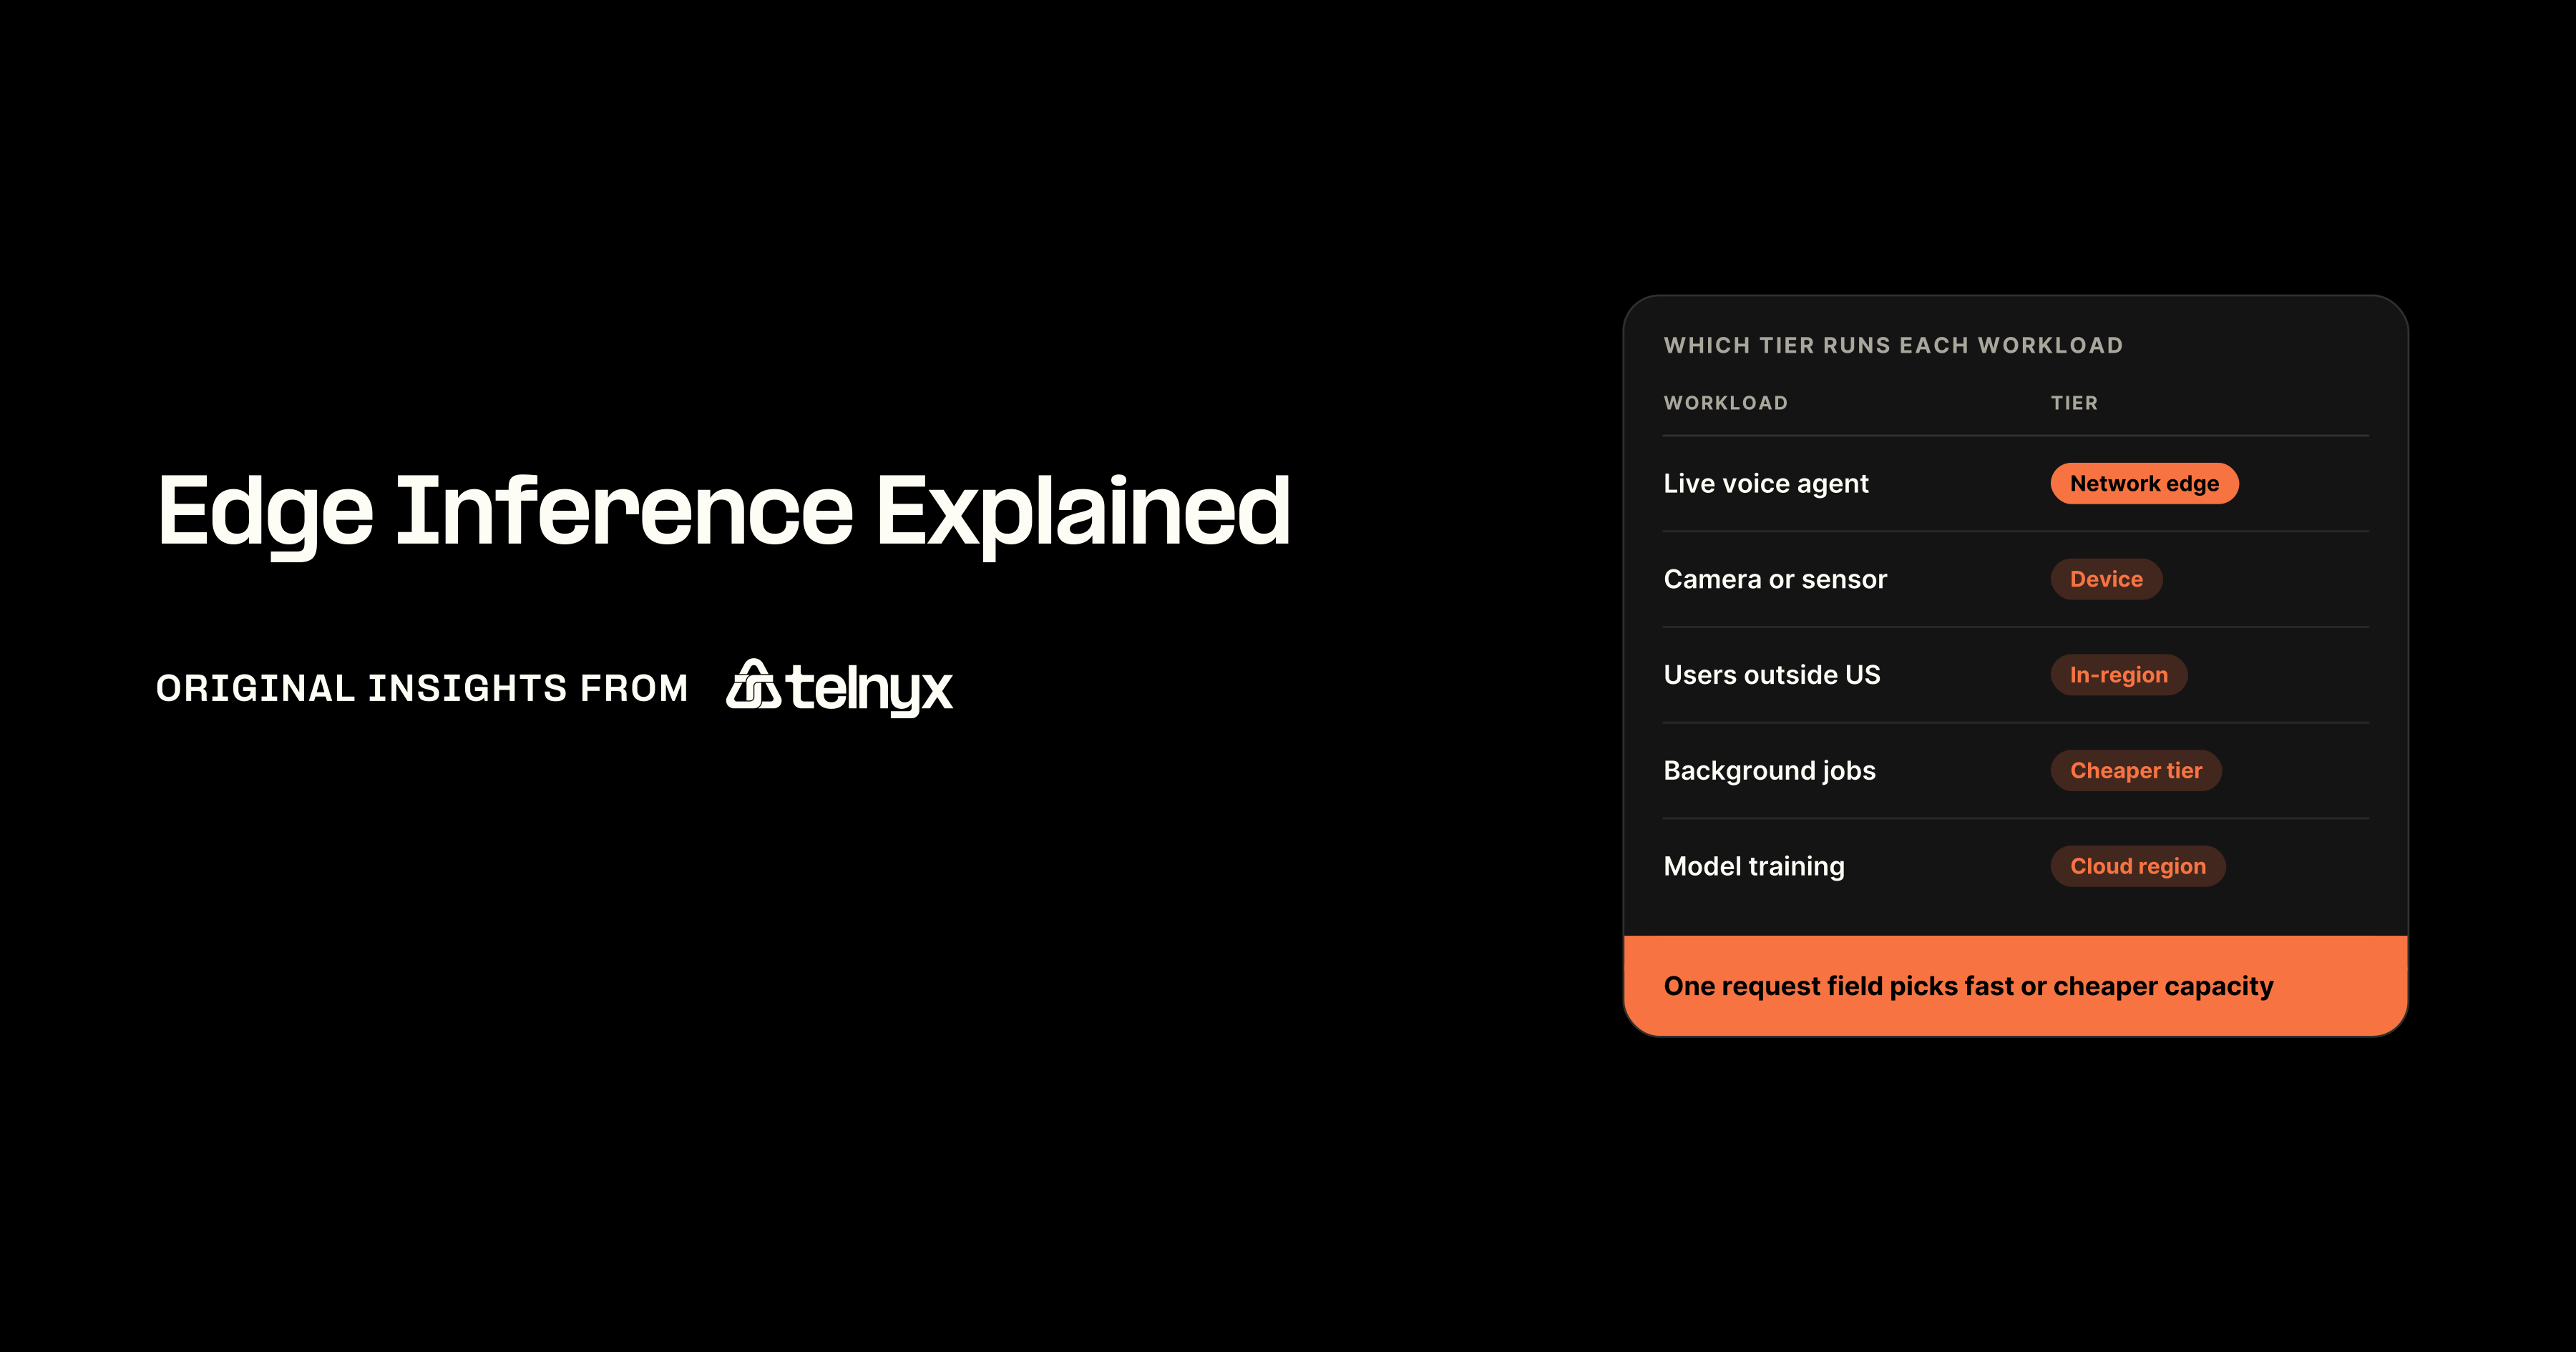
- Edge point of presence (PoP): близко к звонящему, с одним переходом от оператора, но ограниченная мощность GPU для больших моделей. В статье «Edge inference explained» объясняется, когда это подходит.
- Регион GPU гиперскейлера: много GPU, с двумя или более переходами: от провайдера телефонии к облаку, и часто от облака к вендору TTS.
- GPU, размещенные вместе с сетью оператора: медиа-плоскость и модель находятся в одной сети, без переходов между ними. Компромисс — это ограниченная библиотека моделей.
Резервный провайдер в другом облаке следует той же арифметике: он добавляет переход, поэтому может увеличить задержку диалога, даже если его модель отвечает быстрее. Штраф также применяется к каждому компоненту по отдельности.
«Когда вы вызываете их API из голосового конвейера, вы добавляете сетевой запрос к стороннему облаку. Это нормально для создания подкаста. Но в живом разговоре это приводит к задержкам». Д-р Сонам Гупта, Developer Advocate в Telnyx
Что дает размещение GPU в сети оператора
Telnyx запускает модели на GPU, размещенных непосредственно в своей сети в регионах Северной и Южной Америки, Европы, Ближнего Востока и Африки, а также Азиатско-Тихоокеанского региона. Между медиа-плоскостью и GPU нет промежуточных узлов других провайдеров. Емкость масштабируется автоматически без «холодного старта», поэтому скачок трафика не заставит абонентов ждать прогрева GPU. Если ваш агент работает на LiveKit, документация по интеграции LiveKit покажет, как подключить его к Telnyx.
Какой узел нужно оптимизировать в первую очередь?
- STT, LLM и TTS в трех разных облаках: объедините их в одной сети, прежде чем приступать к настройке модели.
- Телефония у одного провайдера, GPU у другого: перенесите инференс в сеть телефонии.
- Один регион в США, абоненты в Европе или Азиатско-Тихоокеанском регионе: запускайте инференс в регионе нахождения абонента.
- Один провайдер, один регион, но агент все равно перебивает абонентов: обратите внимание на определение конца фразы (endpointing) и джиттер.
Как исключить задержки LLM из голосового инференса в реальном времени
Абонент ничего не слышит до получения первого байта синтезированного аудио, а этот байт зависит от первого предложения модели. Показатель, который нужно оптимизировать — время до получения первого токена (TTFT), а основной метод — потоковая передача.
Потоковая передача токенов в TTS до завершения предложения
Отправляйте первое законченное предложение в TTS, пока генерация продолжается. Ожидание полного ответа увеличивает время ожидания абонента на всю длительность генерации. Контекст также растет: десятиминутный разговор содержит гораздо более длинный промпт, чем его начало, поэтому суммируйте или сокращайте историю между репликами.
Выбор модели и уровня обслуживания для живого звонка
Модель меньшего размера на быстрой инфраструктуре обычно работает лучше, чем большая модель, стоящая в очереди. Telnyx предоставляет библиотеку отобранных моделей для инференса, и для каждого запроса можно задать service_tier с тарифами, указанными на странице цен на инференс:
- Default: стандартная емкость по стандартным тарифам, используется, если поле не заполнено.
- Priority: емкость, оптимизированная для интерактивной работы с низкой задержкой, включая голосовую связь, с той же моделью и контекстным окном. Доступно для избранных моделей.
- Flex: самые низкие тарифы для фоновых задач, которые могут подождать несколько минут.
Поскольку API совместим с OpenAI, переход агента от другого провайдера означает лишь смену базового URL. Показатели задержки для каждого уровня не публикуются, поэтому сравните Priority и Default на своих собственных звонках.
Пример: инференс Telnyx внутри звонка с живым переводом
Этот пример моста для перевода соединяет двух абонентов, говорящих на разных языках, используя Voice Call Control и AI Inference. Транскрипт поступает в модель через translate(), а обработчик call.gather.ended озвучивает результат другому абоненту:
Python
def translate(text, from_lang, to_lang): resp = requests.post(INFERENCE_URL, headers={"Authorization": f"Bearer {TELNYX_API_KEY}", "Content-Type": "application/json"}, json={"model": AI_MODEL, "messages": [{"role": "system", "content": f"Translate from {from_lang} to {to_lang}. Return ONLY the translation, nothing else."}, {"role": "user", "content": text}], "max_tokens": 200, "temperature": 0.1}, timeout=15) resp.raise_for_status() return resp.json()["choices"][0]["message"]["content"]elif event_type == "call.gather.ended" and bridge: speech = p.get("speech", {}).get("result", "") if speech and bridge.get("state") == "active": from_lang = bridge[f"lang_{side}"] to_lang = bridge["lang_b"] if side == "a" else bridge["lang_a"] other_ccid = bridge["ccids"].get("b" if side == "a" else "a") translated = translate(speech, from_lang, to_lang) if other_ccid: client.calls.actions.speak(other_ccid, payload=translated, voice="female", language_code=lang_code(to_lang)) client.calls.actions.gather(ccid, input_type="speech", end_silence_timeout_secs=2, timeout_secs=15, language_code=lang_code(bridge[f"lang_{side}"])) return jsonify({"status": "translated"}), 200
В примере используется двухсекундный тайм-аут тишины, что подходит для перевода, но слишком медленно для агента. Именно здесь на помощь приходят потоковая передача предложений и более точное определение конца фразы.
Перебивание и определение реплик в голосовом конвейере реального времени
Абонент делает паузу, чтобы подумать, агент начинает отвечать, абонент продолжает говорить, и теперь они говорят одновременно. Это наложение — проблема тайминга, и более быстрая модель редко ее решает.
Почему ваш агент перебивает абонентов
Определение реплики решило, что пауза означает конец фразы. Короткий порог тишины часто приводит к ошибкам, а длинный — к замене перебивания на «мертвый эфир». Джиттер на участке оператора растягивает и сжимает те самые паузы, которые измеряет детектор, поэтому один и тот же порог ведет себя по-разному от звонка к звонку. Руководство по планированию начала речи охватывает элементы управления таймингом.
«Большинство заявлений о «сквозном голосовом ИИ» рассыпаются, когда вы измеряете то, что действительно важно: опыт конечного клиента в реальном времени. Задержка реплики, джиттер, обработка прерываний. Не бенчмарки на слайдах, а поведение во время живого звонка. Это возможно только тогда, когда вы контролируете весь стек. Сеть, медиа-плоскость, оркестрация и пути инференса, а не хрупкая цепочка сторонних сервисов через публичный интернет. Это планка, которой должен соответствовать голосовой ИИ». Иэн Рейтер, операционный директор Telnyx
Что должно происходить, когда абонент перебивает
- Остановить воспроизведение TTS.
- Отменить текущий запрос к LLM.
- Отбросить собственное аудио агента из входных данных STT, чтобы эхо не распознавалось как речь абонента.
- Зафиксировать, какую часть ответа услышал абонент, и обновить контекст соответствующим образом.
Сопоставление ключевых слов по фразам вроде «подождите» или «на самом деле» пропускает большинство прерываний, а пропуск четвертого шага заставляет модель думать, что абонент услышал ответ, который он никогда не слышал.
Соответствие требованиям и локализация данных для голосового инференса в реальном времени
Прежде чем агент для сферы здравоохранения или финансов выйдет в продакшн, регуляторы спросят, где завершается аудио, где работает модель и что сохраняется. Telnyx выполняет инференс в регионах Северной и Южной Америки, Европы, Ближнего Востока и Азии, скоро появится LATAM, и трансграничная маршрутизация отсутствует. Запросы выполняются без хранения данных и без обучения на ваших данных.
Руководство по голосовым агентам для здравоохранения и страница голосового ИИ для здравоохранения охватывают вопросы звонков пациентов. Правила согласия на запись различаются в зависимости от юрисдикции, а разбор суверенитета данных в Австралии описывает ситуацию на одном из рынков.
Как измерить голосовой инференс в реальном времени на живых звонках
Отсчет времени начинается, когда абонент перестает говорить, и заканчивается, когда первый байт ответа достигает его. Только измерение на пути звонка учитывает оба плеча оператора, поэтому время до первого токена — лишь один из параметров.
Метрики, предсказывающие завершение звонка
Отслеживайте задержку реплики на уровне p50 и p95, так как среднее значение скрывает медленные ответы, которые запоминаются абонентами:
- Задержка реплики: от конца речи абонента до первого аудио ответа у абонента.
- Частота перебиваний: реплики, в которых агент начал говорить, пока абонент еще говорил.
- Частота «мертвого эфира»: реплики, где пауза превысила ваш порог.
- Частота завершения звонка на первой реплике: абоненты, которые ушли до или во время первого ответа.
Используйте эти метрики вместе с вашим производственным чек-листом и следите за завершениями звонков, которые переключаются на человека, где передача от ИИ к человеку сама по себе добавляет ожидание.
Пример: живая транскрипция и анализ тональности звонка
Этот пример панели мониторинга превращает вызов Telnyx в поток событий транскрипции. Отмечая каждое из них временем поступления, вы можете сопоставить речь вызывающего абонента с моментом, когда ваш агент начинает воспроизведение аудио:
Python
elif event_type == "call.answered": client.calls.actions.start_transcription(call_control_id, language="en") return jsonify({"status": "transcribing"}), 200elif event_type == "call.transcription": text = p.get("transcription_data", {}).get("transcript", "") if text and call_control_id in call_intel: ci = call_intel[call_control_id] ci["transcript"].append(text) ci["latest_text"] = text ci["duration"] = int(time.time() - ci["start_time"]) # Анализ каждые 3 сегмента, чтобы избежать чрезмерных вызовов API if len(ci["transcript"]) % 3 == 0: analysis = analyze_segment(" ".join(ci["transcript"][-3:]))
Вычтите зарегистрированное время модели из измеренной задержки очереди, и остаток будет временем сети и передачи. В масштабах всей системы это разделение показывает, была ли медленная неделя вызвана сетью или моделью, что наиболее важно для высоконагруженных решений контакт-центров.
Часто задаваемые вопросы о голосовом выводе в реальном времени
Почему мой голосовой агент перебивает звонящих, и связано ли это с задержкой или определением очереди?
Обычно это связано с определением очереди. Агент начинает говорить, когда его механизм определения конца фразы решает, что пауза завершила очередь звонящего, а джиттер на стороне оператора делает эти паузы длиннее или короче, чем они были на самом деле. Задержка усугубляет ситуацию, так как медленный ответ приходит уже после того, как звонящий возобновил речь. Настройте порог тишины и обработку перебивания (barge-in), прежде чем менять модели.
Могу ли я использовать второго провайдера вывода в качестве резервного для своего голосового агента без его переписывания?
Да, если оба провайдера предоставляют API, совместимый с OpenAI. Вывод Telnyx совместим с OpenAI, поэтому перенаправление агента на него означает лишь изменение базового URL. Однако проверьте, где работает резервный вариант. Провайдер в другом облаке добавляет сетевой переход к каждому обслуживаемому запросу, поэтому это может увеличить задержку, даже если его модель быстрее.
Какая задержка делает голосовой разговор естественным?
Единого согласованного числа не существует, и опубликованные пороговые значения поставщиков различаются. ITU-T G.114 рекомендует поддерживать одностороннюю задержку «изо рта в ухо» на уровне 150 мс для большинства приложений, а телефонный разговор оплачивает одностороннюю задержку в каждом направлении плюс время работы модели. Установите свою цель как задержку очереди на уровне p95, измеренную во время реальных вызовов, и отслеживайте перебивания и «мертвый воздух» вместе с ней.
Почему стандартный вывод «запрос-ответ» не может выполнять транскрипцию в реальном времени?
Вывод «запрос-ответ» требует полной записи перед началом работы, поэтому транскрипт существует только после того, как звонящий закончил говорить. Транскрипция в реальном времени передает аудиокадры в модель по мере их поступления и возвращает частичные и окончательные транскрипты во время речи. Во время вызова ожидание всей записи превращает каждую паузу в «мертвый воздух».
Что использовать для голосового ИИ: WebSockets или WebRTC?
Используйте то, что подходит для конкретной задачи. WebRTC подходит для браузерных и мобильных клиентов, так как передает медиа через UDP со встроенной буферизацией джиттера и эхоподавлением. WebSockets подходят для потоковой передачи аудио между серверами, например, для пересылки аудио вызова в модель. Для телефонных звонящих сегмент, который достигает вас, является RTP-потоком оператора, поэтому этот выбор влияет только на переходы после медиа-плоскости.
Устраните переход, съедающий ожидание вашего звонящего
Теперь вы можете разместить каждую миллисекунду ожидания звонящего на именованном переходе. Запускайте вывод на GPU, размещенных совместно с сетью оператора: совместимость с OpenAI, смена базового URL для переключения и уровень Priority для голоса.
Попробуйте Telnyx Inference