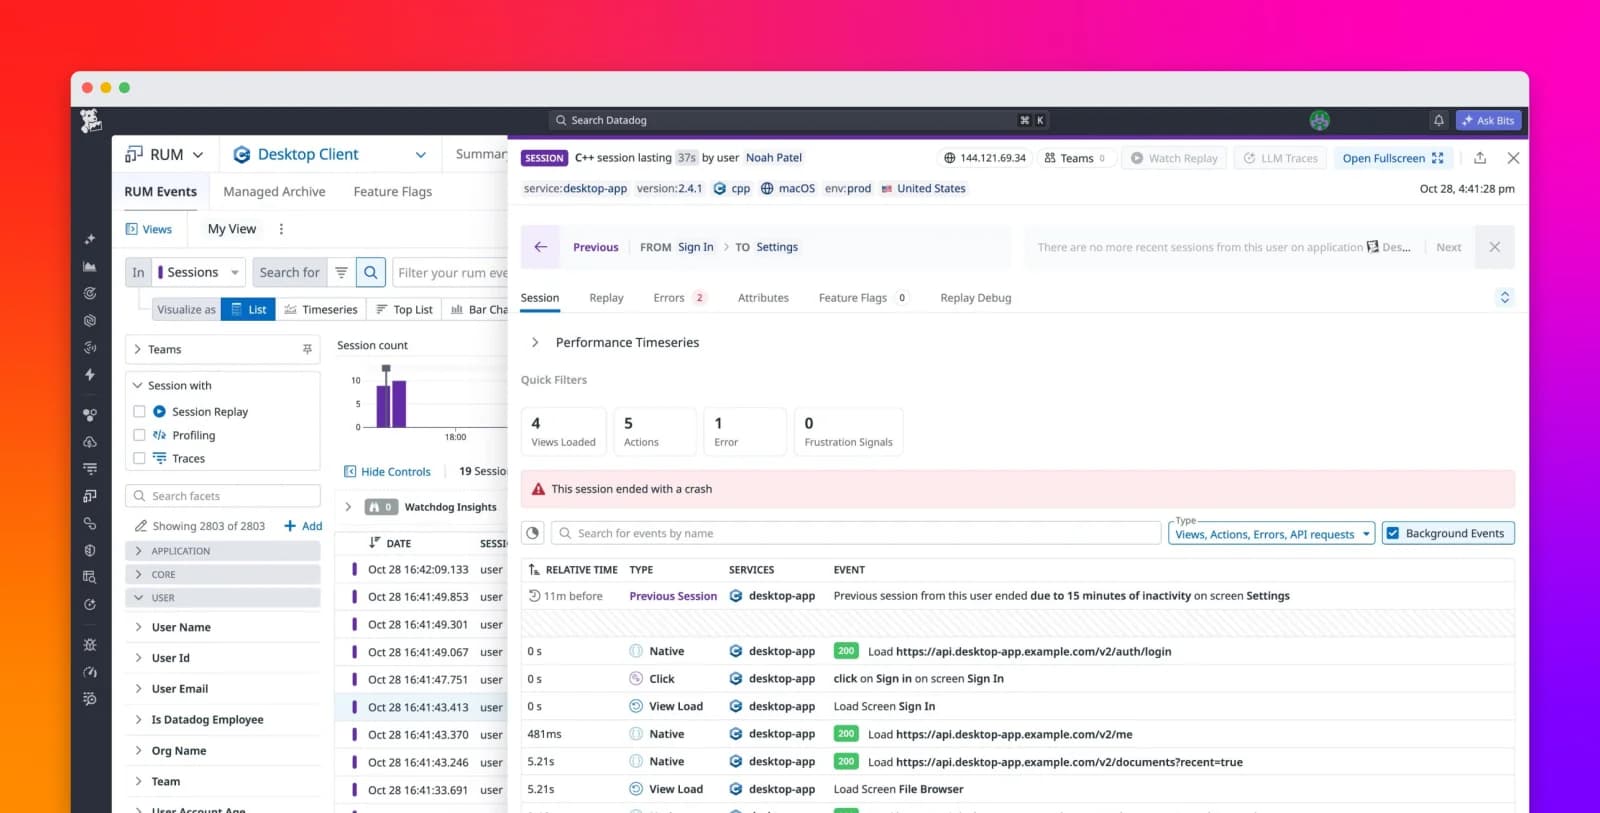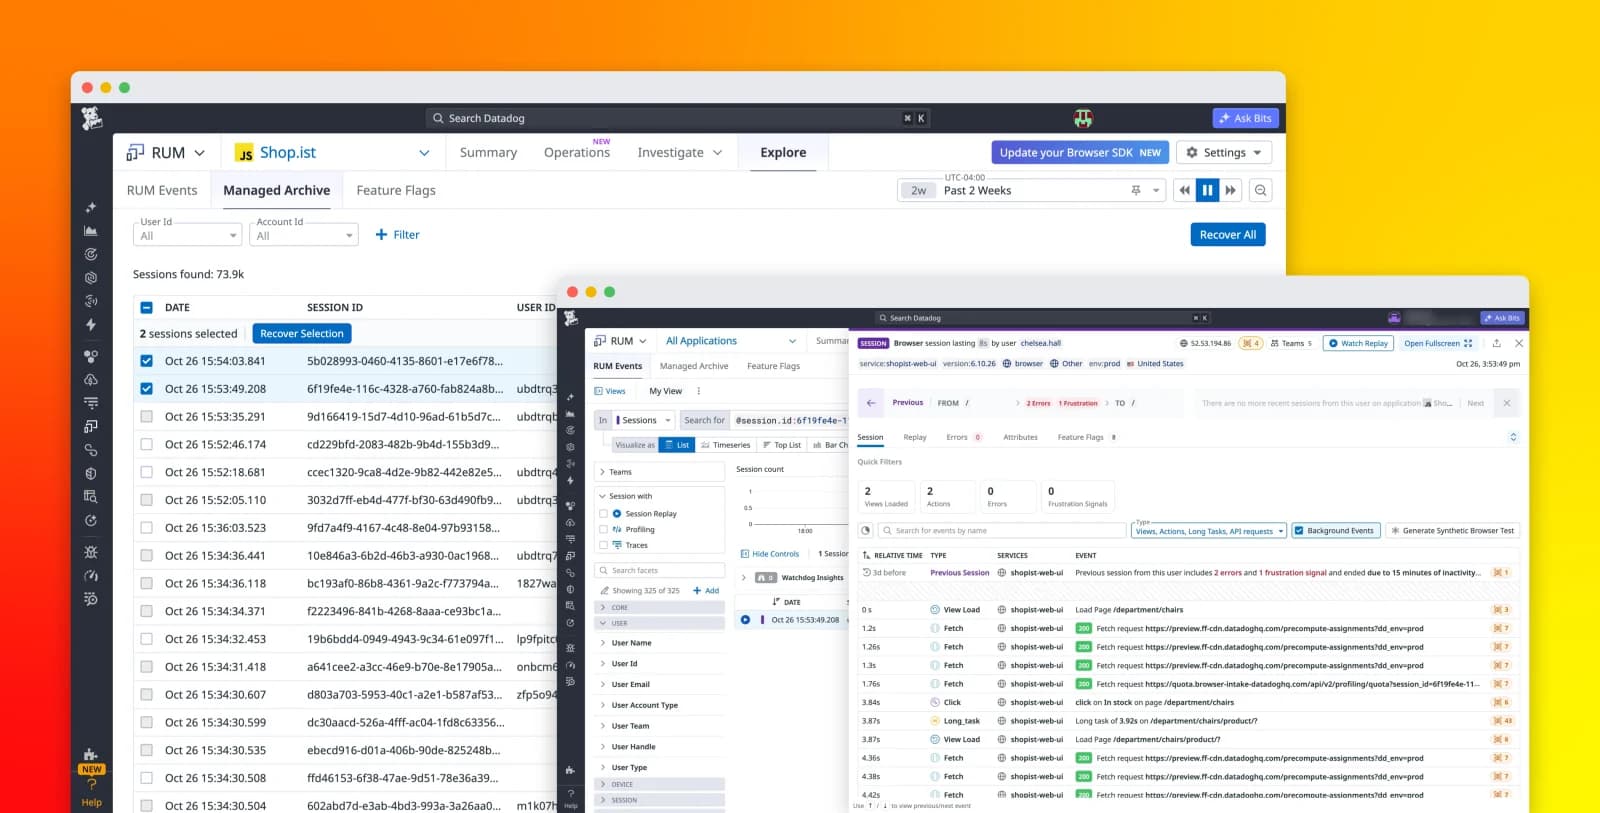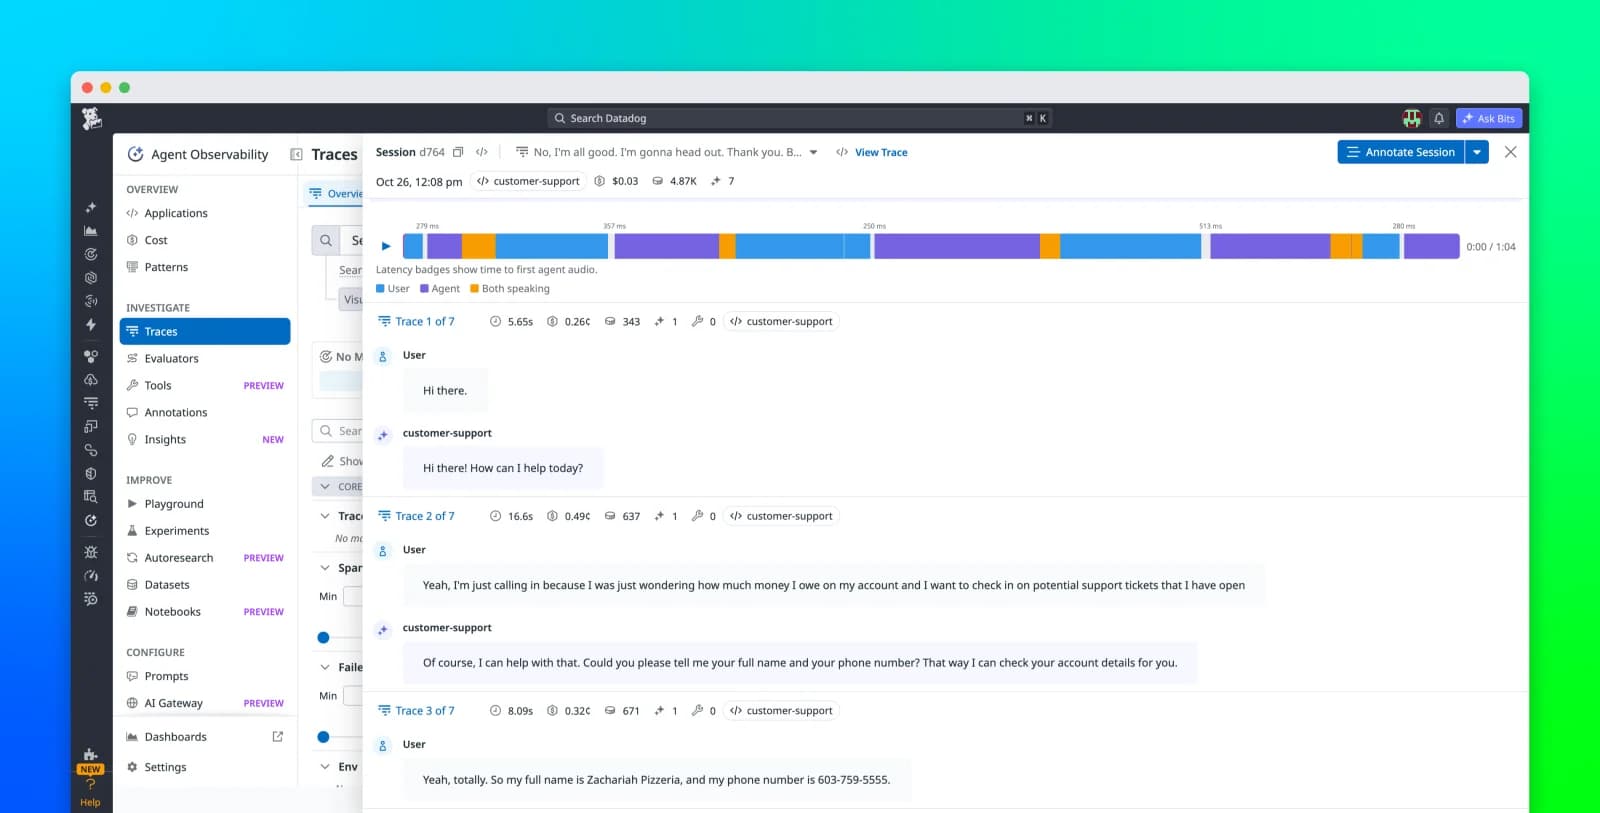
Datadog Real User Monitoring (RUM) и Product Analytics помогают командам разработки и работы с данными понимать доступность и производительность приложений, а также поведение пользователей на основе данных сеансов. Команды могут принимать весь объем этих данных в Datadog для мониторинга и анализа. Однако им также могут потребоваться данные о событиях в инфраструктуре, которую они контролируют, для поддержки пользовательской аналитики и отчетности, рабочих процессов машинного обучения (ML) или долгосрочного доступа к данным.
Export Pipelines предоставляют встроенный способ непрерывной отправки данных RUM и Product Analytics из Datadog в ваше облачное хранилище. Затем вы можете загрузить файлы в такие хранилища данных, как Snowflake, BigQuery или Databricks, или обработать полученные данные в ваших собственных пайплайнах.
В этой статье мы покажем, как вы можете:
- Непрерывно отправлять данные сеансов пользователей из Datadog в ваше облачное хранилище
Непрерывно отправлять данные сеансов пользователей из Datadog в ваше облачное хранилище
- Использовать экспортированные данные для аналитики, моделей машинного обучения и хранения с учетом требований комплаенса
Использовать экспортированные данные для аналитики, моделей машинного обучения и хранения с учетом требований комплаенса
Непрерывно отправлять данные сеансов пользователей из Datadog в ваше облачное хранилище
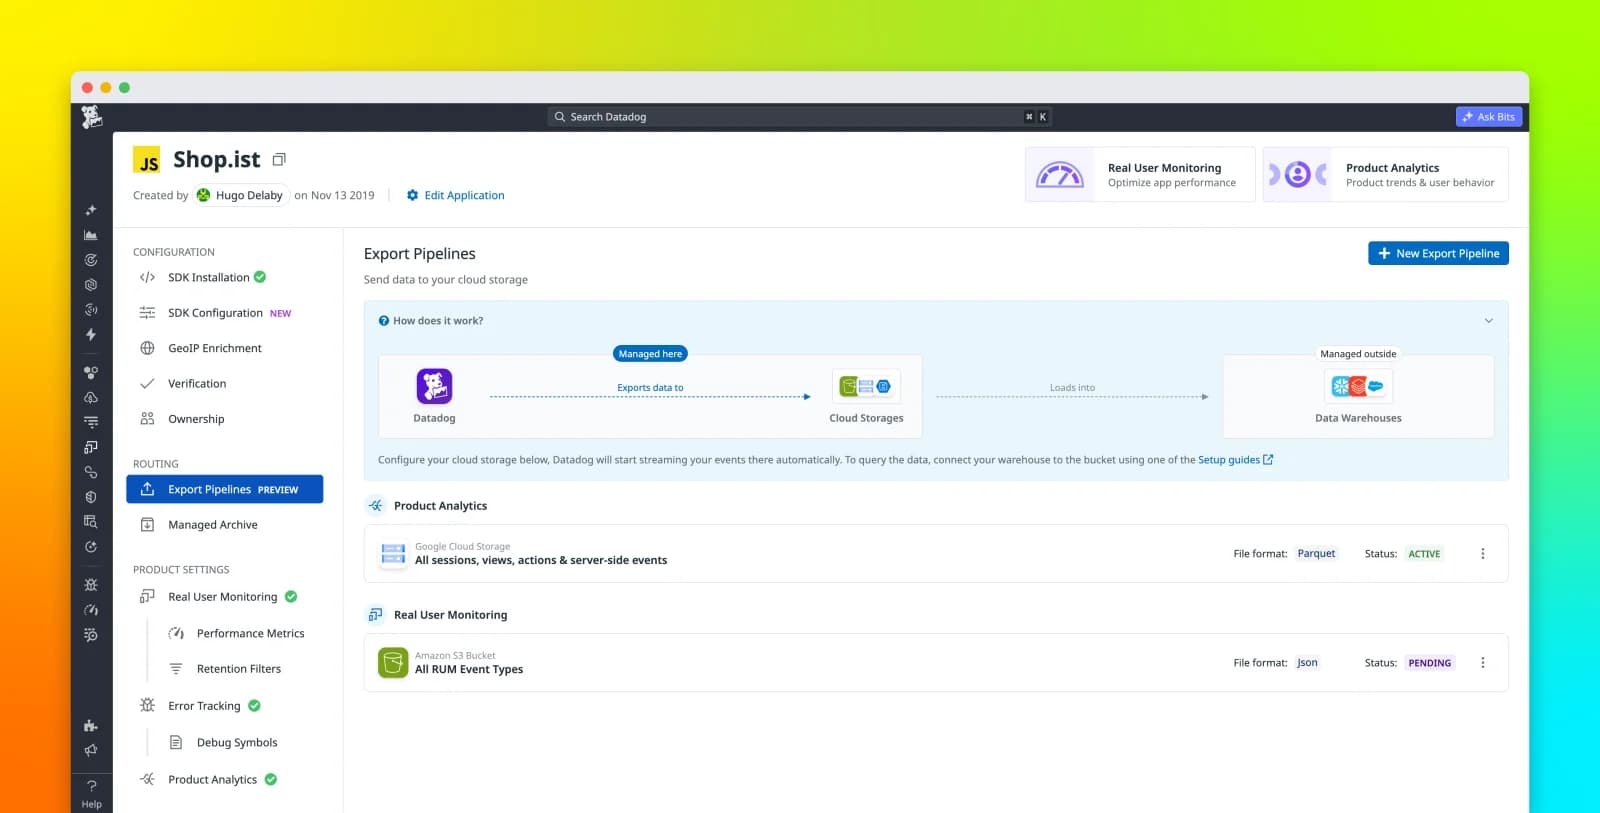
Export Pipelines переносят данные RUM и Product Analytics в вашу собственную облачную инфраструктуру. Вы настраиваете пайплайн в пользовательском интерфейсе Datadog, выбираете данные о производительности или поведении, которые хотите экспортировать, и выбираете пункт назначения в Amazon S3, Azure Blob Storage или Google Cloud Storage. После настройки пайплайна Datadog непрерывно отправляет соответствующие события в этот пункт назначения, не требуя от вашей команды поддержки пользовательских скриптов экспорта или заданий по расписанию.
Export Pipelines поддерживают форматы файлов Parquet и JSON, что позволяет выбрать формат в зависимости от того, как последующие системы будут обрабатывать данные. Parquet загружается напрямую в Snowflake, BigQuery и Databricks без предварительной обработки.
JSON подходит командам, у которых есть собственные пайплайны обработки или которым требуется более гибкое представление каждого события.
Datadog упорядочивает файлы по дате и часу в месте хранения, поэтому последующие процессы могут нацеливаться на файлы из соответствующего периода времени вместо сканирования каждого экспортированного файла. Вы можете включать, отключать или обновлять конфигурацию экспорта по мере изменения ваших требований. На странице Export Pipelines отображается текущее состояние каждого пайплайна — Активен (Active), Ошибка (Error), В ожидании (Pending) или Приостановлен (Paused), — чтобы вы могли видеть, работают ли ваши пайплайны должным образом.
Использовать экспортированные данные для аналитики, моделей машинного обучения и хранения с учетом требований комплаенса
Отправка событий RUM и Product Analytics в ваше облачное хранилище делает тот же набор технических данных и данных о поведении доступным для рабочих процессов за пределами Datadog. Команды могут загружать файлы в хранилище данных для анализа, передавать их в пайплайны машинного обучения или хранить в течение длительного времени для соблюдения требований комплаенса.
Например, аналитическая команда может захотеть понять, как поведение приложения связано с бизнес-результатами, которые уже смоделированы в ее хранилище. Команда может экспортировать события Product Analytics в бакет Google Cloud Storage и загрузить файлы Parquet в BigQuery. Там аналитики могут объединять действия в приложениях и поведение пользователей с наборами данных, такими как подписки, атрибуты учетных записей или финансовые данные, без необходимости внедрения второго набора средств инструментирования приложений.
Команды специалистов по данным также могут отправлять события RUM и Product Analytics в облачное хранилище для рабочих процессов машинного обучения. Затем они могут использовать собственные пайплайны преобразования данных и моделирования для обучения моделей персонализации, прогнозирования оттока, рекомендаций или обнаружения аномалий.
Export Pipelines также могут помочь организациям соблюдать требования комплаенса, которые предполагают долгосрочный доступ к данным о событиях в контролируемой ими инфраструктуре. Datadog RUM обеспечивает стандартное хранение в течение 30 дней и предлагает 6-месячное хранение с помощью RUM Managed Archive, а Product Analytics обеспечивает хранение в течение 15 месяцев. Организации, которым нужен доступ к данным о событиях сверх этих периодов, могут экспортировать соответствующие события в облачное хранилище и применять собственные политики хранения, доступа и жизненного цикла.
Начало работы с Export Pipelines
Export Pipelines предоставляют прямой путь для переноса данных RUM и Product Analytics из Datadog в контролируемую вами инфраструктуру без написания или поддержки пользовательского кода экспорта. Независимо от того, передаете ли вы данные в хранилище данных, обучаете модели машинного обучения или решаете задачи долгосрочного хранения для комплаенса, ваши данные остаются доступными в формате и месте назначения, которые лучше всего подходят для ваших рабочих процессов. Чтобы узнать больше, ознакомьтесь с документацией по Export Pipelines.
Если вы новичок в Datadog, вы можете зарегистрироваться для получения 14-дневной бесплатной пробной версии, чтобы начать экспорт данных RUM и Product Analytics в свое облачное хранилище.