Мы внедрили Cerebras Wafer Scale Engines вместе с GPU для обеспечения молниеносной генерации токенов в масштабе.
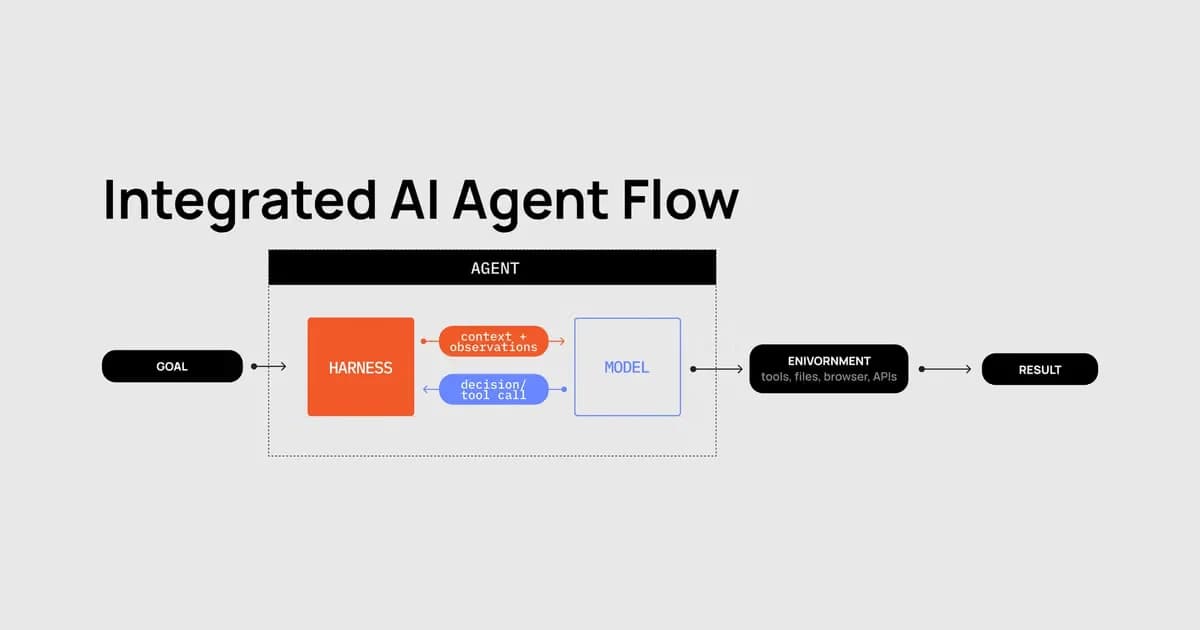
Мир нуждается в сверхбыстрых токенах. В 2026 году Cerebras столкнулась с ненасытным спросом на быстрый инференс как в нашем облаке, так и через наших партнеров. Чтобы удовлетворить этот спрос, мы начали разработку дезагрегированного инференса: GPU обрабатывают промпты (prefill), а системы Cerebras отвечают за генерацию вывода (decode).
Это решение уже находится в промышленной эксплуатации и обеспечивает в пять раз больше токенов на мегаватт при сохранении сверхвысоких скоростей Cerebras.
Теперь мы можем предоставлять больше сверхбыстрых токенов через Cerebras Inference Cloud, чтобы удовлетворить рыночный спрос. Инфраструктурные партнеры также могут использовать дезагрегированное решение Cerebras для получения большего количества сверхбыстрых токенов в своих собственных дата-центрах.
Наряду с недавно анонсированной системой CS4, значительно расширенным производством и запланированной мощностью дата-центров в 700 МВт, дезагрегированный инференс позволит Cerebras и нашим партнерам предоставлять гораздо больше сверхбыстрых токенов в 2027 году и в последующий период.
В этом блоге мы рассмотрим:
- Потребность в увеличении мощности сверхбыстрого инференса
- Почему Cerebras имеет преимущество в декодировании
- Результаты промышленного внедрения дезагрегированного инференса Cerebras
- Дезагрегированный инференс Cerebras для инфраструктурных партнеров
Потребность в увеличении мощности быстрого инференса
Агентные приложения, такие как Muse, Copilot и Codex, быстро масштабируются и требуют высокоинтерактивного инференса для поддержания вовлеченности пользователей. Чтобы удовлетворить растущий спрос на эти приложения в условиях ограниченного энергопотребления, наша отрасль должна обеспечить значительно большую мощность инференса на мегаватт при скоростях отклика, делающих эти приложения полезными.
Источники: Goldman Sachs Research, «Прогноз: ИИ-агенты увеличат денежный поток в технологическом секторе по мере роста использования», 20 мая 2026 г.; оценки мощности дата-центров Goldman Sachs, согласно Investing.com, 6 ноября 2026 г.
Именно поэтому Cerebras инвестировала в дезагрегацию. Сочетание ускорителя предварительного заполнения для обработки промптов с системой Cerebras для генерации ответов увеличивает пропускную способность токенов на мегаватт, сохраняя при этом сверхвысокие скорости генерации Cerebras. Для провайдеров инференса это означает больше возможностей для обслуживания клиентов и более высокий потенциал дохода при том же бюджете энергопотребления.
Почему Cerebras имеет преимущество в декодировании
Запрос на инференс состоит из двух основных этапов. Обработка промпта, известная как prefill, обрабатывает входные данные и создает промежуточное состояние модели. Генерация ответа, известная как decode, использует это состояние для генерации выходных токенов. Существует множество способов разделения рабочей нагрузки инференса, включая draft–target, attention–FFN и другие, но отделение prefill от decode дает уникальные преимущества, когда целью является высокоинтерактивный инференс.
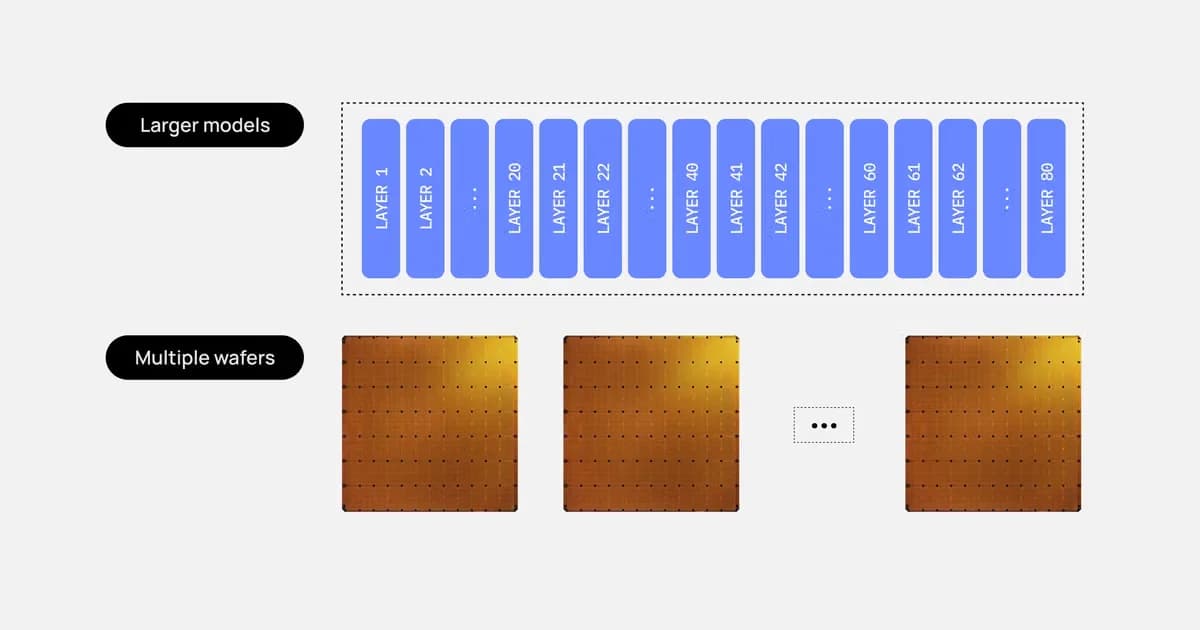
Декодирование является авторегрессионным. Это означает, что модель генерирует по одному токену за раз, используя каждый сгенерированный токен в качестве входного для генерации следующего. Каждый шаг требует повторного считывания данных модели из памяти, поэтому пропускная способность памяти имеет огромное значение. В области сверхбыстрого инференса чипы, ориентированные на SRAM, имеют преимущество, поскольку они могут хранить эти данные на кристалле и считывать их гораздо быстрее. Cerebras доводит это до уровня пластины (wafer scale), обладая десятками гигабайт SRAM и десятками петабайт в секунду пропускной способности памяти на одном чипе — это в 350 раз больше емкости SRAM и в 5400 раз больше пропускной способности памяти, чем у типичного GPU GB300. Это позволяет системе Cerebras размещать больше одновременных запросов и слоев модели непосредственно на чипе, позволяя CS-3, CS-4 и CS-5 достигать сверхвысоких скоростей при привлекательной пропускной способности.
Результаты промышленного внедрения дезагрегированного инференса Cerebras
Сочетание систем Cerebras, оптимизированных для сверхбыстрого декодирования, с ускорителями, хорошо подходящими для вычислительных потребностей prefill, такими как GPU AMD Instinct, позволяет обеспечить огромное количество сверхбыстрого инференса в масштабе. В промышленном развертывании в Cerebras Inference Cloud GPU AMD Instinct обрабатывают промпты, а системы Cerebras CS-3 генерируют ответы. Перенос обработки промптов на GPU позволяет системам Cerebras направить свою мощность на генерацию ответов. В нашем измеренном промышленном развертывании эта комбинация обеспечила 5-кратную пропускную способность на мегаватт по сравнению с конфигурацией только на базе CS-3, без потери скорости генерации токенов.
Мы планируем широко развернуть дезагрегированный инференс на сотнях мегаватт в Cerebras Inference Cloud и в партнерских развертываниях к концу 2027 года. Наша цель — увеличить мощность сверхбыстрого инференса, доступную для наших клиентов.
Дезагрегированный инференс Cerebras для инфраструктурных партнеров
Решение Cerebras для дезагрегированного инференса также было создано для внедрения нашими партнерами. Инфраструктурные партнеры могут развертывать кластеры дезагрегированного инференса на основе эталонной архитектуры, предоставляемой Cerebras, размещая выбранные ими ускорители prefill и системы Cerebras в рамках единой сети. Для интеграции программного обеспечения партнеры могут использовать либо комплексный стек дезагрегированного ПО Cerebras, либо SDK только для декодирования.
Комплексный стек дезагрегированного ПО лучше всего подходит для партнеров, оптимизирующих время выхода на рынок. Он состоит из:
- Фреймворка дезагрегированного инференса для маршрутизации запросов между пулами prefill и decode, а также управления емкостью и состоянием реплик.
- Механизма prefill для обработки промптов с использованием движков инференса с открытым исходным кодом, таких как vLLM или SGLang.
- Механизма декодирования Cerebras для генерации ответов на системах Cerebras.
- ПО KV Portal — интерфейса для передачи промежуточного состояния модели, включая кэши key-value, между движками prefill и decode через RDMA.
SDK только для декодирования лучше всего подходит для партнеров, оптимизирующих контроль. С помощью этого SDK партнеры могут использовать свой собственный фреймворк инференса и движок prefill вместе с движком декодирования Cerebras и ПО KV Portal. Кроме того, SDK предоставляет средства разработки, такие как имитация реплики декодирования Cerebras и эталонная интеграция с фреймворком дезагрегированного инференса и движком prefill с открытым исходным кодом.
Партнеры с ранним доступом, включая Amazon Web Services, Fireworks AI, Gimlet Labs и General Compute, уже имеют доступ к решению Cerebras для дезагрегации для своих развертываний. Сейчас мы расширяем доступ для других партнеров, стремящихся предоставить своим клиентам сверхбыстрый инференс в масштабе.
Чтобы обсудить результаты, решения или возможности развертывания более подробно, свяжитесь с нами здесь.