AMD и RGS упрощают планирование HPC и ИИ в Kubernetes с помощью защищенной архитектуры, созданной для эффективного использования GPU.
AMD обеспечивает работу передовых мировых систем научных вычислений: от экзафлопсных суперкомпьютеров, способствующих открытиям в США и Европе, до Lux — первой системы Genesis Mission для науки на базе ИИ. Благодаря ведущим процессорам, GPU, FPGA, сетевым решениям и открытому программному обеспечению ROCm, AMD предоставляет государствам, лабораториям и предприятиям единую открытую платформу для высокопроизводительных вычислений (HPC), ИИ для науки, суверенного ИИ, агентного ИИ и перехода к квантовым вычислениям.
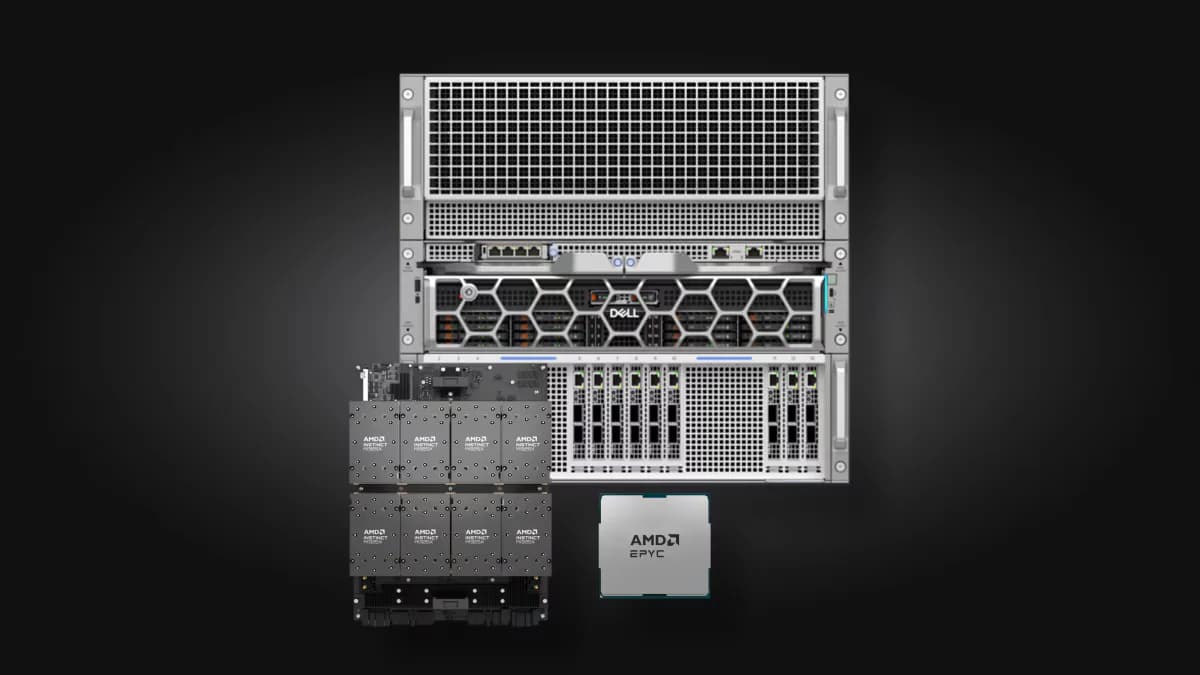
Компании AMD и Rancher® Government Solutions (RGS) объединили усилия для создания защищенной, готовой к промышленной эксплуатации эталонной архитектуры, призванной упростить планирование рабочих нагрузок HPC и ИИ, а также повысить эффективность использования GPU в Kubernetes. Это решение, работающее на базе платформы RGS Carbide и высокопроизводительных GPU AMD Instinct™, предоставляет исследовательским организациям и структурам национальной безопасности защищенный и легко масштабируемый фундамент для их наиболее критически важных рабочих нагрузок с ускорением на GPU. Интеграция проектов с открытым исходным кодом Slinky и Kueue позволяет организациям использовать интеллектуальное динамическое планирование заданий и автоматическое распределение GPU для достижения максимальной эффективности.
AMD обладает подтвержденным опытом лидерства в области ускоренных вычислений, обеспечивая работу экзафлопсных суперкомпьютеров, ресурсоемких научных и государственных задач, а также крупномасштабного ИИ-вывода. Ускорители AMD Instinct™ и открытое программное обеспечение ROCm™ служат основой для развития HPC и ИИ в различных средах развертывания. Этот опыт лег в основу открытой, воспроизводимой эталонной архитектуры, призванной помочь большему числу организаций увереннее развертывать и эксплуатировать инфраструктуру с ускорением на GPU.
«HPC и ИИ стремительно сближаются. По мере роста рабочих нагрузок организациям необходимо эффективно распределять ресурсы GPU, соблюдая при этом высокие стандарты безопасности», — говорит Крис Рейнольдс, вице-президент по архитектуре решений в RGS. — «Эта эталонная архитектура создана для решения обеих задач. Поскольку она работает на Kubernetes, исследователи могут вести разработку на одной рабочей станции и масштабировать ту же работу на большой кластер GPU с использованием единой базовой конфигурации».
От рабочей станции до крупного кластера — с единым определением
Традиционные HPC-системы обладают огромной вычислительной мощностью, но перенос на них рабочих задач часто происходит медленно. Программное обеспечение устанавливается непосредственно на общую систему, его окружение редко совпадает с окружением на компьютере исследователя, и задача, которая работает на ноутбуке, может не запуститься в кластере. Исследователи тратят время на отладку окружения и ожидание доступа к большой системе только для того, чтобы протестировать небольшие изменения.
Контейнеры решают проблему окружения. Каждая задача упаковывается вместе с кодом, библиотеками и зависимостями, поэтому она работает одинаково везде. На хосте ничего не нужно устанавливать, а программное обеспечение одной команды не конфликтует с другим.
Kubernetes как уровень оркестрации контейнеров решает проблему масштабирования с помощью декларативной модели. Вместо написания пошаговых сценариев для каждой системы исследователь описывает потребности задачи: какие контейнеры запустить, сколько нужно GPU и памяти. Kubernetes сопоставляет рабочие нагрузки с подходящим оборудованием, обеспечивает высокую доступность и отказоустойчивость за счет распределения задач по кластеру и автоматически перезапускает задания в случае сбоя оборудования.
Определения заданий HPC — это простые текстовые файлы, которые можно версионировать, проверять и передавать другим. Эксперименты становятся воспроизводимыми, а задания можно повторно запустить спустя месяцы в том же окружении. Команды могут работать над частями задачи параллельно, а большой кластер резервируется для тех запусков, которые действительно в нем нуждаются.
Один общий кластер также может выполнять пакетные исследовательские задачи параллельно с долгоживущими сервисами, такими как вывод моделей, вместо разделения оборудования на отдельные изолированные сегменты. Такой подход помогает сократить объем простаивающих мощностей и повысить уровень использования, чтобы организации могли извлечь больше пользы из уже имеющегося оборудования.
Тот же декларативный подход применяется и к самой платформе. AMD и RGS использовали его для автоматизации развертывания всего стека, от драйверов GPU до планировщика заданий, чтобы организации могли многократно создавать идентичные среды. Специалисты по анализу данных и исследователи могут сосредоточиться на своей работе, а не на создании и обслуживании инфраструктуры под ней.
Защищенный фундамент для конфиденциальных рабочих нагрузок
Среды HPC часто работают с конфиденциальными и критически важными данными, поэтому наличие безопасной и соответствующей требованиям базовой конфигурации имеет решающее значение. Эффективная работа ИИ и HPC также требует тесной интеграции между аппаратным и программным обеспечением.
AMD и RGS провели валидацию ключевых компонентов этой архитектуры, чтобы подтвердить, что среда надежно использует GPU AMD и сопоставляет каждую рабочую нагрузку с необходимыми ей ускорителями. Фундамент включает:
Возможности AMD
Возможности RGS
Оптимизированные вычисления:
Высокопроизводительные GPU AMD Instinct с автоматизированной декларативной установкой программного стека AMD ROCm.
Оркестрация с фокусом на безопасность:
RKE2 Government — защищенный дистрибутив Kubernetes, работающий на безопасной корпоративной ОС Linux и разработанный в соответствии с требованиями безопасности правительства США.
Управление GPU:
Оператор AMD ROCm GPU для автоматического обнаружения и управления ресурсами GPU для контейнеризированных рабочих нагрузок.
Защищенная база и автоматизация:
Платформа Carbide разработана для обеспечения безопасного, защищенного фундамента с автоматизированным развертыванием полного стека — от драйверов до планировщика заданий.
Справедливое и эффективное планирование GPU с помощью Slinky и Kueue
Общему кластеру GPU нужен четкий механизм для определения того, какие задания запускать, когда и на каком оборудовании. Эта архитектура объединяет два проекта с открытым исходным кодом для решения этой задачи.
- Slinky переносит Slurm, планировщик, хорошо знакомый многим пользователям HPC, в Kubernetes, поэтому существующие рабочие процессы сохраняются.
- Kueue управляет очередями заданий и квотами, чтобы команды справедливо делили емкость GPU, а ресурсы не простаивали.
Вместе они позволяют исследователям надежно запускать требовательные приложения, включая vLLM для высокопроизводительного вывода больших языковых моделей.
Суверенный ИИ требует как мощных вычислительных ресурсов, так и операционного контроля. AMD является лидером в создании этого фундамента благодаря своему портфелю высокопроизводительных процессоров, ускорителей Instinct, сетевых решений и открытого программного обеспечения ROCm™. Основываясь на сотрудничестве AMD, SUSE и RGS, анонсированном на конференции Advancing AI 2026, эта эталонная архитектура воплощает данное видение в планировании HPC и ИИ: объединяя ускорение AMD с защищенным фундаментом Kubernetes от RGS, она помогает государственным органам, исследовательским институтам и регулируемым предприятиям запускать конфиденциальные рабочие нагрузки в контролируемых ими средах.
Ускоряя будущее научных вычислений: продолжение следует
Эта совместно разработанная эталонная архитектура объединяет традиционное планирование заданий HPC и современную оркестрацию контейнеров на безопасном фундаменте.
Вместе AMD и RGS предоставляют частным предприятиям, исследовательским институтам и национальным лабораториям безопасную открытую инфраструктуру, необходимую для решения сложных научных задач, чтобы их команды могли тратить меньше времени на инфраструктуру и больше — на открытия.