9 сент. 2020 г.
Команда Kaggle рада продемонстрировать работы наших гроссмейстеров. Эту статью написал Владимир Игловиков, и она наполнена советами, которыми, как он жалеет, никто не поделился с ним во время его активного участия в Kaggle. Оригинал статьи можно найти в блоге Владислава Ternaus Blog.
Нажмите клавишу Enter или щелкните, чтобы просмотреть изображение в полном размере
Введение
Я участвовал в соревнованиях по машинному обучению (МО) на Kaggle и других платформах, чтобы прокачать свои навыки МО. Я был 19th in the global rating, и получил титул Kaggle Grandmaster.
Каждое соревнование по МО завершалось новыми знаниями, кодом и весами моделей.
Мне нравилось узнавать что-то новое, но я игнорировал ту пользу, которую могли принести старые пайплайны МО. Код оставался в приватных репозиториях GitHub. Весы были разбросаны по всему жесткому диску. В конце концов, все это удалялось.
Эта ситуация уникальна не только для Kaggle. Та же история и в академической среде. Студент обучает модель, пишет статью. После ее принятия на конференцию пайплайны забрасываются, артефакты обучения удаляются, и студент идет дальше.
В этой статье мы поговорим о небольших шагах, которые вы можете сделать после завершения каждого соревнования по МО.
Эти шаги помогут вам:
- Повысить технические знания.
- Создать личный бренд.
- Улучшить карьерные возможности.
- Сделать мир лучше :)
В качестве примера я буду использовать репозиторий https://github.com/ternaus/retinaface
Он не был частью соревнования на Kaggle, а был создан для иллюстрации этой истории.
I. +5 мин: выложите код в публичный репозиторий GitHub
Скорее всего, код уже находится на GitHub, но в приватном репозитории.
Что вы потеряете, если сделаете его публичным?
Бывают ситуации, когда личное должно оставаться личным, но в вашем пет-проекте, решении для Kaggle или научной статье это может быть не так.
Самое распространенное препятствие, которое я видел: люди считают, что весь публичный код должен быть идеальным, и что их будут осуждать, если это не так.
На самом деле всем все равно. Просто сделайте это. Выложите его как есть, без какой-либо полировки.
Публикация кода — важный психологический шаг. Выпуск несовершенного кода — уверенный, смелый шаг.
К тому же все последующие шаги основаны на этом.
Пример:
II. +20 мин: улучшите читаемость
Вы можете улучшить читаемость своего кода на Python, добавив средства форматирования и проверки синтаксиса.
Это несложно и не отнимает много времени. Линтеры и форматтеры не превратят плохой код в хороший, но читаемость повысится. Думайте об исправлении синтаксиса как о базовой гигиене. Это как чистить зубы, но для кода.
Я написал об этом статью под названием Девять простых шагов для создания более красивого кода на Python. Обязательно ознакомьтесь с ней.
Шаг 1: файлы конфигурации
Добавьте эти файлы в корневой каталог вашего репозитория.
- setup.cfg — конфигурация для flake8 и mypy.
- pyproject.toml — конфигурация для black.
Шаг 2: зависимости
Установите необходимые библиотеки с помощью
Шаг 3: black
Существует 100500 способов форматирования кода. Форматтеры, такие как black или yapf, изменяют код в соответствии с заранее определенным набором правил.
Проще читать кодовую базу, в которой соблюдены определенные стандарты. Когда вы часами работаете над кодом и вам нужно переключаться между различными стилями программирования, это истощает «силу воли» — незачем делать это без уважительной причины.
Запуск
отформатирует все файлы Python в соответствии с правилами black.
Шаг 4: flake8
Запуск
не изменит код, но проверит его на наличие синтаксических ошибок и выведет их на экран.
Исправьте их.
Шаг 5: mypy
В Python нет обязательной статической типизации, но рекомендуется добавлять типы к аргументам функций и возвращаемым значениям.
Например:
Вам следует добавить типизацию в код.
- Это облегчает чтение кода.
- Вы можете использовать пакет mypy для проверки аргументов и типов функций на согласованность.
После обновления кода запуск mypy для всего репозитория:
Если mypy обнаружил проблемы — исправьте их.
Шаг 6: хук pre-commit
Постоянно запускать flake8, black и mypy вручную — это раздражает.
Существует инструмент под названием pre-commit hook, который решает эту проблему.
Чтобы включить его, скопируйте этот файл в свой репозиторий: .pre-commit-config.yaml.
Вам нужно установить пакет pre-commit на свой компьютер с помощью:
И инициализировать с помощью:
Все готово.
Отныне при каждом коммите он будет запускать набор проверок и не позволит пройти коммиту, если что-то не так.
Основное отличие от ручного запуска black, flake8, mypy заключается в том, что он не просит вас исправить проблемы, а заставляет это сделать. Следовательно, нет растраты «силы воли».
Шаг 7: GitHub Actions
Вы добавили проверки в хук pre-commit и запускаете их локально. Но вам нужна вторая линия обороны. Вам нужно, чтобы GitHub запускал эти проверки для каждого пулл-реквеста.
Способ сделать это — добавить файл .github/workflows/ci.yaml в репозиторий.
Там есть строки:
которые говорят GitHub, что проверять.
Я также рекомендую отказаться от практики отправки кода напрямую в ветку master.
Создайте новую ветку, измените код, сделайте коммит, отправьте на GitHub, создайте пулл-реквест и объедините с master.
Это стандарт в индустрии, но он крайне необычен в академической среде и среди участников Kaggle.
Если вы не знакомы с этими инструментами, добавление их и исправление ошибок и предупреждений может занять более 20 минут.
Запомните это время. В следующем проекте добавьте эти проверки в самый первый коммит, когда еще не написано ни строчки кода. С этого момента каждый небольшой коммит будет проверяться, и вам нужно будет исправлять от силы пару строк кода каждый раз: крошечные накладные расходы, отличная привычка.
Я также рекомендую прочитать книгу Atomic Habits: An Easy & Proven Way to Build Good Habits & Break Bad Ones. В ней рассказывается о небольших изменениях в вашем поведении, которые повышают продуктивность и качество жизни.
III. +20 мин: создайте хороший файл README
Хороший файл README служит двум целям:
- Для себя: вы предполагаете, что никогда не будете использовать этот код, но «никогда не говори никогда». Вы воспользуетесь им и не вспомните, что здесь происходило. Файл README поможет вам.
- Для других: README — это аргумент в пользу продажи. Если люди не могут понять назначение репозитория и какие проблемы он решает, они не будут им пользоваться. Вся проделанная вами работа не окажет положительного влияния на других.
Для репозиториев машинного обучения минимум включает:
- Изображение, которое показывает, в чем заключалась задача и как вы ее решили. Никаких слов не требуется. Скорее всего, проработав над задачей несколько недель, у вас есть 100500 картинок. Они просто не являются частью README. Исправьте это.
- Где разместить данные.
- Как начать обучение.
- Как выполнять инференс.
Если вам нужно написать 100500 слов, чтобы описать, как запустить обучение или инференс, это тревожный сигнал. Вам нужно провести рефакторинг кода и сделать его более удобным для пользователя. Люди часто спрашивают — как стать лучшим программистом? Это упражнение помогает. Вам нужно будет переписать свой код. Попробуйте посмотреть на свой README глазами кого-то другого.
Это также отличное упражнение, которое поможет выработать привычку смотреть на продукт с точки зрения пользователя.
Знаменитое: «Клиент всегда прав».
Знаменитое: «Клиент всегда прав».
Пример: для retinaface я написал обертку над моделью, которая скрывает детали постобработки.
Постобработка — это прямо-таки сложно, но она не добавляет ценности людям, которым до этого нет дела => пользователи должны иметь возможность скрыть ее.
Файл Readme, созданный на этом этапе, будет использоваться позже, когда мы будем собирать библиотеку.
IV. +20 мин. Сделайте вашу обученную модель простой в использовании
Я полагаю, вы пишете
чтобы загрузить предобученные веса в модель.
Это работает, и шаги понятны, но требуются веса на диске и знание того, где они находятся. Более элегантное решение — использовать функцию torch.utils.model_zoo.load_url в torchvision и аналогичные в TensorFlow или Keras.
Мы можем сделать следующее:
Если веса отсутствуют на диске, они скачиваются из интернета и кэшируются на диске. Модель инициализируется, и веса загружаются.
Это удобно для пользователя, и именно это вы видите в библиотеках torchvision и timm.
Шаг 1: разместите веса предобученной модели
Это было самой большой сложностью для меня. Куда положить веса модели, если вы не хотите связываться с AWS, GCP?
Очевидно, есть отличное решение, я бы сказал, лазейка. Вы можете загрузить веса в релизы на GitHub.
Нажмите Enter или кликните, чтобы просмотреть изображение в полном размере
Лимит составляет 2 ГБ на файл, чего достаточно для большинства моделей глубокого обучения.
Шаг 2: напишите функцию, которая инициализирует модель и загружает веса
В моем случае:
Этот функционал будет задействован при создании блокнота Colab и веб-приложения.
V. +20 мин. Создайте библиотеку
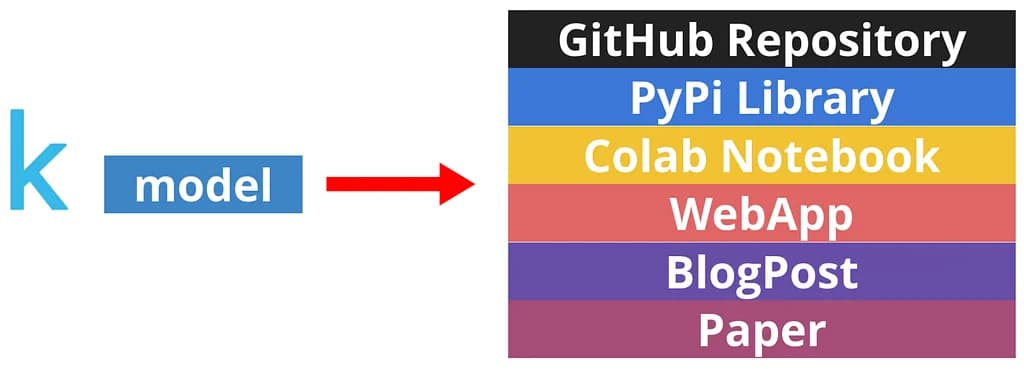
На этом этапе вы снижаете порог входа для использования вашей модели. Цель состоит в том, чтобы выполнять предсказания без
Шаг 1: добавьте необходимые зависимости в requirements.txt
Вы можете использовать
или обновить его вручную.
Шаг 2: измените структуру файлов репозитория
Создайте «главную папку», в моем случае названную «retinaface», так же, как и репозиторий.
- Переместите туда весь важный код.
- Не переносите туда вспомогательные изображения, Readme, блокноты или тесты.
Делать это вручную и обновлять все импорты было бы больно. PyCharm или аналогичная IDE сделает это за вас.
Это распространенный способ структурирования кода в репозиториях.
Я надеюсь, что в будущем вы будете следовать этому паттерну с самого начала. Если вы хотите чего-то более структурированного, ознакомьтесь с пакетом Cookie Cutter.
Шаг 3: добавьте файл конфигурации
- Добавьте setup.py в корневой каталог папки с содержимым, похожим на setup.py
- Добавьте версию для пакета. В моем случае я добавил ее в init-файл «главной» папки.
Шаг 4: создайте учетную запись на PyPI
Если у вас нет учетной записи на PyPI, самое время ее создать.
Шаг 5: соберите библиотеку и загрузите ее на PyPI
Вот и все. Ваш репозиторий представляет собой библиотеку, и каждый сможет установить ее с помощью:
Если вы проверите страницу пакета на PyPI, вы увидите, что для презентации проекта используется файл Readme из вашего репозитория.
Мы будем использовать функционал этого этапа для Google Colab и веб-приложения.
VI. +20 мин. Создайте блокнот Google Colab
Хорошей практикой является добавление блокнота Jupyter в репозиторий, чтобы показать, как инициализировать модель и выполнять инференс. Example.
Мы можем сделать лучше.
Мы включили «модную» инициализацию модели и магию установки pip на предыдущих двух шагах. Давайте воспользуемся этим.
Мы можем создать блокнот Google Colab.
Теперь все, что нужно человеку для работы с вашей моделью, — это браузер! Больше людей смогут ознакомиться с ней.
Не забудьте добавить ссылку на блокнот в файл Readme и обновить версию на PyPI.
VII. +20 мин. Создайте веб-приложение
Многие специалисты по работе с данными считают, что создание веб-приложения — это сложная процедура, требующая специальных знаний.
Это предположение верно: веб-приложение для сложного проекта требует навыков, которых у специалистов по данным может не быть.
Создать простое веб-приложение, демонстрирующее работу модели, легко.
Я создал отдельный репозиторий на github для веб-приложения. Тем не менее вы можете сделать это в своем репозитории с моделью.
Запись в блоге с описанием деталей: Как развернуть Streamlit на Heroku
Шаг 1: Добавьте код для приложения
Меньше 40 строк.
Шаг 2: добавьте файлы конфигурации
Вам потребуется добавить файлы:
- setup.sh — вы можете использовать этот файл без изменений.
- Procfile — вам потребуется изменить путь к файлу с приложением.
Шаг 3: добавьте requirements.txt
Шаг 4: зарегистрируйтесь на herokuapp
Шаг 5: выполните push кода
Ваш проект запущен. Ознакомьтесь с примером для https://retinaface.herokuapp.com/
VIII. +4 часа: Напишите пост в блоге
Многие люди недооценивают свою работу. Они считают, что если они умеют что-то делать, то это умеют все. Это не так.
Что для одного мусор, то для другого сокровище.
Что для одного мусор, то для другого сокровище.
Ваша статья поможет другим людям и улучшит ваши карьерные возможности.
Я работаю в Lyft, Level5, и применяю методы глубокого обучения для задач беспилотных автомобилей. До Lyft я работал в агентстве по взысканию долгов TrueAccord. Вы можете прочитать о моем поиске работы в посте в блоге: «Смена карьеры на автономные транспортные средства.»
Одной из причин, почему я смог совершить этот карьерный скачок, было то, что я делился своими знаниями в постах блога и на митапах. Это привлекло внимание рекрутеров и менеджеров по найму.
Сработало для меня — сработает и для вас.
Для машинного обучения я бы порекомендовал написать текст, охватывающий следующие темы:
- В чем заключалась проблема?
- Как вы ее решили?
Если вы дочитали до этого момента и нашли эту статью полезной, вы можете сказать «Спасибо!», написав пост в блоге об одной из проблем машинного обучения, с которой вы столкнулись, и о том, как вы ее решили.
Пример: