Современные сети обрабатывают миллионы событий каждую секунду — от аутентификации устройств до передачи данных, — что требует надежного способа фиксации полной истории каждого взаимодействия. Apache Flink является мощным инструментом для организации и анализа этого непрерывного потока данных в реальном времени, обеспечивая точную запись сложных последовательностей по мере их возникновения. Однако масштабирование этого процесса для обработки огромных всплесков данных может создать скрытые проблемы с производительностью, которые угрожают стабильности системы.
Поэтому мы переписали эту логику в виде буфера в памяти, запустили его параллельно с оригинальным на реальных производственных данных, используя шаблон разработки «A/B» в течение пяти месяцев, и выполнили переключение путем изменения тем по умолчанию. Вот сам шаблон, защитные механизмы, удерживающие его в заданных границах, и контрольный список, который мы бы использовали снова.
Flink и проблемы с потоковыми данными
Apache Flink — это движок с открытым исходным кодом для обработки неограниченных потоков событий в реальном времени. Задание Flink считывает события из источника, такого как Kafka, запускает вашу логику для каждого из них по мере поступления и записывает результаты вниз по потоку. Здесь нет конца файла, которого нужно ждать.
Именно это делает потоковую обработку сложнее пакетной. Пакетное задание работает с полным, завершенным набором данных. Потоковое задание видит события по мере их поступления: непрерывно, всплесками, не по порядку и иногда с опозданием. Для остальной части этой статьи имеют значение четыре понятия из Flink:
- Время события: когда событие реально произошло, взятое из самой записи.
- Время обработки: когда событие достигло машины, которая его обрабатывает, что может быть намного позже или в другом порядке.
- Состояние: то, что задание запоминает между событиями для каждого ключа (для нас — для каждого сеанса). Flink хранит его в бэкэнде состояния, либо в куче JVM (памяти Java-процесса), либо в RocksDB, встроенном хранилище «ключ-значение» на локальном диске.
- Контрольные точки (чекпоинты): периодические снимки этого состояния, чтобы перезапущенное задание возобновляло работу с того места, где остановилось, без потери или дублирования данных.
События сетевого подключения показывают, почему это важно. Если шаг аутентификации сеанса приходит после шага DNS, задание, доверяющее порядку прибытия, считывает цепочку неверно. Чтобы сделать все правильно, требуется потоковая обработка с состоянием: запоминание предыдущих шагов каждого сеанса и приведение их в порядок по времени события перед принятием решения об успешности подключения.
Проблема: ложные срабатывания при скорости 200 000 сообщений в секунду
Наш конвейер считывает события сетевого подключения из Kafka. Каждая попытка подключения представляет собой цепочку шагов разных типов (например, auth, assoc, dhcp и dns). Чтобы оценить, было ли подключение успешным, мы должны прочитать шаги сеанса в том порядке, в котором они происходили на самом деле.
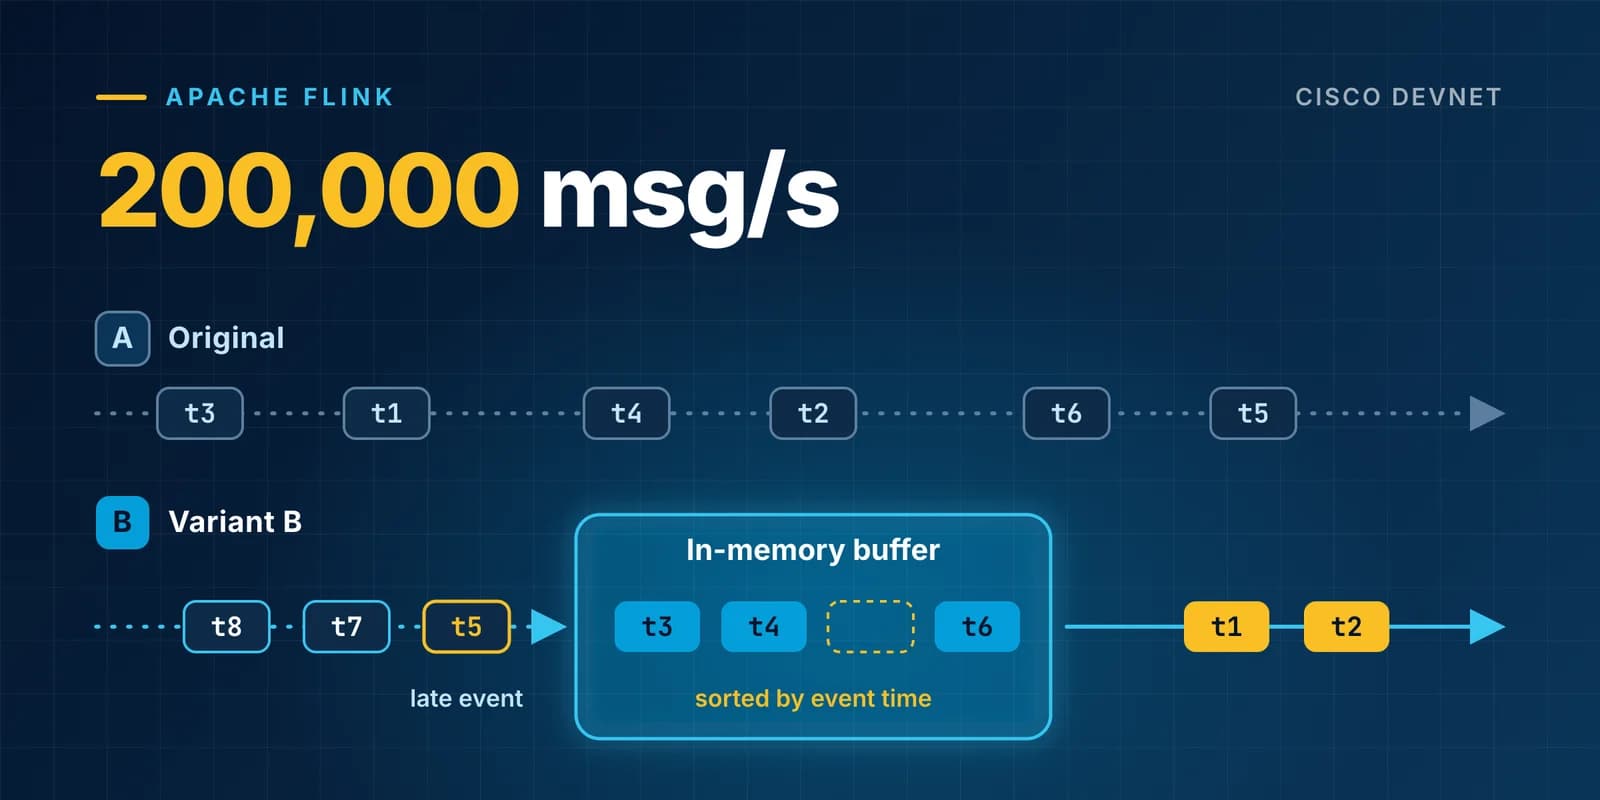
При скорости 200 000 сообщений в секунду этот порядок не совпадает с порядком поступления. Трафик поступает всплесками, и некоторые события приходят с опозданием. Наше исходное приложение Flink с трудом справлялось с тем и с другим, что привело к ложным срабатываниям в отчетах об успешности подключений.
Флейм-граф указал на RocksDB
Мы нашли причину с помощью флейм-графа в веб-интерфейсе Flink (диаграммы, показывающей, на что задание тратит время; более широкие полосы означают большее время). Эта функция не включена по умолчанию, поэтому задайте параметр rest.flamegraph.enabled: true, чтобы задействовать ее. Наши буферы сеансов находились в RocksDB — бэкэнде состояния, который Flink использует для крупного долговечного состояния.
Это имеет свою цену на критическом пути выполнения. Как поясняется в документации по бэкэндам состояния Flink, каждое чтение и запись через RocksDB сериализует и десериализует значение. В нашем задании каждое входящее событие вызывало этот ресурсоемкий доступ к состоянию плюс регистрация таймера.
RocksDB не была неверным инструментом; она существует для хранения состояния, превышающего объем памяти. Она оказалась не тем местом для переупорядочения событий для каждого отдельного сообщения. Нам потребовался более быстрый уровень для упорядочивания событий перед фиксацией данных в долговечном состоянии.
Решение: переупорядочивание в памяти по времени события
Мы создали второе приложение параллельно под названием «Вариант B». Оно группирует попытки каждого сеанса по типу шага (например, auth, assoc, dhcp и dns), упорядочивает их по времени события и позволяет сортировать поздно прибывающие события внутри буфера каждого сеанса перед синтаксическим анализом.
Буфер находится внутри KeyedProcessFunction, низкоуровневого оператора Flink, который предоставляет доступ к состоянию и таймерам для каждого ключа. События сеанса попадают в HashMap, а специальный компаратор сортирует их по времени события (когда оно произошло), а не по времени получения (времени обработки). Поздние прибытия занимают свое место в буфере сеанса до того, как мы распарсим цепочку.
Теперь критический путь обращается к обычным объектам в куче без постоянного взаимодействия с состоянием. Обратной стороной является память: буфер располагается в куче JVM, вне управляемого состояния Flink, поэтому он должен иметь ограничения. Подробнее об этом ниже.
Снимки только по контрольным точкам сохраняют семантику exactly-once
Вариант B по-прежнему записывает долговечное состояние, просто не для каждого события. При каждой контрольной точке мы копируем содержимое буфера в ListState (список, который Flink сохраняет с каждой контрольной точкой), а при перезапуске приложения восстанавливаем буфер из него. Документация Flink по работе с состоянием охватывает хуки создания снимков и восстановления.
Поскольку снимок буфера создается как часть каждой контрольной точки, гарантия exactly-once от Flink по-прежнему сохраняется для состояния приложения. Сквозная доставка exactly-once также зависит от того, как приемник (sink) обрабатывает повторно воспроизводимый вывод, поэтому эту сторону тоже стоит проверить.
Три защитных механизма, ограничивающих размер буфера
Буфер в памяти при такой скорости требует ограничений. Мы внедрили три механизма:
- Вытеснение по неактивности: специальный трехминутный тайм-аут неактивности (не встроенный TTL состояния во Flink, то есть time-to-live, который охватывает только состояние с ключами) удаляет неактивных клиентов из буфера.
- Устранение дребезга таймеров: мы ограничили регистрацию таймеров, чтобы они не срабатывали избыточно.
- Компактные записи: компактные POJO (простые объекты Java, содержащие только необходимые нам поля) заменяют сырые записи, и мы парсим поля только один раз — при поступлении.
Исходя из этого, мы настроили длину окон сеанса и значения защитных механизмов для баланса между обнаружением краевых случаев и использованием ресурсов.
В основе всего этого мы перенесли наше развертывание Flink в Kubernetes на базе Amazon EKS. Для нас это обеспечило экономическую эффективность и гибкость управления ресурсами, необходимые при таком масштабе.
Пять месяцев бок о бок, а затем переключение с помощью конфигурации
Мы не стали сразу заменять производственный конвейер. Мы запустили Вариант B параллельно с исходной реализацией в течение пяти месяцев, используя флаги функций для управления тем, какие результаты видны. Это позволило нам подтвердить результаты Варианта B на реальных производственных данных, в то время как оригинал оставался стандартным.
Это особенно важно для потоковой обработки с состоянием. Ошибки упорядочивания проявляются при реальном трафике: всплесках, запоздалых событиях и краевых случаях, которых нет в тестовых наборах. Запуск обоих конвейеров параллельно — это способ обнаружить такие случаи до того, как они попадут в продакшн.
Когда мы обрели уверенность, процедура переключения оказалась простой:
- Обновить темы по умолчанию.
- Удалить логику ветвления из пользовательского интерфейса, сервера панели мониторинга и уровня запросов ClickHouse.
Контрольный список для вашей следующей задачи потоковой обработки с состоянием
Если вы запускаете задание Flink с состоянием при высоких объемах данных, вот что мы сделали бы снова:
- Сначала выполните профилирование: откройте флейм-граф перед изменением схемы состояния.
- Держите горячий путь в памяти: буферизуйте данные в KeyedProcessFunction и сохраняйте снимок в ListState только на контрольных точках, чтобы перезапуски восстанавливали буфер.
- Ограничивайте буферы: сохраняйте в контрольной точке только то состояние, которое необходимо для восстановления буфера, и заранее отфильтровывайте недействительные записи.
- Выселяйте неактивные сеансы: используйте жесткое выселение по неактивности для предотвращения утечек памяти.
- Проверяйте перед переключением: используйте A/B-разработку для сравнения результатов ниже по потоку в реальном времени и выявления непредвиденного поведения до выпуска в продакшен.
Высокопроизводительная потоковая обработка с состоянием сводится к двум привычкам: держите доступ к бэкенду состояния вне пути каждого события и никогда не переключайте задание с состоянием вслепую.
На этой неделе включите Flink flame graph для вашего самого загруженного оператора и посмотрите, куда на самом деле уходит его время.