
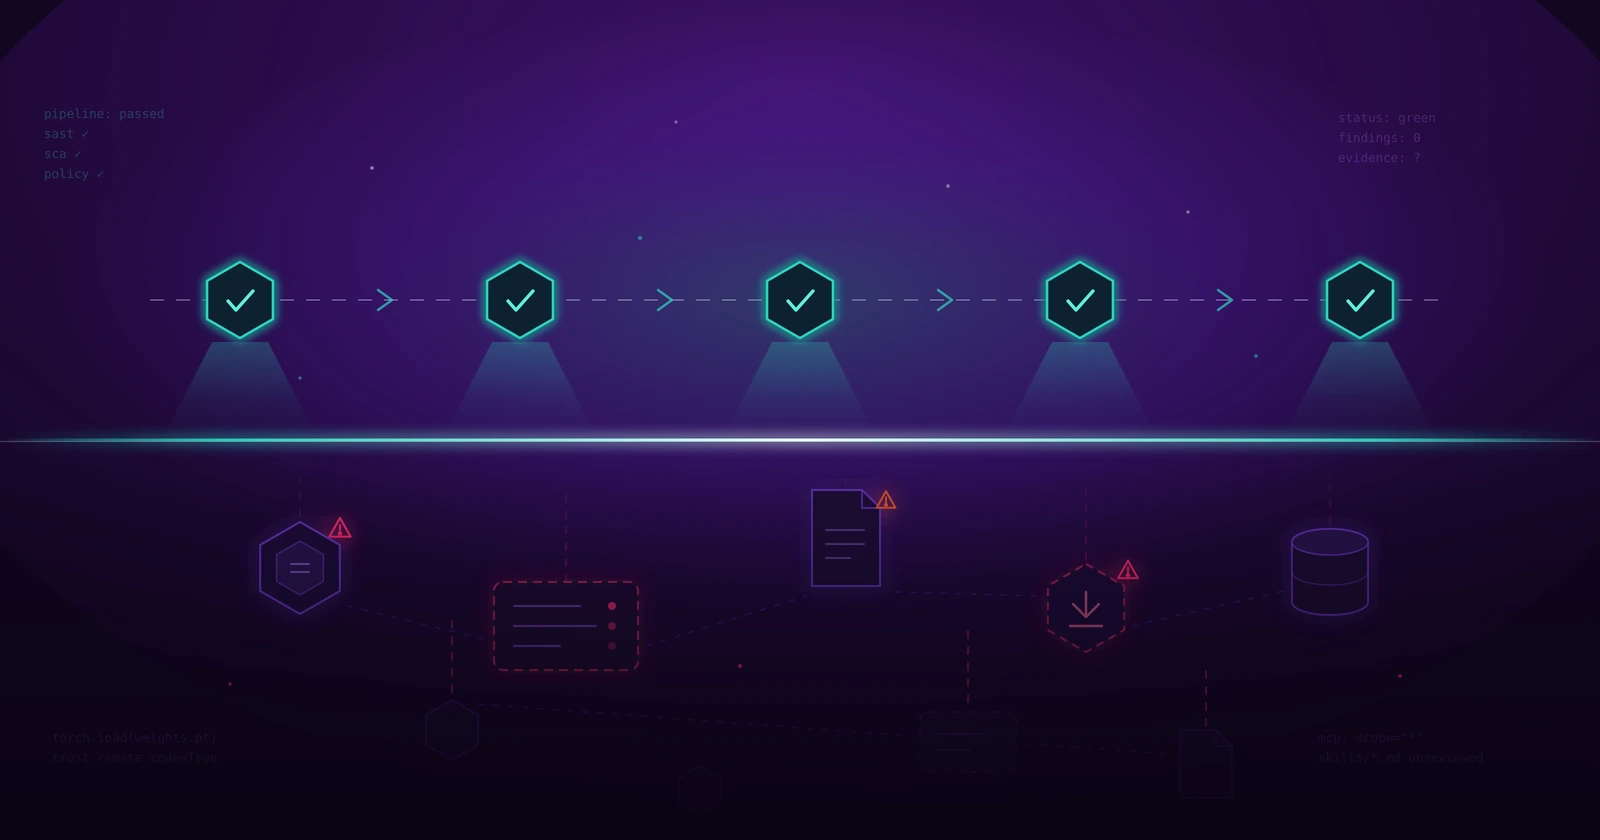
Эра «доверия как политики» для регуляторов закончилась.
Раньше эта цепочка была проблемой внутренней зрелости, чем-то, над чем программа безопасности могла работать со временем:
Разработчик доверяет коду, созданному ИИ, потому что он компилируется. Рецензент доверяет резюме, созданному ИИ, потому что оно звучит правдоподобно. Команда безопасности доверяет результатам сканера, потому что пайплайн «зеленый». Аудитор доверяет доказательствам, потому что чек-лист заполнен. Ни на одном этапе никто не проверяет сам объект. Каждый человек лишь подтверждает, что предыдущий шаг выглядел нормально.
Теперь это не так. EU AI Act, Cyber Resilience Act, NIS2 и DORA теперь предполагают или требуют наличия документированного реестра и проверяемого контроля над системами с поддержкой ИИ. ISO 42001 превращает эту базу в полноценную систему управления с ответственностью, оценкой рисков, контролем жизненного цикла и мониторингом. Ни одна из этих структур не примет «зеленый» пайплайн в качестве доказательства. Они задают другие вопросы: можете ли вы предоставить реестр и можете ли вы доказать, что политика соблюдалась.
Это разрыв, который большинство организаций скоро обнаружат на собственном горьком опыте. Сегодня только 22% организаций имеют официальную политику управления ИИ. Разрыв глубже, чем кажется: руководство считает, что около 27% активов ИИ стандартизированы и регулируются, в то время как практики, работающие с ними напрямую, оценивают этот показатель в 12%. Это именно тот разрыв между отчетом о соответствии и реальным положением дел, который обучен находить аудитор.
Но насколько сложно составить список активов ИИ?
Цепочка поставок ИИ больше, чем вы думаете, и растет быстрее
Заманчиво думать об ИИ в цепочке поставок как о нескольких вызовах API LLM. На практике инфраструктура продолжает расширяться, включая агентские фреймворки, способные к автономным действиям, уровни оркестрации и, все чаще, MCP-серверы, которые подключают ассистентов к инструментам, файлам и данным.
Каждая модель, которую скачивает команда, поставляется не только с весами. Она содержит скрипты загрузки и файлы настройки, которые выполняются в среде в момент загрузки модели — без pull-реквеста, без проверки кода, без контроля безопасности. Файл с pickle-оберткой может содержать исполняемые опкоды и вспомогательные средства пересборки Torch, способные к атакам через десериализацию. Вызов trust_remote_code=True дает скачанному скрипту пропуск в среду выполнения. Ассистенты для написания кода усугубляют проблему с другой стороны: модель рекомендует пакет, пакет оказывается вредоносным, и уязвимость не вписана в код — она установлена.
Разработчики, использующие ИИ, делают коммиты в 3–4 раза чаще своих коллег, но привносят уязвимости в 10 раз чаще (Cloud Security Alliance, 2026). Значительная часть того, что скрывается за этой цифрой, — это вовсе не уязвимость кода, а неуправляемая модель, MCP-сервер с избыточными правами или файл навыков, содержащий инструкцию, которую никто не проверял. Ничто из этого не соответствует чек-листу, написанному до появления этого класса активов.
Инструменты AppSec никогда не были предназначены для этого
Дело не в том, что разработчики ведут себя плохо. Дело в давлении. Разработчики ограничены сроками, чтобы быстрее дойти до статуса «готово», и непроверенные инструменты ИИ очень хорошо в этом помогают. Команды безопасности обычно знают, какие корпоративные ИИ-платформы официально одобрены, но у них гораздо меньше видимости в отношении расширений браузера, плагинов IDE, CLI-агентов и MCP-серверов, которые разработчики используют ежедневно.
Большинство инструментов AppSec не могут ответить на этот вопрос, потому что они никогда не были созданы для работы с этим классом активов. SAST читает исходный код. SCA читает заявленные зависимости. Ни один из них не может открыть файл .pt, .pth или .pkl и сказать, что внутри.
Причина, по которой инструменты не видят этого, заключается в том, что компоненты ИИ ведут себя не так, как программное обеспечение, вокруг которого строились регулирование цепочки поставок и AppSec. Значительная их часть вообще не является зависимостями. Это вызов API к конечной точке модели, системный промпт в конфигурационном файле, файл навыков, определение агента.
Вопрос риска смещается соответствующим образом: не «уязвима ли эта версия?», а «отравлена ли эта модель?», «есть ли у этого MCP-сервера избыточные права?», «содержит ли этот файл навыков внедренную инструкцию, которую никто не проверял?». Ни один из этих вопросов не укладывается в чек-лист, написанный до появления этого класса активов.
По сути, ИИ добавляет второй, более сложный уровень, который традиционные инструменты AppSec сегодня не могут обнаружить, включая:
- Кто или что создало этот код?
- К какому контексту модель имела доступ при генерации?
- Если агент вызывал инструменты, то какие именно и какие данные он считывал?
- Была ли проверка человеком реальным решением или формальностью на пути к релизу?
Ничто из этого не заменяет существующие средства контроля. SCA по-прежнему важен; фреймворк оркестрации или библиотека ИИ вполне могут содержать критическую уязвимость (CVE), и именно для этого был создан SCA. Риски, специфичные для ИИ, требуют выхода за рамки этого, а не замены.
Решение: единый реестр, соответствующий требованиям регуляторов
Вы не можете управлять тем, что не можете инвентаризировать. И вы не можете инвентаризировать это, прося сам ИИ отчитаться о себе. Это просто превращает обнаружение в очередное утверждение.
Здесь на помощь приходит безопасность цепочки поставок ИИ (AI Supply Chain Security). Это не дополнительный сканер, а детерминированное обнаружение каждой модели, MCP-сервера, агента и набора данных в ваших приложениях.
Сканеры LLM подключаются напрямую к местам хранения моделей: репозиториям Hugging Face, внутренним реестрам, локальным директориям, Git-репозиториям и проводят статический анализ всей поверхности проекта: исходного кода на Python, блокнотов и бинарных форматов моделей, включая PyTorch, Keras и файлы с pickle-оберткой, в поисках небезопасной десериализации, опасных загрузчиков моделей, выполнения команд оболочки, а также специфических опкодов и вспомогательных средств пересборки, которые позволяют модели выполнять код во время загрузки. Модель никогда не запускается. Никакого снижения производительности, никакого нарушения работы ML-пайплайна. Та же строгость распространяется на MCP-серверы, оценивая, соответствуют ли действия инструментов подключенного сервера заявленным, а также на агентские фреймворки.
Каждое сканирование формирует один артефакт: AI-BOM, экспортируемый реестр каждой модели, SDK, агента, MCP-сервера, навыка и набора данных в инфраструктуре, сопоставленный напрямую с требованиями документации EU AI Act, NIS2, DORA и ISO 42001.
Ландшафт регулирования и стандартов ИИ: как Checkmarx может помочь
Политика без механизма контроля — это совет, а не управление. Принудительное управление означает, что компоненты ИИ оцениваются, закрепляются за владельцами и ограничиваются с той же дисциплиной, что и любые другие находки безопасности, используя обнаружение, достаточно детерминированное, чтобы служить доказательством, а не просто оценкой уверенности модели, оценивающей собственную работу.
И поскольку внедрение ИИ больше не ограничивается инженерией, управление не может останавливаться и на традиционном периметре AppSec. Каждый сотрудник все чаще становится разработчиком чего-либо: скрипта, автоматизации, внутреннего инструмента, а это означает, что управление нуждается в легких средствах контроля, которые охватывают части организации, ранее не попадавшие в поле зрения безопасности.
Одной лишь видимости недостаточно. Получив ее, вам все равно нужно оценить и классифицировать то, что вы видите. Управление (Governance) само по себе разделяется на два связанных, но различных вопроса, которые требуют разных доказательств:
- Процесс — как разработчики используют ИИ при создании программного обеспечения. Какие помощники по написанию кода одобрены, какие данные можно вводить в промпт, можно ли напрямую принимать сгенерированный код, какая проверка человеком требуется и как обеспечивается подотчетность.
- Продукт — какой ИИ встроен в то, что вы выпускаете. Какие LLM или провайдеры задействованы, какие данные они обрабатывают, является ли сценарий использования высокорискованным, регулируемым, ориентированным на клиента или критически важным для безопасности, и какая документация или мониторинг требуются в связи с этим.
Если рассматривать это как единый недифференцированный разговор об «управлении ИИ», вы в итоге получите лишь частичный охват того или другого.
Это различие важно, потому что обязательное соблюдение нормативных требований — это текущий фактор, а не будущий. Ландшафт регулирования и стандартов ИИ расширяется, и организации, которые опередят события, — это не те, кто запрещает инструменты ИИ, и не те, кто позволяет им работать бесконтрольно. Это будут те, кто сможет с доказательствами, а не просто с уверенностью, сказать, какой именно ИИ находится в их конвейере, на что он способен и кто несет за него ответственность.
Хотите услышать полный разговор? Недавно мы провели живую панельную дискуссию с руководителями в области исследований безопасности, продуктов для цепочек поставок ИИ и глобального консультирования по AppSec — «Теневой ИИ в SDLC» (Shadow AI in the SDLC), — охватив темы видимости, рисков MCP и пути к управляемому ИИ.
Теги:
Управление ИИ
Инвентаризация ИИ
Безопасность цепочки поставок ИИ
AI-BOM
Соответствие требованиям AppSec
EU AI Act
ISO 42001
Безопасность MCP