Автор: Марчелло Мажонки (Marcello Majonchi), директор по продуктам в Arduino
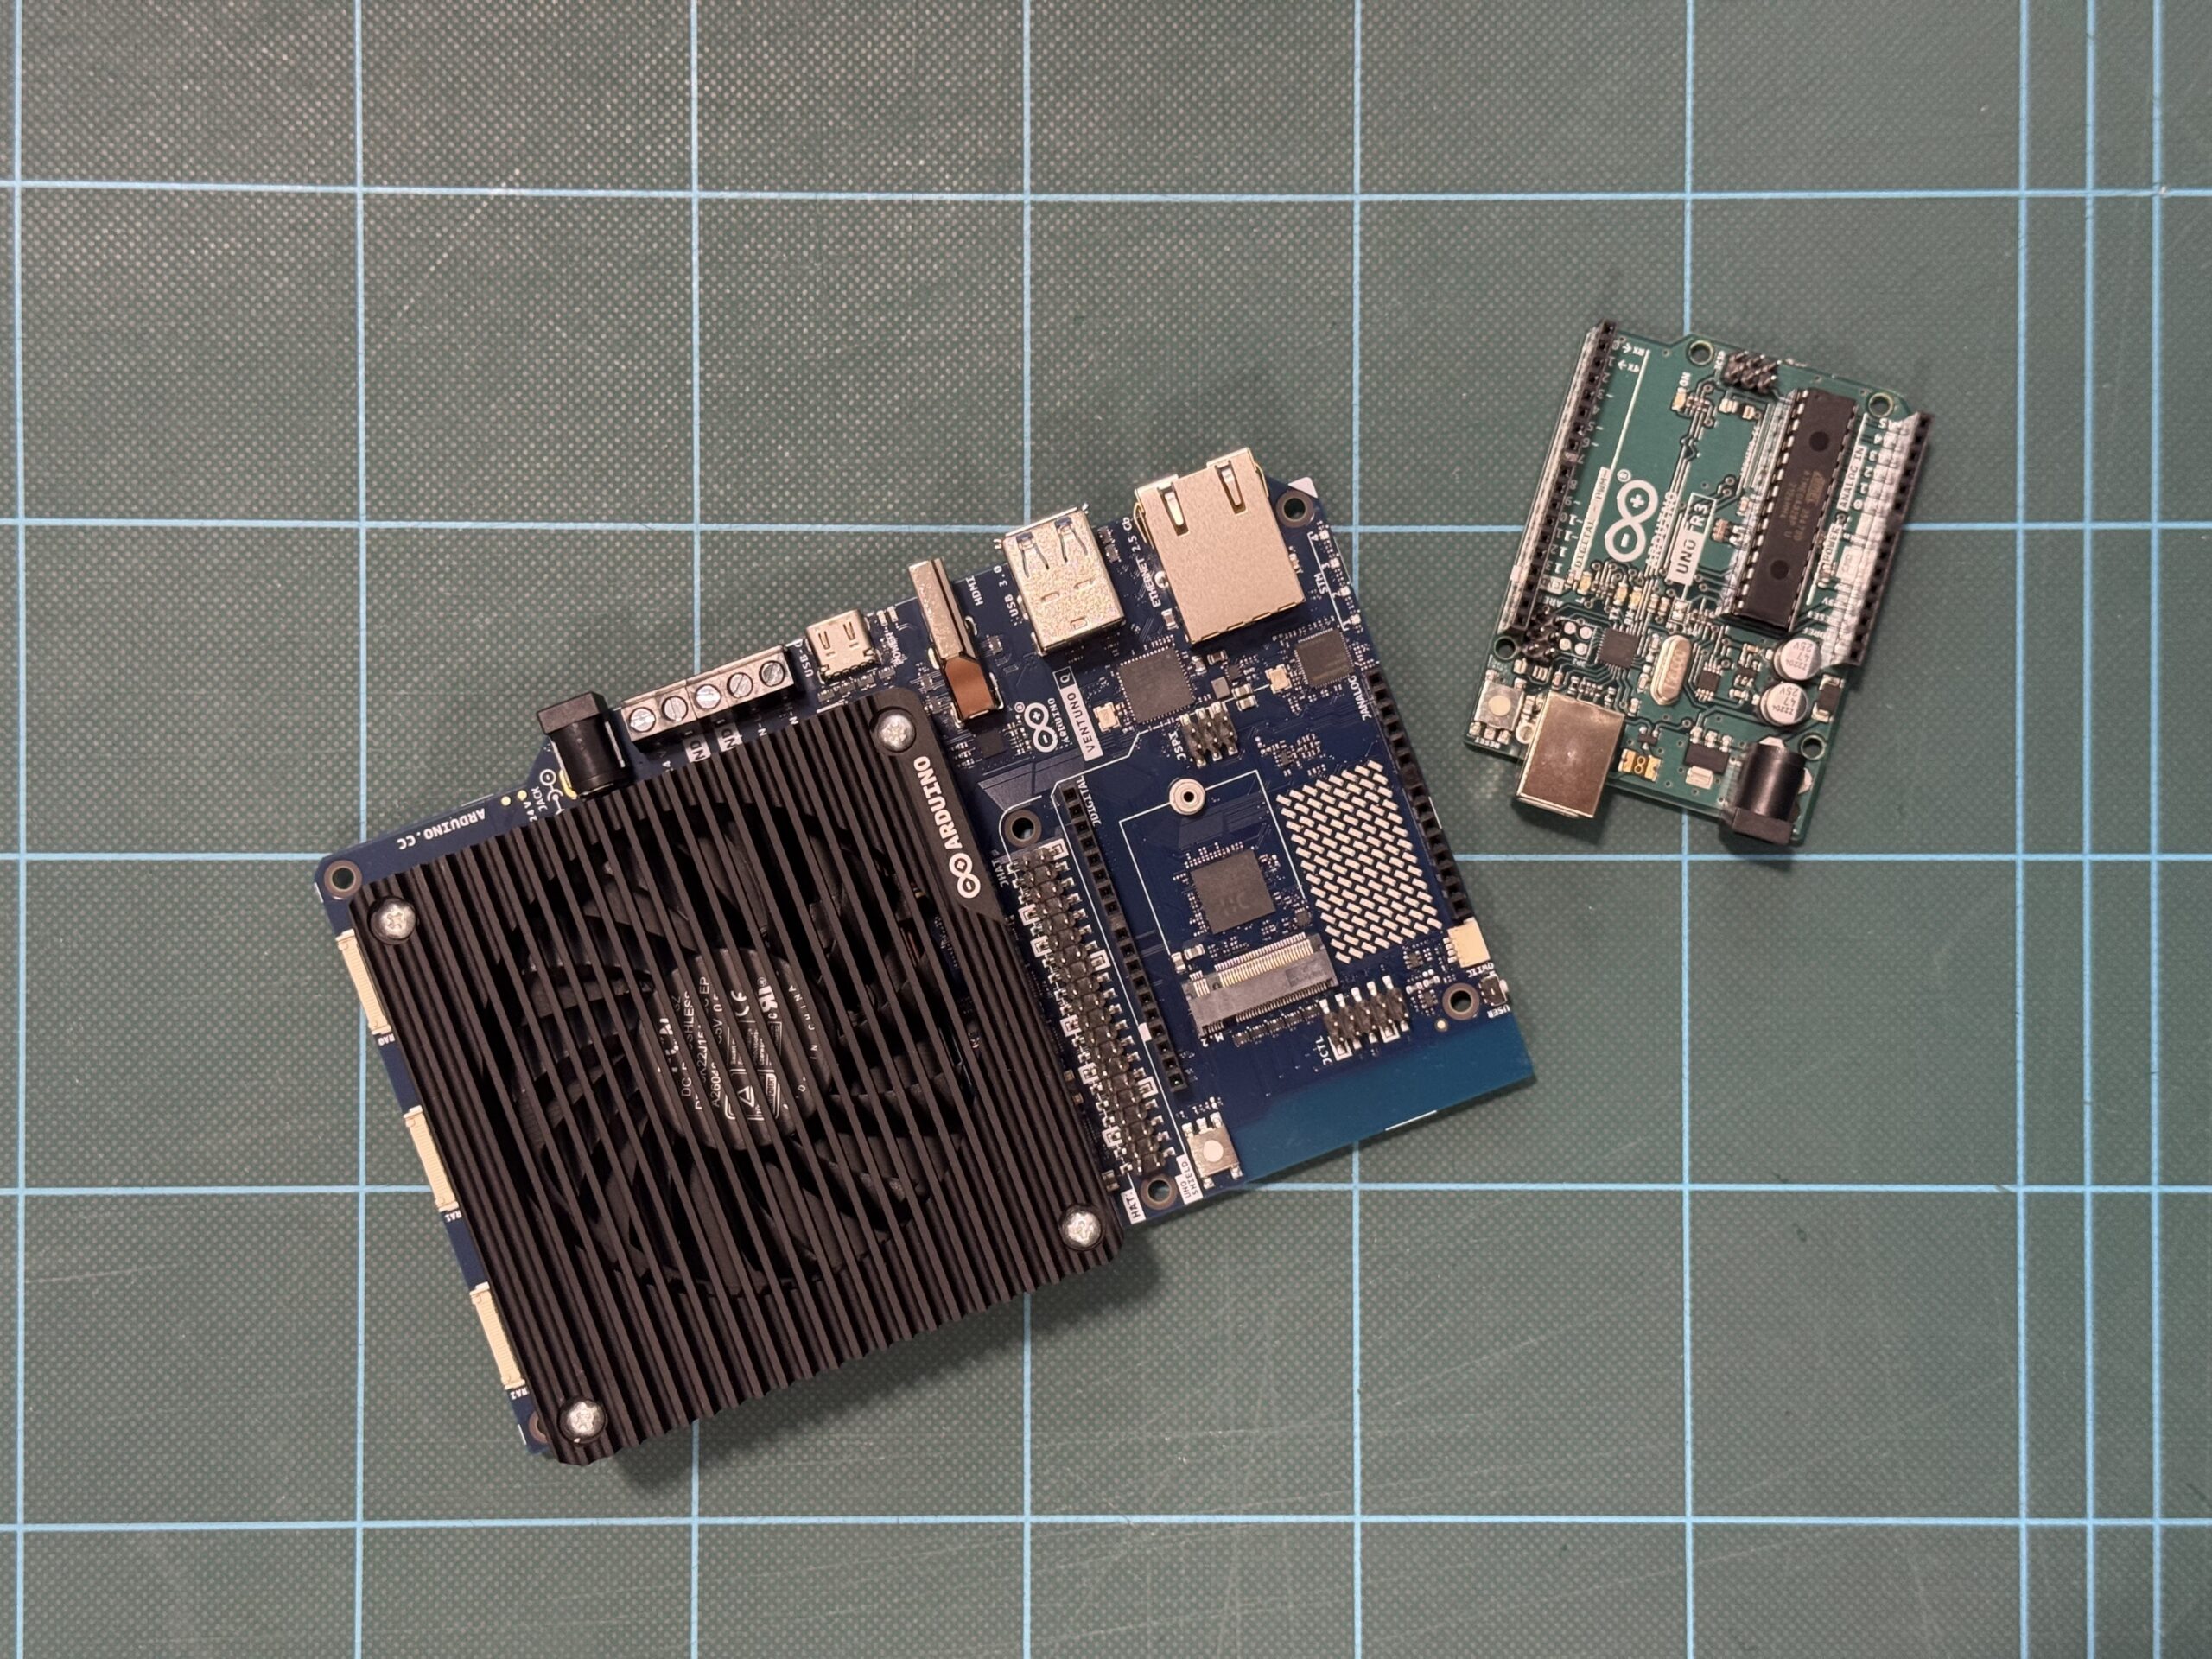
На моем столе лежат две платы. У них одинаковый логотип и в чем-то схожие названия. Их технологии не могут быть более разными, и тем не менее философия за ними стоит абсолютно одинаковая.
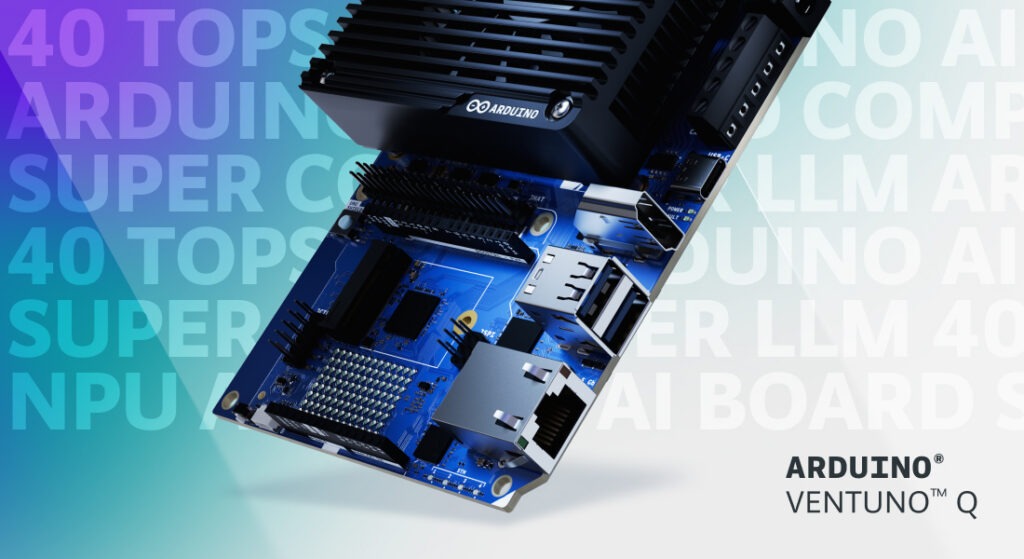
Слева у меня ранняя плата Arduino UNO Rev3, оснащенная микроконтроллером Microchip ATmega328P — кремниевым чипом размером с ногт, восходящим к 2000-м годам, который дал старт оригинальной революции Arduino. Справа располагается Arduino VENTUNO Q, работающая на чипсете Qualcomm Dragonwing IQ-8 с восьмиядерным процессором и NPU, способным выдавать до 40 плотных TOPS, что делает ее самой мощной платой Arduino с акцентом на ИИ на сегодняшний день.
Обе платы — это Arduino. Обе имеют одинаковые штыревые разъемы. Всего за несколько шагов вы можете замигать светодиодом на одной из них или развернуть на другой LLM с 8 миллиардами параметров, а затем спросить у нее, как запрограммировать исходную плату для мигания светодиодом.
Удивительно, как технологии эволюционировали за последние 20 лет, но вполне естественно возникает вопрос: насколько именно?
Что ж, вы уже знаете ответ из заголовка, однако поиск точной цифры раскрывает распространенную проблему в том, как преподносятся спецификации производительности, и предлагает лучший способ оценки любых заявлений о производительности.
Проблема спецификаций
Чипсет Dragonwing (IQ-8275) на плате VENTUNO Q имеет заявленную спецификацию в 40 плотных TOPS, что означает сорок триллионов плотных операций в секунду.
Чип ATmega328P образца 2009 года, с другой стороны, является рабочей лошадкой мира встраиваемой электроники: одиночное 8-битное ядро AVR RISC с тактовой частотой 20 МГц, известное своим давним применением во встраиваемых системах, простой архитектурой и широкой доступностью.
В техническом описании ATmega нет метрик производительности, потому что тогда никто не отслеживал подобные вещи. Но если оценить его вычислительный предел вручную, получается примерно 8 миллионов операций в секунду.
Разделите 40 триллионов на 8 миллионов, и вы получите 5 миллионов. Вопрос закрыт?
Не совсем. За этим простым делением скрывается распространенная ловушка в интерпретации показателей производительности: операции не равны друг другу.
Компьютеры выполняют математические вычисления в разных форматах — представьте их как разные валюты. Форматы с низким числовым разрешением (часто используемые для базовой яркости пикселей) требуют относительно малых вычислительных ресурсов. Высокоточные числа с плавающей запятой (обычно применяемые в физике или навигации) как правило требуют больше вычислительных ресурсов. В результате чип, оптимизированный для быстрого перемалывания простых целых чисел, может выглядеть посредственно при столкновении со сложными десятичными дробями.
Маркетинговые материалы для ИИ-оборудования обычно указывают формат с низким разрешением целых чисел — INT8 или INT16. Сравнение этих цифр с оценкой ATmega328P, полученной на основе тактовых циклов общего назначения, сродни сравнению разных валют без применения обменного курса. Получившееся число может выглядеть впечатляюще, но оно не дает корректного сравнения по принципу «равный с равным».
Итак, вот правило № 1 для значимых сравнений производительности: обе стороны должны измеряться с использованием одной и той же «валюты».
Проектирование честной гонки
Для проведения осмысленного сравнения оба чипа должны выполнять одну и ту же операцию над одними и теми же данными и выдавать эквивалентные результаты.
Типичной рабочей нагрузкой для такой операции является математическая основа современного машинного обучения: умножение двух чисел и добавление результата к текущей сумме. Это называется операцией умножения с накоплением или, в просторечии, MAC.
Повторите этот цикл миллионы (или триллионы) раз, и вы сможете прийти к таким вещам, как классификация изображений (то есть определение того, содержит ли фотография собаку, машину или праздничный торт), распознавание речи (то есть непрерывный поиск конкретного слова пробуждения с одновременной фильтрацией фонового шума) или даже более экзотичным вещам вроде автономной навигации (то есть оценке данных датчиков в реальном времени для отличения стены от человека).
Все эти задачи основаны на одной и той же базовой математике — совокупности операций MAC, просто в разных масштабах, что делает их полезной линейкой для измерения.
Фактический бенчмарк
Давайте для простоты выберем классификацию изображений.
Нам понадобятся тестовые изображения для подачи в обе системы, созданные из стандартных цифровых фотографий, обрезанных и измененных до единого разрешения 224 × 224 пикселя по трем цветовым каналам RGB. Такая предварительная обработка преобразует каждую фотографию в массив входных данных (также известный как тензор), содержащий 150 528 отдельных значений пикселей (224 умножить на 224 и умножить на 3). Данные изображения форматируются в виде 8-битных квантованных целых чисел (INT8), сопоставляющих каждое значение цвета с целым числом от 0 до 255 в соответствии с низкоразрядным целочисленным форматом, требуемым современным железом.
Оценка одной фотографии требует потоковой передачи этого тензора через модель зрения, содержащую примерно 100 мегабайт сохраненных параметров, что создает рабочую нагрузку в 8 миллиардов общих операций (4 миллиарда шагов MAC). VENTUNO Q спроектирована так, чтобы обрабатывать примерно 5000 фотографий каждую секунду; с такой скоростью система могла бы отсортировать целый фотоархив (или просто набор снимков из ресторана у миллениала) за один сердечный ритм. При тех же предположениях бенчмарка оригинальной плате UNO Rev3 потребовалось бы около 17 минут на анализ той же фотографии, так что подумайте дважды, прежде чем делать снимок этого тирамису.
Чтобы обработать 5000 фотографий, на работу с которыми за одну секунду рассчитана VENTUNO Q, плате UNO Rev3 потребовалось бы примерно 58 дней при текущей скорости бенчмарка. Если бы вы начали 1 января, она бы не закончила работу до конца февраля.
В контексте этого бенчмарка разница в производительности остается на уровне пяти миллионов к одному.
Почему все это на самом деле не имеет смысла
Вот в чем подвох: UNO Rev3 практическим образом не может выполнить эту рабочую нагрузку бенчмарка, поскольку модель превышает доступные ресурсы памяти устройства.
Для модели компьютерного зрения требуется примерно 100 мегабайт памяти для хранения ее параметров. ATmega328P имеет 32 килобайта флеш-памяти и 2 килобайта оперативной памяти, чего недостаточно для хранения модели.
Метрика «58 дней» просто предполагает наличие бесконечной внешней памяти. Это чисто умозрительное упражнение, но есть кое-что еще более актуальное.
Разрыв между 2008 годом и сегодняшним днем заключается не только в том, что старый чип работает медленно. Дело в том, что целая категория задач перешла из разряда невыполнимых на старом железе в разряд рутинно реализуемых на современных платформах ИИ. Никакое количество терпения не сможет растянуть 8 килобайт памяти до 100 мегабайт.
Настоящие технологические скачки редко ощущаются как «то же самое, только быстрее». Они проявляются в виде совершенно новых категорий возможностей, открывающихся впервые.
Что действительно имеет значение
Хотя это умозрительное упражнение указывает на пятимиллионную разницу в арифметических возможностях, значимость VENTUNO Q выходит за рамки чистой вычислительной производительности.
Одним из ключевых вкладов платформы является повышение доступности периферийного интеллекта за счет снижения барьеров для экспериментов и разработки. Цель состоит в том, чтобы разработчикам было проще перейти от изучения ИИ-программ к созданию физических систем ИИ.
Будь то переключение контакта GPIO на 8-битном ATmega или развертывание модели компьютерного зрения на современном NPU, обе платы созданы на основе единой философии разработки: подключите железо, откройте доступную среду разработки и приступайте к созданию.
Именно этот акцент на доступности для разработчиков имеет наибольшее значение. Несмотря на существенные различия в вычислительной мощности, обе платы спроектированы так, чтобы обеспечить понятный путь в разработку аппаратного обеспечения и эксперименты.
Сохранение доступности при одновременном кардинальном расширении вычислительных возможностей представляет собой значительное инженерное достижение. Для меня в этом и заключается главная суть. Повышение доступности технологий искусственного интеллекта помогает большему количеству людей перейти от использования ИИ-инструментов к созданию собственных приложений с поддержкой ИИ.
Продукты под брендом Qualcomm являются продуктами компании Qualcomm Technologies, Inc. и/или ее дочерних компаний. Arduino, UNO, VENTUNO и логотип Arduino являются товарными знаками или зарегистрированными товарными знаками компании Arduino S.r.l.