Кратко: Content Addressed Storage (CAS), экспериментальная функция в Antalya 26.6, представляет собой расширение модели хранения ClickHouse, которое позволяет хранить данные MergeTree в общем объектном хранилище. Самое главное, оно позволяет масштабировать хранилище независимо от вычислений.
«Бейся головой о стену достаточно долго, и что-нибудь обязательно сработает». — Английская поговорка
Разделение вычислений и хранилища — важнейшая проблема в современных аналитических системах. Аналитические базы данных следуют примеру Snowflake и размещают единую копию табличных данных в общем объектном хранилище. ClickHouse двигался в этом направлении в течение нескольких лет, но до сих пор открытые сборки не предлагали полного решения.
Altinity Antalya 26.6 представляет новое расширение модели хранения ClickHouse — Content Addressed Storage (CAS), которое предлагает простой способ использования общего объектного хранилища для таблиц MergeTree. Пользователи могут включить его, обновившись до последней сборки Antalya и внеся простое изменение в конфигурацию. Оно работает со всеми движками таблиц MergeTree.
Большинство баз данных спроектированы для одноузловой архитектуры. Чтобы масштабировать такие архитектуры вверх, необходимо увеличить объем памяти, диска и количество процессоров в системе. Но существует предел тому, насколько их можно увеличить в рамках одного сервера.
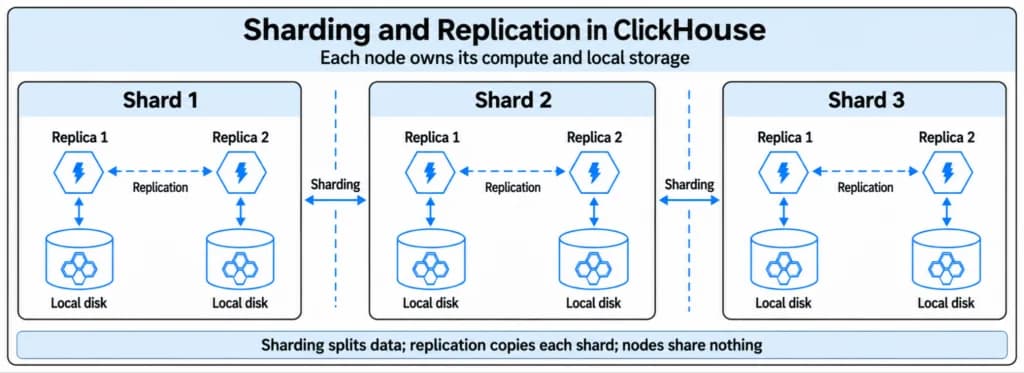
Здесь на помощь приходит архитектура без совместного использования ресурсов (shared-nothing). В ней каждый отдельный узел обладает собственной вычислительной мощностью и собственной выделенной частью или копией данных. Это обеспечивает массивный параллелизм, распределяя данные и обработку по нескольким узлам. Базы данных приняли эту архитектуру под названием массово-параллельной обработки (MPP).
Идеальный пример MPP-базы данных — это открытый ClickHouse. Каждый сервер поставляется с процессорами и собственным локальным хранилищем. Несколько серверов в кластере повышают вычислительную мощность за счет репликации и шардирования. У каждого узла есть свое локальное хранилище.
Но у архитектуры без совместного использования ресурсов есть одно критическое ограничение: она не может масштабировать хранилище и вычисления независимо друг от друга.
Пользователи и разработчики баз данных искали архитектуру, в которой единая копия данных могла бы подключаться к нескольким узлам базы данных, распределяющим нагрузку запросов. Snowflake стала пионером этого подхода. DataBricks последовала тому же паттерну несколько лет спустя. В таких архитектурах существует пул данных, обычно размещаемый в объектном хранилище, и несколько узлов обработки запросов, которые извлекают данные из этого пула для обработки запросов. Узлы обработки можно добавлять или удалять по требованию. Хранилище существует независимо.
Источник изображения — блог Snowflake
В 2020 году ClickHouse начал переход к использованию объектного хранилища в качестве варианта хранения для таблиц MergeTree, названного дисками S3. Этот процесс прошел через множество итераций. Объектное хранилище имеет характеристики, отличные от блочного хранения. В частности, задержка в нем намного выше, что требует иной организации данных и методов их извлечения. За прошедшие годы поддержка объектного хранилища в ClickHouse стремительно развивалась. Компактные парты, множество кэшей, префетч и другие ухищрения сокращали разрыв в производительности между локальным хранилищем и объектным хранилищем. Но одна проблема долгое время оставалась нерешенной — совместное использование данных. Несмотря на использование объектного хранилища, ClickHouse продолжал использовать подход shared-nothing, при котором каждый реплика и шард используют собственную копию данных!
Проблема была очевидна, и разработчики ClickHouse отреагировали на нее репликацией без копирования (zero-copy replication). Репликация без копирования означает, что как только одна реплика ClickHouse размещает данные на диске S3, их не нужно реплицировать на другие реплики ClickHouse. Несколько реплик подключаются к одним и тем же общим данным на S3. Проблема решена? Что ж, не совсем.
К сожалению, лежащая в основе конструкция диска S3 в ClickHouse делает репликацию без копирования ненадежной. Если вкратце, хранилище на дисках S3 в ClickHouse состоит из трех систем, которые должны координироваться транзакционным образом: ссылки на данные хранятся на локальном хранилище и реплицируются как обычная таблица ClickHouse, сами данные хранятся в объектном хранилище, а состояние репликации отслеживается в Keeper отдельно для каждой реплики. Вы можете обратиться к статье об архитектуре MergeTree поверх S3 для получения более подробной информации. Поддержание синхронизации этих трех источников данных в реальной жизни практически невозможно. Большинство пользователей, предположительно, страдали молча, поэтому практические проблемы не получили широкой огласки. Наши друзья из Tinybird опубликовали увлекательную историю о своем опыте. Самое главное, что эта конструкция не удаляет файлы-сироты должным образом. Отсутствие эффективной сборки мусора является ключевым недостатком подхода репликации без копирования.
Проблемы репликации без копирования привели к тому, что основная команда ClickHouse объявила ее устаревшей в 2025 году (#82250). Код остался, но все тесты были удалены.
Появление CAS
Потребовалось время, чтобы прийти к лучшему подходу к решению проблемы разделения вычислений и хранилища в ClickHouse. Мы начали с попыток исправить репликацию без копирования, но столкнулись с множеством препятствий. Год спустя мы запустили проект Antalya. Проект Antalya добавляет Apache Iceberg в качестве слоя хранения в ClickHouse, а также бессерверные роевые узлы (swarm nodes) в качестве масштабируемых вычислений. Это позволяет совместно использовать данные между узлами ClickHouse и внешними системами через Iceberg и, следовательно, использовать Iceberg в качестве единой копии данных не только для ClickHouse, но и для других внешних систем. Это великолепная архитектура, которая обеспечивает доступ к данным из потенциально тысяч служб запросов.
Antalya работает действительно отлично, но она также добавляет сложности в обмен на обеспечение широкой доступности хранилища для других приложений. Нам требовалось более простое решение, предназначенное исключительно для ClickHouse. Михаил Филимонов, ведущий инженер Altinity и один из лучших разработчиков ПО, с которыми мне доводилось работать, много ломал над этой проблемой голову. Он заперся в комнате на месяц с изобилием ИИ-инструментов. Так родился CAS.
Концепция адресуемого по содержимому хранилища (content addressed storage) не нова. Она работает за счет ссылки на файлы с использованием хэша содержимого вместо традиционного имени файла. Так работает, например, Git. ClickHouse уже использовал CAS для некоторых внутренних сценариев, таких как дедупликация блоков. Мы просто вывели это на уровень файлов. Мы создали его как расширение существующей модели политики хранения самым простым из возможных способов.
Главная идея заключается в том, что на каждый файл данных таблицы MergeTree ссылаются по хэшу его содержимого. Множество серверов совместно используют один пул объектного хранилища. Здесь нет дублирования байтов, нет бухгалтерии zero-copy в Keeper, нет локального дискового состояния ссылок для каждой реплики, которое растет вместе с объемом данных, и нет изменяемого счетчика ссылок для каждого блога (refcount). Только хэш. Отображение между хэшами и содержимым хранится в неизменяемых файлах манифеста и таблице ссылок в памяти (reftable). Ничего не хранится локально, все находится в объектном хранилище.
Архитектура напоминает Iceberg, и на то есть веские причины. Хранение всей информации «на диске» создает единый источник правды и упрощает такие задачи, как восстановление. Это масштабируемое и проверенное решение.
Вместо того чтобы заменять MergeTree новым движком, мы добавили другой тип метаданных CAS для дисков объектного хранилища. Это существенно упрощает как реализацию, так и миграцию.
Но хватит теории. Позвольте мне показать, как это работает, а затем мы вернемся к техническим деталям.
CAS в действии
CAS расширяет архитектуру ClickHouse, ничего не урезая, поэтому его можно применять в работающих системах ClickHouse без какого-либо редизайна. Чтобы начать его использовать, просто обновитесь до сборок Antalya 26.6 и выше. В версии 26.6.4 было изменение формата, поэтому используйте самую свежую сборку.
После обновления до сборки, поддерживающей CAS, ничего не происходит сразу. Чтобы начать его использовать, диск CAS должен быть определен в конфигурации хранилища ClickHouse:
Как может заметить опытный пользователь ClickHouse, эта конфигурация мало чем отличается от обычного S3-диска. Ключевое отличие заключается в новом параметре metadata_type. ClickHouse уже поддерживает несколько типов метаданных, поэтому мы добавили новый — cas. Кроме того, ему нужно различать разных «клиентов» CAS, и они идентифицируются с помощью cas_server_root_id, который должен уникально идентифицировать узел кластера. Это похоже на {replica} в таблицах ReplicatedMergeTree. (Вместо макроса {replica} можно также использовать {server_uuid}.)
Поскольку CAS является диском, его нужно добавить в политики хранения, чтобы использовать. Например, вот политика, которая хранит данные только на CAS:
Или уровневая политика, которая добавляет CAS в качестве второго уровня:
Все функции ClickHouse поддерживаются в полном объеме. Мы можем создавать таблицы на дисках CAS, перемещать парты и партиции между локальными дисками, обычным S3 и CAS, либо мы можем использовать диск CAS в качестве холодного уровня с помощью выражений TTL таблиц.
Для целей этой статьи я загружу набор данных «ontime» на диск CAS в одноузловой ClickHouse в Altinity.Cloud. Позже я масштабирую его на большее количество узлов и проведу другие эксперименты. Чтобы загрузить тестовый набор данных, можно использовать функцию IMPORT DATASET в Altinity.Cloud или запустить его чистым SQL следующим образом:
Обратите внимание, что движок — ReplicatedMergeTree, но репликация используется только для координации. Данные записываются только один раз.
Загрузка 200 миллионов строк занимает менее 4 минут, и таблица готова к выполнению запросов. Никакой другой магии, она просто работает.
Чтобы посмотреть, как данные хранятся на самом деле, мы можем использовать системные таблицы. Мы можем начать с system.parts, чтобы убедиться, что все данные находятся на CAS:
Также появились три новые таблицы, специфичные для CAS:
- cas_mounts — напоминает system.replicas, но на уровне дисков. В ней показаны серверы и диски, подключенные к пулам CAS
- cas_log и cas_gc_log — полезны для отслеживания того, что происходит внутри CAS
Например, cas_log, сгруппированный по event_type, может дать вам представление о том, что происходило внутри CAS:
Давайте протестируем добавление новой реплики, чтобы убедиться, что мы можем легко масштабировать вычислительные узлы. The Altinity Operator for ClickHouse и Altinity.Cloud делают добавление реплик очень простым. При использовании обычного хранилища ReplicatedMergeTree ClickHouse должен реплицировать данные по сети на новую реплику, что занимает довольно много времени. С CAS инициализация таблицы ontime на новой реплике заняла всего 14 секунд. Это видно из cas_log, как только реплика переходит в онлайн-режим:
На больших наборах данных это может занять больше времени. Нам еще предстоит оценить, как это работает на данных размером в несколько терабайт.
Архитектурные особенности
Под капотом CAS представляет собой бэкенд MetadataStorage, который сохраняет каждый файл парта MergeTree один раз, используя его хеш содержимого в качестве ключа объекта. Узлы ClickHouse используют один и тот же пул объектного хранилища и публикуют ссылки на неизменяемые манифесты. Данные координации CAS хранятся в бакете, а не в Keeper.
Позвольте мне объяснить основные архитектурные решения более подробно.
Как CAS хранит парт?
Начнем с базовой объектной модели. Парт MergeTree — это каталог, содержащий множество файлов. CAS вычисляет хеш содержимого для каждого файла и сохраняет его под ключом, полученным из этого хеша. Если другой парт содержит тот же файл, он разрешается в тот же объект, поэтому нет необходимости сохранять другую копию.
Имя парта не указывает напрямую на эти блобы. Вместо этого оно указывает на изменяемую ссылку (mutable ref), которая указывает на неизменяемый манифест (immutable manifest). В манифесте перечислены файлы, принадлежащие парту, и места хранения их содержимого:
имя парта → изменяемая ссылка → неизменяемый манифест → неизменяемые хешированные блобы
Небольшие файлы метаданных, такие как count.txt или columns.txt, могут быть встроены непосредственно в манифест. Более крупные файлы хранятся как отдельные блобы с адресацией по содержимому.
Как публикуется парт?
Итак, как новый парт становится видимым? ClickHouse не может сначала опубликовать ссылку, а затем выгрузить данные. Сбой между этими действиями оставил бы видимый парт, указывающий на недостающие файлы.
CAS использует тщательно упорядоченную последовательность публикации. Сначала писатель создает неизменяемый манифест. Затем он записывает долговечную предварительную ссылку (precommit ref) перед выгрузкой или принятием необходимых блобов. Как только все блобы становятся доступны, предварительная фиксация повышается до зафиксированной ссылки (committed ref), и парт становится видимым для обычных читателей.
Условная запись объектов обеспечивает координацию. Если два сервера пытаются создать один и тот же блоб, успешной оказывается только одна запись. Другой сервер находит существующий блоб и принимает его вместо выгрузки еще одной копии. В этом решении не участвует отдельная служба метаданных. Координация происходит полностью внутри объектного хранилища.
Чтение следует по цепочке в обратном направлении. ClickHouse разрешает ссылку на парт, проверяет манифест, а затем считывает требуемые диапазоны блобов из объектного хранилища. Файлы, внедренные в манифест, не требуют дополнительного запроса объекта.
Объектное хранилище как единственный источник истины
CAS возлагает на объектное хранилище больше ответственности, чем обычный диск на базе S3. В бакете хранятся не только данные, но и ссылки, манифесты, аренды монтирования, состояние ограждения (fencing) и метаданные сборщика мусора.
Это не исключает Keeper из ReplicatedMergeTree. Keeper по-прежнему координирует журнал репликации и консенсус набора партов, как описано ниже.
Каждый сервер имеет свою собственную идентичность, эпоху записи и возобновляемую аренду монтирования. Если сервер теряет аренду, локальное ограждение запрещает ему выполнять дальнейшие записи. Неоднозначные операции завершаются неудачей по принципу fail-closed: ClickHouse повторяет их попытки, а не предполагает, что неопределенная запись не произошла.
Это требует реальной поддержки условного создания и замены объектов, чтения диапазонов, возобновляемого листинга, стабильных токенов объектов и удаления по точному токену. S3-совместимой реализации недостаточно просто принимать соответствующие заголовки — она должна корректно реализовать логику.
AWS S3 и Google Cloud Storage поддерживают необходимые операции. Azure пока не прошла проверку.
Поведение репликации
CAS не заменяет репликацию ClickHouse. ReplicatedMergeTree по-прежнему использует Keeper для журнала репликации и консенсуса набора партов — именно так другие реплики узнают о прибытии нового парта. CAS меняет то, каким образом получающая реплика получает данные парта.
Чем это отличается от репликации ClickHouse с нулевым копированием (zero-copy replication)? Цель похожа, но модель владения принципиально иная. Репликация с нулевым копированием говорит:
«Реплика 2 должна ссылаться на тот же удаленный объект, который уже использует Реплика 1».
CAS говорит:
«Хэш файла идентифицирует объект. Любая реплика может независимо опубликовать ссылку на него».
При репликации без копирования (zero-copy) реплики разделяют пути к удаленным объектам и используют учет Keeper для координации владения. CAS вместо этого разделяет идентификаторы содержимого.
Получение партов без копирования позволяет избежать передачи байтов, предоставляя принимающей реплике метаданные, указывающие на существующие удаленные файлы. Самая сложная часть заключается в том, чтобы доказать, что эти файлы остаются живыми во время перемещения прав владения между репликами.
CAS справляется с этим с помощью трехэтапного процесса переподключения ссылок:
- Принимающая реплика фиксирует свое намерение использовать общие файлы.
- Она проверяет, по-прежнему ли отправляющая реплика владеет тем же партом.
- После подтверждения она публикует парт локально.
Если какой-либо из шагов дает неопределенный результат, CAS повторяет попытку вместо того, чтобы гадать, что произошло. Байты парта загружаются только тогда, когда удается подтвердить, что переподключение не завершилось. Это предотвращает публикацию репликой парта с недостающими данными или публикацию одного и того же парта дважды.
Сборка мусора
Это, пожалуй, самое главное архитектурное отличие, которое решает проблемы с «осиротевшими» файлами, с которыми пользователи сталкивались при промышленном использовании zero-copy репликации.
Zero-copy должна отслеживать, какие реплики все еще ссылаются на удаленный объект. В RFC 62936 (одной из многочисленных попыток исправить zero-copy репликацию) описываются WAL, очереди ZooKeeper и общие снимки состояния, призванные сделать такое отслеживание более безопасным.
CAS использует другой подход. Он определяет, что все еще необходимо, прослеживая цепочку достижимости:
- Зафиксированная или находящаяся в процессе выполнения ссылка удерживает свой манифест живым.
- Живой манифест удерживает все свои блобы живыми.
- Когда ссылка удаляется, ее блобы могут стать кандидатами на очистку, если на них больше ничего не ссылается.
- Сборка мусора помечает нессылочный блоб и проверяет его снова в следующем цикле.
- Удаляется только точная версия помеченного объекта, поэтому более новая замена остается в безопасности.
Если уверенности в безопасности нет, CAS откладывает удаление и проверяет снова в последующих циклах сборки мусора. Очистка происходит автоматически после того, как доказано, что объект не используется.
Важное примечание по программной инженерии: Михаил доказал эффективность этого алгоритма с помощью TLA+ при содействии Claude. Этот подход представляет собой качественный шаг вперед в разработке надежных алгоритмов, связанных с управлением распределенным хранилищем. В будущем мы расскажем об инженерном процессе CAS подробнее.
Советы и рекомендации
Мы все еще собираем опыт эксплуатации дисков CAS. Позвольте поделиться несколькими советами.
CAS может страдать от тех же проблем, что и любое хранилище MergeTree на базе S3 обмена. Запросы стоят дорого, поэтому, если кто-то записывает много данных непосредственно в CAS, AWS может применить ограничение частоты запросов. В логах появится следующее сообщение, а также общие замедления:
2026.09.04 07:21:28.037323 [ 872 ] {} <Error> AWSClient: Response status: 503, Slow Down
Вот несколько советов, которые могут сделать его эффективнее:
- Не пишите часто на диски CAS. Вместо этого используйте локальное хранилище для высокочастотных вставок и слияний, а затем перемещайте менее фрагментированные данные в CAS с помощью правил TTL.
- Агрессивнее используйте компактные парты. Значение по умолчанию min_bytes_for_wide_part составляет всего 10 МБ, его можно безопасно увеличить до 100 МБ или более. Также можно установить min_level_for_wide_part на уровне 3 или 4, чтобы хранить все парты низких поколений в компактном формате.
- Шардируйте пул для крупных развертываний. Если шардирование кластера зафиксировано, это можно сделать, добавив макрос {shard} в конечную точку. Кроме того, разные таблицы могут находиться в разных пулах.
См. также другие настройки конфигурации в встроенной документации.
До того как CAS достигнет стадии GA, мы планируем создать подробное руководство пользователя, а также применить дополнительные оптимизации сервера для обеспечения бесперебойной работы пользователей. Он также будет интегрирован в Altinity.Cloud.
Статус и планы на будущее
Диски CAS являются экспериментальной функцией начиная с релиза Antalya 26.6. Они прошли всестороннее тестирование самыми разными способами. Функция успешно проходит все стандартные тесты ClickHouse при использовании CAS вместо обычного S3. Мы также разработали собственный набор тестов для функций, специфичных для CAS. Реализация функционально завершена для AWS S3 и GCP GCS. Ее еще нужно адаптировать для работы с хранилищем блобов Azure.
Наш следующий фокус — производительность. Мы протестировали производительность вставок и запросов и поделимся результатами в отдельной статье в блоге. Функция отлично работает для запросов, но пока не обладает полной производительностью для вставок. Поэтому ее можно использовать для холодного уровня, но не в качестве единственной модели хранения.
Параллельно мы также предоставим сравнение между хранением данных в CAS, доступных для чтения только через ClickHouse, и размещением данных таблиц в Iceberg, которые обычно доступны широкому кругу движков запросов. Они решают разные задачи и имеют разные компромиссы. Большим преимуществом CAS является то, что это готовое расширение для существующих приложений ClickHouse.
Мы продолжим экспериментировать с CAS внутри компании и работать над улучшениями. Мы приглашаем всех попробовать его и сообщать о проблемах. Это открытое ПО, и оно всегда будет таковым. Мы с нетерпением ждем появления GA-версии CAS для разделения вычислений и хранилища в OSS ClickHouse к концу 2026 года!