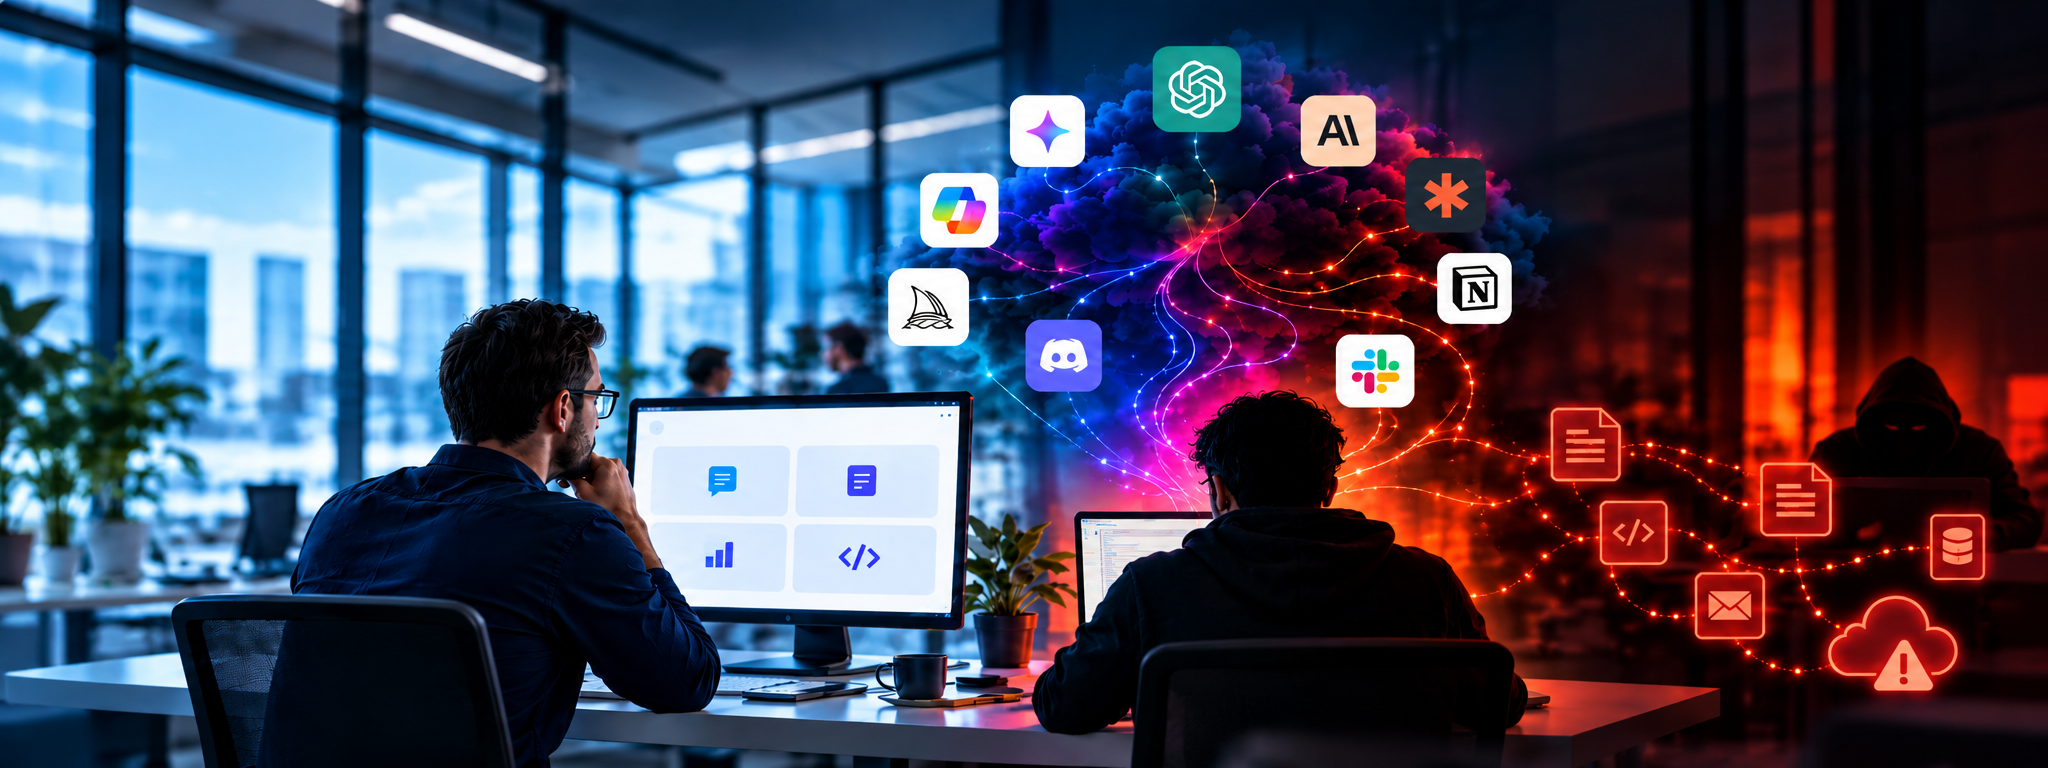
Внедрение ИИ в компаниях больше не ждет, пока системы управления успеют за ним. Сотрудники уже вовсю используют генеративный ИИ для написания кода, суммаризации документов, анализа данных, подготовки писем и автоматизации рутинных задач — зачастую через инструменты и учетные записи, которые службы безопасности не могут полностью контролировать. То, что начиналось как вопрос управления, превратилось в измеримую проблему безопасности, последствия которой уже проявляются в виде затрат на устранение утечек, инцидентов потери данных и растущего разрыва между санкционированным ИИ и тем, как на самом деле работают люди.
Организации с высоким уровнем использования теневого ИИ понесли расходы на устранение утечек, которые в среднем на 670 000 долларов превышали показатели компаний с низким уровнем теневого ИИ или вовсе без него. Каждая пятая исследованная организация сообщила об утечке, связанной с теневым ИИ. Среди организаций, столкнувшихся с инцидентом безопасности, связанным с ИИ, в 97% случаев отсутствовали надлежащие средства контроля доступа к ИИ. В то же время 63% пострадавших организаций либо вообще не имели политики управления ИИ, либо все еще разрабатывали ее, и лишь 34% компаний с такими политиками регулярно проводили аудит на предмет несанкционированного использования ИИ.
Тем временем интенсивность использования растет гораздо быстрее, чем меры контроля. Netskope’s 2026 Cloud and Threat Report показало, что число людей, использующих облачные приложения генеративного ИИ (SaaS) в среднем наборе инструментов компании, за год утроилось, а объем промтов увеличился в шесть раз. Почти половина (47%) пользователей генеративного ИИ по-прежнему применяла персональные ИИ-приложения, а в среднем на каждую организацию приходилось 223 нарушения политики работы с данными, связанных с генеративным ИИ, ежемесячно.
Даже специалисты по безопасности попадают в эту же ловушку. Согласно опросу Mindgard, охватившему более 500 профессионалов в области кибербезопасности, 24% респондентов сообщили о неформальном использовании ИИ, таком как личные аккаунты в ChatGPT или не утвержденные браузерные расширения, и лишь 32% заявили, что их организации активно контролируют использование ИИ. Исследование SANS, опубликованное в июле 2026 года, наглядно показывает, как быстро нарастает давление: использование ИИ в кибербезопасности возросло с 50% до 78% всего за год, однако более половины респондентов отметили отсутствие какой-либо формальной базы аудита для выполнения их обязанностей по управлению ИИ.
Именно это делает проблему теневого ИИ столь трудноразрешимой. В большинстве случаев она является следствием не просто игнорирования политик со стороны сотрудников. Люди начинают использовать ИИ, потому что он ускоряет их работу. Если одобренные инструменты, четкие правила работы с данными, средства контроля учетных записей и мониторинг не поспевают за этим, пользователи заполняют образовавшийся пробел самостоятельно.
Проблема также выходит за рамки просто теневого использования. показало, что каждый четвертый вредоносный инцидент был осуществлен с помощью ИИ (что на 56% больше по сравнению с предыдущим годом), а стоимость таких утечек составила в среднем около 6 миллионов долларов, что примерно на 1 миллион долларов превышает общемировой показатель. Более чем в каждой пятой компании также сообщили об утечке, направленной против модели или приложения ИИ; при этом у 92% таких организаций не было надлежащего контроля доступа к ИИ.
Таким образом, вопрос безопасности больше не заключается в том, будут ли компании использовать ИИ. Они уже это делают. Вопрос в том, останется ли это внедрение прозрачным, ограниченным рамками и подотчетным по мере того, как ИИ превращается из инструмента для консультаций в систему, способную действовать от имени пользователя.
Когда ИИ выходит за рамки текстового поля
Теневой ИИ — это лишь видимая часть айсберга. Главные изменения начинаются тогда, когда системы ИИ подключаются к корпоративным данным и получают возможность использовать инструменты.
Традиционные механизмы кибербезопасности по-прежнему важны. Управление учетными записями, принцип наименьших привилегий, безопасная разработка, классификация данных, мониторинг и реагирование на инциденты остаются фундаментом. NIST’s 2026 analysis в области безопасности ИИ-агентов пришло практически к тому же выводу: знакомые принципы безопасности сохраняют актуальность, но их необходимо адаптировать к системам, где результаты работы моделей могут напрямую влиять на действия программного обеспечения.
Это меняет границы доверия. Обычное приложение получает входные данные и выполняет логику, заданную разработчиками. ИИ-агент интерпретирует инструкции на естественном языке, обрабатывает контент из электронной почты, документов, веб-сайтов, репозиториев и других систем, а также может самостоятельно решать, какой инструмент вызвать следующим. Если агент также способен извлекать конфиденциальную информацию или модифицировать внешние системы, различие между данными и инструкциями приобретает критическое значение для безопасности.
Это основная проблема, стоящая за инъекциями промтов (prompt injection). Вредоносная инструкция, замаскированная в документе, на веб-странице, в тикете или письме, может быть обработана моделью как часть того же контекста, который используется для выполнения легитимных инструкций. OWASP по-прежнему рассматривает инъекции промтов как ключевой риск безопасности больших языковых моделей (LLM), а рекомендации на 2026 год расширяют фокус внимания на всю агентную экосистему в целом: перехват целей, злоупотребление инструментами, компрометацию идентификационных данных и привилегий, отравление памяти и контекста, а также небезопасное взаимодействие между агентами.
Практический вопрос поэтому звучит не просто так: «Можно ли обмануть модель?». Модели неизбежно будут сталкиваться с состязательными и неоднозначными входными данными. Гораздо важнее спросить: «Что сможет сделать система, если модель удастся обмануть?»
Чат-бот, выдающий некорректный ответ, создает проблемы одного порядка. Агент с доступом к электронной почте, облачному хранилищу, исходному коду, внутренним API, учетным данным или производственным системам — совершенно другого. NIST уделяет все больше внимания именно этой проблеме, включая вопросы идентификации, аутентификации, авторизации агентов, их привязки к конкретному пользователю-владельцу и аудита их действий. В своем исследовании August 2026 guidance утверждает, что при развертывании агентов повторяется знакомый сценарий безопасности: практическая польза от продукта появляется раньше, чем база идентификации, необходимая для управления им.
Полезный способ оценки рисков заключается в совместном рассмотрении трех возможностей: способности обрабатывать ненадежный контент, доступа к конфиденциальным данным или системам, а также изменения состояния или внешних коммуникаций. Сами по себе эти возможности не являются изначально опасными. Однако их сочетание при отсутствии жестких границ создает прямую дорогу от вредоносного ввода к разрушительным действиям.
Платформа Moltbook наглядно продемонстрировала, почему инфраструктура вокруг модели важна ничуть не меньше, чем сама модель. В феврале 2026 года исследователи из Wiz выяснили, что вирусная социальная сеть для ИИ-агентов имела неверно настроенный бэкенд Supabase. Ошибки в настройке безопасности на уровне строк (Row Level Security) открыли неавторизованный доступ на чтение и запись к производственным данным, скомпрометировав около 1,5 миллиона токенов аутентификации агентов, 35 тысяч адресов электронной почты, личные сообщения и другие записи.
Результатом была не просто утечка данных. Эти учетные данные можно было использовать для выдачи себя за агентов, получения доступа к личной информации и изменения контента в реальном времени. Wiz сообщила о проблеме, и Moltbook устранила ее в течение нескольких часов. Публичный ключ Supabase, видимый во фронтенде, сам по себе не являлся уязвимостью; такие ключи предназначены для использования в клиентских приложениях. Реальной ошибкой было отсутствие политики авторизации базы данных, стоявшей за ним. Эта деталь делает инцидент еще более поучительным. Moltbook не была выведена из строя экзотическим новым эксплойтом для ИИ. Ее скомпрометировал обычный сбой контроля доступа в приложении, созданном с невероятной скоростью. Создатель платформы описывал ее разработку во многом как «вайб-кодинг» с помощью ИИ. ИИ ускорил путь от идеи до продакшена, но он не гарантировал безопасную архитектуру, контроль доступа или тестирование.
Это одно из главных противоречий в сфере безопасности ИИ: ИИ может сократить время, необходимое для создания ПО и автоматизации работы, одновременно сокращая время, доступное для выявления небезопасных решений до того, как они попадут в продакшен. Более быстрая разработка ценна, но более быстрая небезопасная разработка — это просто накопление долга по безопасности ускоренными темпами.
Как выглядит безопасное внедрение ИИ
Ответ заключается не в том, чтобы относиться к каждому инструменту ИИ как к одинаково опасному или отвечать тотальным запретом. Это обычно загоняет сотрудников в тень и существенно снижает оперативную эффективность. Работоспособная программа безопасности начинается с признания того, что сотрудники и бизнес-подразделения уже используют ИИ, а затем с создания достаточной видимости и контроля, чтобы отличать обычную производительную работу от по-настоящему рискованной деятельности.
Видимость стоит на первом месте. Службам безопасности необходима инвентаризация, которая включает санкционированные ИИ-сервисы, используемые личные аккаунты, расширения для браузеров, встроенные функции ИИ в SaaS-продуктах, внутренне разработанные модели, агенты, шлюзы моделей и интеграции, такие как MCP-серверы. Телеметрия сетей, DNS, прокси, конечных точек, систем управления доступом и DLP может выявить большую часть этой активности, но техническое обнаружение должно сопровождаться беседами с пользователями и бизнес-командами. Цель состоит не в слежке ради самой слежки; она заключается в том, чтобы понять, чего люди пытаются достичь, и предоставить более безопасные пути там, где потребность является законной.
Исходя из этого, меры контроля должны следовать за рисками, а не за названиями брендов. Чат-бот, отвечающий на вопросы по публичной документации, не требует такого же подхода, как агент, способный читать записи клиентов и выполнять транзакции. Классификация рисков должна учитывать конфиденциальность данных, надежность входных данных, инструменты и системы, к которым у ИИ есть доступ, возможность писать или общаться вовне, продолжительность хранения состояния и обратимость его действий.
Идентификация приобретает особое значение по мере того, как системы становятся агентными. Каждый агент должен работать с четкой идентификацией, узкоограниченными полномочиями, назначаемым владельцем — человеком или сервисом — и учетными данными, которые можно ротировать или отзывать. Широкий постоянный доступ трудно оправдать, когда агенту нужен лишь небольшой набор разрешений для конкретной задачи. Работа NIST в области идентификации подчеркивает необходимость применения аутентификации, авторизации, делегирования, принципа наименьших привилегий, аудируемости и неотказуемости к программным агентам, а не рассматривать их как невидимые расширения учетной записи пользователя.
Защита данных также должна быть приближена к самому взаимодействию с ИИ. Организациям необходимо знать не только то, какой ИИ-сервис посещает пользователь, но и какая информация поступает в него и исходит из него. Конфиденциальный исходный код, данные клиентов, учетные данные, регулируемая информация и интеллектуальная собственность должны контролироваться на уровне браузера, API, конечных точек и приложений, где это возможно. Данные Netskope показывают почему: число нарушений политик безопасности данных, связанных с ИИ, удвоилось, даже несмотря на то, что использование росло еще быстрее, а половина организаций в ее наборе данных по-прежнему не имела применимых политик защиты данных для генеративных приложений ИИ.
Для созданных внутри компании систем ИИ жизненный цикл безопасной разработки требует соответствующего обновления. Извлеченные документы, результаты работы инструментов, ответы моделей и внешний контент — все это следует рассматривать как потенциально ненадежное. Вывод модели не должен напрямую поступать в выполнение кода, SQL-запросы, команды оболочки, внешние коммуникации или критически важные для бизнеса действия без валидации и проверки политик. Тот же принцип применим к коду, созданному ИИ: скорость разработки не отменяет необходимость проверки архитектуры, управления секретами, контроля зависимостей, тестирования и принципа наименьших привилегий.
Реагирование на инциденты также должно измениться. Расследованию может потребоваться ответить на вопросы, на которые традиционные сценарии не отвечают: какой промпт или внешний контент повлиял на агента? Какие инструменты он вызывал? Какие учетные данные он использовал? Какие данные он извлек? Какое состояние он изменил? Какие другие агенты или системы получили его вывод? Организациям нужны логи, позволяющие ответить на эти вопросы, и им нужен быстрый способ отозвать учетные данные агента или отключить возможности, когда его поведение становится подозрительным.
Управление обеспечивает организационную структуру вокруг этих технических средств контроля. Основой по-прежнему остается Рамка управления рисками ИИ от NIST, в то время как ISO/IEC 42001 предоставляет подход на основе сертифицируемой системы менеджмента для управления ИИ в масштабах всей организации. Последние рекомендации OWASP по LLM и агентам, включая Стандарт контроля агентов, выпущенный в сентябре 2026 года, отражают то, как быстро смещается фокус с защиты отдельных промптов и моделей на управление идентичностью, инструментами, разрешениями, памятью и действиями систем ИИ.
Регулирование развивается в том же направлении, хотя сроки продолжают сдвигаться. В ЕС большинство правил Закона об искусственном интеллекте начали применяться в августе 2026 года, в то время как требования к системам высокого риска были впоследствии перенесены на 2 декабря 2027 года для автономных систем высокого риска и на 2 августа 2028 года для ИИ высокого риска, встроенного в регулируемые продукты. Colorado аналогичным образом перенесла дату вступления в силу своего закона об ИИ на 1 августа 2027 года. Урок для лидеров по безопасности заключается в том, чтобы не строить программу вокруг одного дедлайна. Потенциал управления должен существовать до того, как очередное нормативное требование, опросник от клиента или инцидент заставят его появиться.
Самое главное, что хорошее управление должно делать одобренный ИИ проще в использовании, а не сложнее. Если у сотрудников есть безопасные корпоративные аккаунты, четкие правила относительно того, какими данными можно делиться, полезные и санкционированные инструменты, а также быстрый путь для оценки новых вариантов использования, у них будет меньше причин обходить безопасность. Управление становится фактором развития, а не тормозом.
Это возвращает нас к парадоксу, который лежит в основе корпоративного ИИ.
ИИ расширяет поверхность атак и в то же время становится одним из наиболее ценных инструментов в арсенале защитников. выяснила, что злонамеренные кибератаки с использованием ИИ обходятся дороже среднемирового показателя, однако организации, активно применяющие ИИ и автоматизацию в обеспечении безопасности, сэкономили около 1,93 млн долларов на ликвидации последствий утечек по сравнению с теми, кто их не использует. в то же время зафиксировала, как группы безопасности стремительно внедряют ИИ в тестирование на проникновение (ред-теаминг), расследования, реагирование и безопасность приложений.
Отказ от ИИ поэтому не является реалистичной стратегией безопасности. Это также свело бы на нет многие защитные преимущества, которые организации уже получают. Более правильная цель — отделить полезную автономность от неконтролируемых полномочий.
Для этого руководителям служб безопасности необходимо рассматривать ИИ как часть корпоративной операционной модели, а не как еще одну категорию SaaS. Советам директоров и топ-менеджменту требуется прозрачность рисков и зон ответственности, связанных с ИИ. Директорам по информационной безопасности (CISO) необходимы возможности обнаружения, управления идентификационными данными, защиты данных и реагирования на инциденты, которые распространяются и на агентов. ИТ-командам нужно предоставлять утвержденные сервисы, достаточно качественные, чтобы конкурировать с инструментами, которые сотрудники в противном случае стали бы использовать самостоятельно. Юридическим отделам и отделам комплаенс необходимо переводить меняющиеся требования в практические правила, не превращая каждый эксперимент в многомесячный процесс согласования.
Организации, которые справятся с этим лучше всего, — это не те, что внедряют ИИ быстрее всех или наиболее жестко его ограничивают. Это те организации, которые делают ИИ простым в использовании там, где риск приемлем, сложным для нецелевого использования там, где последствия высоки, и видимым повсюду.
Внедрение ИИ уже произошло. Настоящий выбор заключается в том, будут ли организации управлять этим процессом осознанно или позволят перекроить границы своих данных, учетных записей и систем по одному промпту, интеграции и агенту за раз.