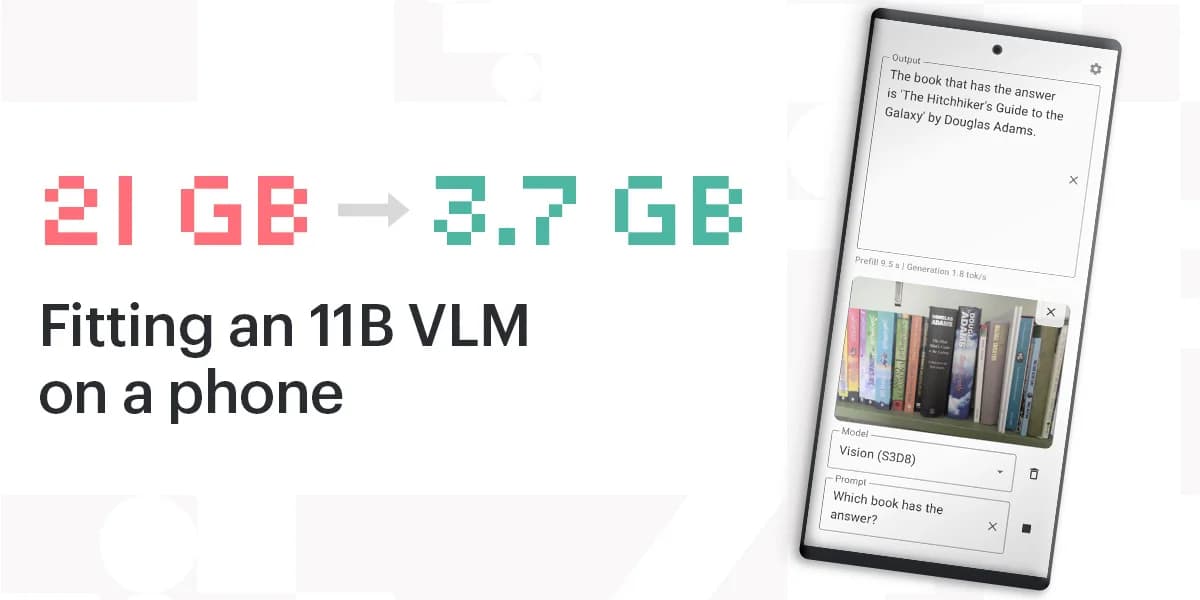
Иметь мультимодальную языковую модель (VLM) прямо в кармане — это здорово. Сочетание текстового и визуального интеллекта идеально подходит для персональных устройств, таких как смартфоны, ноутбуки и носимые гаджеты. Однако такие модели могут быть требовательны к памяти, и их развертывание на устройствах с низким энергопотреблением сопряжено с трудностями. В то время как спрос на крупные передовые модели, работающие в облаке, продолжает расти, ИИ для мобильных устройств и робототехники с ограниченным энергопотреблением также развивается очень быстро.
Команда исследователей из Graphcore и Arm недавно взялась за заведомо амбициозную задачу: уместить крупную 11-миллиардную VLM, для весов которой изначально требовалось более 21 ГБ, в бюджет хранения объемом около 4 ГБ, чтобы она поместилась на Android-смартфоне.
Результатом стала реализация Llama 3.2 Vision Instruct размером 3.7 ГБ. Мы достигли этого с помощью нового формата, спроектированного с учетом особенностей процессоров Arm, и процедуры обучения с учетом квантования (quantisation-aware training), которая выбирает разнообразные промпты для сохранения возможностей исходной модели.
Для достижения этой цели потребовалось решить три взаимосвязанные проблемы:
- Дизайн формата: как представить параметры модели, соблюдая баланс между размером, скоростью и точностью.
- Обучение: как эффективно квантовать модель в этот формат, сохранив максимум производительности в прикладных задачах.
- Выполнение: создание полноценной реализации вычислений на CPU, которая работает в рамках демонстрационного приложения для Android.
Формат: три веса в одном байте
Эффективный формат квантования весов должен сбалансировать три противоречивых требования. Он должен быть:
- Компактным, в нашем случае — менее 3 бит на вес.
- Быстрым в дешифрации: в идеале распаковываться так же быстро, как читаются сжатые входные данные.
- Высокоточным, способным представлять веса достаточно точно для сохранения высокой производительности в задачах.
Вдохновившись системой команд нашей целевой платформы, мы разработали формат под названием S3D8 — высококомпактный формат (2.7 бита на вес), который балансирует скорость и точность в данном диапазоне. Основная идея заключается в том, чтобы сохранить абсолютное значение 3 весов в виде 5-битного индекса, а затем сохранить 3 отдельных бита выбора знака для восстановления декодированных весов.
Центроиды S3D8 (слева) с инверсией знака (оттенок) против 1D-центроидов (права), показанных как произведение по 3 измерениям, где оба варианта обучены на выборках из t-распределения Стьюдента.
Использование 3D-векторного квантования дает существенные преимущества в точности по сравнению с 1D-форматами (см. paper), а применение небольшой таблицы поиска позволяет осуществлять быстрое сопоставление в регистрах при декодировании. Например, наши бенчмарки показывают, что произведение матрица-вектор между 4096-элементным вектором активаций INT8 и матрицей 4096 x 14336 достигает 26.5 GMAC/с для матрицы INT8, но 33.8 GMAC/с для S3D8 при работе на смартфоне Android. Такой прирост скорости возможен, поскольку дополнительные затраты на декомпрессию в S3D8 перевешиваются экономией пропускной способности при загрузке весов из памяти.
Обучение: восстановление производительности в сжатой модели
Простое квантование методом «прямого приведения» (direct cast) каждого тензора весов к ближайшему значению S3D8 полностью ломает модель, приводя к нулевой точности в 4 прикладных задачах. Это происходит потому, что квантование до 2.7 бит на параметр является слишком агрессивным, и модель не может справиться с ним без возможности скорректировать веса и восстановить производительность.
Поэтому мы использовали обучение с учетом квантования (QAT) для восстановления производительности в квантованной модели. QAT квантует модель при прямом проходе и пропускает градиенты через операцию квантования при обратном проходе для корректировки весов, обучая их воспроизводить выходы исходной неквантованной модели. Хотя этот метод высокоэффективен, мы обнаружили, что он очень чувствителен к распределению входных данных, используемых во время обучения.
Мы разработали процедуру выборки, которая сначала формирует пользовательские промпты как комбинацию трех компонентов: шаблона, необязательной инструкции и вопроса. Затем она выбирает вариант завершения (completion) от неквантованной модели-учителя. Это существенно улучшает производительность в прикладных задачах по сравнению с более простой процедурой (см. ).
Подводя итог, наш метод значительно превзошел альтернативные форматы и процедуры квантования:
Соотношение между общей производительностью в задачах и сжатием модели при прямом приведении, GPTQ и QAT. В рамках нашей схемы QAT формат S3D8 превосходит стандартный INT с блочным масштабированием, обеспечивая примерно на 22% большее сжатие при той же производительности в задаче. Прямое приведение весов модели к значению менее 3.5 бит на параметр приводит к существенной деградации модели. Хотя методы GPTQ и QAT могут улучшить производительность, QAT превосходит их при меньшем количестве бит на параметр. Штриховая линия показывает производительность исходной модели bfloat16 (21.3 ГБ).
Выполнение: работа на смартфоне
Поскольку мы хотели получить демонстрационный прототип, работающий на процессоре смартфона, наша задача была еще не закончена. Мы также спроектировали и создали:
- Ядра для S3D8: объединенные операции деквантования, матричного умножения и приведения типов.
- Дополнительные ядра и реализацию модели: кастомный движок на C++ для выполнения Llama VLM, упакованный в нативную библиотеку.
- Формат файла на основе safetensors для сериализации квантованной модели.
- Приложение для Android, которое загружает модели, принимает промпты и выполняет нативную библиотеку.
Мы публикуем наш implementation для поддержки дальнейших разработок с использованием этих идей.
Что дальше?
Мы были рады, а也许 и немного удивлены, увидев полноценно работающий на смартфоне метод. Он еще не совсем готов к массовому использованию на мобильных телефонах — 11-миллиардная модель пока немного тяжеловата, и нашей реализации не помешали бы ядра Vulkan для сокращения времени префилла (prefill). Но мы надеемся, что этот формат и рецепт обучения окажутся полезными инструментами для сжатия VLM/LLM, привносящими больше интеллекта в наши устройства.
Если вы хотите узнать больше, загляните в наш технический блог, где также можно получить устанавливаемую демо-версию. Либо сразу переходите к для получения полного объяснения работы и результатов.