По мере того как ИИ-фабрики вырастают из мегаваттных в гигаваттные, их создание требует большего, чем просто перердовых вычислений. Открытые стандарты помогают индустрии масштабировать ИИ-инфраструктуру быстрее, эффективнее и надежнее.
На саммите Open Compute Project (OCP) Global Summit, проходящем в конференц-центре San Jose McEnery Convention Center, NVIDIA объявила о новых партнерствах и разработках, направленных на создание общей основы для инфраструктуры искусственного интеллекта нового поколения.
NVIDIA передала ключевые конструкции стоек и вычислительных треев NVIDIA Vera Rubin в консорциум OCP в рамках открытой архитектуры NVIDIA MGX, предоставив системным интеграторам общую основу для разработки инфраструктуры ИИ-фабрик нового поколения.
В совокупности эти усилия охватывают саму ИИ-фабрику, питающую ее электросеть и стоечную архитектуру, которая лежит в основе современных ускоренных вычислений.
NVIDIA и партнеры объявляют о достижениях в области открытой архитектуры
На мероприятии OCP компания NVIDIA и ее партнеры сделали ряд анонсов:
- NVIDIA и гиперскейлеры опубликовали открытые стандарты для ИИ-фабрик нового поколения, включая стандарты проектирования ИИ-фабрик и устойчивости электросетей.
- NVIDIA представила новые компоненты программного обеспечения с открытым исходным кодом для NVIDIA DSX AI Factory.
- Meta и NVIDIA развивают открытые сетевые технологии для ИИ благодаря инновациям в виде SuperNIC NVIDIA Spectrum-X Ethernet и Spectrum-6.
- Visionbay представила дизайн ИИ-фабрики на 800В постоянного тока для эпохи Vera Rubin.
- NVIDIA и Cisco анонсировали стандарт Ultra-Dense Small Form Factor Pluggable (USFP) — первый в отрасли модуль для сетевых фабрик на базе 400 Гбит/с.
- NVIDIA и Google объявили о поддержке Falcon Transport в будущих SuperNIC NVIDIA ConnectX-10 и DPU BlueField.
Выступая перед переполненным залом, Ян Бак, вице-президент по гипермасштабируемым и высокопроизводительным вычислениям в NVIDIA, рассказал о том, как открытая инфраструктура становится критически важным компонентом для масштабирования ИИ-фабрик по всему миру.
Новости на OCP подчеркивают, как экстремальное сопроектирование NVIDIA в сочетании с открытыми стандартами ускоряет развертывание, повышает энергоэффективность и увеличивает производительность в пересчете на токены на ватт.
ИИ-фабрики Vera Rubin развиваются благодаря стоечным решениям MGX на OCP 2024 🔗
NVIDIA присоединилась к лидерам индустрии в создании третьего поколения эталонного дизайна ЦОД MGX в рамках инициативы OCP Open DC Initiative.
В сочетании с такими технологиями открытого жидкостного охлаждения, как MQD и MQDB, эта инициатива помогает превратить проверенные проекты ИИ-фабрик в отраслевые стандарты, которые другие могут принимать, производить и масштабировать.
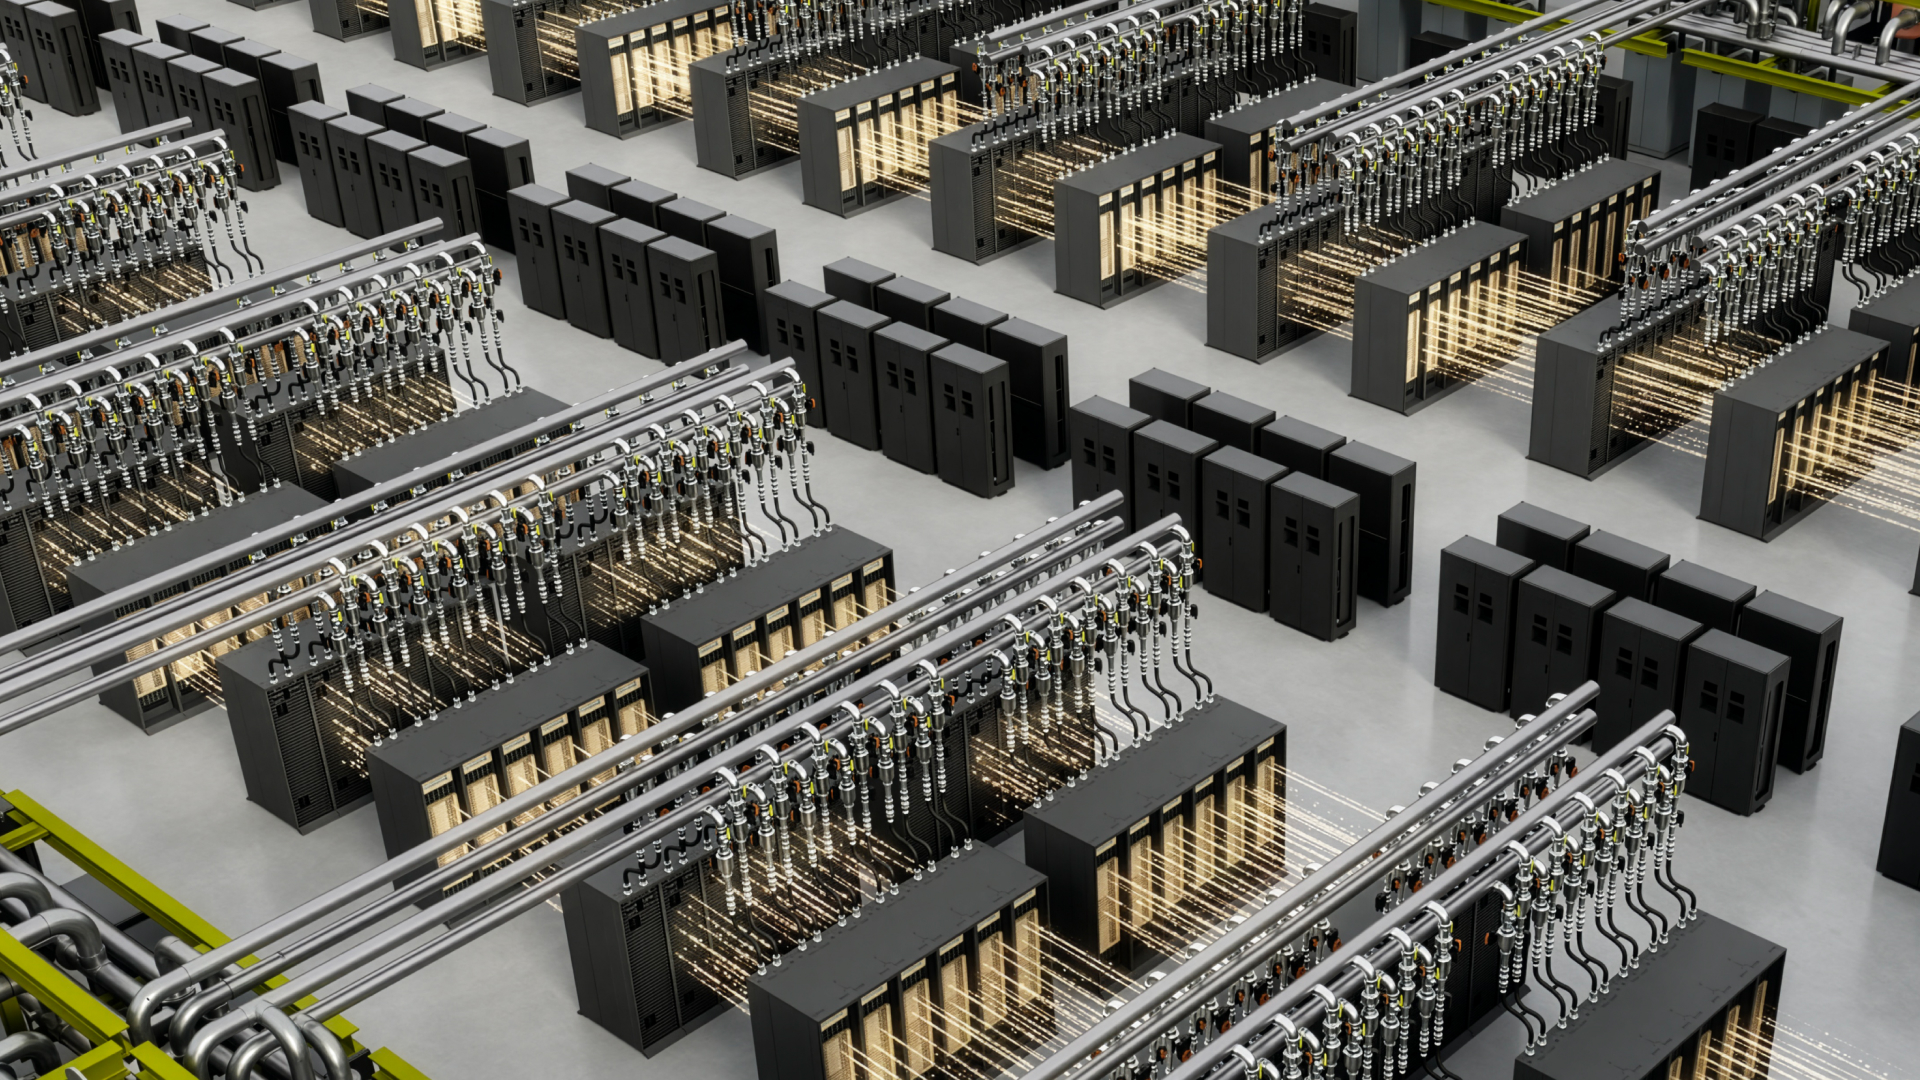
Для ИИ-фабрик NVIDIA Vera Rubin обновленная спецификация MGX 1.2 расширяет открытую архитектуру ИИ-фабрик за счет стоечного жидкостного охлаждения с безразъемным соединением (blind-mate), совместимой стоечной коммутационной инфраструктуры и шинопровода на 5000 А с жидкостным охлаждением, разработанного для высокомощных ИИ-систем. Она также добавляет встроенную поддержку 19-дюймового оборудования и более плотные конструкции стоек.
MGX 1.2 дополнительно расширяет модульность за счет настраиваемых отсеков ввода-вывода, безвентиляторных вычислительных треев с жидкостным охлаждением, стандартизированных интерфейсов питания и охлаждения, а также общей инфраструктуры, которая помогает партнерам по экосистеме создавать совместимые платформы ускоренных вычислений. Это сокращает время сборки, тестирования и обслуживания для оптимизации производства и сервисного обслуживания на местах, обеспечивая более быстрое и эффективное развертывание инфраструктуры. Архитектура поддерживает развертывание стоек мощностью до 250 кВт, одновременно упрощая ремонтопригодность, развертывание и повторное использование инфраструктуры.
Спецификация стоечной конструкции Vera CPU расширяет открытую архитектуру NVIDIA MGX за пределы ускоренных вычислений, предоставляя специализированную платформу для наступающей эры агентного ИИ. В то время как Vera Rubin NVL72 служит основой для крупномасштабного обучения и инференса, стойка NVIDIA Vera CPU разработана для поддержки вызова функций (tool calling), оркестрации и выполнения в изолированной среде (sandbox), помогая агентам ИИ взаимодействовать с приложениями, данными и сервисами в реальном времени.
Созданная на базе стоечной архитектуры NVIDIA MGX третьего поколения, стойка Vera CPU разделяет те же принципы стоечного дизайна, которые объединяют вычисления, сети, питание и охлаждение в общую модульную платформу. Такой подход позволяет партнерам развертывать специализированную инфраструктуру, получая при этом выгоду от общей экосистемы, упрощенной интеграции и единой основы для ИИ-фабрик нового поколения.
NVIDIA выпускает новые программные компоненты с открытым исходным кодом для DSX AI Factory 🔗
Платформа NVIDIA DSX AI factory platform использует подход экстремального сопроектирования для объединения вычислений, сетей, питания, охлаждения, инфраструктуры и программного обеспечения, помогая ИИ-фабрикам работать как единая оптимизированная система и максимизировать производительность ИИ в рамках имеющихся инфраструктурных ограничений. В центре этой единой системы находится DSX OS — открытый уровень операционной системы, который превращает архитектуру DSX в скоординированные и повторяемые операции в масштабном исполнении.
На саммите OCP компания NVIDIA расширила DSX OS компонентами с открытым исходным кодом для настройки сетей, проверки кластеров, управления стойками и подготовки «голого железа» (bare metal):
- NVIDIA Config Manager: Автоматизирует конфигурацию коммутаторов в больших масштабах, позволяя клиентам развертывать, проверять и поддерживать согласованные сетевые фабрики ИИ-фабрик с минимальным ручным вмешательством или вообще без него.
- NVIDIA Cluster Readiness Engine: Помогает предотвратить дорогостоящие сбои заданий путем стресс-тестирования кластеров графических процессоров с помощью симуляций реальных рабочих нагрузок для гарантии исправности оборудования до начала обучения.
- NVIDIA Rack Management Service: Предлагает решение для абстракции и управления аппаратным обеспечением стоек, которое рассматривает стойки как первоклассные единицы для улучшенного управления прошивками в масштабах ИИ-фабрики.
- Cluster API Provider for NVIDIA Infrastructure Controller: Ускоряет развертывание на «голом железе» и подключение клиентов (tenant onboarding), превращая «сырое» оборудование для ИИ в готовые к работе кластеры за часы, а не дни.
Разработанные на основе опыта NVIDIA по управлению NVIDIA DGX Cloud, эти компоненты с открытым исходным кодом позволяют облачным провайдерам и программным партнерам интегрировать возможности ИИ-фабрик непосредственно в свои мультиарендные платформы.
Разработчики могут посетить страницу DSX AI Factory на GitHub, чтобы изучить новые и существующие программные компоненты с открытым исходным кодом от платформы NVIDIA DSX AI Factory и внести свой вклад в их разработку.
NVIDIA и гиперскейлеры публикуют открытые стандарты для ИИ-фабрик нового поколения 🔗
Чтобы ИИ-инфраструктура масштабировалась по всему миру, ей требуется нечто большее, чем передовое железо — ей нужна общая основа, на которой сможет строить вся индустрия.
На саммите OCP компании NVIDIA, AMD, Google и Meta объединили усилия для публикации новой открытой спецификации, которая закладывает эту основу. Open Data Center Specification v0.7 определяет единый проект для проектирования инфраструктуры ИИ-фабрик нового поколения — от архитектуры питания до инфраструктуры охлаждения и физической компоновки.
Спецификация устойчивости электросетей OCP (OCP Grid Resilience Specification), опубликованная компаниями Google, Meta, Microsoft и NVIDIA, определяет, как крупномасштабная ИИ-инфраструктура должна вести себя при сбоях в электросетях: оставаться подключенной, реагировать автоматически и восстанавливаться практически до полной нагрузки менее чем за две секунды.
Когда эти стандарты стали общедоступными, производители по всему миру получили единый ориентир для разработки. Производители оборудования, поставщики услуг колокации и операторы дата-центров могут приступить к проектированию, изготовлению и поставке инфраструктурного уровня, обеспечивающего работу строящихся по всему миру фабрик искусственного интеллекта, не дожидаясь проприетарных спецификаций от отдельных заказчиков.
Обладая совместимостью с эталонным дизайном NVIDIA DSX, эти спецификации обеспечивают проверенную и готовую к развертыванию реализацию обоих стандартов — от планировки помещений и архитектуры питания до программного обеспечения, которое отслеживает сигналы электросети и реагирует на них в режиме реального времени. Для операторов, строящих фабрики искусственного интеллекта на базе Vera Rubin, теперь пролегает прямой путь от открытого стандарта сообщества до работающей системы.
Visionbay.ai разрабатывает фабрику ИИ с напряжением 800 В постоянного тока для эры Vera Rubin 🔗
По мере того как фабрики искусственного интеллекта становятся все больше и мощнее, перед ними встает главная проблема: обеспечение достаточной мощности для систем ускоренных вычислений, которые стимулируют развитие ИИ нового поколения.
На саммите OCP компания Visionbay представила планы относительно K-1 — платформы фабрики ИИ нового поколения, разработанной на базе архитектуры 800 ВDC (постоянного тока) и созданной с учетом будущих развертываний систем NVIDIA Vera Rubin. Проект объединяет эталонную архитектуру NVIDIA 800 VDC с технологиями питания и терморегулирования от Vertiv для создания масштабируемой основы высокоплотной инфраструктуры ИИ.
Этот проект решает нарастающую проблему отрасли. По мере расширения рабочих нагрузок обучения, инференса и рассуждений в сфере ИИ плотность энергопотребления стоек продолжает расти. Традиционное распределение питания низкого напряжения становится все сложнее масштабировать: оно требует больше меди, кабелей и оборудования для преобразования энергии.
Приняв архитектуру NVIDIA 800 VDC, проект K-1 создает путь к созданию инфраструктуры ИИ более высокой плотности, сохраняя при этом гибкость для существующих развертываний. Вместо того чтобы требовать полного перехода в первый же день, платформа спроектирована так, чтобы поэтапно внедрять распределение 800 VDC там, где оно приносит наибольшую пользу, помогая операторам готовиться к будущим поколениям ускоренных вычислений без масштабной перестройки помещений.
Архитектура построена вокруг центров питания кластерного уровня, которые централизуют преобразование переменного тока в постоянный (AC-to-DC) и распределяют 800 VDC ближе к вычислительным ресурсам. Такой подход упрощает распределение питания на нижнем уровне, поддерживает модульное расширение и создает повторяемые строительные блоки для будущего роста фабрик искусственного интеллекта.
K-1 также отражает философию проектирования на системном уровне, лежащую в основе фабрик ИИ NVIDIA, где питание, охлаждение и вычисления проектируются совместно. Поддерживая инфраструктуру с жидкостным охлаждением, масштабируемое распределение питания и будущие развертывания класса Vera Rubin, этот проект демонстрирует, как партнеры экосистемы преобразуют архитектуру фабрик ИИ от NVIDIA в развертываемую инфраструктуру, созданную для следующей эры ускоренных вычислений.
На мероприятии компании Meta и NVIDIA объявили о том, что Meta переходит на использование коммутаторов NVIDIA Spectrum-6 Ethernet 102,4 Тбит/с для создания более крупных и производительных фабрик ИИ NVIDIA Vera Rubin на базе открытых сетевых технологий.
Spectrum-6 обеспечивает вдвое большую коммутационную емкость и пропускную способность на линию по сравнению со Spectrum-4, а также предоставляет сеть Ethernet ИИ без потерь данных со скоростью 200 Гбит/с на линию, с высокой эффективной пропускной способностью и изоляцией производительности, которая предотвращает замедление трафика одной задачи из-за другой.
Созданный на базе Spectrum-6 коммутатор Meta под названием N-IceCube устанавливается в IcePack — 100-терабитную стойку Meta с жидкостным охлаждением. N-IceCube работает под управлением операционной системы Facebook Open Switching System (FBOSS), представляющей собой сетевую ОС Meta с открытым исходным кодом, переданную в OCP для поддержки эффективных сетей гиперскейлеров.
FBOSS построена на базе интерфейса абстракции коммутатора (Switch Abstraction Interface, SAI) — стандарта OCP, в разработке которого участвовала компания NVIDIA. Это обеспечивает независимый от поставщика способ управления аппаратной частью коммутаторов. В совокупности эти технологии поддерживают агентные фабрики ИИ, насчитывающие более 100 000 графических процессоров, которые обучают и обслуживают масштабные модели.
Это объявление знаменует собой следующий шаг в сотрудничестве, объединяющем опыт Meta в эксплуатации инфраструктуры искусственного интеллекта в масштабе гиперскейла и сетевые технологии NVIDIA.
В основе этого сотрудничества лежит технология Spectrum-X Multiplane, реализованная на базе коммутаторов Spectrum-6 и суперсетевых адаптеров ConnectX-9 SuperNIC. Multiplane распределяет трафик графических процессоров на аппаратном уровне между восемью независимыми сетевыми плоскостями, позволяя фабрикам ИИ масштабироваться до более чем 100 000 графических процессоров с меньшим количеством уровней коммутаторов и более низкими затратами на инфраструктуру. Множество путей между графическими процессорами повышают использование сети и ее отказоустойчивость: при выходе из строя какого-либо компонента трафик перенаправляется на оставшиеся плоскости, обеспечивая продуктивную работу графических процессоров и бесперебойную работу приложений ИИ даже при сниженной пропускной способности.
Meta и NVIDIA совместно работали над повышением этой отказоустойчивости на основе опыта развертывания и быстрого инженерного итерационного процесса. Команды проверили улучшения как в локальных (on-premises), так и в облачных средах.
«Мы рады нашему тесному партнерству с NVIDIA в деле обеспечения операционной масштабируемости и производительности многоплоскостных сетей (multiplane fabrics), что является критически важным требованием как для создания собственной инфраструктуры, так и для наших совместных облачных партнеров, — заявил Омар Балдонадо (Omar Baldonado), старший директор по дата-центрам и сетевым технологиям ИИ в компании Meta. — Перенос FBOSS на ASIC-чипы Spectrum означает, что мы можем использовать один и тот же программный стек в наших сетях, а новый коммутатор Meta на базе Spectrum, N-IceCube, интегрируется в Icepack — нашу стоечную систему с жидкостным охлаждением на 102,4 Тбит/с для горизонтального масштабирования, которая соединяет будущие поколения ускорителей в нашем парке оборудования».
Совместно Meta и NVIDIA разрабатывают архитектуру и операционное руководство, которые могут применять другие операторы инфраструктуры искусственного интеллекта, превращая уроки сложных производственных нагрузок в более масштабируемые, отказоустойчивые и эффективные фабрики ИИ.
С помощью USFP компании NVIDIA и Cisco заново изобретают разъемную оптику для масштабов фабрик ИИ 🔗
По мере того как фабрики искусственного интеллекта масштабируются для поддержки более крупных моделей и растущего спроса на инференс, каждый компонент инфраструктурного стека должен обеспечивать более высокую производительность, эффективность и простоту — вплоть до самого сетевого соединения.
На саммите OCP компании NVIDIA и Cisco объявили о планах по созданию USFP — нового форм-фактора оптического подключаемого приемопередатчика (трансивера), разработанного для того, чтобы помочь создателям фабрик ИИ масштабировать сетевые инфраструктуры ИИ нового поколения при одновременном повышении плотности пропускной способности и энергоэффективности.
Обладая примерно такими же габаритами, как и получивший широкое распространение форм-фактор OSFP со скоростью 200 Гбит/с на линию, USFP обеспечит путь к сетям со скоростью 400 Гбит/с на линию и продолжит модель развертывания на основе трансиверов, уже зарекомендовавшую себя в поколениях сетей дата-центров. Объединяя 16 полнодуплексных линий с планами масштабирования до 32 линий, USFP обеспечит в четыре раза большую плотность пропускной способности по сравнению с традиционной разъемной оптикой со скоростью 200 Гбит/с на линию.
Результатом становится возможность подключения большего числа вычислительных ресурсов без добавления уровней сети, которые могут увеличить задержки, энергопотребление и сложность.
Новый форм-фактор разработан с учетом требований к масштабируемости и эффективности фабрик искусственного интеллекта нового поколения. Он поддерживает высокоскоростные сети передачи данных, сохраняя при этом гибкость и ремонтопригодность, которые сделали вставляемую оптику основой современных дата-центров. Кроме того, он обеспечит примерно в 1,3 раза большую энергоэффективность, помогая операторам передавать больше данных с меньшими затратами энергии.
Чтобы способствовать развитию открытой экосистемы, NVIDIA и Cisco сотрудничают с компаниями TE Connectivity и Amphenol в области корпусов, разъемов и модулей, планируя развивать USFP посредством совместных усилий сообщества на основе множественных источников. Вместе эти компании закладывают основу для более масштабируемых, эффективных и совместимых сетевых решений для фабрик ИИ.
Google Falcon Transport поддерживает NVIDIA ConnectX-10 для создания совместимых сетей ИИ 🔗
NVIDIA и Google также объявили о поддержке Falcon Transport в будущих SuperNIC-модулях NVIDIA ConnectX-10 и DPU-процессорах BlueField, что поможет повысить эффективность сети для крупномасштабной инфраструктуры ИИ.
Falcon — это транспортный протокол, разработанный для надежной передачи данных по сетям Ethernet, которые в противном случае могут терять пакеты при перегрузках. Он поддерживает рабочие нагрузки ИИ и систем хранения данных благодаря многопутевой балансировке нагрузки, программируемому контролю перегрузок, аппаратному восстановлению потерь и безопасности для каждого соединения.
Это сотрудничество объединяет аппаратное ускорение NVIDIA с программным обеспечением DOCA для реализации Falcon и распространения сетевых технологий NVIDIA на транспортный уровень дата-центров Google. Сетевые адаптеры (NIC) NVIDIA и Google могут обмениваться данными по общему транспортному протоколу, в то время как приложения сохраняют стандартные программные интерфейсы RDMA.
Распределяя трафик по маршрутам, адаптируясь к перегрузкам, восстанавливая потерянные пакеты и защищая соединения, Falcon помогает рабочим нагрузкам эффективнее использовать доступную пропускную способность и поддерживать предсказуемую производительность по мере масштабирования сетей Ethernet.
Узнайте больше, присоединившись к NVIDIA на OCP.