ClickHouse Cloud работает на многих тысячах узлов Kubernetes в AWS, GCP и Azure. В таких масштабах узел с поврежденным диском, зависшей задачей ядра или полуработающей сетью — это повседневное явление. Большинство таких сбоев поначалу не выглядят как отказ узла. Kubernetes все еще сообщает, что узел готов (Ready). В консоли облачного провайдера экземпляр отображается как запущенный. Вместо этого вы видите реплику ClickHouse, которая не может выполнить запись на свой кэш-диск, под, зависший в состоянии ContainerCreating, или запрос, у которого истекает тайм-аут на одной реплике, в то время как на других он работает.
Хотя облачные провайдеры (CSP) иногда пытаются обнаруживать и устранять эти проблемы, им это удается не в 100% случаев. Кроме того, поведение «устранения» различается у разных облачных провайдеров и не всегда является оптимальным решением для конкретной проблемы. Мы хотели иметь больше контроля и согласованности между различными CSP. Поэтому мы запустили проект, который назвали «Надежность вычислительного уровня» (Compute Layer Reliability).
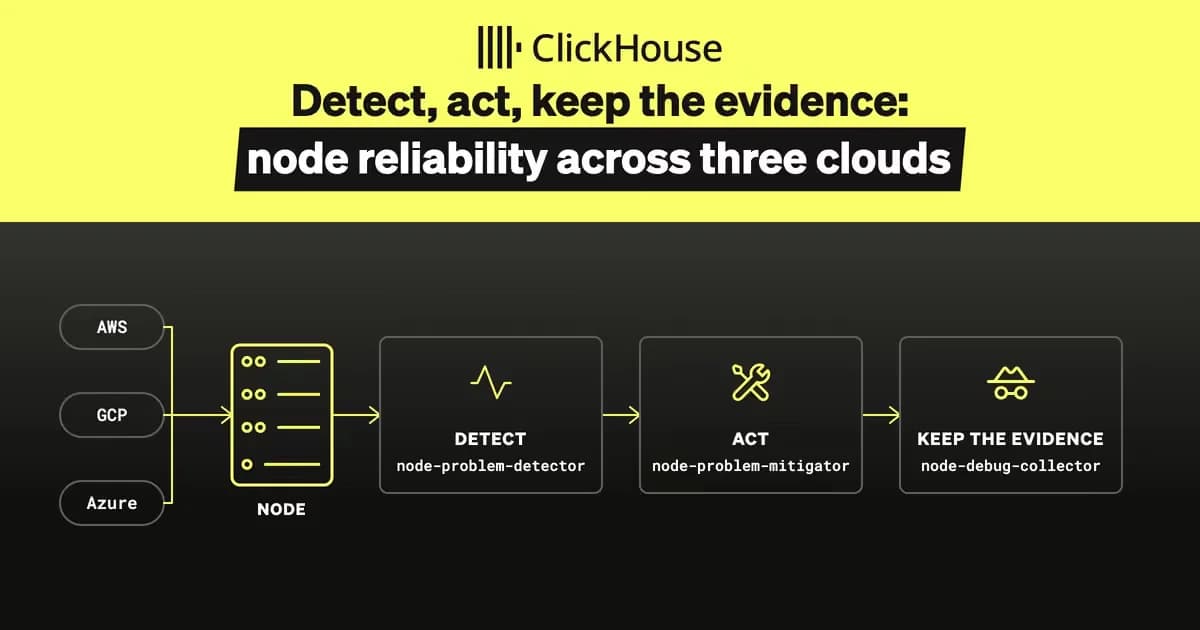
В этой статье рассказывается о том, что мы обнаружили, проанализировав обработку состояния здоровья узлов в каждом облаке, почему мы решили взять на себя как обнаружение, так и реакцию, а также о трех компонентах, которые мы создали или внедрили для реализации этого:
- Node Problem Detector (NPD), датчик. Облачно-нативный компонент, адаптированный под наши нужды. Он работает на каждом узле и преобразует строки журналов ядра и системы, а также несколько активных проверок в состояния (Conditions) и события (Events) узла Kubernetes.
Node Problem Detector (NPD), датчик. Облачно-нативный компонент, адаптированный под наши нужды. Он работает на каждом узле и преобразует строки журналов ядра и системы, а также несколько активных проверок в состояния (Conditions) и события (Events) узла Kubernetes.
- Node Problem Mitigator (NPM), актуатор. Это контроллер, который отслеживает эти состояния и контролируемым образом выводит узел из эксплуатации: устанавливает taint, выполняет drain, а затем завершает работу экземпляра.
Node Problem Mitigator (NPM), актуатор. Это контроллер, который отслеживает эти состояния и контролируемым образом выводит узел из эксплуатации: устанавливает taint, выполняет drain, а затем завершает работу экземпляра.
- Node Debug Collector (NDC), инструмент криминалистического анализа. Он собирает логи и состояние системы с узла до того, как узел исчезнет, даже если узел уже недоступен.
Node Debug Collector (NDC), инструмент криминалистического анализа. Он собирает логи и состояние системы с узла до того, как узел исчезнет, даже если узел уже недоступен.
Мы обнаружили узел EC2, на котором вышел из строя один из двух дисков NVMe, входящих в состав программного массива RAID. Ядро записало в лог сообщение о том, что в массиве raid0 отсутствует или поврежден элемент, за которым последовал поток ошибок EXT4 и ошибок ввода-вывода (I/O) на файловой системе кэша. Поды ClickHouse на этом узле в течение длительного времени сталкивались с ошибками записи. Никакие данные не были потеряны, но система работала в деградировавшем состоянии, и дежурный оператор потратил много времени на выяснение первопричины.
Никому не поступало оповещений о том, что сам узел нездоров. Объект Node в Kubernetes оставался в статусе Ready. Облачный провайдер не пометил экземпляр как проблемный. Единственным местом, где был виден сбой, был циклический буфер ядра (ring buffer) самой ВМ.
В этом кластере действительно работал Node Problem Detector. NPD — это стандартный инструмент Kubernetes для этой задачи: DaemonSet, который отслеживает логи ядра и системы, сопоставляет их с правилами и сообщает о проблемах в объекте Node. Когда мы проверили его логи, оказалось, что он зафиксировал ошибки EXT4. Но стандартное правило для ошибок EXT4 помечено как «временное» (temporary). Временное правило генерирует событие Kubernetes (Event), которое истекает через час. Оно не устанавливает состояние узла (Node condition), и ничто в нашем стеке на него не отреагировало.
Бывали и другие случаи, когда простая выгрузка (drain) узлов решала различные проблемы. Каждый раз человек находил проблему, читая логи, и каждый раз исправление было одинаковым.
В Kubernetes встроены стандартные состояния узлов (Node conditions): Ready, MemoryPressure, DiskPressure, PIDPressure и NetworkUnavailable. Их устанавливает kubelet, и встроенные контроллеры Kubernetes реагируют на них. Когда статус Ready становится равным false, узел получает taint, и с него выселяются поды.
Эти состояния отражают собственное представление kubelet об узле. Они не охватывают деградировавший RAID-массив, файловую систему, перешедшую в режим только для чтения (read-only), среду выполнения контейнеров, застрявшую на зависшей задаче ядра, и многие другие режимы отказов, при которых kubelet продолжает сообщать о готовности (Ready), в то время как ВМ находится в деградировавшем состоянии.
Kubernetes v1.37 поддерживает условия жизненного цикла (Lifecycle Conditions), что частично улучшает мониторинг состояний узлов и контроль процесса вывода из эксплуатации (drain). Этого не было, когда мы начинали проект, и эта функция все еще недостаточно зрела для использования в производственных средах.
Мы управляли парком серверов в трех облаках, и в каждом из них был свой подход. Мы провели масштабное исследование каждого облака и извлекли актуальную рабочую конфигурацию из встроенных агентов ВМ, поставляемых некоторыми облачными провайдерами. Вот что мы выяснили.
В AWS мы специально отключили автовосстановление узлов (auto-repair), потому что видели случаи, когда эвристика фрагментации дисков постоянно помечала узлы как нездоровые. Поведение автовосстановления также влияет на то, как тома монтируются и размонтируются на узле. Простое выселение подов с нездоровых узлов происходит быстрее, чем ожидание завершения автовосстановления. В большинстве случаев автовосстановление представляет собой перезагрузку узла на месте, что означает кратковременное отключение работающих контейнеров. Перезагруженные узлы часто сталкивались с той же проблемой снова.
В GCP провайдер развертывает собственный NPD на каждом узле с длинным списком проверок, включая несколько пользовательских плагинов. Auto-repair был отключен по схожим причинам. Встроенные проверки NPD не охватывали важные для нас сигналы.
В Azure провайдер также запускает NPD в качестве процесса хоста, опять же с множеством проверок. В Azure нет встроенного механизма реагирования на условия, публикуемые NPD. Невозможно управлять механизмом автовосстановления для этих ВМ. В случае проблем, обнаруженных Azure, ВМ может быть перезагружена, пересоздан ее образ или выполнено повторное развертывание. Это означает, что после завершения процесса старые проблемы могут вернуться, и это по-прежнему не охватывает важные для нас сигналы.
Мы решили пойти собственным путем: реализовать единые обнаружение, реакцию и сбор отладочной информации во всех 3 облачных провайдерах.
- Собственное обнаружение. Мы запускаем собственную конфигурацию node-problem-detector NPD во всех трех облаках. Мы пишем проверки самостоятельно, основываясь на тех сбоях, с которыми реально столкнулись. Проблемы, которые наносят нам ущерб, становятся постоянными состояниями, а не событиями, срок действия которых истекает через час.
- Собственная реакция. Мы не пытаемся восстановить узел на месте. Узел, сообщающий о проблеме с оборудованием или ядром, выводится из эксплуатации, а рабочие нагрузки перепланируются на здоровые узлы. Мы написали контроллер node-problem-mitigator (NPM), который отслеживает состояния, публикуемые NPD, и применяет одну настроенную реакцию на каждое состояние — от режима «только наблюдение» до завершения работы экземпляра.
- Сохраняйте улики. До начала проекта сбор диагностических данных с неисправного узла представлял собой ручную гонку наперегонки с процессом вывода из эксплуатации, причем зачастую узел уже не отвечал на запросы. Операторам приходилось помнить разные последовательности шагов для разных облачных провайдеров (CSP) и выполнять одинаковые последовательности команд для выгрузки собранных данных в общее хранилище для анализа. Мы создали node-debug-collector для решения этих проблем.
Kubernetes не видит происходящее внутри узла
Как мы видели выше, некоторые сбои узлов никогда не доходят до Kubernetes. Мягкая блокировка ядра (kernel soft lockup) или сбой монтирования диска кэша NVMe оставляют узел в состоянии Ready, в то время как рабочая нагрузка страдает. Нам нужен был датчик внутри узла, который преобразует эти сбои в сигналы, понятные Kubernetes. Вместо написания собственного агента мы выбрали стандартный Node Problem Detector (NPD). Это небольшой DaemonSet, который активно поддерживается и генерирует стандартные условия и события узла (Node Conditions and Events). Мы развертываем стандартный образ без изменений. Все, что мы добавляем, — это конфигурация, поэтому все наши кластеры в трех облаках запускают один и тот же детектор с единым каталогом проверок, а добавление или настройка проверки сводится к изменению конфигурации и выкатке.
Мониторинг изнутри
NPD поставляет несколько типов мониторов. Мы используем два из них.
Мониторы логов: NPD отслеживает кольцевой буфер ядра или юнит journald и сопоставляет каждую строку с регулярными выражениями. Они недороги и охватывают все, что оставляет след в логах. Вот правило, которое фиксирует ошибки в файловой системе ext4:
Главный недостаток мониторов логов заключается в их «липкости»: после сопоставления с шаблоном лога результирующее условие узла остается активным бесконечно. Мониторы на основе пользовательских плагинов выполняют проверки повторно и обновляют состояние на основе последнего результата.
Мониторы на основе пользовательских плагинов: запускают скрипт по расписанию и считывают его код завершения и стандартный вывод (stdout). Мы используем их, когда в логах ничего нет или когда одной строки лога недостаточно. Примером может служить проверка тайм-аута NVMe, которая срабатывает только тогда, когда по меньшей мере два устройства выходят по тайм-ауту в течение одной минуты, поскольку тайм-аут одного устройства обычно является самовосстанавливающейся помехой, а двух — почти всегда означает сбой на стороне хоста. Другой пример — скрипт, который проверяет, что локальные диски NVMe правильно смонтированы.
Независимо от метода обнаружения, каждая проблема, обнаруженная в нашей системе, становится условием (Condition), публикуемым на объекте Node. Это дает нам видимость проблем с узлами и позволяет принимать меры.
Меньше ложных срабатываний важнее быстрого обнаружения
Значительная часть работы ушла на исследование проблем с узлами в продакшене, превращение каждой из них в правило обнаружения, а затем его тонкую настройку во избежание ложных срабатываний. Перенос клиентских рабочих нагрузок стоит дорого и может вызвать определенные сбои, поэтому каждая проверка должна показывать, что проблема именно в самом узле, а не просто в одном поде или кратковременном сбое. Мы также хотим избегать реагирования на проблемы уровня кластера, такие как некорректная сетевая политика или ошибка конфигурации CNI, поскольку перенос рабочих нагрузок их не исправит, а скорее усугубит последствия.
Именно поэтому описанная выше проверка тайм-аута NVMe подсчитывает количество пострадавших устройств. Проверка сети — хороший сигнал мониторинга, но мы не предпринимаем по нему мер устранения: масштабный сбой в регионе приводит к тому, что все узлы не проходят одни и те же проверки, и перенос подов не поможет. Проверка создания подов игнорирует первые минуты после загрузки, когда сбои являются нормальным явлением, пока CSI/CNI узла все еще инициализируется. Непредвиденные случаи расследуются и обрабатываются в рамках обычного дежурного процесса (on-call).
Один и тот же набор проверок развертывается во всех облаках. GCP и AKS развертывают собственные демоны NPD, и отключить их невозможно. Там, где управляемый NPD провайдера уже сообщает об уязвимости или состоянии, мы отключаем свой вместо того, чтобы сообщать об одной и той же проблеме дважды.
Рис.: Проблемы, обнаруженные на узлах в продакшене за одну неделю
Проблема устранения последствий
С большой силой приходит большая ответственность, а это значит, что ни один из существующих инструментов не хочет брать на себя ответственность за уничтожение неправильного узла. И поэтому они часто оказываются бесполезными для наших целей: когда мы уверены, что узел неисправен, нам нужно, чтобы он исчез. Учитывая это, задача завершения работы оказывается весьма устойчивой к «стандартизации в отрасли»: здесь нет универсального решения. Проблема не в том, что существующие инструменты недостаточно сложны, а в том, что «порог прекращения работы» может сильно различаться в зависимости от следующего:
- Тип рабочей нагрузки (сохраняющая состояние / без сохранения состояния)
- Зрелость ПО, запущенного в кластере (PDB, соблюдение SIGTERM, гарантии тайм-аута и т. д.)
- Культура разработчиков в организации / уровень YOLO операторов кластера
Мы рассмотрели существующие контроллеры с открытым исходным кодом, прежде чем принять решение о дальнейших действиях:
- Medik8s node-healthcheck-operator и self-node-remediation. Мощные, но требуют установки и настройки CustomResources. Цепочка от строки лога ядра до выведенного из эксплуатации узла проходила через NPD, условие, контроллер, пользовательский ресурс и второй DaemonSet. Слишком много движущихся частей для наших потребностей, и при этом инструмент не позволял нам легко реализовать собственную логику при необходимости.
- Draino. Заброшен, последний коммит был около шести лет назад. Выполняет только вывод из эксплуатации (drains).
- Cluster API MachineHealthChecks. Гораздо более масштабное архитектурное изменение, чем оправдывала сама проблема.
- Новый upstream node-readiness-controller в сочетании с descheduler. Ноль пользовательского кода, повторное использование уже запущенного компонента. Но связь слабая: если дешедюлер настроен неправильно, узлы получают тайнты (taints) и никогда не выводятся из эксплуатации. Кроме того, он не дает нам контроля над последующими шагами, такими как удаление инстанса. К тому же, сам Node Readiness Controller был незрелым, когда мы начинали проект.
- Собственное автоматическое восстановление узлов Karpenter. Мы не используем Karpenter в наших кластерах GCP и Azure. Сама функция зависит от агента узла AWS, что не позволяет обеспечить согласованность между облаками.
Наш собственный NPM (Node Problem Mitigator)
Поэтому мы создали собственный контроллер с простой миссией: уничтожать неисправные узлы с желаемым уровнем агрессивности. Контроллер только уничтожает/удаляет узлы и никогда не определяет, является ли узел исправным или неисправным; эта задача делегируется node-problem-detector.
Контроллер отслеживает статус и условия узлов, и каждое условие настраивается с помощью шагов по устранению проблем узла (от наименее агрессивных к наиболее агрессивным):
- Оценка (Evaluate): тестовый запуск (dry run) для мониторинга ситуации
- Вывод из эксплуатации (Drain): корректное удаление подов с соблюдением PDB
- Завершение (Terminate): вывод из эксплуатации (с тайм-аутом), затем удаление инстанса/ВМ.
Шаги могут быть изменены для уже выполняющегося процесса устранения последствий (если срабатывает другое условие с более агрессивными шагами), но направление только одно: в сторону более агрессивных мер. Независимо от выбранных шагов, отладочная информация узла может быть собрана в первую очередь с помощью задания предварительного устранения (pre-mitigation Job, см. следующий раздел о NDC). Сбор отладочного пакета по умолчанию выполняется по принципу «лучших усилий» (best-effort); он не блокирует меры по устранению, чтобы гарантировать избавление от неисправных узлов как можно быстрее.
Безопасность. Когда вы развертываете нечто подобное в производственном кластере, первое, что приходит на ум: «А что, если?». Что, если он начнет удалять слишком много узлов одновременно? Что, если есть рабочие нагрузки, которые мы предпочитаем проверять силами человека перед уничтожением? Node-problem-mitigator использует различные механизмы безопасности (safety gates) для снижения рисков устранения:
- Kill switch: значение в config map, которое останавливает любую активность контроллера.
- Режим пробного запуска / оценки (Dry-run): предварительный просмотр потенциальных мер по устранению без их фактического выполнения.
- Исключения: пространства имен рабочих нагрузок, пометки (taints), аннотации и метки узлов; мы можем фильтровать и пропускать эти узлы.
- Глобальное ограничение частоты устранения проблем с узлами: с какой скоростью можно устранять проблемы на узлах. Например, можно настроить максимум одно устранение проблемы на узел за 15 минут (на кластер).
- Вывод различных метрик и отправка оповещений о зависших процессах устранения, аномально высоком количестве таких процессов и т. д.
Внедрение
Внедрение столь «опасного» инструмента — большая ответственность. К счастью, у нашей команды хватило смелости взяться за это шаг за шагом:
- Начните с оценки условий и их паттернов. Обеспечьте процесс достаточным количеством датчиков и оповещений; поначалу следите за дашбордом вручную.
- Постепенно настраивайте более агрессивные меры реагирования для тех условий, в которых вы уверены.
- Начинайте с окружений разработки и стейджинга, опережая продакшен на один шаг.
- Поддерживайте детализацию конфигураций; некоторые условия несут в себе больше рисков, чем другие.
Node-problem-mitigator является проектом с открытым исходным кодом, и мы приветствуем вклад разработчиков:
Когда мы обнаруживаем подозрительный узел, первое, что хочется сделать, — получить с него телеметрию: логи, метрики, состояние системы и т. д. Когда узел удаляется, мы теряем потенциально полезные диагностические данные. Было бы здорово иметь отладочный пакет проблемного узла прямо перед его заменой?
У разных облачных провайдеров свои методы сбора отладочных пакетов (EC2RL, AKS periscope), но они зависят от конкретного облака и в основном заточены под их техподдержку. Сбор отладочных данных превращается в проблему: разные методы авторизации и сбора для разных облаков, а также сопоставление узлов с их представлением в виде облачных инстансов. Это немалый объем работы, особенно во время инцидента.
Из трех поддерживаемых нами CSP инструмент GCP ближе всего соответствует нашим требованиям: sosreport. Он обладает высокой модульностью, открытым исходным кодом и не зависит от конкретного облака. На самом деле, у него огромное количество плагинов, и нам пришлось просеять все поддерживаемые сборщики, оставив в пакете только те, что имеют отношение к нашим кластерам.
Отлично, сборщик у нас есть. Теперь остается только доставить его на проблемный узел, запустить и собрать результаты. Оказалось, что это гораздо более сложная часть сбора отладочных данных: из-за того, что мы используем 3 разных облачных провайдера, а узел находится в неисправном состоянии, доставка и выполнение могут стать непростой задачей. Проблемный узел может быть настолько неисправен, что не передает данные телеметрии и не реагирует на запросы их сбора, либо вообще не отвечает.
Наш подход к этой проблеме:
- Попробуйте использовать kubectl cp и kubectl run.
- Если kubelet мертв, в качестве транспорта используйте SSM/S3 (и их эквиваленты в GCP/Azure).
- В качестве опции можно запустить режим снимка (snapshot mode): собирать отладочные данные автономно. Клонируйте корневой том через снимок, создайте временный инстанс/ВМ, подключите корневой том и соберите все доступное в автономном режиме.
Режим снимка также можно использовать для «хрупких» узлов: тех, в отношении которых у нас есть опасения по поводу минимального влияния самих сборщиков.
Инструмент может использоваться как разработчиками, так и автоматически запускаться node-problem-mitigator. В обоих случаях специфичные для CSP детали безопасно абстрагируются, поэтому сбор можно выполнить одной командой, а особенности облака будут определяться по атрибутам узла, таким как ProviderID. Никакие конфиденциальные данные с узла не выгружаются, что соответствует нашим политикам конфиденциальности данных.
С момента внедрения системы NPD++NDC мы каждый месяц устраняем проблемы на ряде нездоровых узлов. Улучшенная видимость этих проблем позволяет нам выявлять новые сценарии сбоев, а также проверять изменения в конфигурациях ВМ перед их развертыванием в продакшен. Мы получаем автоматически собранные диагностические данные и можем без задержек передавать их в службу поддержки CSP.
Как и любое другое «повышение надежности», это имеет свою цену: увеличение сложности системы. Новая автоматизация порождает новые сценарии сбоев, и мы уделяли особое внимание тому, чтобы понять эти новые вызовы и подготовиться к ним. Слишком широкое правило обнаружения может истощить здоровые узлы, не решив проблему; ошибка в модуле устранения может вывести из строя слишком много узлов одновременно или, наоборот, заглушить ошибку без каких-либо действий. Мы согласились на этот компромисс, потому что предохранители (kill switch, пробный запуск, ограничение частоты и исключения) превращают каждый из таких сбоев в ограниченное и наблюдаемое событие, а контроллер, который работает одинаково в трех облаках, проще понять, чем три специфичных для провайдера механизма восстановления, которыми мы не можем полностью управлять.
Стоит отметить, что эта система не реагирует на внешние сигналы о проблемах с ВМ. AWS публикует Status Checks for EC2 instances, в GCP есть мониторинг целостности для защищенных узлов (Shielded Nodes), а в Azure — . Вы также можете захотеть принять меры в отношении узлов, которые кажутся полностью не отвечающими — до такой степени, что NPD не публикует никаких условий (Conditions), поскольку не получает долю ресурсов ЦП или сети. Мы рассмотрим обработку таких ситуаций в следующих публикациях.
Свяжитесь с нами, если хотите присоединиться к команде, реализующей подобные проекты в ClickHouse.