В сентябре наш технический директор Теди Папайоргиджи выступил на конференции GMI Summer Signal в Exploratorium в Сан-Франциско.
В зале собрались более 200 разработчиков, инвесторов и основателей AI-компаний. Команды Runway, Luma, MiniMax и Inworld AI демонстрировали, что можно сделать с помощью генерации видео в реальном времени, агентского кинопроизводства и интерактивных AI-персонажей.
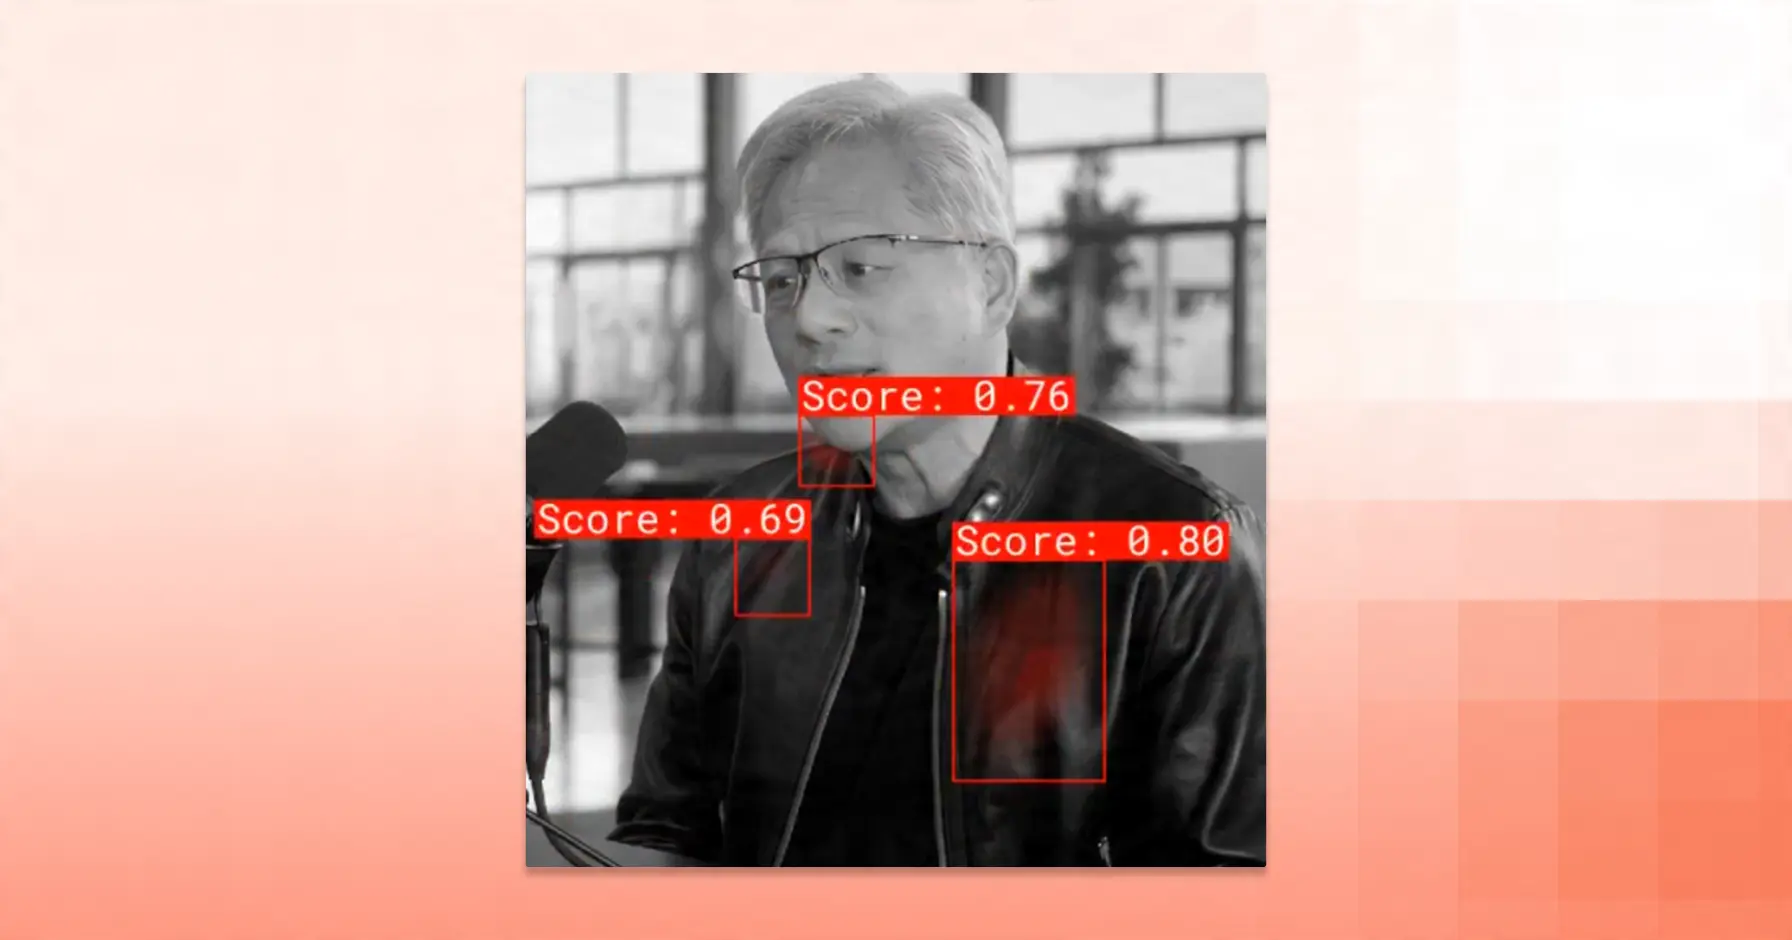
Теди начал свое выступление с игры в угадывание. Зрители увидели видео пресс-конференции, аудиозапись и фотографию собаки на диване, а затем должны были решить, является ли каждый из них настоящим или поддельным.
Все три были синтетическими, и я бы сказал, что менее 10% людей в зале угадали все три правильно — и это было после того, как им сказали, что им нужно решить, является ли контент настоящим или поддельным — они уже были в состоянии повышенной готовности.
Все остальные сосредоточились на том, что может создать генеративный AI (и насколько это реалистично), и мы хотели донести до людей тот факт, что лучшее человеческое обнаружение чаще всего ошибочно.
Это стало довольно хорошим описанием нашей работы в третьем квартале. После официального прекращения работы над голосовой генерацией в качестве платного продукта мы полностью сосредоточили усилия компании на обнаружении. Генеративные модели продолжали меняться, и наша работа все больше фокусировалась на обнаружении, которое могло понимать больше, чем следы моделей, которые оно уже видело.
DETECT-World: взгляд за пределы следов
Наша модель предыдущего поколения DETECT-3B Omni уже была сильной, занимала первое место на DFBench и охватывала аудио, изображения и видео на 51 языке. Но, как и большинство моделей обнаружения, она сильно зависела от изучения артефактов, которые оставляют известные генераторы, и поиска этих артефактов в новом контенте.
Это становится сложнее по мере увеличения количества генераторов. Выпускается новая модель, ваш детектор никогда не видел ее выходных данных, и производительность может упасть, пока вы не переобучите его. В итоге вы постоянно собираете новые примеры и учите модель, на что обращать внимание.
DETECT-World использует другой подход, при котором он все еще ищет артефакты, связанные с сгенерированным контентом, но также проверяет, имеет ли сам контент смысл.
Согласуется ли освещение по всему лицу? Правильно ли падают тени в зависимости от источника света? Имеет ли смысл движение на заднем плане от одного кадра к другому? Соответствуют ли губы аудио на самом деле?
Эти сигналы полезны, потому что они не привязаны к одному конкретному генератору, и физика не меняется, когда запускается новый генератор.
Результаты нашей новой модели также были очень впечатляющими. Точность обнаружения видео-фэйков увеличилась с 80,96% до 98,2%, в то время как точность изображений возросла с 86,70% до 95,8%. Точность аудио достигла 99,47% с уровнем ложно положительных результатов 0,66%, а задержка снизилась на 66% до 399 миллисекунд.
Три поколения обнаружения: точность по модальностям
Аудио представлено во всех трех поколениях. Изображения и видео были представлены в DETECT-3B Omni.
Аудио: Podonos benchmark · Изображение/видео: внутренние бенчмарки pending resemble.ai
На независимом Podonos audio deepfake detection benchmarkбенчмарке Podonos для обнаружения аудио-фэйков DETECT-World занял первое место из 18 оцененных систем по состоянию на август 2026 года. Это была единственная система на доске с уровнями ложно положительных и ложно отрицательных результатов ниже 1%. Наша предыдущая модель DETECT-3B Omni заняла второе место.
Мы также протестировали DETECT-World против инструмента Haotian AI для обмена лицами в реальном времени, который был новым для модели. Он идентифицировал сгенерированный контент с точностью около 95% без предварительного знакомства с генератором, переобучения или тонкой настройки.
Эта идея поиска за пределами известных шаблонов также повлияла на то, как мы думали о остальной части стека обнаружения в этом квартале.
На GMI мы показали другую сторону этой работы с помощью Model Behavior — выставки, созданной на основе визуализаций UMAP, которые наши модели производят внутренне. Каждая точка представляет собой фрагмент медиаконтента, причем похожие и разные примеры сгруппированы в кластеры.
Видимые вместе, визуализации начинают выглядеть почти органично: стаей птиц, дельтой реки, формами, которые формируются и разделяются, когда модель находит связи в данных.
Для нас это был способ сделать то, что обычно происходит внутри модели, видимым для людей. Обнаружение сводится к пониманию того, как медиаконтент соответствует тому, что модель learned о реальном и манипулированном контенте, а не к опоре на один артефакт.
Полностью автоматизированное, судебно-медицинское расследование
Та же идея возникла, когда мы начали работать над тем, что происходит после получения результата обнаружения.
Аналитик по доверию и безопасности, рассматривающий фрагмент контента в социальных сетях с вероятностью манипуляции 94%, все равно должен знать, какого рода манипуляция произошла, насколько сильны доказательства в различных судебно-медицинских аспектах и нужно ли удалять контент на самом деле.
Вот почему мы запустили Investigator в этом квартале: шесть управляемых судебных следователей доступны через наш API, каждый из которых построен вокруг конкретного рабочего процесса верификации.
Они охватывают модерацию социальных сетей, материалы страховых требований, кадры новостных репортажей, документы и квитанции, судебные доказательства, а также удостоверяющие личность документы и представленных лиц.
Каждое расследование объединяет несколько слоев судебного анализа и возвращает доказательства и объяснения вместе с результатом. Цель — дать человеку, рассматривающему контент, достаточно контекста, чтобы принять решение, не собирая расследование вручную.
Это неоднократно возникало в разговорах с корпоративными клиентами. Само обнаружение было высокоточным, но когда следующие шаги требуют больше, чем «это AI или нет», нужны полные контекстные данные, результаты из нескольких API и рекомендации Investigator.
Обнаружение того, кто действует — бот, AI или человек?
В течение последних трех лет, когда мы говорили об обнаружении, мы обычно говорили о медиаконтенте: является ли это аудио, изображение или видео, сгенерированное AI?
Теперь есть еще один вопрос, который стоит задать: что, если то, что взаимодействует с вашим веб-сайтом или приложением, является AI?
Agent Detection — это наша модель System One и новый для нас продукт. Владельцы веб-сайтов и приложений могут добавить одну строку кода и начать получать видимость своего трафика в течение нескольких минут.
Вместо того чтобы полагаться на строки user-agent, которые агенты могут подделать, модель анализирует поведенческие сигналы, такие как движение курсора, ритм печати и модели взаимодействия. Каждое решение включает обоснование, поэтому операторы могут видеть, почему посетитель был классифицирован как человек, AI-агент или что-то, что требует дальнейшего рассмотрения.
Это дает организациям выбор, что делать с различными типами трафика. Они могут перенаправлять агентов на API или MCP-серверы, ограничивать доступ к чувствительным областям, таким как биллинг или управление учетными данными, или предотвращать определенные действия, такие как удаление учетной записи.
Я не думаю, что ответ заключается в блокировке каждого AI-агента. Некоторые из них делают полезные вещи, и личное использование уже взрывается, поэтому организациям придется установить политику маршрутизации, разрешения и ограничения. Проблема заключается в том, чтобы знать, что происходит в ваших системах, и иметь достаточно информации, чтобы решить, как реагировать, и решение начинается с того, чтобы знать, имеете ли вы дело с человеком, ботом или агентом.
В этом смысле обнаружение агентов — это естественное продолжение работы, которую мы уже ведём. Мы начали с вопроса о том, был ли фрагмент медиаконтента сгенерирован или манипулирован как по содержанию, так и по вызовам, и теперь мы также рассматриваем поведение: является ли объект, взаимодействующий с системой, ИИ-агентом и что он делает.
Видеть работу в реальном мире
Часть признания, которое мы получили в этом квартале, отражала этот более широкий подход.
DETECT-World выиграл Best Technological Solution at the Global Anti-Scam Summit America, а на Visual 1st мы выиграли Лучшую технологию, врученную Навином Сармой из Google.
Премии были обнадеживающими, но мне показались более интересными разговоры вокруг них. Люди начинают задавать вопросы, которые выходят за рамки «это фейк или нет?». Они хотят знать, откуда что-то взялось, насколько они могут доверять результату и что они могут реально сделать с этой информацией.
Именно здесь и вписывается в картину водяной знак. Обнаружение может выявить признаки манипуляции, а водяной знак может помочь установить происхождение.
Мы работаем над обоими аспектами уже много лет, и подписание Кодекса практики ЕС по прозрачности контента, генерируемого ИИ вместе с Google, Anthropic, Meta и другими в качестве технологического поставщика решений для маркировки и обнаружения было важным шагом в том, чтобы сделать эту часть нашего подхода более явной.
Зохаиб также присоединился к панели на мероприятии Google по безопасности ИИ в сентябре, посвященном безопасности и наблюдаемости агентов. Он возвращался к тому, что организациям нужна видимость того, что происходит, прежде чем они смогут ввести вокруг этого значимые ограничения.
Это относится к новым системам ИИ, но также проявляется и в гораздо более старой инфраструктуре. Мы видим это в устаревших системах колл-центров, работающих с голосовыми клонами, так же, как мы видим это на веб-сайтах, работающих с ИИ-агентами.
Что мы должны друг другу
Все это возвращает меня в ту комнату в Exploratorium.
Аудитория должна была решить, являются ли несколько фрагментов медиаконтента реальными или фейковыми. Год назад это могло показаться разумным вопросом, на который люди могли ответить самостоятельно, но теперь это невозможно.
По мере того как генеративные модели становятся лучше в воспроизведении реальности, наша собственная оценка становится менее надёжной. Иногда мы решаем, что что-то фейк, потому что это не соответствует нашим ожиданиям, а иногда мы верим чему-то, потому что это подтверждает то, что мы уже ожидаем как истину.
Модели могут подходить к проблеме по-разному. Они могут рассматривать гораздо больший объём доказательств и изучать связи между вещами, которые сложно увидеть человеку.
Именно поэтому мы хотели, чтобы Model Behavior был представлен на GMI. Визуализации дали людям возможность увидеть, как модель обнаружения организует эти доказательства, а не рассматривать итоговый результат как чёрный ящик.
Вопрос, лежащий в основе всего этого, по-прежнему прост: заслуживает ли это вашего доверия?
Для нас ответ на этот вопрос всё чаще означает больше, чем просто возвращение оценки. Это означает понимание контента, расследование доказательств, знание того, когда что-то новое, и предоставление людям достаточного контекста, чтобы решить, что происходит дальше.
Что дальше
Вскоре мы запускаем Resemble AI для Microsoft Teams, обеспечивая бесперебойное обнаружение глубоких фейков в режиме реального времени без ботов на встречах, где команды уже принимают важные решения.
И это только начало. У нас есть ещё много новых продуктов и партнёрств, которые помогут организациям обнаруживать ИИ в контенте, звонках и поведении.
Если что-то из этого относится к тому, что вы создаёте или защищаете, мы хотели бы услышать от вас, запланируйте звонок с нашей командой.