Вкратце
Возобновился интерес к архитектурам исполнителя-оркестратора как способу сэкономить на фронтальных вычислениях. В таких системах фронтальная модель оценивает задачу, строит план и координирует работу между меньшими, более дешевыми моделями-исполнителями, чтобы прийти к решению. Мы считаем, что эти сбережения могут быть еще больше, если изучить, как построен весь конвейер.
В нашей конфигурации более дешевые модели вызываются первыми для обработки токен-насыщенного контекста и извлечения информации, оптимизированных для получения контекста наивысшего качества. К тому времени, когда в конце вызывается фронтальная модель, у нее уже есть контекст, чтобы написать правильный патч после всего лишь одного вызова.
Это архитектура, которая позволила нам достичь рекордного показателя разрешения 80,8% на SWE-Bench Pro, потратив всего 5,99 доллара на задачу, по сравнению с другими гибридными подходами, такими как недавний эксперимент Fireworks AI с работником + советником, где качество пострадало в погоне за экономией затрат.
Экспериментальная настройка и базовый уровень
Мы используем стандартную настройку бенчмарка coding-agent, подробно описанную в нашей предыдущей работе: агент получает задачу на естественном языке, работает внутри Docker-контейнера, содержащего целевой репозиторий, действует через терминал команд и выводит git-патч, оцениваемый по скрытым тестам. Наш базовый уровень — это классический цикл ReAct (Reasoning + Acting) с Docker-терминалом в качестве единственного инструмента. Один проход с использованием открытой модели MiniMax-M3 решает 57% всего публичного набора SWE-Bench Pro. Это хороший базовый уровень, но его повышение требует более сложной оркестрации.
Инженерная разработка многомодельного конвейера для улучшения производительности агента
Легким решением для повышения процента разрешения могло бы стать замена MiniMax-M3 на фронтальную модель. Но наша цель заключалась не только в повышении качества; мы хотели сделать это, одновременно снижая затраты на вычисления по сравнению с текущим результатом, соответствующим передовым достижениям. Фронтальный агент потратил бы весь свой бюджет как на исследование, так и на генерацию, что значительно увеличило бы затраты.
Наше решение заключалось в том, чтобы намеренно подумать о том, как мы построили наш конвейер.
Ранее мы измеряли, как изменение порядка традиционного конвейера кодирования-агента улучшило как точность, так и эффективность; вместо того, чтобы сначала извлекать контекст, а затем генерировать решение, мы генерируем решения в большом масштабе, а затем используем эти кандидаты для лучшего извлечения контекста.
Теперь мы продолжаем изучать, как эффективное проектирование нашего конвейера кодирования-агента может значительно улучшить качество, одновременно снижая общую стоимость задачи. Мы делаем два важных предложения: во-первых, назначать каждый этап модели, которая наиболее эффективна в требуемой работе. Во-вторых, проектировать агентов так, чтобы к моменту вызова фронтальной модели для окончательного написания у нее был лучший контекст для работы.
Можно представить это как команду, состоящую из младших, старших и главных членов. Здесь наша младшая модель параллельно распространяется по репозиторию, ищет, пробует исправления, запускает тесты. Не каждая попытка успешна, но в совокупности они определяют, где находится исправление. Старшая модель подхватывает их попытки, изучает код, к которому они прикоснулись, и пишет, от чего именно зависит реальное исправление: участвующие функции, их вызывающие стороны, тесты, которые их покрывают. Только тогда главная модель садится и пишет патч один раз, исходя из подготовленного брифинга.
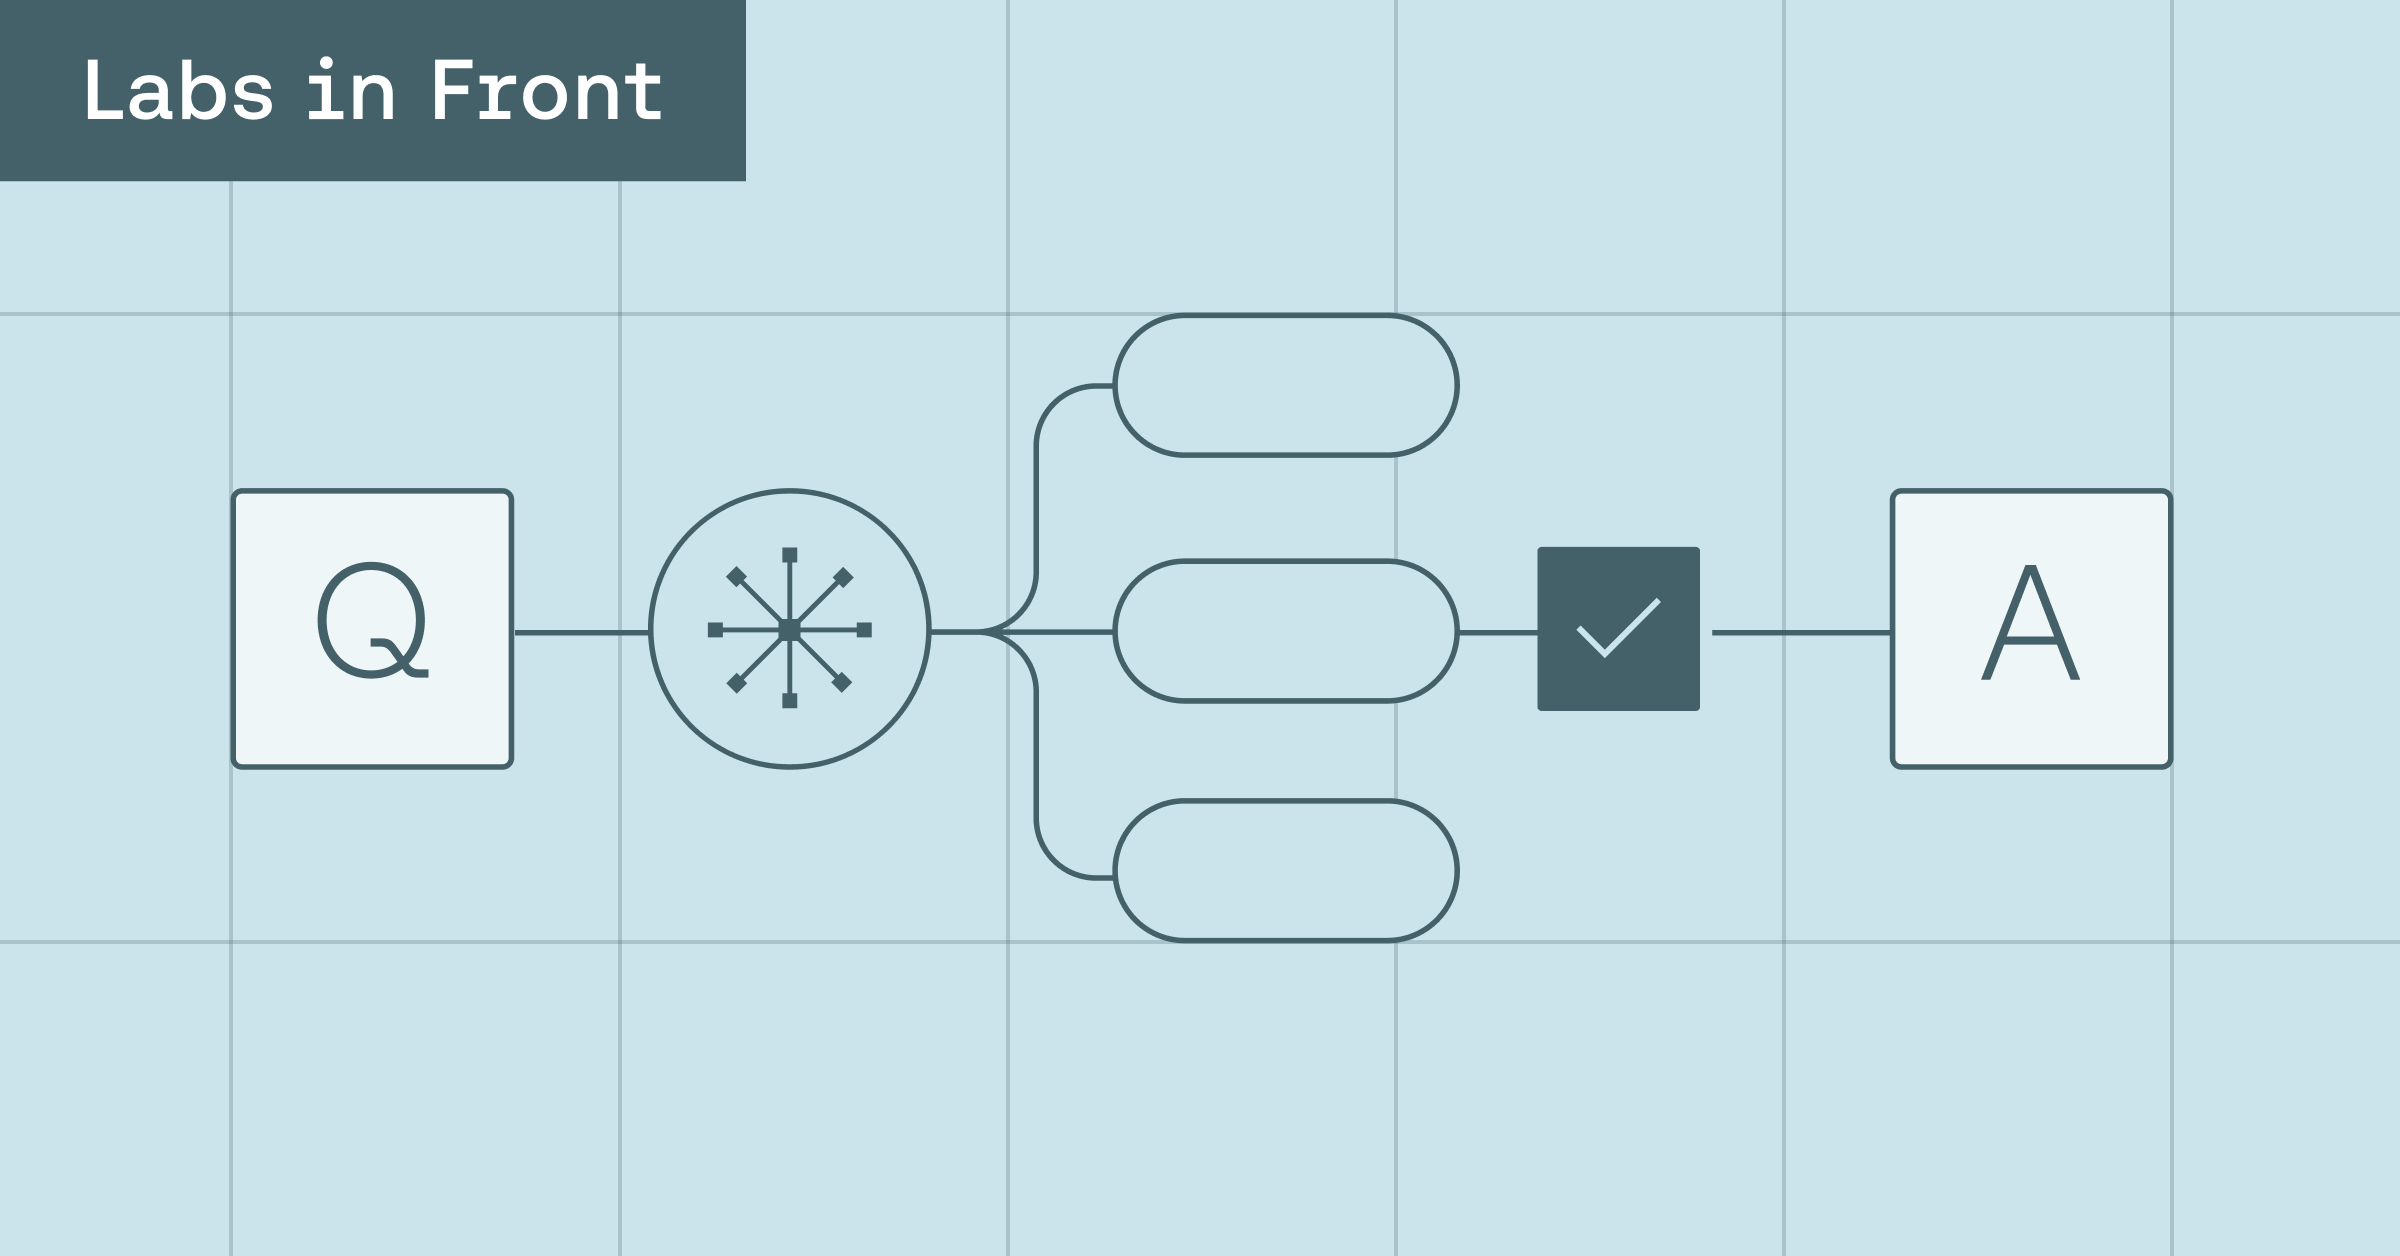
Вот наш конвейер: MiniMax-M3 как младшие, GPT-5.2 как старшие, а фронтальная модель (Opus 4.8 или Fable 5) как главные, которых мы привлекаем для одного шага, где их навыки меняют результат.
Оценка эффективности нашего покрытия кода: получаем ли мы правильный контекст?
Одним из основных источников эффективности в этом конвейере является предоставление фронтальной модели только самого релевантного, высококачественного контекста, чтобы она оставалась сосредоточенной при генерации патча. Поскольку патчи решений могут достигать десятков тысяч токенов, нерелевантный контекст добавляет шум, который может отвлечь модель от правильного решения и заставить ее блуждать, увеличивая затраты.
Поэтому перед окончательной генерацией (шаг 3) мы проверили, содержит ли контекст, который мы собрали, действительно код, необходимый для исправления. Мы сделали это, сравнив его с золотыми патчами бенчмарка: для каждой задачи какая доля строк, к которым прикасается золотой патч, также появляется в нашем собранном контексте? Мы отслеживаем это двумя способами:
Параллельные роллы (младшая модель). Каждый ролл — это одна полная попытка открытого составителя (MiniMax-M3) решить задачу. По мере того, как мы движемся по оси x в Figure 3, пул растет от 1 до 10, поскольку больше попыток в совокупности затрагивают больше релевантного кода.
Извлечение контекста (старшая модель). Помимо кандидатских патчей, GPT-5.2 извлекает окружающий код, от которого зависит исправление. Затененная область на графике — это то, что добавляет этот шаг извлечения контекста помимо роллов.
Рисунок 3. Покрытие строк золотого патча в зависимости от размера пула роллов с и без извлечения контекста GPT-5.2 (затененная область = прирост). Среднее значение на экземпляр по 731 публичной задаче SWE-Bench Pro.
Мы измеряем два вида строк кода отдельно:
- Удаленные строки — это строки, которые золотой патч удаляет или модифицирует, и они находятся в исходном коде. Покрытие здесь помогает ответить на вопрос: насколько хорошо мы нашли правильное «место» в репозитории для исправления? С помощью параллельных роллов и извлечения контекста мы достигаем ~90% покрытия такого типа строк.
- Добавленные строки — это новый код, который вводит исправление. Покрытие здесь помогает ответить на вопрос: насколько хорошо мы предложили правильное исправление? На этом типе строк мы достигаем ~71% покрытия.
Отслеживание, куда на самом деле идут деньги
Наш конвейер, работающий с Fable 5, стоит 5,99 доллара за задачу. Вот как эта цена распределяется по конвейеру:
Основное преимущество здесь — это перенос нагрузки с фронтальной модели.
Когда один агент Opus 4.8 решает всю задачу от начала до конца, это стоит 18,28 доллара ([[L1]по данным Fireworks AI). В нашем конвейере фронтальные модели потребляют только 25% бюджета, а остальная работа выполняется более дешевыми моделями. В результате весь наш конвейер работает примерно в 1/3 от стоимости одного агента Opus 4.8, при этом превосходя его по качеству.
Ключевые выводы
- Соответствуйте модели этапу. Открытые, более слабые модели не только дешевле, но и теперь достаточно хороши, чтобы эффективно генерировать роллы и искать репозитории. Сохраните качество фронтальных моделей для сложных задач, с которыми открытые, более слабые модели все еще не могут справиться хорошо.
- Повторно используйте то, за что вы уже заплатили. Рассматривайте параллельные роллы младших агентов как «карту исправлений», которой они являются. Подайте этот сигнал в извлечение контекста, а не выбрасывайте его после голосования.
- Собирайте исходный контекст после попыток решения задач. Поиск дискриминационного контекста между известными патчами приводит к гораздо более сфокусированному и эффективному исходному контексту, который можно подать на следующий шаг.
- Тратьте фронтальные вычисления экономно. Одна фронтальная генерация над хорошо подготовленным контекстом лучше, чем агент, использующий фронтальную модель от начала до конца. Используйте дорогую модель на этапе, где качество имеет наибольшее значение.
Это часть более широкого усилия по оптимизации производительности агентов путем разработки правильной стратегии выполнения на основе подходящих моделей. Следующий шаг — совершенствование процесса извлечения исходного контекста для достижения более высокой охвата.