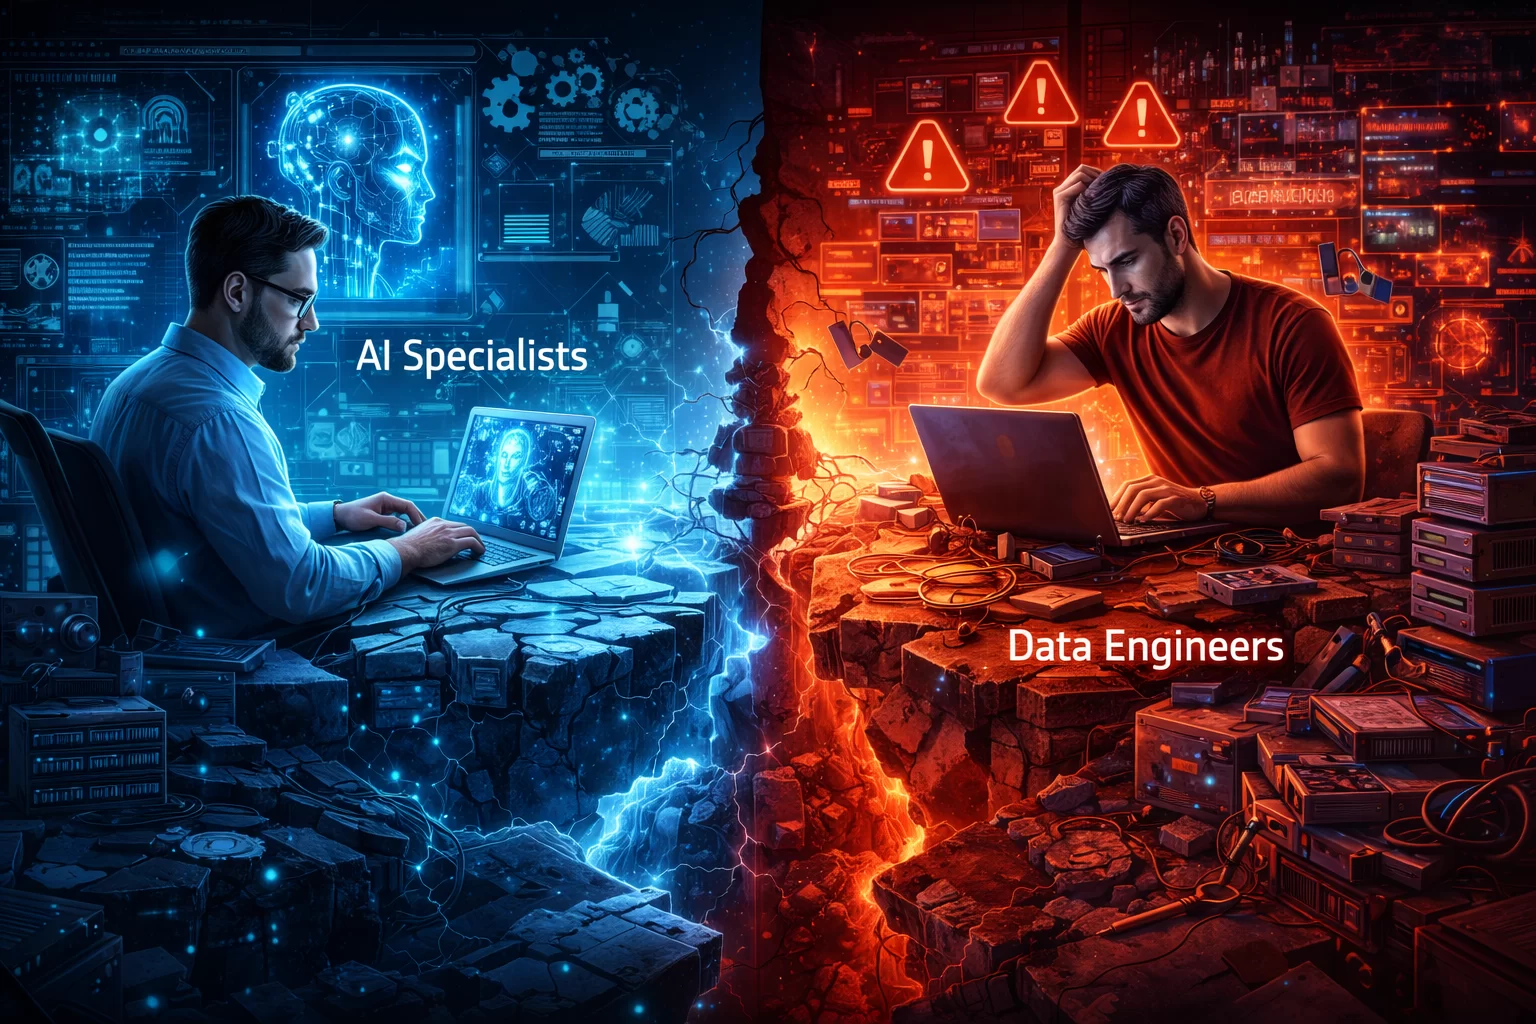
В стремлении внедрить искусственный интеллект организации совершают критическую ошибку, которая может стоить им миллионов из-за провальных проектов и упущенных возможностей. Последние данные о занятости выявляют тревожную тенденцию: компании нанимают специалистов по ИИ беспрецедентными темпами, пренебрегая ролями в области фундаментальной инфраструктуры данных, которые делают успех ИИ возможным. Это сродни найму гонщиков до постройки гоночной трассы — на бумаге выглядит впечатляюще, но обречено на провал.
Тревожная статистика провалов ИИ-проектов
Цифры рисуют мрачную картину текущего состояния внедрения ИИ в корпоративной среде. Согласно исследованиям RAND, более четырех из пяти ИИ-проектов не оправдывают ожиданий. Этот уровень неудач, превышающий 80%, примерно вдвое выше, чем у традиционных технологических проектов, что вызывает серьезные вопросы о том, как организации подходят к внедрению ИИ.
Что стоит за этими провалами? Ответ кроется не в сложности моделей ИИ или возможностях алгоритмов машинного обучения. Напротив, виновником является нечто гораздо более фундаментальное: качество, доступность и управление данными, питающими эти системы. Почти две трети (63%) организаций признают, что не уверены в своих возможностях управления данными для ИИ-инициатив, однако структура найма говорит о том, что многие не видят этой связи.
Недавние данные о занятости в США от DoubleTrack предоставляют конкретные доказательства этого несоответствия. В период с 2024 по 2025 год американские работодатели разместили 111 296 вакансий для специалистов по ИИ и машинному обучению, но только 76 271 роль была сосредоточена на инфраструктуре данных. Этот 46-процентный разрыв между ролями в ИИ и позициями инженеров данных свидетельствует о фундаментальном непонимании того, что обеспечивает успех ИИ-проектов.
Феномен «найма роботов раньше механиков»
Этот дисбаланс в найме можно понять через простую аналогию: компании по сути нанимают роботов, не убедившись, что у них есть механики для их обслуживания. Специалисты по ИИ — это видимое, захватывающее лицо цифровой трансформации, новаторы, которые обещают революционизировать бизнес-процессы и открыть новые источники дохода. Инженеры данных, напротив, работают за кулисами, создавая конвейеры, обеспечивая качество данных и поддерживая инфраструктуру, которая делает ИИ возможным.
Проблема проявляется по-разному в разных отраслях, но закономерность остается неизменной. В отделах продаж компании разместили на 232% больше вакансий в сфере ИИ, чем позиций в инфраструктуре данных. Это особенно тревожно, учитывая, что данные CRM (управления взаимоотношениями с клиентами) печально известны своей неряшливостью, несогласованностью и фрагментарностью. Данные о продажах часто содержат дубликаты записей, противоречивое форматирование, неполную информацию и конфликтующие записи в разных системах — именно те проблемы с качеством данных, которые обрекают ИИ-проекты на провал с самого начала.
Отделы маркетинга демонстрируют более сбалансированный подход, но все же отдают предпочтение ролям в ИИ на 54%. Хотя это лучше, чем в продажах, это все равно свидетельствует о тревожной приоритизации возможностей ИИ над работой по обеспечению качества данных, необходимой для эффективной поддержки этих возможностей.
Секторы инженерии, права и технологий продемонстрировали схожие закономерности: наем в сфере ИИ стабильно опережает наем в инфраструктуру данных. Каждый из этих отделов генерирует и полагается на различные типы данных с уникальными проблемами качества, однако акцент при найме остается на внедрении ИИ, а не на создании фундамента данных.
География хайпа вокруг ИИ: где проблема наиболее остра
География рассказывает интересную историю о том, кто совершает эту ошибку наиболее серьезно. Штаты с самым высоким соотношением ролей в ИИ к ролям в инфраструктуре данных — это не традиционные технологические центры, такие как Калифорния, Нью-Йорк или Массачусетс. Вместо этого это регионы, которые обычно воспринимаются как менее технологически зрелые:
- Миссисипи лидирует с ошеломляющим показателем: на 264% больше ролей в ИИ, чем позиций в данных
- Миссури следует за ним с показателем 179%
- Канзас демонстрирует дисбаланс в 176%
- Монтана регистрирует на 175% больше ролей в ИИ, чем в данных
Это географическое распределение предполагает, что регионы с менее развитыми технологическими экосистемами могут быть более подвержены хайпу вокруг ИИ, спеша нанимать специалистов без предварительного создания необходимой инфраструктуры. В этих областях может не хватать опытных руководителей, которые понимают, что успех ИИ зависит от качества данных, или на них может оказываться давление с целью выглядеть инновационными, не понимая при этом технических требований.
Более устоявшиеся технологические центры, хотя и демонстрируют дисбаланс, как правило, имеют лучшие показатели. Вероятно, это отражает более глубокие институциональные знания о реалиях внедрения сложных технологических систем и важности фундаментальной инфраструктуры.
Головоломка с компенсацией
Ситуацию усугубляет то, что специалисты по ИИ получают среднюю надбавку к зарплате примерно в 15 000 долларов по сравнению с инженерами данных. Организации платят больше профессионалам, которые не могут добиться результатов без надлежащего фундамента. Этот разрыв в компенсации сигнализирует рынку о том, что работа с ИИ более ценна, чем инженерия данных, что отвлекает таланты от фундаментальных ролей и усиливает организационные предубеждения, отдающие предпочтение захватывающей, видимой работе с ИИ перед критически важной инфраструктурой данных.
Понимание причин происходящего
Несколько факторов способствуют этому широко распространенному несоответствию между приоритетами найма и реальными техническими требованиями:
Проблема видимости
ИИ-проекты очень заметны. Когда организация объявляет о новой ИИ-инициативе, это вызывает ажиотаж среди заинтересованных сторон, впечатляет инвесторов и создает убедительные маркетинговые нарративы. Проекты по инфраструктуре данных, напротив, невидимы для большинства заинтересованных сторон. Создание надежных конвейеров данных, внедрение систем управления и обеспечение качества данных не подходят для захватывающих пресс-релизов.
Непонимание сложности
Многие лица, принимающие решения, недооценивают сложность работы инженеров данных. Они могут рассматривать ее как простые процессы ETL (извлечение, преобразование, загрузка), которые можно выполнить быстро, в то время как ИИ требует специализированных знаний. В действительности современная инженерия данных чрезвычайно сложна и включает в себя распределенные системы, обработку в реальном времени, системы обеспечения качества данных, внедрение управления и интеграцию между разнообразными системами и форматами.
Разрыв в компетенциях руководства
Многие руководители, принимающие решения о найме и бюджете, не имеют технического образования, которое дало бы им представление о требованиях к данным для успешного ИИ. Они могли читать о трансформационном потенциале ИИ в бизнес-изданиях, но им не хватает понимания технических предпосылок. Этот пробел в знаниях приводит к решениям, которые отдают приоритет захватывающему результату (ИИ) перед необходимым фундаментом (инфраструктурой данных).
Давление с целью выглядеть инновационными
Организации испытывают сильное давление, стремясь выглядеть инновационными и дальновидными. Найм специалистов по ИИ сигнализирует об инновациях гораздо эффективнее, чем найм инженеров данных. Это особенно актуально для компаний на конкурентных рынках или тех, кто пытается привлечь инвестиции. Внешний эффект от найма ИИ-специалистов часто превалирует над практическими требованиями для достижения успеха.
Реальные последствия
Последствия такого искаженного приоритета найма выходят далеко за рамки провальных пилотных проектов. Организации сталкиваются с рядом серьезных проблем:
Растраченные инвестиции
Когда ИИ-проекты терпят неудачу из-за слабой базы данных, организации тратят значительные средства не только на зарплаты ИИ-специалистов, но и на всю экосистему, выстроенную вокруг них — облачную инфраструктуру, лицензии на ПО, программы обучения и альтернативные издержки. Эти провальные проекты могут стоить миллионы, не принося никакой бизнес-ценности.
Разочарование талантов и текучесть кадров
Талантливые ИИ-специалисты, приходящие в организации в ожидании инновационной работы, быстро разочаровываются, обнаружив, что их ограничивает низкое качество данных. Они могут тратить 80% своего времени на очистку и подготовку данных — работу, для которой они слишком квалифицированы и на которую не подписывались. Это ведет к низкой удовлетворенности работой и высокой текучести кадров, создавая порочный круг найма, потери талантов и повторного найма.
Конкурентное отставание
Пока организации борются с провальными ИИ-инициативами, построенными на шатких фундаментах данных, конкуренты, которые должным образом инвестировали в инфраструктуру данных, достигают реальных результатов. Эти конкуренты могут быстрее внедрять итерации, развертывать более сложные модели и добиваться реальных бизнес-результатов, оставляя компании, ставящие ИИ впереди данных, далеко позади.
Организационное разочарование
Повторяющиеся неудачи ИИ-проектов порождают цинизм внутри организаций. Команды становятся скептичными по отношению к новым инициативам, руководители теряют веру в технологические инвестиции, а в организации вырабатывается иммунитет к инновациям. Этот культурный ущерб может сохраняться долго после того, как технические проблемы будут решены.
Путь вперед: построение стратегий ИИ, ориентированных на данные
Решение этого кризиса заключается не в полном прекращении найма ИИ-специалистов — организациям нужны как экспертиза в области ИИ, так и возможности инженерии данных. Однако последовательность и пропорции имеют огромное значение. Вот как организации могут создать более устойчивые возможности в области ИИ:
Начните с оценки данных
Прежде чем нанимать хотя бы одного ИИ-специалиста, организации должны провести тщательную оценку своего текущего ландшафта данных. Эта оценка должна включать качество данных в ключевых системах, возможности доступа к данным и их интеграции, системы управления и политики, техническую инфраструктуру для обработки данных, а также разрывы между текущим состоянием и готовностью к ИИ.
Эта оценка дает дорожную карту того, что необходимо построить до того, как ИИ-инициативы смогут стать успешными, и помогает расставить приоритеты в инвестициях в инфраструктуру данных.
Установите правильные пропорции найма
Вместо дисбаланса в 46%, наблюдаемого в текущих данных о занятости в США, организациям следует стремиться как минимум к паритету между ролями инженеров данных и ИИ-специалистов на ранних этапах создания возможностей. Более подходящим соотношением может быть 2:1 или даже 3:1 в пользу инженеров данных, пока не будет создана надежная инфраструктура данных.
Это не означает, что найм ИИ-специалистов должен прекратиться, но он должен быть пропорционален существующим мощностям инженерии данных, способным его поддерживать.
Инвестируйте в управление данными на раннем этапе
Управление данными — это не просто соблюдение нормативных требований, это обеспечение того, чтобы данные были надежными, согласованными и достаточно достоверными для обучения моделей ИИ. Организациям следует создать системы управления данными до запуска ИИ-инициатив, включая четкое владение данными и подотчетность, стандарты качества данных и мониторинг, практики управления метаданными, возможности отслеживания происхождения данных, а также меры безопасности и конфиденциальности.
Создавайте кросс-функциональные команды
Наиболее успешные внедрения ИИ предполагают тесное сотрудничество между инженерами данных, ИИ-специалистами, экспертами в предметной области и бизнес-стейкхолдерами. Вместо изоляции ИИ-команд организациям следует создавать интегрированные группы, где инженеры данных и ИИ-специалисты работают вместе с момента зарождения проекта до развертывания и обслуживания.
Приоритет инфраструктуры перед инновациями
Организациям следует сопротивляться искушению сразу переходить к передовым методам ИИ. Вместо этого им следует сначала построить надежные конвейеры данных, которые могут надежно собирать, очищать и подготавливать данные, внедрить мониторинг и оповещение о качестве данных, создать масштабируемую инфраструктуру хранения и обработки данных, создать инструменты самообслуживания для доступа к данным для аналитиков и специалистов по данным, а также обеспечить наличие систем безопасности и соответствия требованиям.
Только после создания этих основ организациям следует приступать к амбициозным ИИ-инициативам.
Обучайте руководство
Пожалуй, самое важное — организациям необходимо обучать свое руководство техническим реалиям внедрения ИИ. Это обучение должно охватывать то, как модели ИИ зависят от качества данных, почему инженерия данных является обязательным условием успеха ИИ, типичные сроки и инвестиции, необходимые для создания инфраструктуры данных, а также риски приоритизации найма ИИ-специалистов над инженерами данных.
Когда руководители понимают эти основы, они с большей вероятностью принимают решения, ведущие к успешным результатам.
Роль моделей зрелости ИИ
Организациям следует принять модели зрелости ИИ, которые признают инфраструктуру данных обязательным условием для продвинутых возможностей ИИ. Типичные этапы включают:
Этап 1: Фундамент данных – создание базовых процессов сбора, хранения и обеспечения качества данных.
Этап 2: Аналитические возможности – создание описательной и диагностической аналитики, которая дает инсайты на основе существующих данных.
Этап 3: Предиктивная аналитика – внедрение моделей, которые прогнозируют будущие результаты на основе исторических закономерностей.
Этап 4: Предписывающая аналитика – разработка систем, которые рекомендуют действия на основе прогнозов.
Этап 5: Автономные системы – создание ИИ-систем, которые принимают и реализуют решения с минимальным вмешательством человека.
Организациям следует честно оценивать свой текущий этап и сопротивляться желанию перескакивать через него. Попытки реализации продвинутых инициатив на 1-м этапе зрелости данных гарантируют провал.
Предупреждение Gartner: обрыв 2026 года
Исследовательская компания Gartner выпустила суровое предупреждение, подтверждающее важность надлежащих основ данных: три из пяти ИИ-проектов без данных, готовых к ИИ, могут быть заброшены к 2026 году. Это представляет собой огромную трату организационных ресурсов и значительный откат для инициатив по цифровой трансформации.
Концепция «данных, готовых к ИИ» имеет решающее значение. Недостаточно просто иметь данные; эти данные должны быть чистыми, доступными, хорошо управляемыми, должным образом интегрированными, безопасными и соответствующими требованиям, а также достаточными по объему и разнообразию для предполагаемых приложений ИИ.
Организации, которые сосредоточились на найме ИИ-специалистов, не обеспечив соответствие своих данных этим критериям, скорее всего, окажутся частью статистики по отказу от проектов в 60% случаев.
Отраслевые особенности
Разные отрасли сталкиваются с уникальными вызовами при создании фундаментальных данных для ИИ. Финансовые учреждения должны балансировать инновации с жесткими нормативными требованиями и отслеживанием происхождения данных. Организации здравоохранения должны внедрять ИИ, сохраняя соблюдение HIPAA и объединяя изолированные данные пациентов. Розничные продавцы требуют обработки данных в реальном времени по онлайн и офлайн каналам. Производственные компании нуждаются в надёжных IoT‑конвейерах и интеграции OT/IT систем для предиктивного обслуживания и контроля качества.
Лучшие практики успешных организаций
Организации, которые успешно внедрили ИИ, имеют общие характеристики: они начинали с конкретных, высокоценных кейсов, а не пытались преобразовать всё сразу; серьёзно инвестировали в инфраструктуру данных до масштабирования ИИ‑инициатив; создали кросс‑функциональные команды, включающие инженеров данных, специалистов по ИИ и экспертов домена; измеряли успех по бизнес‑результатам, а не только точности модели; и рассматривали качество данных как постоянную дисциплину. Эти организации понимали, что успех ИИ строится на отличных фундаментальных данных.
Перспектива Artezio: создание устойчивых возможностей ИИ
В Artezio мы наблюдали эти паттерны в работе с клиентами. Организации, которые обращаются к нам с желанием «провести ИИ», часто должны услышать неприятную правду: они ещё не готовы к ИИ. Их инфраструктура данных недостаточно зрелая, чтобы поддерживать успешные ИИ‑инициативы.
Наш подход подчёркивает разработку с учётом фундаментальных данных. Мы помогаем клиентам оценить текущую зрелость данных, построить надёжную инфраструктуру, внедрить рамки управления и только затем развивать ИИ‑возможности, которые действительно приносят бизнес‑ценность. Такой подход может занять больше времени вначале, но приводит к устойчивым возможностям, приносящим реальный ROI.
Мы также признаём, что успешная реализация ИИ требует разнообразных навыков. Наши команды включают инженеров данных, архитекторов данных, инженеров ML, специалистов по ИИ и экспертов домена. Такой многопрофильный подход гарантирует, что проекты имеют как фундаментальную инфраструктуру, так и специализированный ИИ‑экспертизу, необходимые для успеха.
Заключение: переосмысление приоритетов найма ИИ
Текущий дисбаланс в найме ИИ против инженеров данных представляет фундаментальное недоразумение того, что делает ИИ‑инициативы успешными. Организации фактически пытаются строить дома, начиная с крыши — подход, который неизбежно обрушится под собственным весом.
Путь вперёд требует честной оценки текущей зрелости данных, стратегического найма, приоритизирующего роли инфраструктуры данных, инвестиций в управление данными и качество, терпеливого построения возможностей в правильной последовательности и образования руководства о технических реалиях.
Компании, которые продолжают нанимать специалистов по ИИ без соответствующих инвестиций в инженерию данных, окажутся частью статистики 80 % неудач. Те, кто признаёт инфраструктуру данных как фундамент для успеха ИИ, будут теми, кто достигает реальных бизнес‑результатов и конкурентных преимуществ.
Вопрос не в том, инвестировать ли в ИИ, а в том, как инвестировать мудро, обеспечив наличие фундаментальных основ для поддержки этой инвестиции. Как ясно показывает исследование Gartner, организациям до 2026 года нужно это сделать. После этого проекты, построенные на шаткой базе данных, всё чаще будут отменяться, представляя огромные потери инвестиций и упущенные возможности.
Выбор ясен: организации могут либо гоняться за хайпом ИИ, нанимая специалистов без инфраструктуры, либо строить устойчивые возможности, правильно инвестируя в фундаментальные данные. Организации, выбравшие второй путь, останутся и будут успешными, когда цикл хайпа ИИ неизбежно корректируется, а результаты важнее обещаний.
О Artezio
Artezio – компания по разработке программного обеспечения, специализирующаяся на индивидуальных решениях, с глубоким опытом в инженерии данных, аналитике и внедрении ИИ. Мы помогаем организациям строить фундаментальные возможности, необходимые для успешной цифровой трансформации, гарантируя, что инвестиции в ИИ приносят реальную бизнес‑ценность, а не просто впечатляющие демонстрации. Свяжитесь с нами, чтобы узнать, как мы можем помочь вашей организации построить устойчивые данные и ИИ‑возможности.