ИИ теперь может сопоставить десятки тысяч закупленных материалов с коэффициентами выбросов за один день или построить углеродный след от добычи до ворот завода для продукта, у которого его никогда не было. Открытый вопрос как для компаний, так и для исследователей заключается в том, как решить, можно ли доверять конкретному результату. Сегодня мы выпускаем концептуальную основу, которая поможет командам по устойчивому развитию обрести большую уверенность в своих измерениях.
Вопрос о том, как проверить надежность ИИ, в углеродном учете стоит сложнее, чем во многих других областях, поскольку здесь редко существует единственно верный ответ для сверки. Шесть экспертных групп, получивших одинаковые данные по хлопку, разошлись в оценках на 44%. Environmental product declarations (EPDs) for identical products различаются более чем на 50% при одинаково соответствующих требованиям допущениях. Система ИИ, которая заявляет о «точности 95%», делает утверждение о совпадении с чьим-то суждением, и полезные вопросы заключаются в том, чье это суждение, на каких исходных данных оно основано и что происходит с оставшимися неточными 5%.
A paper we've just published open access in the Journal of Industrial Ecology предлагает набор критериев оценки, которые отвечают на эти вопросы. Мы разработали их при участии более чем 60 специалистов по устойчивому развитию, закупкам и оценке жизненного цикла (LCA) из восьми предприятий и семи секторов, доработали совместно с двумя верификационными компаниями, а затем применили к нашим собственным системам в Watershed Product Footprints. Мы надеемся, что эти критерии окажутся полезными далеко за пределами нашей работы. В этом посте рассматриваются сами критерии, то, как команды, создающие системы расчета углеродного следа на базе ИИ, могут проектировать решения с их учетом, и как покупатели и верификаторы могут использовать их для оценки таких систем. Мы подробно останавливаемся на двух из них: валидации индикаторов и повторяемости, приводя результаты нашей недавней работы, включая то, как мы применили их к собственным ИИ-системам Watershed для расчета углеродного следа продукции.
Начните с трех вопросов
Критерии сгруппированы вокруг трех операционных требований. Каждое из них соответствует вопросу, который должен задать проверяющий.
- Насколько хорошо система справляется с задачей по сравнению с экспертным суждением или документированными эталонными значениями? Бенчмаркинг: результаты должны соответствовать одобренным экспертами допустимым сопоставлениям, принятым проверяющим методологическим решениям или предопределенным допускам, а производительность должна указываться по категориям и качеству входных данных, а не в виде единого усредненного показателя.
- Может ли эксперт увидеть, как был получен результат? Прозрачная логика: обоснование сопоставления или методологического решения должно быть доступным и соответствовать принятым принципам углеродного учета. Для системы, построенной на базе большой языковой модели (LLM), где невозможно воспроизвести каждый внутренний шаг, это означает то, что пользователь может видеть для каждого результата: структурированную сводку обоснования, цепочку вычислений, стоящую за цифрой, информацию о том, какие проверки выполнялись детерминированно, а какие нет, и ссылки на поддерживающие источники.
- Какие результаты требуют проверки человеком? Характеристика неопределенности и проверяемость: система не должна выдавать предположения за факты. Она должна предоставлять проверенные индикаторы неопределенности и документацию, которая позволяет проверяющему вмешаться в работу с материалами и элементами высокого риска.
Первые два пункта имеют близкие аналоги в программном обеспечении и валидации машинного обучения: с одной стороны, оценка на отложенном тестовом наборе, с другой — документированная логика и контрольные журналы. Третий пункт чаще всего упускается из виду в инструментах расчета следа на базе ИИ, поэтому ему уделяется наибольшее внимание в следующих разделах.
Критерии для двух сценариев использования
Мы быстро поняли, что единый контрольный список для всех сценариев использования углеродного следа с помощью ИИ будет слишком строгим для простых приложений и слишком мягким для сложных, поэтому критерии разделены по сценариям использования.
- Сценарий 1 — автоматизированное сопоставление: связывание текста закупок, такого как «лист из нержавеющей стали 304», с набором данных инвентаризации жизненного цикла, таким как «производство стали, хромоникелевая сталь 18/8, горячекатаная».
- Сценарий 2 — автоматизированное моделирование: создание спецификации материалов и технологических процессов для продукта, не имеющего прямого совпадения в базе данных.
Для автоматизированного сопоставления (Сценарий 1) критерии требуют, чтобы система ИИ и ее поставщик продемонстрировали следующее. Нумерация соответствует статье, чтобы вы могли на нее ссылаться.
Критерий
На что обратить внимание
1.1 Эффективность бенчмаркинга
Точность по отношению к проверочному набору с одобренными экспертами допустимыми сопоставлениями с раскрытием информации о процессе маркировки.
1.2 Согласованность по типам материалов и форматам ввода
Производительность, отраженная по отраслевым категориям и сложности входных данных, с оговорками в случаях нестабильной работы.
1.3 Надлежащая детализация и подход с использованием прокси
Логика выбора прокси-данных, соответствующая практике LCA при отсутствии точного совпадения.
1.4 Повторяемость
Недвусмысленные входные данные дают одинаковое сопоставление при разных запусках; данные, вызывающие сомнения, помечаются как неопределенные.
1.5 Индикация качества сопоставления
Видимый индикатор качества совпадения или неопределенности, который выделяет плохие совпадения для улучшения данных, проверки человеком или эскалации до Сценария 2.
1.5.1 Валидация индикаторов
Если этот индикатор используется для сокращения или приоритезации проверки, его способность обнаруживать ошибки сопоставляется с независимыми метками и раскрывается.
С 1.6 по 1.10 Документация
Методология сопоставления, источники данных, история изменений для каждого сопоставления, логика принятия решений и контрольный журнал на уровне результатов.
1.11 Непрерывное совершенствование
Механизм обратной связи для внесения исправлений в систему.
1.12 Место в иерархии протокола парниковых газов
Заявление о том, где данный метод располагается в иерархии качества данных охвата 3.1.
Системы моделирования PCF предъявляют такие же требования к документации плюс собственные критерии бенчмаркинга и неопределенности.
Критерий
На что обратить внимание
2.1 Разумная точность и бенчмаркинг на уровне компонентов
Сквозные проверки по эталонным значениям, таким как EPD, плюс проверки на уровне компонентов по материальному балансу, скоростям подачи сырья и выбору прокси, поскольку итоговые значения сами по себе скрывают взаимопоглощающие ошибки.
2.2 Индикация неопределенности
Уровни доверия, диапазоны или показатели чувствительности для точек данных и допущений, определяющих результат.
2.2.1 Валидация индикаторов
Как и в 1.5.1: любая проверка, используемая для отмены или приоритезации проверки, проходит валидацию, а показатели ее эффективности раскрываются.
С 2.3 по 2.6 Документация
Основные источники данных, указанные для конкретного утверждения, которое они подтверждают, методология ИИ, подход к расчетам, а также заявление о том, для каких видов использования результат пригоден, а для каких нет.
2.7 Основные допущения
Допущения, существенно влияющие на итоговую цифру, зафиксированы.
2.8 Выявление горячих точек
Четкое указание основных источников выбросов и возможностей для улучшения.
Ни один из критериев не устанавливает проходной балл, поскольку достаточность 90-й точности сопоставления зависит от того, используется ли результат для предварительной оценки тысяч малозначимых позиций или для отчетного показателя, подчиненного порогу существенности в 5%. Критерии требуют, чтобы системы раскрывали доказательства, чтобы вы или ваш верификатор могли принять решение о пригодности для конкретной цели.
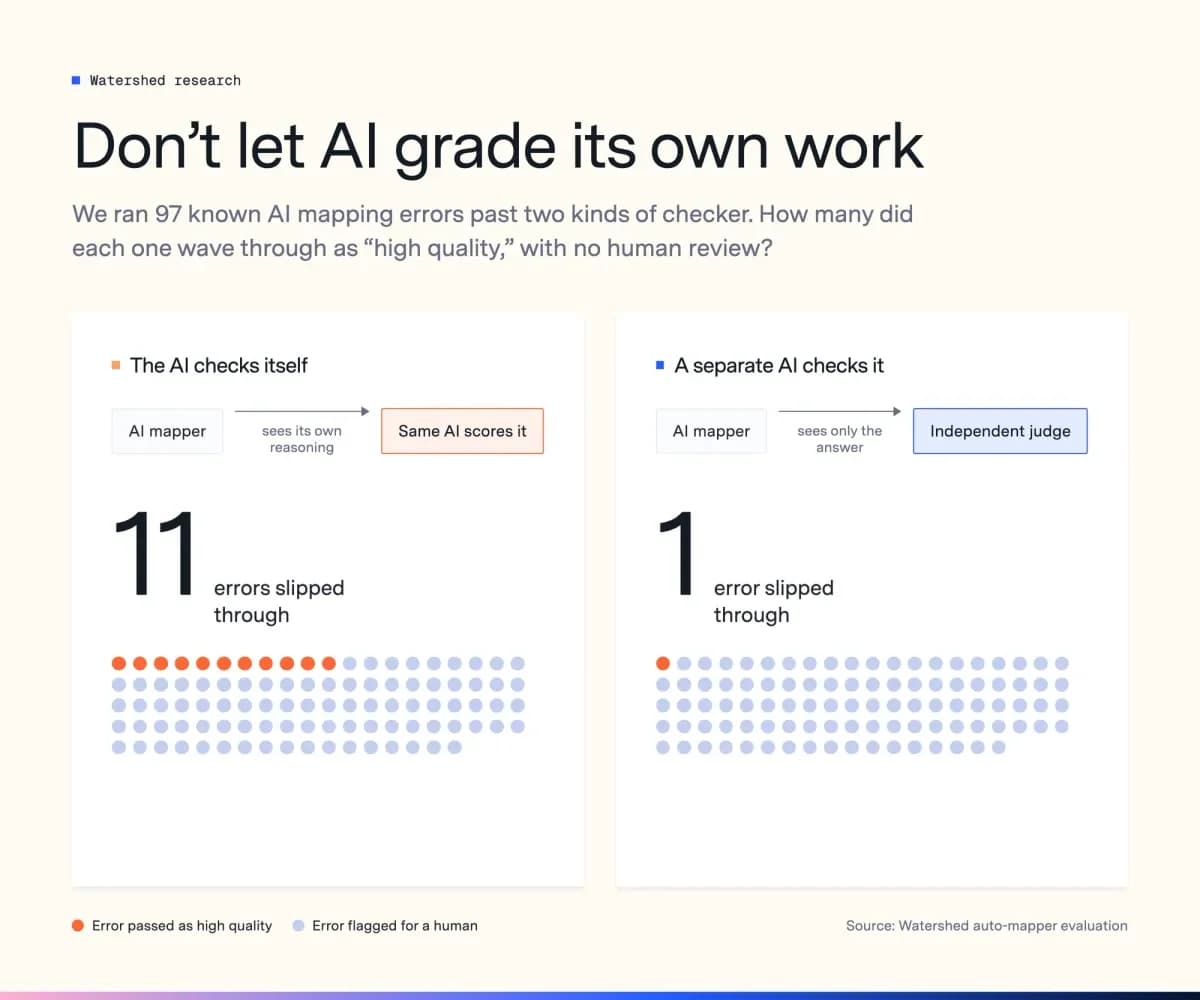
Не позволяйте ИИ оценивать собственную работу
Один из критериев, который мы сочли особенно важным как разработчики и пользователи таких систем, — это валидация индикаторов (1.5.1 и 2.2.1). Его также легко упустить из виду. Большинство инструментов расчета углеродного следа на базе ИИ сообщают ту или иную оценку уверенности или качества, и вполне естественно принимать эту оценку за чистую монету, пока вы ее не протестируете.
Многие клиенты вполне обоснованно хотят использовать эту оценку, чтобы решить, что именно требует проверки человеком. Но в большинстве систем оценка поступает из того же семейства моделей, которое создало ответ, часто с тем же промптом или в том же цикле, который принял решение. Если вы доверяете оценке, вы доверяете ИИ в том, что он укажет на собственные ошибки, что представляет собой проблему замкнутого круга доверия.
Решение состоит в том, чтобы рассматривать индикатор как самостоятельный системный вывод и проводить его бенчмаркинг соответствующим образом. Возьмите набор сопоставлений с независимыми экспертными метками, пропустите через них индикатор и получите показатели, необходимые рецензенту:
- долю ошибочных результатов, которые индикатор отмечает как приемлемые (это ваш уровень ложноотрицательных результатов, если вы автоматически принимаете решения на его основе);
- уровень ошибок среди принятых им результатов с доверительным интервалом;
- долю всех выявленных им ошибок при том бюджете на проверку, который вы действительно будете использовать.
Эти цифры задают политику проверки. До тех пор, пока индикатор не прошел валидацию таким образом, усилия по проверке должны распределяться по степени значимости и случайной выборке независимо от того, что говорит индикатор. Даже после прохождения валидации наиболее значимые позиции должны проверяться в любом случае, независимо от полученной оценки.
Наш собственный флаг качества сопоставления для автоматического сопоставителя материалов иллюстрирует обе стороны. Получив оценку от независимой модели-судьи, которая никогда не видит логики сопоставителя, он пропустил в категорию высокого качества только 1 ошибку из 97 в валидационном наборе. Если поручить задачу судейства самой модели сопоставителя, этот показатель вырастает до 11 из 97. Проверки на уровне компонентов в нашей модели Advanced AI, напротив, еще не преодолели этот порог: единственными доступными эталонными значениями являются общие показатели EPD, и на их основе проверки не позволяют отделить хорошие графики от плохих. Поэтому мы не используем их для отмены проверки, о чем и говорится в документе.
Рассмотрение повторяемости в качестве диагностического инструмента
Изменчивость результатов от запуска к запуску обычно рассматривается как недостаток генеративного ИИ. В рамках критериев она трактуется как полезная информация о входных данных. Запустите сопоставитель десять раз для позиции закупок, в которой указано только «Compartment boxes & lids» с описанием «packaging», и он выдаст литьевой полипропилен пять раз, гофрокартон три раза и термоформованный полипропиленовый лист два раза. Система говорит вам, что входные данные не позволяют получить единственный обоснованный ответ. Именно на этот элемент следует обратить внимание человеку или попросить поставщика внести ясность. Запустите его десять раз для «market for polypropylene, granulate» (точное название из базы данных), и все десять запусков совпадут.
Идентичные запуски подтверждают стабильность. Они ничего не говорят о правильности, поскольку система может быть идеально повторяемой и неизменно ошибаться, поэтому повторяемость в критериях соседствует с бенчмаркингом, а не заменяет его.
Применение этого на практике не означает запуск каждого элемента десять раз. Набор данных о закупках обычно содержит много похожих или идентичных материалов, и когда они возвращаются с разными результатами сопоставления, это тот же сигнал: описания не позволяют получить единственный обоснованный ответ. Подумайте о том, чтобы добавить больше описательных деталей к таким позициям.
Как выглядит сбой
Фреймворк, продемонстрированный только на работающей системе, не представляет большой ценности, поэтому в документе также рассматриваются сбои. Наиболее наглядные примеры связаны с PCFBench, открытым бенчмарком, который мы выпустили для расчета углеродного следа продукции. Универсальные передовые модели, которым поручено рассчитать углеродный след по компонентам, не дотягивают до критериев бенчмаркинга, а их самооценка уверенности не может служить основой для политики проверки. Тот же паттерн красных флажков проявляется и по другим критериям. Результаты бенчмаркинга представлены в виде единого числа без разбивки по категориям, повторяемость никогда не измерялась, а показатель уверенности никогда ни с чем не сопоставлялся.
Текущее положение наших систем
Мы применили критерии к двум системам в составе инструментов оценки углеродного следа продуктов Watershed: автоматическому сопоставителю материалов, который выбирает коэффициенты выбросов для приобретаемых материалов, и модели Advanced AI, которая строит углеродный след от зарождения до ворот предприятия на основе описания продукта. В самом документе и дополнительных материалах приведена оценка по каждому критерию.
Если вы читали наш предыдущий пост о том, как мы проводим бенчмаркинг автосопоставителя, основные выводы вам будут знакомы: производительность сохраняется на хорошо детализированных входных данных и падает на расплывчатых, что само по себе является результатом, который критерии требуют раскрывать. Конкретные цифры меняются с каждым обновлением моделей и библиотек, и мы ожидаем этого. Мы бы хотели, чтобы вы вынесли из документа структуру доказательств вокруг них, поскольку именно она позволяет оценить качество и обоснованность наших цифр или любых других.
Используйте критерии
Документ находится в открытом доступе, содержит разобранные примеры и полные доказательства валидации в дополнительных материалах. Критерии представляют собой разумный list of pre-requisites to ask for when you're evaluating an AI carbon footprinting system — от нас или кого-либо еще, — а также полезный список для публикации при создании собственного решения. Стандартизирующие организации, работающие над расчетом углеродного следа продукции, могут свободно принять или улучшить их, и мы готовы помочь. Скачайте сводный список критериев здесь.
Дополнительные исследования по этой теме см. в нашем аналитическом обзоре по ИИ в области устойчивого развития, который объединяет PCFBench, бенчмаркинг классификации затрат ATLAS и другие исследовательские работы.