Инструменты безопасности на базе ИИ, способные обнаруживать угрозы только на английском языке, обеспечивают лишь ограниченную защиту. Вот как компания Tenable обучила свои детекторы угроз обрабатывать девять дополнительных языков и понимать еще тысячи, не прибегая к модели перевода, которая увеличивает затраты и замедляет обработку.
Ключевые выводы
- Детекторы Tenable One AI Exposure, охватывающие ИИ-угрозы, вредоносный контент и другие риски соблюдения политик, изначально были ориентированы на английский язык. Для оценки угроз, написанных на других языках, наш продукт переводил их на английский, что представляло собой медленный, дорогой и часто неточный подход.
- Компания Tenable создала конвейер агентного перевода, который генерирует высококачественные обучающие и тестовые данные с сохранением меток на девяти языках. Конвейер защищен многосудейским шлюзом качества, циклом доработки и механизмом обработки отказов модели.
- Эта единая многоязычная модель обнаруживает угрозы нативно на всех 10 поддерживаемых языках. По сравнению с нашим предыдущим процессом перевода угроз на английский язык, эта модель работает примерно в 20–800 раз быстрее для каждого элемента и на порядок дешевле, неся единовременные затраты, которые не растут вместе с пользовательским трафиком.
Почему ваш инструмент безопасности ИИ должен поддерживать несколько языков
Промпт-атака на ИИ-модель, написанная на испанском, арабском или хинди, ровно так же опасна, как и атака на английском. Именно поэтому детектор безопасности на базе ИИ, работающий только с английским языком, оставляет вашу организацию уязвимой перед атаками на других языках.
Чтобы решить эту проблему в нашем продукте, компания Tenable сначала внедрила процесс «сначала перевести, потом обнаружить»:
- Определить язык.
- Перевести входные данные на английский с помощью большой модели перевода.
- Запустить детектор для английского языка.
Этот процесс работает, но у него есть четыре недостатка:
- Задержка. Большая авторегрессивная модель перевода, которая запускается перед каждым обнаружением на неанглиском языке, требует сотен миллисекунд для коротких вводных данных и от секунд до десятков секунд для длинных.
- Стоимость. Каждый запрос на неанглиском языке оплачивает полный цикл перевода.
- Операционные расходы. Вам приходится развертывать, масштабировать и обслуживать еще одну тяжеловесную модель.
- Потеря сигнала. При простом переводе смысл и намерение размываются, что снижает способность инструмента обнаруживать угрозы.
Как Tenable превратила свой инструмент безопасности ИИ в полиглота
Чтобы сделать наш ИИ-продукт безопасности нативно многоязычным, мы выяснили, что нам не нужно использовать LLM-переводчик в рабочей среде. Вместо этого нам потребовались высококачественные многоязычные данные в двух местах:
- Обучающий набор для обучения модели целевым языкам.
- Тестовый набор, которому мы можем доверять для честного бенчмаркинга производительности на каждом языке.
Оба набора должны сохранять метки данных, гарантируя, что метка переживет процесс перевода. Перевод может незаметно перевернуть метку (вредоносный образец данных превращается в доброкачественный) или нейтрализовать ее (значимый с точки зрения безопасности язык «смягчается» так, что то, что является явным позитивом на исходном языке, вместо этого читается как пограничная угроза). В любом случае образец данных оказывается с неверной меткой и отравляет датасет.
Компания Tenable пришла к выводу, что следующие методы не являются идеальными:
- Перевод силами экспертов-людей. Это медленно и требует владеющего языком рецензента для каждого языка, поэтому такой подход не масштабируется.
- Машинный перевод. Стандартные методы перевода искажают качество датасета двумя принципиально разными способами: нативный машинный перевод отдает приоритет плавной формулировке в ущерб контексту безопасности, потенциально удаляя вредоносные намерения (например, превращая запрос на синтез токсинов в безобидный химический запрос), в то время как прямой буквальный перевод создает неуклюжий, неестественно сформулированный текст, ухудшающий обучающий сигнал (например, английская фишинговая приманка, переведенная буквально на японский язык).
- Готовые LLM. Они могут отказаться переводить материалы, которые они считают ненадлежащими, например, промпты о синтезе оружия или темах селфхарма, поэтому текст, представляющий собой вероятную угрозу, исключается из датасета.
- Постоянно работающие (онлайн) переводчики. Опора на конвейеры онлайн-перевода влечет за собой задержки на каждый запрос, операционную сложность и затраты, которые растут вместе с сотнями миллионов элементов, что делает такой подход непрактичным для производственных сред.
Процесс перевода должен быть экономически эффективным и воспроизводимым для множества языков.
Решение от Tenable: агентный конвейер плюс многоязычная модель
1. Обзор агентного конвейера
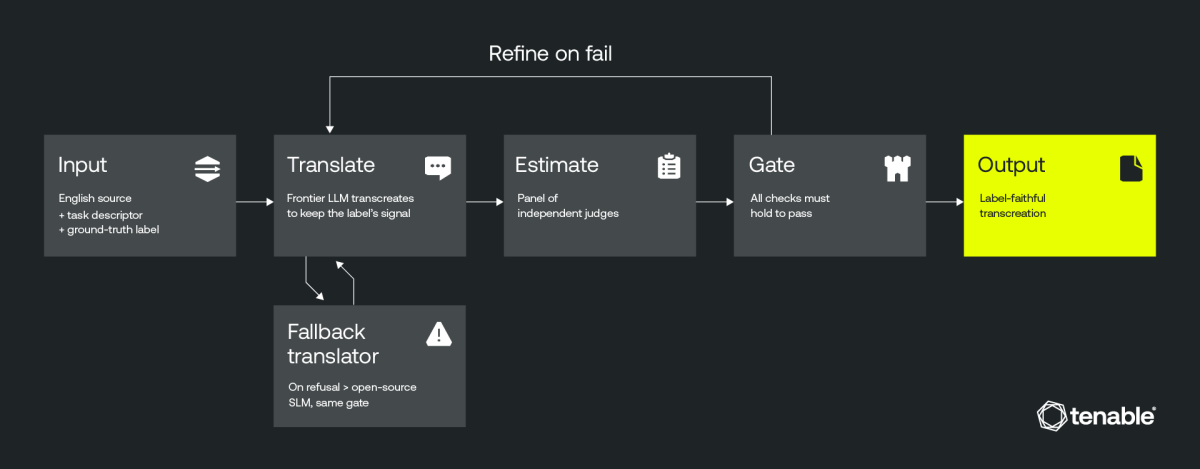
Конвейер агентного перевода. Каждый английский элемент пересоздается передовой LLM, оценивается группой независимых экспертов и либо принимается, либо отправляется на доработку. В случае отказа в дело вступает контролируемая модель с открытым исходным кодом через тот же шлюз.
В процессе перевода данных Tenable каждый элемент проходит через три этапа в нашем агентном конвейере.
- Перевод (Translate). Передовая LLM создает транскраэшн — перевод, который мы дорабатываем, задавая задачу, метку элемента и целевой язык, в отличие от слепого пословного рендеринга. Именно эта тонкая настройка позволяет сохранить смысл, имеющий значение для безопасности, и саму метку.
- Оценка (Estimate). Коллегия независимых судей оценивает каждый перевод на предмет беглости, сохранения смысла и того, сохраняется ли исходная метка данных.
- Шлюз (Gate). Сохраняются только те переводы, которые прошли все проверки.
Два цикла восстановления предотвращают потерю сложных случаев:
- Обработка отказов (Refusal handling). Когда передовой переводчик отказывается обрабатывать конфиденциальный элемент, конвейер передает ту же задачу по транскраэшну контролируемой языковой модели малой мощности с открытым исходным кодом, которая не отказывает. Ее результат проходит через тот же шлюз качества, поэтому легитимные, но конфиденциальные данные безопасности не отбрасываются молча.
- Доработка (Refinement). Если перевод не проходит проверку качества, он отправляется на повторную попытку, а не выбрасывается.
Поскольку задача и метки являются параметрами, этот конвейер может обслуживать любые будущие задачи обнаружения, требующие многоязычной поддержки.
2. Предобученная многоязычная модель
Вместо того чтобы обучать языковую модель с нуля, мы доработали компактную модель, которая уже была предобучена на множестве языков, что дало два преимущества:
- Она потребляет гораздо меньше данных на каждый язык. Модель уже усвоила полезные межъязыковые представления, поэтому нам нужно было лишь обучить ее нашей задаче.
- Она переносит знания между языками. Мы измерили это, прежде чем потратить хотя бы доллар на перевод. Для некоторых задач модель успешно обобщала знания на другие языки, используя только английские обучающие данные, что устранило необходимость в переводе. Для более сложных задач мы использовали фреймворк агентного перевода для перевода только на те языки, на которых модель показывала худшие результаты. Даже в этих случаях обучение модели на нескольких языках повысило качество перевода модели на другие языки без дополнительных затрат.
Влияние и результаты
Заменив нашу устаревшую архитектуру «перевод-затем-обнаружение» на единую нативную модель, Tenable превратила наш конвейер в решение корпоративного уровня, обеспечивающее практически мгновенное глобальное покрытие. Этот сдвиг радикально сократил задержки и инфраструктурные затраты при сохранении высочайшего качества и обеспечении более широкой языковой поддержки. Ниже приведены ключевые результаты, достигнутые с помощью этой модернизированной архитектуры:
- Одна быстрая модель, без переводчика на пути. Обнаружение теперь работает нативно на каждом поддерживаемом языке за десятки миллисекунд, в то время как процесс «перевод-затем-обнаружение» занимал секунды — примерно в 20–800 раз быстрее для каждого элемента. Кроме того, объем занимаемой памяти примерно в 12–14 раз меньше: менее 1 ГБ против 12–14 ГБ.
- Разовые затраты — менее 10 000 долларов США. Мы сгенерировали данные для многоязычного обучения и тестирования один раз. Эти затраты не растут вместе с производственным трафиком клиента, в отличие от постоянно работающего переводчика, счет за услуги которого увеличивается с каждым запросом.
- Гибкая настройка бюджета по дизайну. Мы задаем бюджет, и конвейер настраивает уровень используемой языковой модели (LLM) и степень доработки каждого элемента.
- Качество, которое можно доказать. Нейтральная LLM-судья из семейства сторонних моделей, не входящая в наш стек перевода и оценки, в подавляющем большинстве случаев прямого сравнения отдавала предпочтение трансгреациям Tenable, а не результатам коммерческой модели машинного перевода или сильной открытой модели перевода.
- Отсутствие деградации для английского языка. Каждый детектор Tenable One AI Exposure получил возможность понимать и переводить с девяти языков (испанского, немецкого, французского, итальянского, португальского, китайского мандаринского, японского, арабского и хинди), при этом производительность для английского языка осталась на прежнем уровне или улучшилась, а задержка осталась близкой к реальному времени.
- Выход за рамки языков, на которых мы обучались. Поскольку модель прошла предварительное обучение на очень широком наборе языков, она может читать и отмечать атаки на тысячах языков, на которых мы ее явно не обучали. Мы официально проверили только 10 поддерживаемых нами языков, поэтому этот более широкий охват многообещающий, но требует дальнейшего тестирования, прежде чем на него можно будет полагаться.
Обнаружение угроз ИИ, полнота (recall) при уровне ложноположительных срабатываний 0,005%. (Метрика полноты измеряет, насколько хорошо система находит каждый отдельный релевантный элемент, ничего не упуская.) Наша многоязычная модель не уступает или превосходит подход «перевод-затем-обнаружение» для 9 из 10 языков и в целом (0,93 против 0,88).
Обнаружение вредоносного контента, полнота (recall) при уровне ложноположительных срабатываний 0,02%. В более сложной задаче разрыв увеличивается: наша многоязычная модель лидирует по каждому языку и в целом (0,65 против 0,50).
Как Tenable One AI Exposure защищает многоязычных пользователей
Злоумышленники не ограничиваются английским языком, и ваша защита тоже не должна. Благодаря этой работе Tenable One AI Exposure распространяет одинаковое качество обнаружения (для джейлбрейков, инъекций промптов, вредоносного контента и утечки данных) нативно на 10 языках, с производственной скоростью и без узких мест перевода на пути запроса. По мере того как клиенты внедряют ИИ на новых рынках и для новых языков, это многоязычное покрытие расширяется вместе с ними.
- Облако
- Управление экспозицией